صدای هر پاسخدهنده شنیده میشود. هر بینش قابل ردیابی است. هر مهلتی رعایت میشود.
ساختهشده برای آژانسهای تحقیقات بازار که به مشتری تحویل میدهند و تیمهای داخلی بینش مشتری که به کسبوکار تحویل میدهند. هر دو با یک فشار روبهرو هستند: دادهٔ کیفی غنیترین نشانهای است که دارید و بسیار بیشتر از آن است که بتوان با دقت و دستی خواند. از آژانسها بینش عمیقتر در زمان کوتاهتر و با دستمزد کمتر خواسته میشود. از تیمهای داخلی خواسته میشود پابهپای تصمیمهای محصول و تجاری پیش بروند که دو هفته صبر نمیکنند.
Skimle کدگذاری مکانیکی را که بیشتر هفتهٔ یک تحلیلگر را میبلعد انجام میدهد. تفسیر، «که چه» و توصیه با شماست. دو هفته کدگذاری به دو روز میرسد و ظرافتها در این فشردهسازی حفظ میشوند.
تحلیل حرفهای که با حجم پژوهش شما مقیاس میگیرد
۶۰ مصاحبهٔ عمیق، ۸ گروه کانونی در چهار بازار یا ۵٬۰۰۰ نظر متنی NPS: حجم فراتر از خواندن دستی و دقیق است و ابزارهای سطحی ظرافتهایی را که مشتری یا مدیر تجاری خواهد پرسید از دست میدهند. Skimle بدون فدا کردن عمق مقیاس میگیرد.
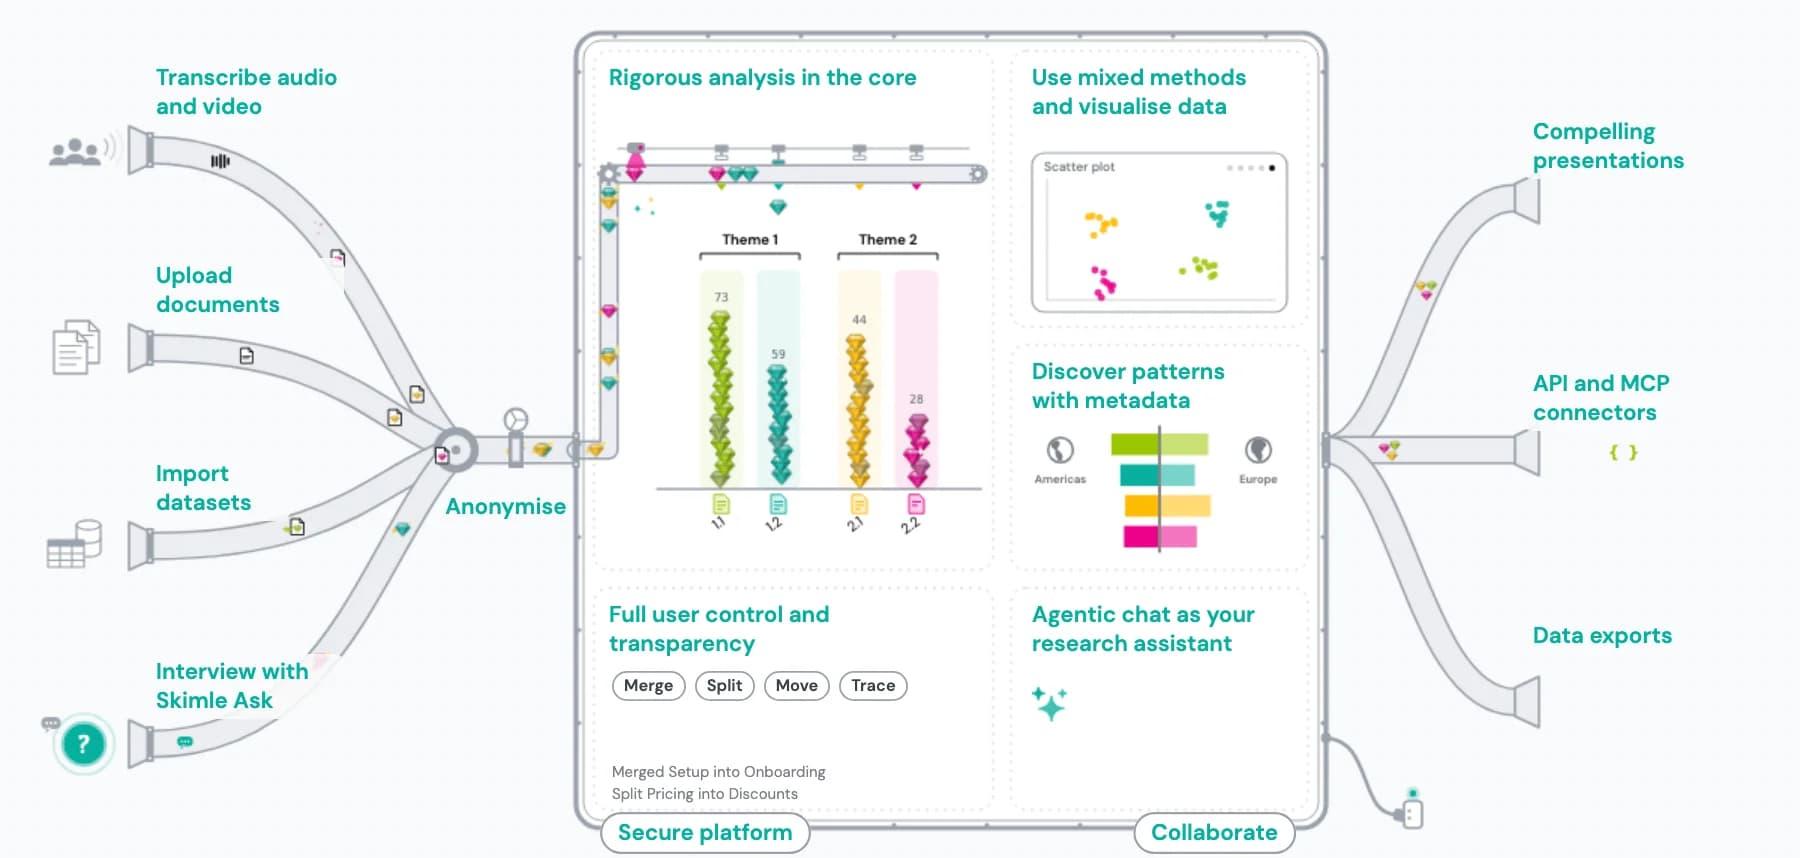
- مصاحبهها، گروههای کانونی، پیمایشهای باز، نقدها و تیکتهای پشتیبانی را در یک پروژه مدیریت میکند
- هر موضوع به نقلقولهای عینی مشتریان پیوند دارد، از کل مجموعهداده نه از نمونه
- تحلیل بخشها درونساخت است: مقایسه بر اساس ویژگیهای جمعیتی، سطح محصول، جغرافیا و بازههای NPS
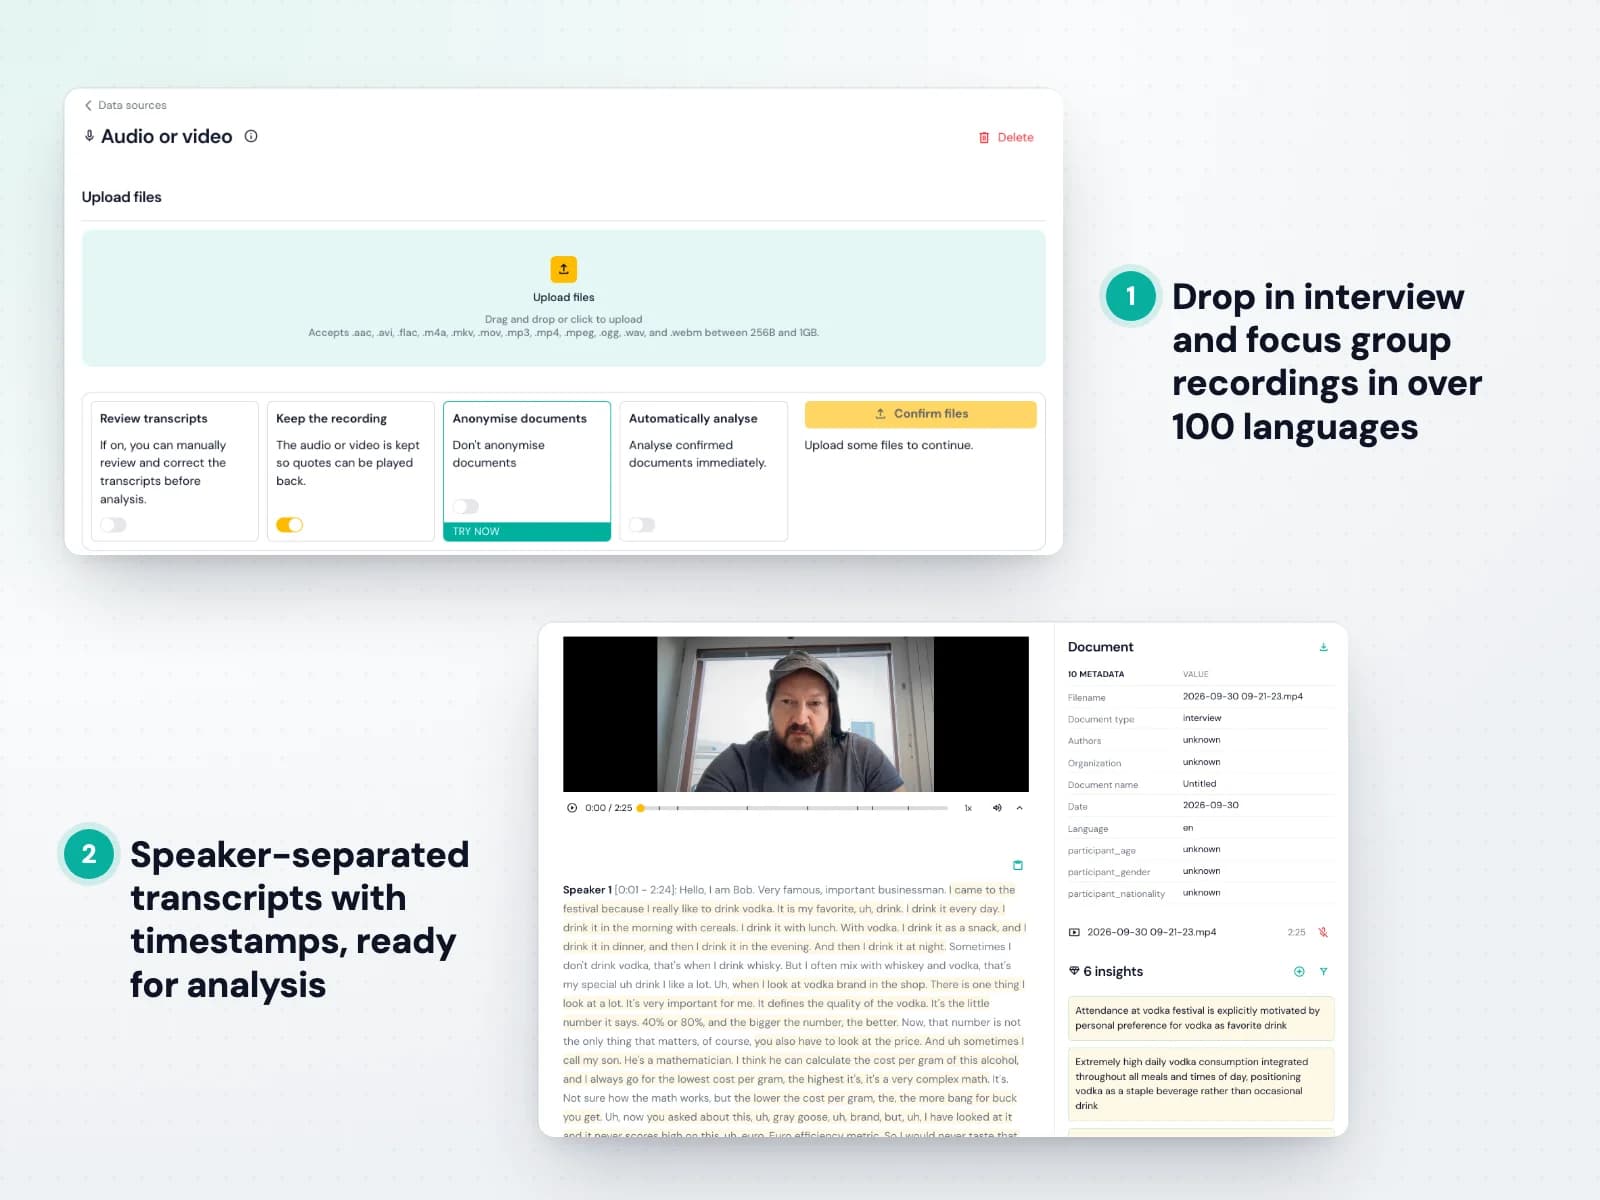
- بیش از ۱۰۰ زبان در یک پروژه، بدون نیاز به مرحلهٔ ترجمه
- خروجیهای آمادهٔ ارائه در Word، PowerPoint و Excel در چند دقیقه
تحلیل گروههای کانونی و مصاحبه با مشتریان در مقیاس بزرگ
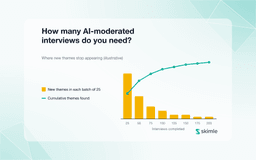
گروههای کانونی دشوارترین دادهٔ کیفی برای تحلیل خوباند. یک شرکتکنندهٔ پرصدا، اگر شواهد را دنبال نکنید، با چهار صدای مستقل یکی به نظر میرسد. مصاحبههای عمیق جور دیگری شکست میخورند: در ۲۰، ۴۰ یا ۶۰ متن، کدگذاری آخرین متن به همان شیوهٔ نخستین به گلوگاه تبدیل میشود. Skimle یک ساختار موضوعی برای همهٔ جلسهها میسازد و نشان میدهد چه چیزی ثابت بود، چه چیزی بر اساس بخش تغییر کرد و چه چیزی یک مورد استثنایی تنها بود؛ تا یافته وقتی مشتری یا ذینفعی اعتراض میکند پابرجا بماند.
چگونه کار میکند
- ۱. هر جلسه را بهعنوان یک سند وارد کنید
متنها یا ضبطها را از Zoom، Teams، Otter یا Fireflies بارگذاری کنید. Skimle صدا و ویدیو را مستقیم پیاده میکند تا هر جلسه سندی آمادهٔ تحلیل شود.
- ۲. تحلیل را روی همهٔ جلسهها اجرا کنید
Skimle هر متن را میخواند و موضوعها را از محتوای همهٔ جلسهها میسازد. بهجای تحمیل نظام دستهها از پیش آماده، کشف میکند واقعاً دربارهٔ چه بحث شده است.
- ۳. ببینید چه چیزی ثابت بود و چه چیزی تغییر کرد
هر موضوع نشان میدهد کدام گروهها در آن سهم داشتهاند و چند بار، و نشانهٔ همگانی را از یک جلسه یا یک بازار جدا میکند.
- ۴. توزیع شواهد را ارزیابی کنید
روی هر موضوعی کلیک کنید تا نقلقولهای پشتیبان را بخوانید و ببینید از کدام جلسهها آمدهاند. اثر صدای غالب را مستقیم بسنجید، نه از روی حافظه.
- ۵. برای مشتری خروجی بگیرید
سند جمعبندی را با نقلقولهای نماینده به تفکیک گروه بسازید؛ آماده برای ارائه یا گزارش کامل.
کدگذاری پیمایشهای باز و مقایسه میان بخشها
یک فهرست موضوعی کلی هرگز به پرسشی که کسبوکار واقعاً پرسیده پاسخ نمیدهد: چه کسی چنین احساسی دارد و این بر اساس بخش چه تفاوتی دارد؟ در برابر هزاران پاسخ متنی، بیشتر تیمها نمونهای را سرسری میخوانند و دیدگاههای اقلیت را که تیزترین نشانه را دارند از دست میدهند. Skimle هر پاسخ را کدگذاری میکند و به شما امکان میدهد همان ساختار موضوعی را بر اساس هر متغیر فرادادهای برش دهید، چه بازهٔ NPS باشد، چه سطح محصول، بازار یا ویژگیهای جمعیتی، و پاسخهای باز یک پیمایش پیگیری را به نمایی با روش ترکیبی تبدیل میکند که بتوانید بر پایهاش اقدام کنید.
چگونه کار میکند
- ۱. پاسخها را همراه فراداده بارگذاری کنید
پاسخهای باز را بهصورت CSV از SurveyMonkey، Typeform یا Qualtrics همراه ستونهای فرادادهٔ پاسخدهندگان وارد کنید تا هر پاسخ بخش خودش را داشته باشد.
- ۲. ساختار کامل موضوعها را بسازید
Skimle هر پاسخ را در سلسلهمراتبی از موضوعها کدگذاری میکند، نه فقط موضوعهای رایج، تا دیدگاههای اقلیت دیده شوند.
- ۳. بر اساس هر متغیری بخشبندی کنید
موضوعها را بر اساس بازهٔ NPS، سطح محصول، جغرافیا یا ویژگیهای جمعیتی فیلتر و مقایسه کنید تا ببینید کدام مسائل برای کدام مشتریان مهمترند.
- ۴. شواهد را بررسی کنید
هر الگو تا نقلقولهای عینی قابل ردیابی است؛ پس هر شکافی میان دو بخش با همان پاسخهایی پشتیبانی میشود که آن را پدید آوردهاند.
- ۵. خروجی آماده برای مشتری بگیرید
گزارشی موضوعی با نقلقولهای عینی و جدولهای متقاطع بسازید؛ در چند دقیقه، نه چند روز.

همهٔ کانالهای بازخورد را در یک تصویر بینش گرد آورید
مصاحبهها، نظرهای متنی NPS، تیکتهای پشتیبانی، نقدها، ضبط تماسهای فروش، جلسههای بازبینی برد و باخت، رشتههای گفتوگوی انجمنها، گزارشهای تحلیلگران و رقبا. هر کانال معمولاً تحلیل، ارائه و واژگان خودش را دارد؛ پس هیچ چیز جمع نمیشود و یک مشکل مشتری سه بار با سه نام گزارش میشود. Skimle هر منبع را در یک پروژه بر اساس یک ساختار دستهای کدگذاری میکند و سپس نشان میدهد هر کانال به یک موضوع چه وزنی میدهد. آژانسها از آن برای افزودن پژوهش کتابخانهای و منابع ثانویه به مطالعهٔ اولیه استفاده میکنند. تیمهای داخلی از آن برای نمایی همیشهروشن از مشتری بهره میبرند.
چگونه کار میکند
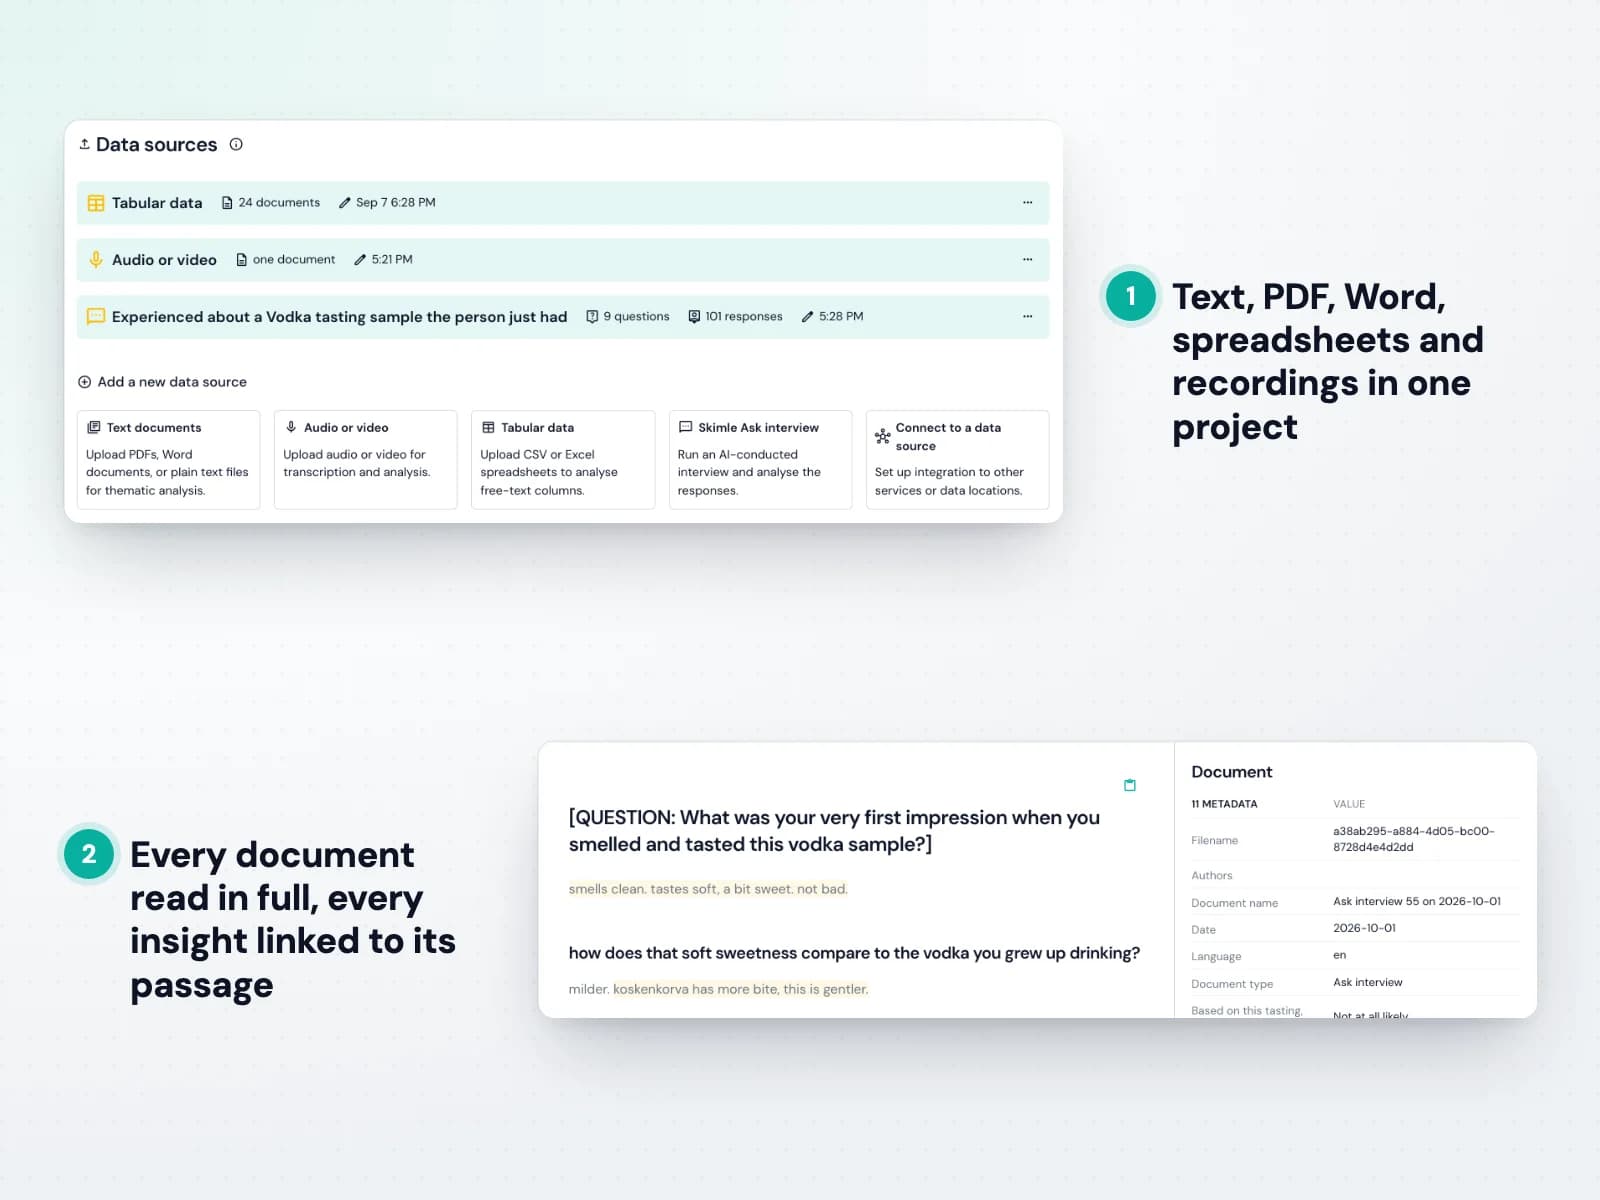
- ۱. کانالها را در یک پروژه گرد آورید
متنها، خروجیهای CSV، فایلهای PDF و ضبطها را کنار هم بارگذاری کنید. خروجی تیکتها، انبوه نقدها، گزارشهای تحلیلگران و صدای مصاحبهها همه در یک پروژه سند میشوند.
- ۲. هر سند را با کانالش برچسب بزنید
کانال، بخش، بازار و تاریخ بهعنوان فراداده وارد میشوند تا هر مقایسهٔ بعدی میان منابع یک فیلتر باشد، نه تحلیلی تازه.
- ۳. همه چیز را بر اساس یک ساختار کدگذاری کنید
Skimle یک ساختار موضوعی برای همهٔ منابع میسازد یا چارچوبی را که از پیش بر اساسش گزارش میدهید به کار میبرد، تا یک یافته در هر کانال همان معنا را داشته باشد.
- ۴. مقایسه کنید هر کانال چه میگوید
ببینید منابع کجا همنظرند و کجا تناقض دارند. موضوعی که در تیکتها پررنگ و در مصاحبهها غایب است یک یافته است، نه ناسازگاریای که باید ماستمالی شود.
- ۵. موج بعدی را بدون شروع دوباره اضافه کنید
دادهٔ فصل بعد در همان ساختار کدگذاری میشود تا پیمایش پیگیری قابلیت مقایسهاش را حفظ کند و گزارش بهروزشده فقط یک خروجیگیری دوباره باشد، نه بازسازی.
پرسشهای متداول
اینها پرسشهایی است که تیمهای بینش و سرپرستان پژوهش آژانسها بیش از همه از ما میپرسند، از جمله پرسشهایی که مستقیم از فرایند خرید میآیند. چکلیست RFP بیطرف نسبت به فروشنده همین پرسشها را برای طرح با هر فروشندهای که امتیاز میدهید فهرست میکند، از جمله خود ما.
- این چگونه به ما کمک میکند با جایگزینهای ارزان و سطحی رقابت کنیم؟
- ارائهدهندگان ارزان و پوستههای نازک هوش مصنوعی با ابر واژهها و فهرست موضوعی تخت بر سر قیمت رقابت میکنند. Skimle عمق را با سرعت آنها به شما میدهد؛ پس آژانس با کیفیت "که چه" متمایز میشود نه با نرخنامه، و تیم داخلی از بودجهای ثابت مطالعات بیشتری بیرون میکشد. ساعتهای تحلیلگر از کدگذاری مکانیکی به تفسیر منتقل میشود، همان بخشی که هر کسی واقعاً برایش پول میدهد. ببینید پول یک مطالعهٔ کیفی واقعاً کجا میرود ←
- وقتی مشتری یا ذینفعی تحلیل با کمک هوش مصنوعی را زیر سؤال میبرد چه بگوییم؟
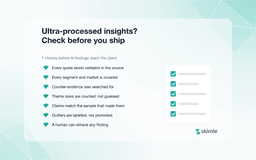
- آن را دقیق توصیف کنید: هوش مصنوعی دستهبندی مکانیکی را انجام میدهد و پژوهشگری مشخص هر موضوع را بازبینی و تفسیر را مینویسد. سپس شواهد را نشان دهید. هر ادعا در گزارش Skimle به نقلقول عینی و سند منبعش باز میشود؛ پاسخی محکمتر از آنچه جمعبندی دستی میتواند بدهد، چون آنجا منطق کدگذاری فقط در ذهن کسی وجود داشت. ۷ قاعده برای استفادهٔ مسئولانه از هوش مصنوعی در تحقیقات بازار کیفی ←
- آیا Skimle کل مجموعهداده را تحلیل میکند یا نمونهای از آن را؟
- کل مجموعهداده. این را باید از هر فروشندهای پرسید، چون چند ابزار زیرمجموعهای از اسناد شما را با جستوجوی تعبیهای بازیابی، تحلیل میکنند و هرگز نمیگویند کدام اسناد وارد نشدهاند. خروجی طوری خوانده میشود که انگار کل پیکره را پوشش داده، اما نداده است. Skimle هر سند را کدگذاری میکند و میتوانید هر کدام را باز کنید تا دقیقاً ببینید کدام بخشها کدگذاری شدهاند و کدام نه.
- آیا میتوانیم نظام دستهها خودمان را به کار ببریم یا فقط باید آنچه هوش مصنوعی میسازد بپذیریم؟
- هر دو، و هر دو روی یک پیکره. نظام دستهها موجودی بیاورید تا Skimle بر اساس آن قیاسی کدگذاری کند، یا بگذارید ساختار را استقرایی از داده بسازد. دستهها را میتوان بعداً ادغام، تقسیم، بازنامگذاری، بازچینی و حذف کرد و تحلیل از ویرایشهای شما پیروی میکند. آژانسهایی که سال به سال پیمایش پیگیری یا چارچوب استاندارد مشتری را اجرا میکنند معمولاً قیاسی کار میکنند؛ مطالعات اکتشافی معمولاً از سوی دیگر آغاز میشوند.
- چه چیزی مانع رسیدن نقلقول ساختگی به گزارش ما میشود؟
- هر نقلقول بهصورت مکانیکی با سند منبع مقایسه میشود. اگر مدل متنی تولید کند که عیناً در دادهٔ شما وجود ندارد، Skimle آن را علامت میزند و بهجای نمایش دوباره پردازش میکند تا نقلقول ساختگی به ارائهٔ مشتری نرسد. همچنین میتوانید هر سندی را باز کنید و ببینید کدام بخشها کدگذاری شدهاند و کدام نه؛ راهی برای یافتن شکست وارونه، یعنی جا افتادن چیزی. شفافیت دوسویه چگونه کار میکند ←
- Skimle را چگونه با دیگر ابزارهای فهرستمان مقایسه کنیم؟
- بهجای تماشای دمو، یک آزمایش آزمایشی اجرا کنید. پیکرهای را بردارید که پیشتر تحلیلش کردهاید تا بدانید پاسخ باید چه باشد، پیش از شروع سه کار بنویسید (یک کدگذاری، یک مقایسهٔ بخشها، یک جستوجوی شواهد)، زمان هر کدام را همراه کار اصلاح بسنجید و عمداً با ابزار مخالفت کنید تا ببینید با چه سرعتی میتوانید خروجیاش را بازساختاردهی کنید. خوشحال میشویم یک پروژهٔ زنده را موازی با ابزار فعلیتان اجرا کنیم و سطح رایگان پیش از همهٔ اینها به یک پژوهشگر اجازه میدهد در یک بعدازظهر به دیدگاهی برسد. چکلیست RFP هفتحوزهای و الگوی امتیازدهی ←
- Skimle چه حجمی از داده را و به چند زبان میتواند پردازش کند؟
- تا ۱٬۰۰۰ سند در هر پروژه، که همه چیز را از مطالعهای با ۲۰ مصاحبه تا پیمایش پیگیری جهانی با هزاران پاسخ پوشش میدهد، و بیش از ۱۰۰ زبان که بدون مرحلهٔ ترجمه به زبان اصلی تحلیل میشوند. یک پروژه میتواند انگلیسی، اسپانیایی، چینی ماندارین، آلمانی و عربی را ترکیب کند، یک ساختار موضوعی برای همه بسازد و هر نقلقول را به زبان اصلیاش نگه دارد. اگر مرتب در بالای این بازه کار میکنید، دربارهٔ ترتیبات حجمی با ما صحبت کنید.
- آیا دادهٔ مشتری امن و محرمانه است؟
- همهٔ دادهها درون اتحادیهٔ اروپا روی AWS، در محیطی که شخص ثالثی دارای گواهی پیکربندی کرده، ذخیره و پردازش میشوند و دادهٔ مشتری هرگز برای آموزش مدلها استفاده نمیشود. توافقنامهٔ پردازش داده در دسترس است، ما تحت توافقنامههای عدم افشای مشتری کار میکنیم، ناممستعارسازی در روند کار تعبیه شده و هر جا حاکمیت داده لازم بداند، استقرار تکمستأجری یا ابر خصوصی در دسترس است.
- اگر استفاده از Skimle را کنار بگذاریم، تحلیل ما چه میشود؟
- در هر طرحی آن را با خود میبرید. دادهٔ کدگذاریشده را با استاندارد باز REFI-QDA (qdpx) خروجی بگیرید و در NVivo، ATLAS.ti یا MAXQDA ادامه دهید، یا خروجیهای Word، PowerPoint و Excel را با نقلقولهایی که بر اساس موضوع مرتب شدهاند ببرید. ما استاندارد همکاریپذیری را دقیقاً به این دلیل پیاده میکنیم که ماندن انتخاب باشد، نه پیامد.
- وقتی حجم مطالعات ما بالا و پایین میرود قیمتگذاری چگونه است؟
- Skimle اشتراکی سبک به ازای هر کاربر با سهمیهٔ اعتبار گنجاندهشده است، بهعلاوهٔ بستههای اعتباری که برای ماههایی که مطالعهای بزرگ در جریان است میخرید. اشتراک کل تیم را میان پروژهها در ابزار نگه میدارد؛ بستهها هزینه را به پروژهای که سببش شده پیوند میدهند، که برای آژانسهایی که هزینه را به مشتری منتقل میکنند مهم است. ذینفعانی که فقط باید یافتهها را بخوانند به جایگاه کاربری نیاز ندارند، چون خروجیها و گزارشهای پژوهشی قابل چاپ این نیاز را پوشش میدهند.
- آیا چند پژوهشگر میتوانند روی یک پروژه کار کنند؟
- بله، همزمان، با حفظ ویرایشها و حاشیهنویسیهای هر نفر. این برای داوری همتا و کنترل کیفیت مناسب است و برای تقسیم یک مطالعهٔ بزرگ میان پژوهشگران تازهکار و ارشد، با یک سرپرست ارشد که ساختار دستهها را هدایت میکند.
ساختهشده برای متخصصان، به دست متخصصان
Skimle بیش از ۱٬۵۰۰ کاربر راضی در بیش از ۵۰ دانشگاه، نهاد دولتی، آژانس و شرکت دارد. همهٔ دادهها درون اتحادیهٔ اروپا ذخیره و بر اساس این موارد پردازش میشوند: سیاست سختگیرانهٔ GDPR ما و شرایط خدمات.
میخواهید بیشتر بدانید؟ ببینید: وبلاگ Signal & Noise، پرسشهای متداول و موارد استفاده بر اساس بخش. همچنین با کمال میل محصول را نمایش میدهیم یا بررسی میکنیم Skimle چگونه با نیازهای شما جور میشود. دربارهٔ شرکت پشت Skimle بیشتر بخوانید