مروری بر ویژگیهای Skimle
Skimle نرمافزار تحلیل دادهٔ کیفی مبتنی بر هوش مصنوعی است، برای پژوهشگران بازار، متخصصان بینش مشتری، پژوهشگران دانشگاهی، مشاوران و دیگر متخصصان کنجکاوی که میخواهند عمیقتر به دادههایشان بپردازند.
متن پیادهشدهٔ مصاحبهها، ضبطهای گروه کانونی، جدولهایی با هزاران پاسخ باز، اسناد یا هر دادهٔ کیفی دیگری را به بیش از ۱۰۰ زبان پشتیبانیشده بارگذاری کنید. روند کاری دقیق و پایینبهبالای Skimle بینشها را شناسایی میکند و ساختار دستهبندی شفافی میسازد که آزادانه میتوانید ویرایشش کنید. میتوانید دادهها را با روشهای ترکیبی بصری کنید، با فراداده الگوها را کشف کنید، عامل هوش مصنوعی خود را از طریق MCP به دادههایتان وصل کنید، ارائههای گیرا بسازید و کارهای دیگر.
پلتفرم ما همچنین Skimle Ask را دارد، موتور پیمایش قدرتمندی با کمک هوش مصنوعی برای گردآوری بینشهای کیفی غنی در مقیاس بزرگ. راهنمای مصاحبه را تعریف کنید، پیوند را با پاسخدهندگان به اشتراک بگذارید و دادهها را با پاسخهای متنی، صوتی یا ویدیویی و پرسشهای تکمیلی هوشمند گردآوری کنید.
Skimle دقت دانشگاهی را با کاربردی بودن کسبوکار ترکیب میکند. بسیاری از ابزارهای هوش مصنوعی از تحلیل واقعی میگذرند و فقط خلاصهای باورپذیر اما غیرقابل دفاع تولید میکنند که مستعد سوگیری و توهم است. ابزارهای قدیمی مانند NVivo، MAXQDA یا ATLAS.ti شما را وادار میکنند بیشتر وقتتان را صرف کدگذاری دستی کنید، نه تحلیل واقعی. Skimle متفاوت ساخته شده است: روند کاری خودکار و دقیق تحلیل با هوش مصنوعی، با شفافیت کامل دوسویه و کنترل کاربر.
Skimle پلتفرم کامل تحلیل کیفی است
Skimle ابزاری همهکاره است که به شما امکان میدهد…
نمودار متحرکی از نحوهٔ کار Skimle. داده از چهار لولهٔ ورودی وارد میشود: پیادهسازی متن، بارگذاری سند، ورود مجموعهداده و مصاحبههای Skimle Ask. سپس از شیر ناشناسسازی وارد ماشین میشود، جایی که بینشها در موضوعها مرتب میشوند، با بصریسازی بررسی میشوند، بر اساس فراداده مقایسه میشوند و با دستیار پژوهشی هوش مصنوعی به بحث گذاشته میشوند. نتایج از سه لولهٔ خروجی بیرون میآیند: ارائهها، اتصالدهندههای API و MCP، و خروجی داده.
پژوهش دانشگاهی
مرور پیشینهٔ پژوهش
مقالهها و منابع ثانویه را وارد کنید، موضوعها را در صدها سند خودکار کدگذاری کنید و کاستیها و الگوهای پیشینه را بهجای چند هفته در چند ساعت شناسایی کنید.
بیشتر بخوانید →تحلیل مضمون
هوش مصنوعی Skimle موضوعهای تکرارشونده را در متن مصاحبهها شناسایی میکند و درخت دستههایی میسازد که میتوانید بازبینی، ویرایش و تأیید کنید؛ هر موضوع تا نقلقولهای مشخص قابل ردیابی است.
بیشتر بخوانید →نظریهٔ زمینهای
نظریه را بهشکل استقرایی از دادهٔ خام بسازید. Skimle متنهایتان را کدگذاری میکند، مفاهیم نوظهور را نمایان میکند و اجازه میدهد با شکلگیری الگوها نظام دستههایتان را بهتدریج پالایش کنید.
بیشتر بخوانید →کدگذاری استقرایی
با کدگذاری باز شروع کنید و بگذارید Skimle دستهها را مستقیم از دادههایتان پیشنهاد دهد. کدها را بازبینی، ادغام و تغییر نام دهید تا با نگاه تحلیلیتان جور شوند و در تمام مسیر کنترل کامل داشته باشید.
بیشتر بخوانید →کدگذاری قیاسی
یک نظام دستهٔ از پیش تعریفشده را روی اسنادتان اعمال کنید. Skimle دستههای شما را با دادههای تازه تطبیق میدهد و کاملاً شفاف نشان میدهد کدام نقلقولها هر کد را برانگیختهاند.
بیشتر بخوانید →روشهای ترکیبی
فرادادهٔ کمّی را با موضوعهای کیفی ترکیب کنید. دستههای کدگذاری را با ویژگیهای جمعیتی پاسخدهندگان جدول متقاطع کنید تا الگوهای معنادار آماری نمایان شوند.
بیشتر بخوانید →
تحقیقات بازار و بینش مشتری
تحقیقات کیفی بازار
مصاحبههای عمیق، گروههای کانونی و پاسخهای باز را در یک جا اجرا و تحلیل کنید: روند کامل تحقیقات کیفی بازار، از متن پیادهشده تا موضوعهای مستند به نقلقول.
بیشتر بخوانید →مطالعات گروه کانونی
گفتوگوهای گروه کانونی را پیاده و تحلیل کنید و پیگیری کنید چه کسی چه گفت و موضوعها میان گروههای شرکتکننده، تسهیلگران و جلسهها چگونه تفاوت دارند.
بیشتر بخوانید →مصاحبه با مشتریان
مصاحبههای عمیق را نظاممند کدگذاری کنید، اشباع را در کل برنامه شناسایی کنید و گزارشهای تمیز و مستند به نقلقول برای ارائه به مشتری خروجی بگیرید.
بیشتر بخوانید →صدای بازار
پاسخهای باز پیمایش را از نمونههای بزرگ گردآوری و کدگذاری کنید تا برداشتهای بازار، نیازهای برآوردهنشده و روندهای نوظهور را در بخشهای مختلف بفهمید.
بیشتر بخوانید →مصاحبههای متمرکز
با Skimle Ask مصاحبههای عمیق ساختاریافته انجام دهید، سپس پاسخها را خودکار کدگذاری و یافتهها را میان بخشهای پاسخدهنده بیدرنگ مقایسه کنید.
بیشتر بخوانید →
مشاوره و بررسیهای لازم
جمعبندی تماس با خبرگان
تماسهای شبکهٔ خبرگان را در سراسر پروژه پیاده و کدگذاری کنید. در کسری از زمان نمایی ساختاریافته از دیدگاه خبرگان دربارهٔ پویایی بازار، ریسکها و فرصتها بسازید.
بیشتر بخوانید →تحلیل دیدگاه ذینفعان
مصاحبه با ذینفعان و خروجی کارگاهها را نظاممند تحلیل کنید تا همهٔ صداها در توصیههای نهایی شما بازتاب یابند و قابل ردیابی باشند.
بیشتر بخوانید →خلاصهسازی اسناد
موضوعها و مواضع کلیدی را از مجموعهاسناد بزرگ، مانند گزارشهای نظارتی، گزارش شرکتها و مقالههای پژوهشی، در کسری از زمان استخراج کنید.
بیشتر بخوانید →تحلیل داده با هوش مصنوعی
از هوش مصنوعی Skimle برای کدگذاری و دستهبندی سریع دادهٔ کیفی مصاحبهها، پیمایشها و اسناد استفاده کنید تا مشاوران روی جمعبندی و تولید بینش تمرکز کنند.
بیشتر بخوانید →پژوهش کتابخانهای
منابع پژوهشی ثانویه را سامان دهید و تحلیل کنید، موضوعها را خودکار کدگذاری کنید و دقیقاً پیگیری کنید هر بینش از کجای مجموعهٔ اسناد آمده است.
بیشتر بخوانید →
متخصصان کنجکاو
مغز سازمانی
مخزنی کدگذاریشده و جستوجوپذیر از دانش سازمان بسازید: یادداشت جلسهها، اسناد راهبردی و پژوهشهایی که تیمتان در طول زمان از آنها پرسوجو، تحلیل و بر آنها بنا کند.
بیشتر بخوانید →تحلیل داده با هوش مصنوعی
هر دادهٔ بدون ساختاری، مانند ایمیلها، گزارشها و یادداشتها، را بارگذاری کنید و بگذارید Skimle آن را ساختاربندی و کدگذاری کند تا مواد خام پراکنده به دانشی سازمانیافته و جستوجوپذیر تبدیل شود.
بیشتر بخوانید →تحلیل اسناد
قراردادها، اسناد سیاستی یا مقالههای پژوهشی را تحلیل کنید تا بدون خواندن تکتک واژهها موضوعها و بینشهای کلیدی را استخراج کنید، با نقلقولهایی که تا منبع اصلی قابل ردیابیاند.
بیشتر بخوانید →تحلیل یکباره
روی هر مجموعهدادهای، مانند یادداشت مصاحبه، ایمیل مشتریان یا بازخورد، تحلیل ساختاریافتهٔ سریعی اجرا کنید، بدون تعهد به برنامهٔ پژوهشی طولانی یا یادگیری ابزاری پیچیده.
بیشتر بخوانید →جمعبندی مجموعهدادهها
بینشهای چند منبع داده را در یک نظام دستهٔ یکپارچه ترکیب کنید و موضوعهای مشترک و تفاوتهای میان مجموعهدادههای بافتهای مختلف را شناسایی کنید.
بیشتر بخوانید →
مدیریت محصول
تحلیل بازخورد مشتریان
نقدهای اپلیکیشن، تیکتهای پشتیبانی و پاسخهای پیمایش را در موضوعهای ساختاریافته گرد آورید. در هر حجمی از داده، دردسرهای اصلی و درخواستهای ویژگی را بیدرنگ شناسایی کنید.
بیشتر بخوانید →کشف مستمر
چرخههای سبک مصاحبه اجرا کنید و یافتهها را در مخزن پایدار بینش کدگذاری کنید. دنبال کنید موضوعها در طول نسخههای محصول و فصلهای کاری تیم چگونه تحول مییابند.
بیشتر بخوانید →پژوهش کاربر
جلسههای آزمون کاربردپذیری، مصاحبههای عمیق و مطالعات روزنگاری را پیاده و تحلیل کنید. بینشها را سریعتر نمایان کنید، بیآنکه غنای جزئیات کیفی موردنیاز تیمتان از دست برود.
بیشتر بخوانید →تحلیل گزارش تماسها
ضبط تماسهای فروش یا پشتیبانی را بارگذاری کنید، خودکار پیاده کنید و در مقیاس بزرگ کدگذاری کنید تا اعتراضهای تکراری، درخواستهای ویژگی و الگوهای احساس را بیابید.
بیشتر بخوانید →
منابع انسانی، کارکنان و فرهنگ
تحلیل مصاحبههای خروج
پاسخهای مصاحبهٔ خروج را در مقیاس بزرگ کدگذاری کنید تا ریسکهای نگهداشت، الگوهای مدیریتی و مشکلات نظاممند را پیش از گسترش در نیروی کار شناسایی کنید.
بیشتر بخوانید →پیمایشهای مشارکت کارکنان
پاسخهای باز پیمایش را به موضوعهای ساختاریافته تبدیل کنید. بفهمید چه چیزی مشارکت و نارضایتی را در تیمها، مکانها و گروههای سابقهٔ کار پیش میبرد.
بیشتر بخوانید →پیمایشهای کوتاه دورهای
با Skimle Ask مصاحبههای کوتاه و پرتکرار انجام دهید و دنبال کنید موضوعهای احساسی کارکنان در طول زمان چگونه تغییر میکنند تا منابع انسانی تصویری لحظهای از سلامت نیروی کار داشته باشد.
بیشتر بخوانید →پیمایشهای فرهنگ سازمانی
دادهٔ کیفی ارزیابی فرهنگ را تحلیل کنید تا شکاف میان ارزشهای اعلامشده و زیسته را بیابید، با ردیابی کامل تا نقلقولهای مشخص پاسخدهندگان برای گزارش به مدیریت.
بیشتر بخوانید →
بخش عمومی و تحلیل سیاست
تحلیل نظرخواهی عمومی
پاسخهای نظرخواهی عمومی را در مقیاس بزرگ تحلیل کنید، نظرهای ارسالی را کدگذاری کنید و رایجترین مواضع، نگرانیها و توصیهها را در میان هزاران ورودی بیابید.
بیشتر بخوانید →بررسی اسناد سیاستی
موضوعها و مواضع کلیدی را از اسناد سیاستی، گزارشهای نظارتی و متون قانونی استخراج کنید؛ هر یافته تا بخش منبع قابل ردیابی است.
بیشتر بخوانید →بازخورد ذینفعان
بازخورد ساختاریافتهٔ شهروندان، کاربران خدمات یا شریکان را نظاممند کدگذاری و تحلیل کنید تا همهٔ صداها ثبت و در گزارشها بازتاب داده شوند.
بیشتر بخوانید →ارزشیابی برنامه
دادهٔ مصاحبه و پیمایش شرکتکنندگان برنامه را تحلیل کنید تا اثر را بسنجید، موضوعهای تکرارشونده را نمایان کنید و گزارشهای ارزشیابی مستند تهیه کنید.
بیشتر بخوانید →
اتصال با MCP
استفاده از Skimle از درون Claude
Skimle را از طریق MCP به Claude وصل کنید و بدون تغییر بافت، به زبان طبیعی از دادههای پژوهشی، دستهها و بینشهایتان پرسوجو کنید.
بیشتر بخوانید →ساخت روندهای کاری هوش مصنوعی
با سرور MCP در Skimle دادهٔ پژوهش کیفی خود را در هر ابزار هوش مصنوعی سازگار با MCP یکپارچه کنید، گامهای تحلیل را خودکار کنید و نتایج را به روندهای گستردهتر بفرستید.
بیشتر بخوانید →پرسوجوی پژوهش با API
از طریق API بهصورت برنامهنویسی به دادهٔ Skimle دسترسی داشته باشید. پروژهها، اسناد، دستهها و بینشها را برای داشبوردهای سفارشی یا ابزارهای گزارشدهی بیرونی بازیابی کنید.
بیشتر بخوانید →
موضوعها از دل داده بیرون میآیند
هر تغییر ثبت میشود و قابل بازگشت است.
گام ۱
بارگذاری و گردآوری داده
ضبطها، اسناد و مجموعهدادهها را وارد کنید یا با مصاحبههای مبتنی بر هوش مصنوعی دادهٔ تازه گردآوری کنید و پیش از تحلیل ناشناسش کنید.
پیادهسازی متن صوت و ویدیو
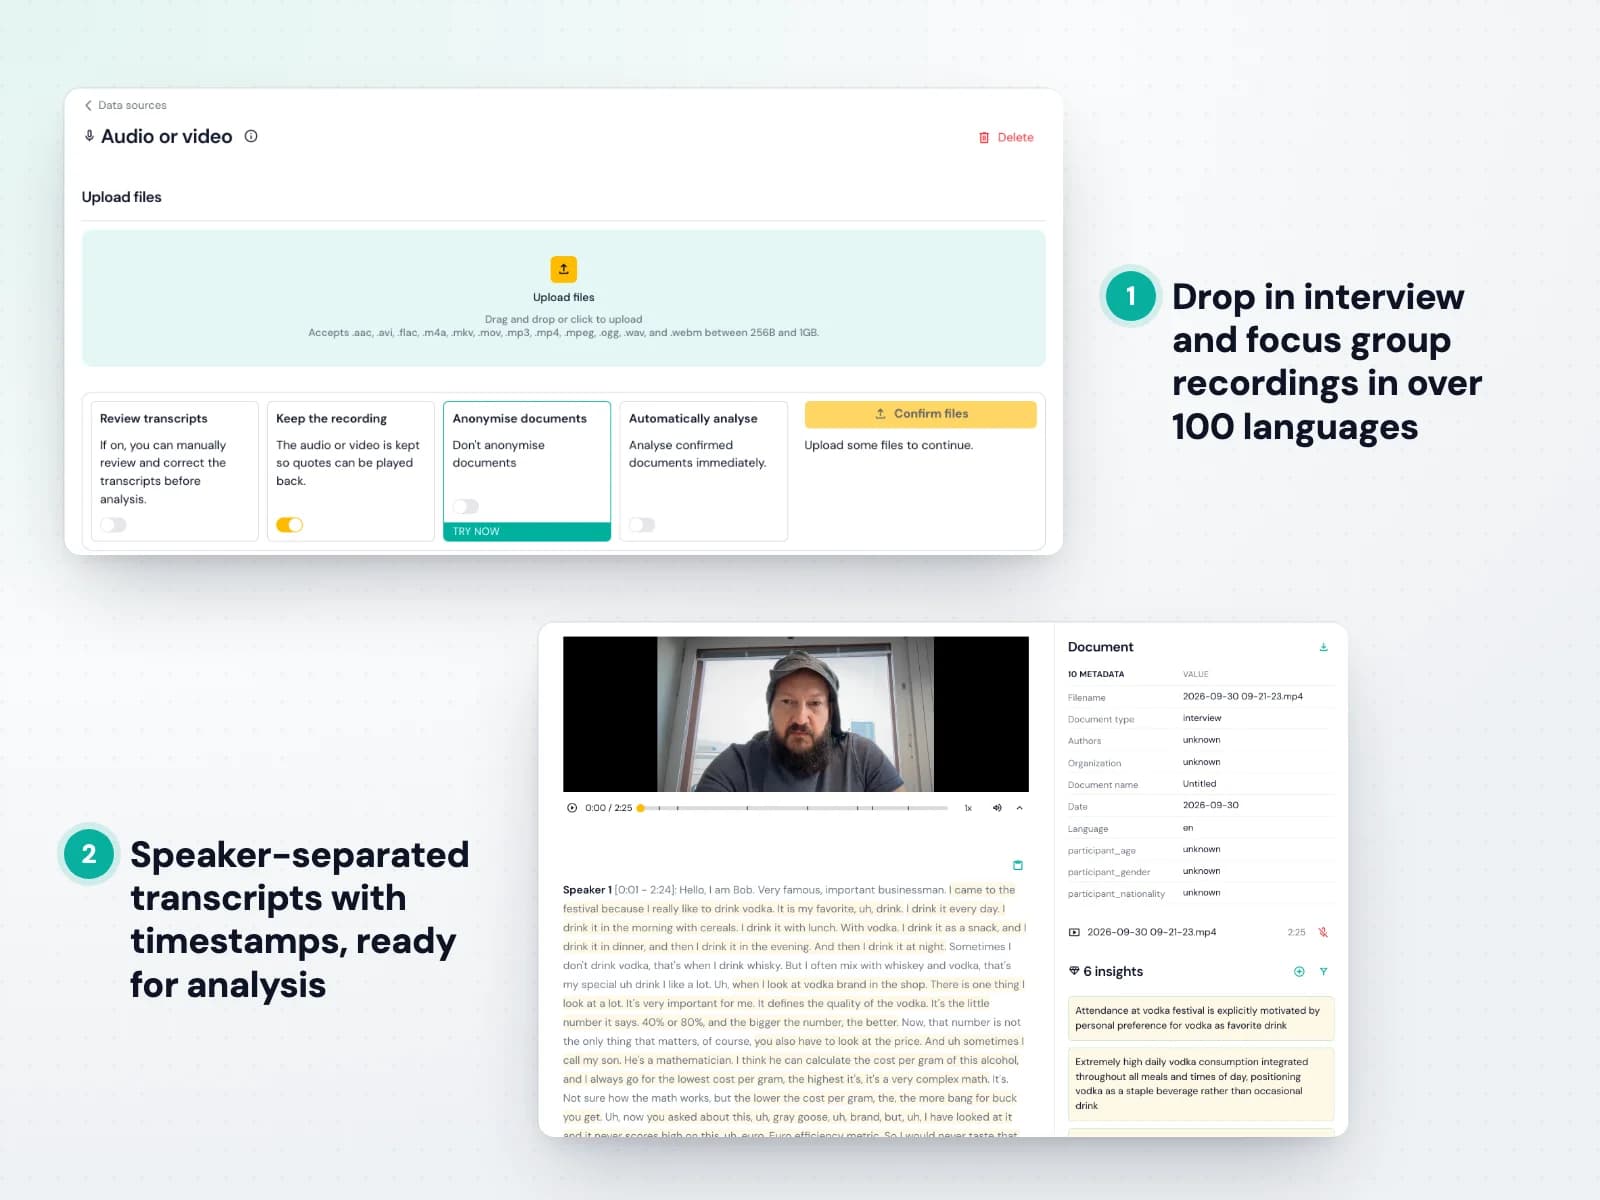
صوت یا ویدیو بارگذاری کنید تا Skimle آن را به متن پیادهشدهٔ دقیق و چندگوینده به بیش از ۱۰۰ زبان تبدیل کند. نه ابزار پیادهسازی جداگانهای لازم است و نه جابهجایی فایل میان سامانهها؛ متن مستقیم وارد پروژهٔ شما میشود. نحوهٔ بارگذاری ضبطها را ببینید.
برای هر منبع داده انتخاب میکنید که آیا پیش از تحلیل متنها را بازبینی کنید، هر ضبط برای پخش نگه داشته شود یا تا آماده شدن متنش حذف شود، و آیا پیش از هر کار دیگری متن ناشناس شود.
- MP3، M4A، WAV، MP4، MOV و دیگر قالبهای رایج
- تفکیک گویندهها و برچسب زمانی
- بازبینی دستی اختیاری پیش از تحلیل
بارگذاری اسناد
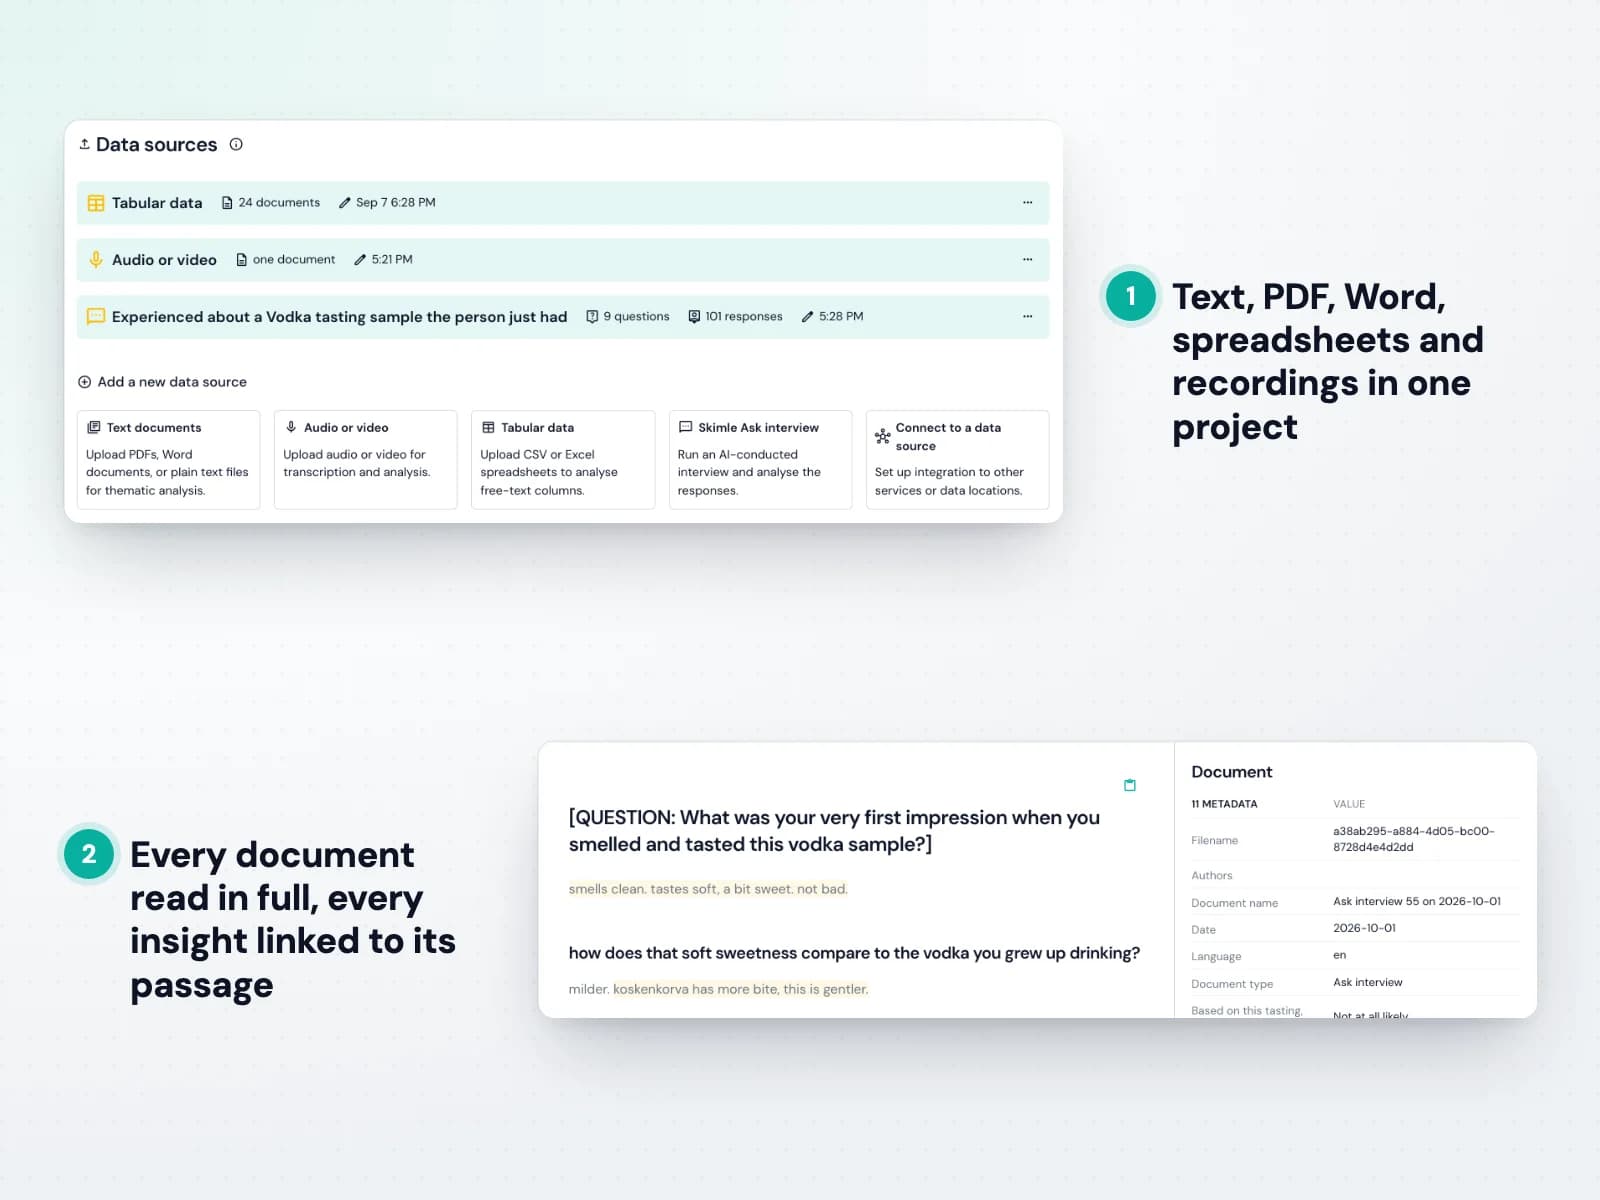
متن مصاحبهها، گزارشها، مقالهها، یادداشتها و پاسخهای باز را در همان قالبهایی که اکنون استفاده میکنید وارد کنید و زبانها را آزادانه در یک پروژه ترکیب کنید. قالبهای پشتیبانیشده را ببینید.
Skimle هر سند را کامل میخواند و از هر بینش پیوندی به بخش دقیقی که از آن آمده نگه میدارد؛ پس چیزی گم نمیشود و همه چیز قابل بررسی است.
- PDF، Word (DOCX)، RTF و TXT
- بیش از ۱۰۰ زبان، ترکیبشده در یک پروژه
- هر بینش پیوندخورده به بخش منبع خود
ورود مجموعهداده
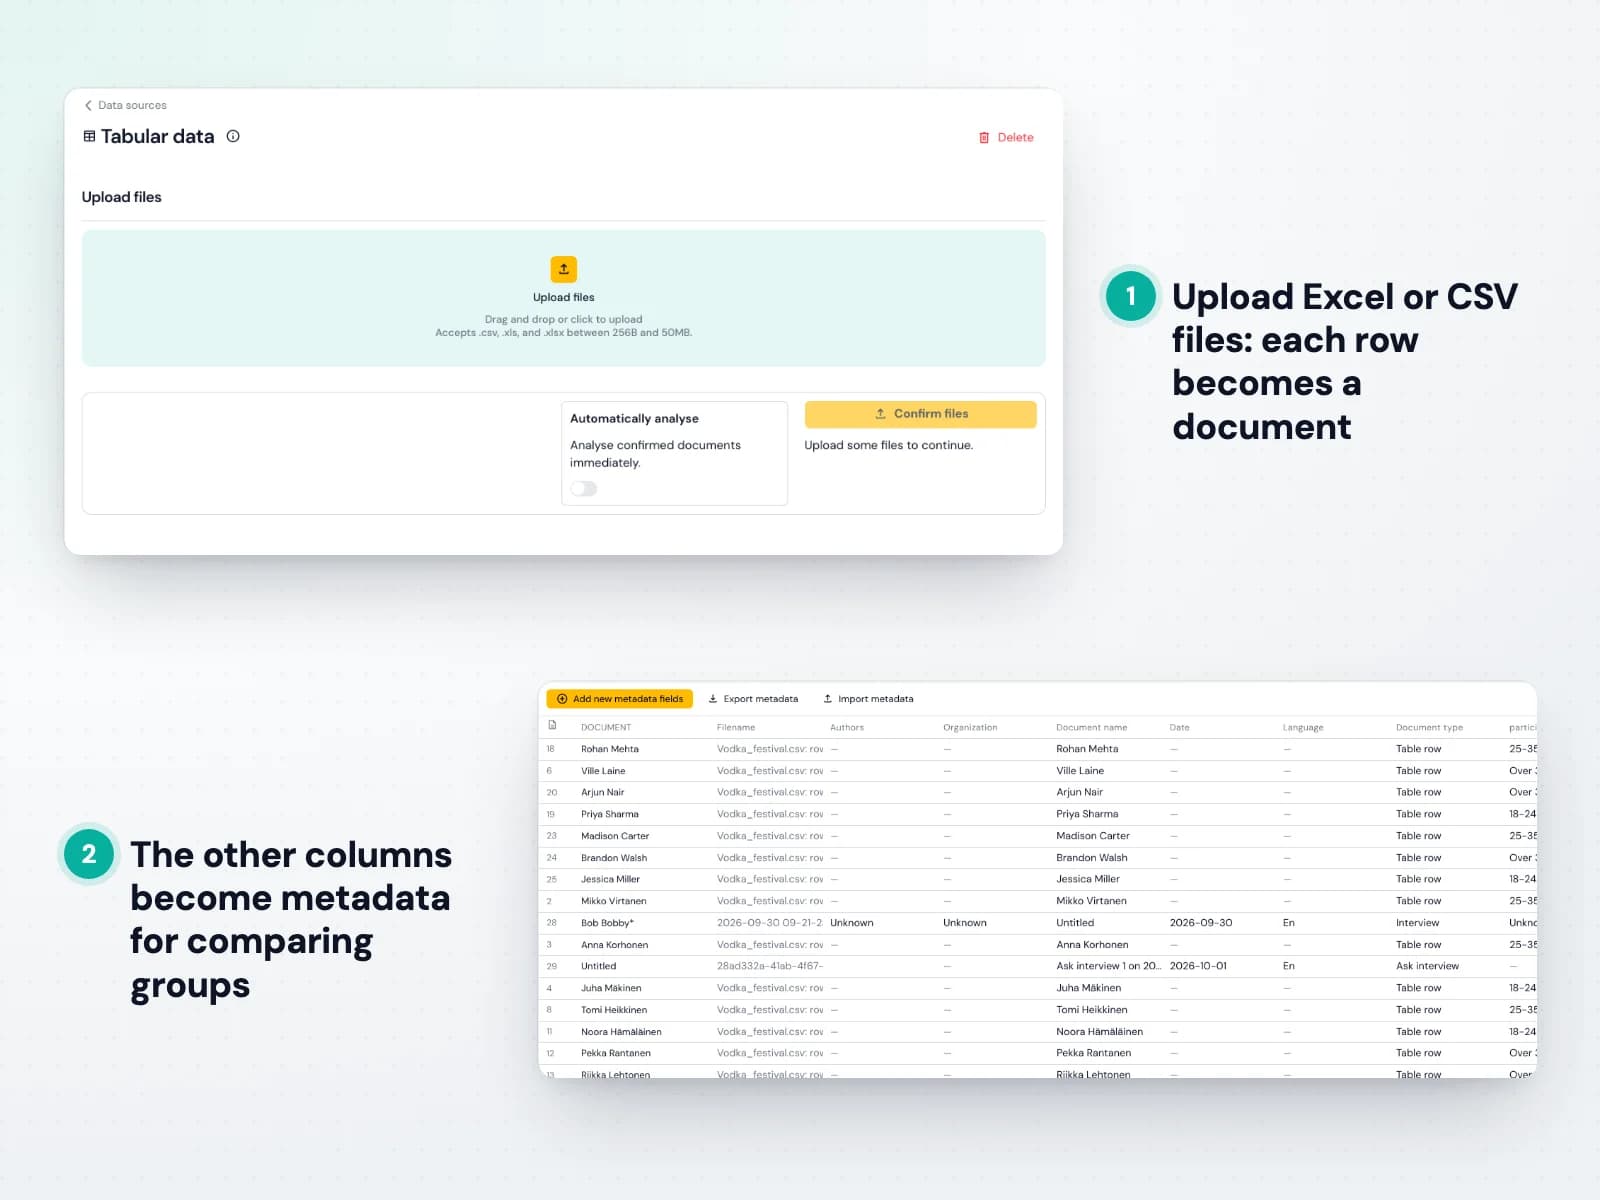
صفحهگستردهها و خروجیهای پیمایش را یکجا وارد کنید. هر ردیف یک سند میشود و برای هر ستون تعیین میکنید که محتوا باشد، فراداده یا نادیده گرفته شود. نحوهٔ ورود داده و افزودن فراداده را ببینید.
چون فراداده همراه هر پاسخ میماند، بعداً میتوانید گفتههای گروههای مختلف پاسخدهندگان را مقایسه کنید، مثلاً مشتریان تازه در برابر وفادار، یا یک منطقه در برابر منطقهٔ دیگر.
- ورود Excel و CSV
- انتخاب ستونهای محتوا و فراداده
- هزاران پاسخ در هر پروژه
مصاحبه با Skimle Ask
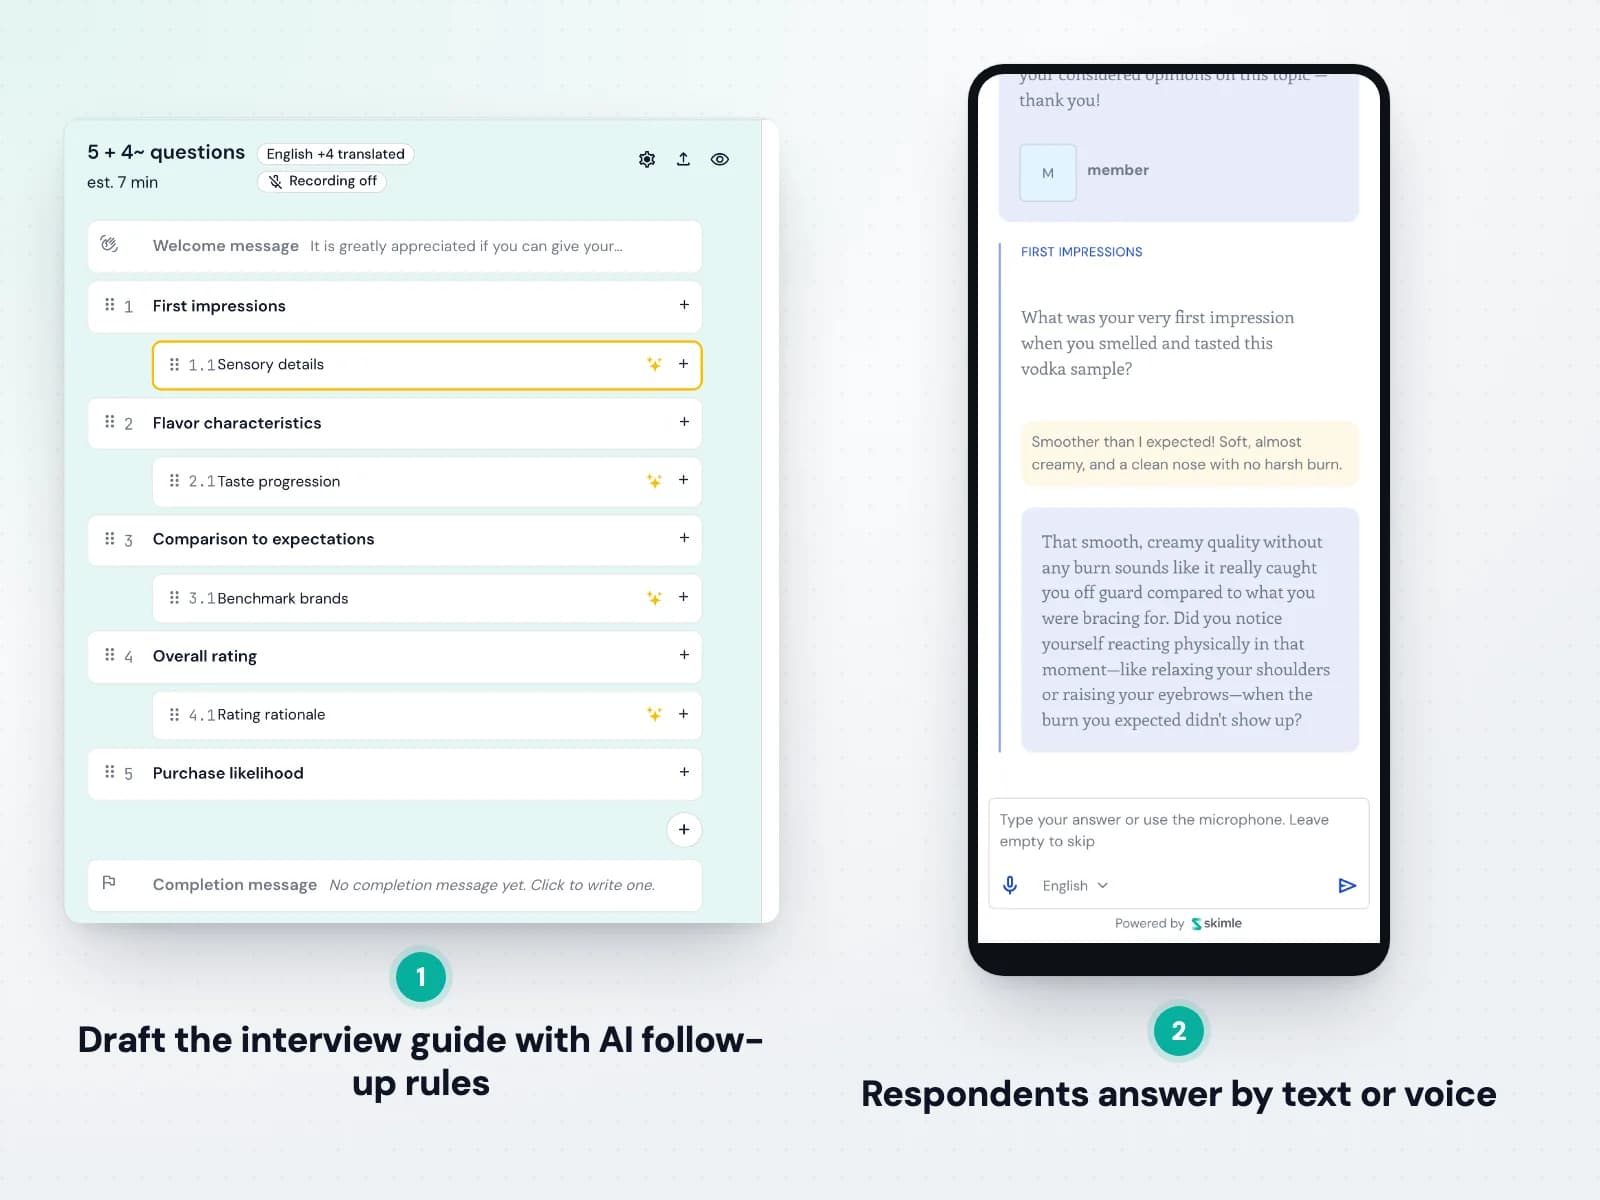
Skimle Ask مصاحبههای کیفی را در مقیاس پیمایش انجام میدهد. توضیح دهید چه میخواهید بدانید، بگذارید هوش مصنوعی پیشنویس راهنمای مصاحبه را بنویسد و هر پرسش و دستورالعمل پرسشهای تکمیلی آن را تنظیم کنید. نحوهٔ ساخت مصاحبهٔ Ask را ببینید.
پاسخدهندگان پیوند را باز میکنند، با متن یا صدا پاسخ میدهند و مصاحبهگر هوش مصنوعی مانند پژوهشگری کارآزموده جزئیات را میکاود. مصاحبههای تکمیلشده مستقیم همراه با دیگر دادههایتان وارد تحلیل میشوند.
- پرسشهای باز و چندگزینهای
- پرسشهای تکمیلی هوش مصنوعی با عمقی که شما تعیین میکنید
- مصاحبه به چند زبان

ناشناسسازی
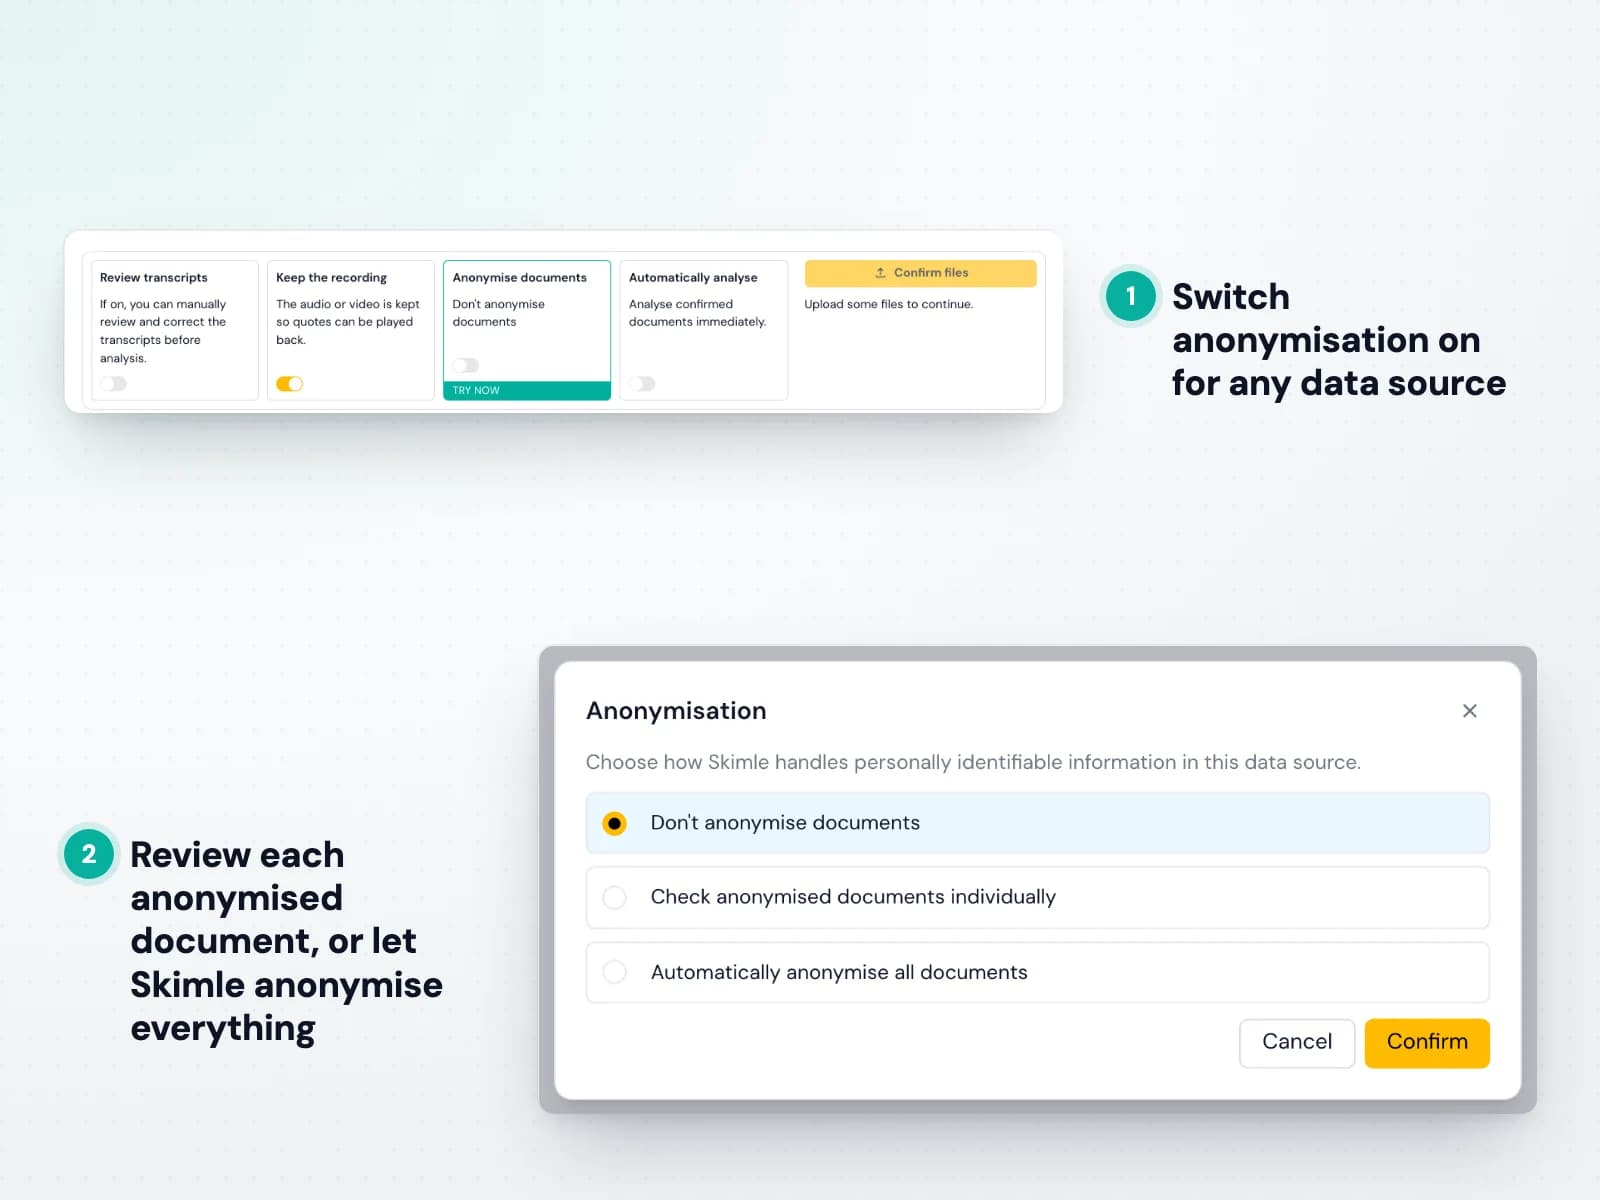
Skimle Anonymise شناسههای شخصی را در شش دسته شناسایی و پیش از تحلیل دادههایتان جایگزین میکند. آن را برای هر منبع داده روشن کنید و انتخاب کنید هر سند را بررسی کنید یا همه چیز بهطور خودکار ناشناس شود. نحوهٔ کار ناشناسسازی را ببینید.
یک فرد در همهٔ اسناد شما نام مستعار یکسانی میگیرد، پس تحلیل منسجم میماند و پاسخدهندگان با اطمینان از شناسایینشدن آزادانه حرف میزنند.
- نامها، نقشها، مکانها، سازمانها، تاریخها و دیگر شناسهها
- نامهای مستعار یکسان در همهٔ اسناد
- گزارش ممیزی و جدول تطبیق برای کمیتههای اخلاق
گام ۲
دادههایتان را تحلیل و بررسی کنید
موتور تحلیلی دقیق با شفافیت و کنترل کامل، نماهای روش ترکیبی، مقایسه با فراداده و یک دستیار پژوهشی هوش مصنوعی.
تحلیل دقیق در هسته
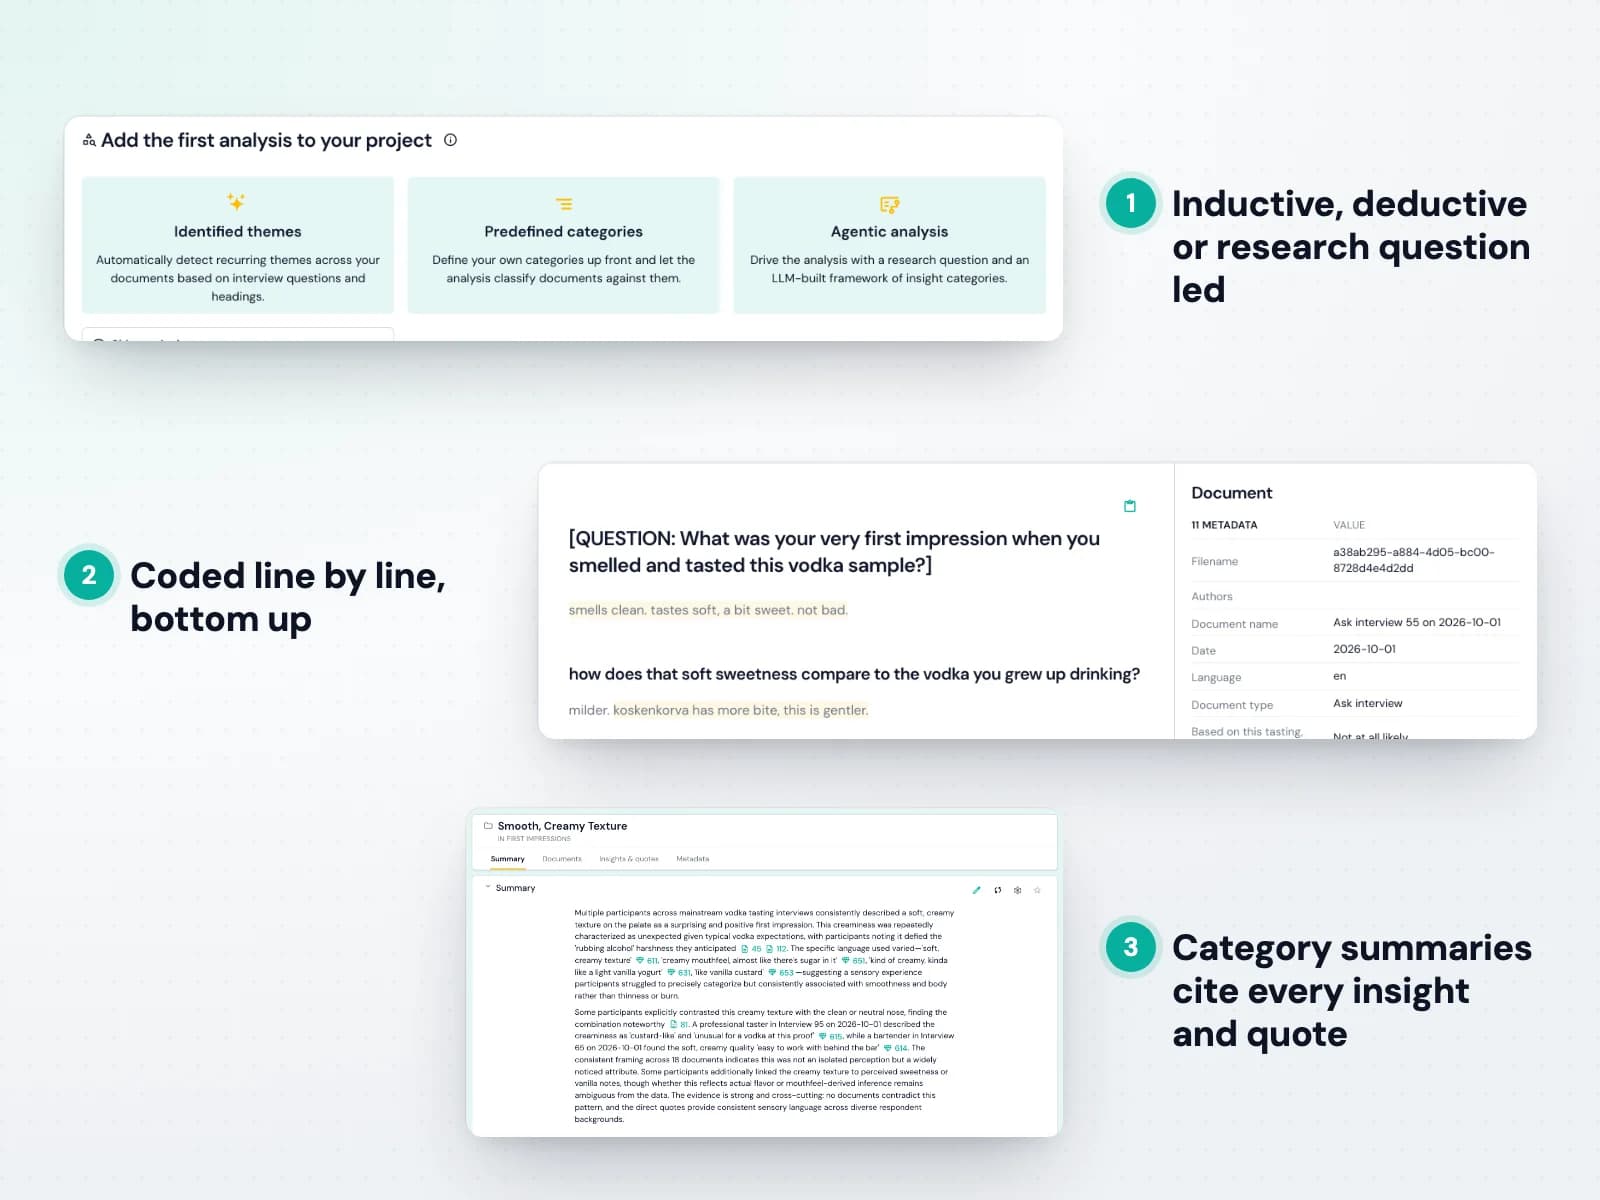
Skimle بهجای خلاصهنویسی از روشهای کیفی شناختهشده پیروی میکند. هر سند را کامل میخواند، بینشها را از پایین به بالا شناسایی میکند و آنها را در دستههایی سامان میدهد که هر یک به نقلقول منبعش پیوند دارد. نحوهٔ کار تحلیل را ببینید.
موضوعهای شناساییشده را انتخاب کنید تا ساختار از دل دادهها بیرون بیاید، دستههای از پیش تعریفشده را برای کدگذاری بر اساس نظام دستههای خودتان، یا تحلیلی عاملمحور که پرسش پژوهشی شما آن را هدایت میکند. سپس خلاصهٔ دستهها به همهٔ بینشها و نقلقولهایی که بر آنها تکیه دارند استناد میکنند.
- تحلیل استقرایی، قیاسی و مبتنی بر پرسش پژوهش
- هر بینش پیوندخورده به یک نقلقول عینی
- خلاصههایی که به شواهد خود استناد میکنند
کنترل کامل کاربر و شفافیت
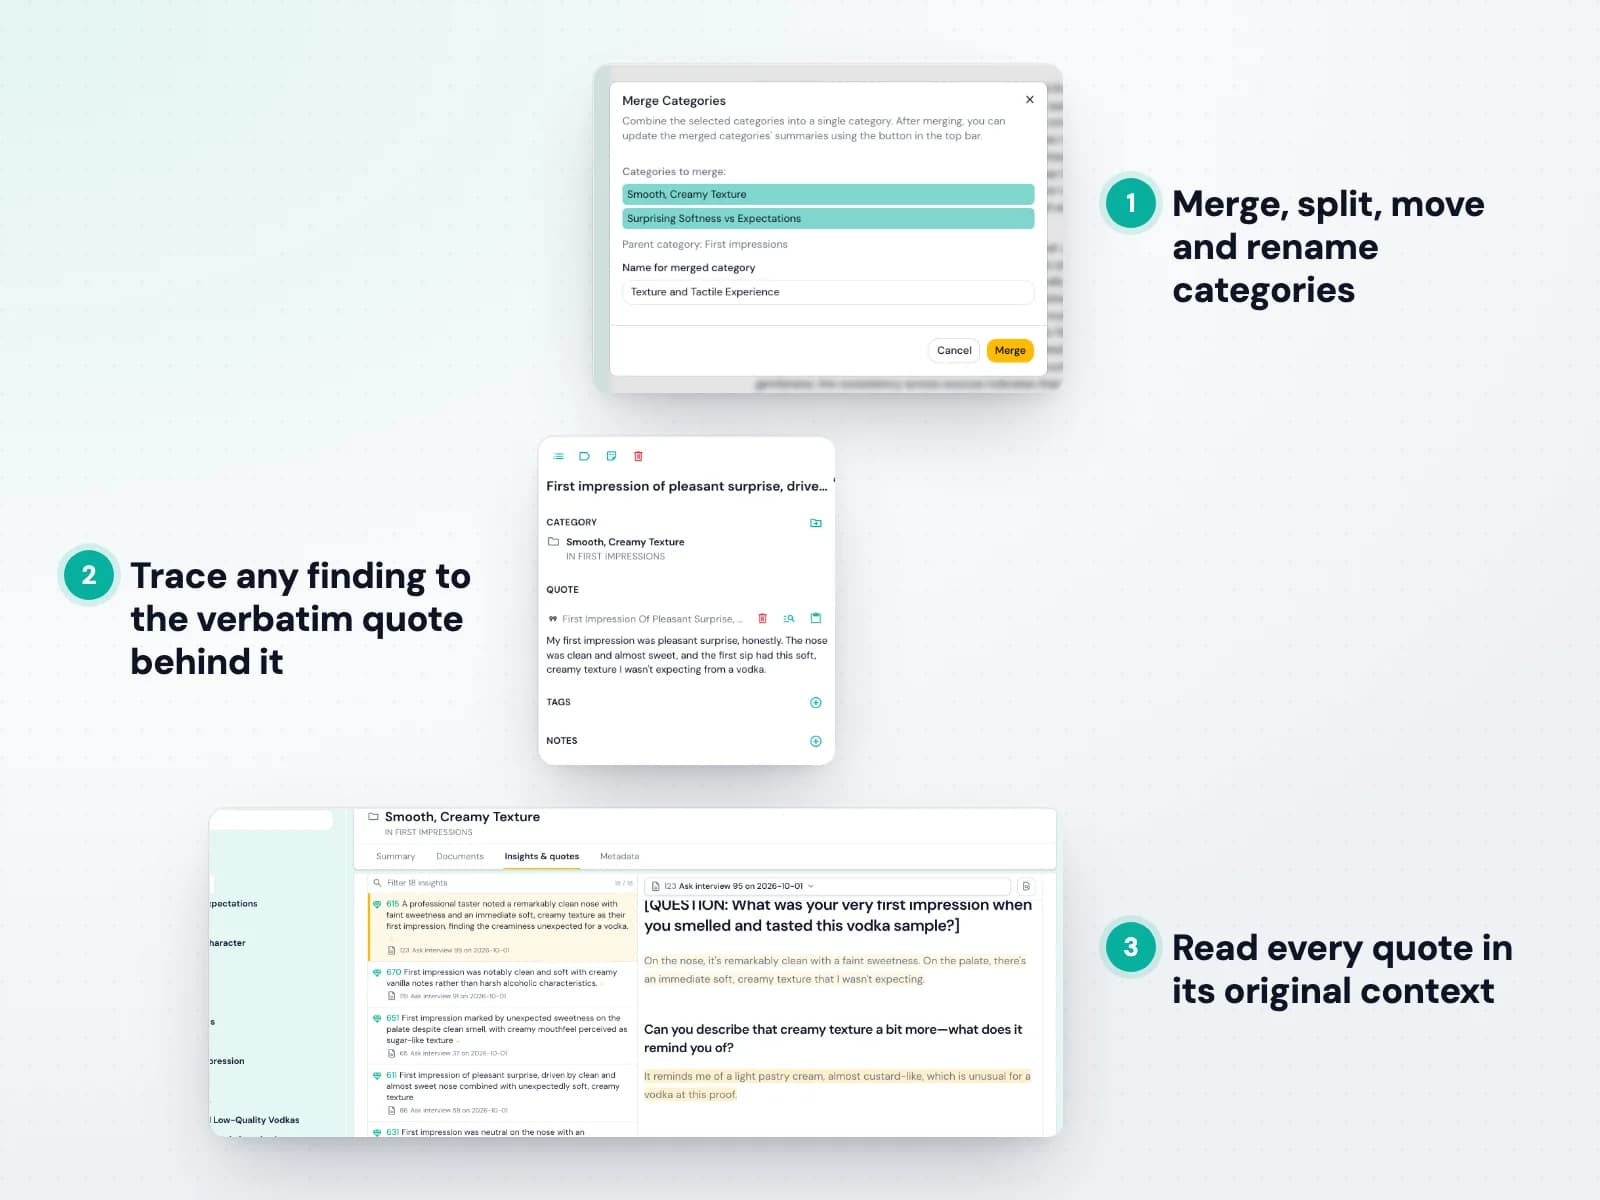
شفافیت دوسویهٔ Skimle یعنی همیشه میتوانید کارش را بررسی کنید. روی هر ارجاع در خلاصه کلیک کنید تا بینش و نقلقول عینی پشت آن را ببینید و سند را باز کنید تا دقیقاً ببینید چه چیزی کدگذاری شده و چه چیزی نه. نحوهٔ مدیریت دستهها را ببینید.
وقتی ساختار با فکر شما جور نیست، تغییرش دهید: دستههای همپوشان را ادغام کنید، دستههای بیش از حد گسترده را تفکیک کنید، با واژههای خودتان نامشان را عوض کنید و بینشها را میانشان جابهجا کنید. هر تغییری قابل بازگشت است.
- ادغام، تفکیک، جابهجایی و تغییر نام دستهها
- ردیابی یافتهها تا منبع و منابع تا یافتهها
- بازگرداندن هر تغییر
روشهای ترکیبی و بصریسازی داده
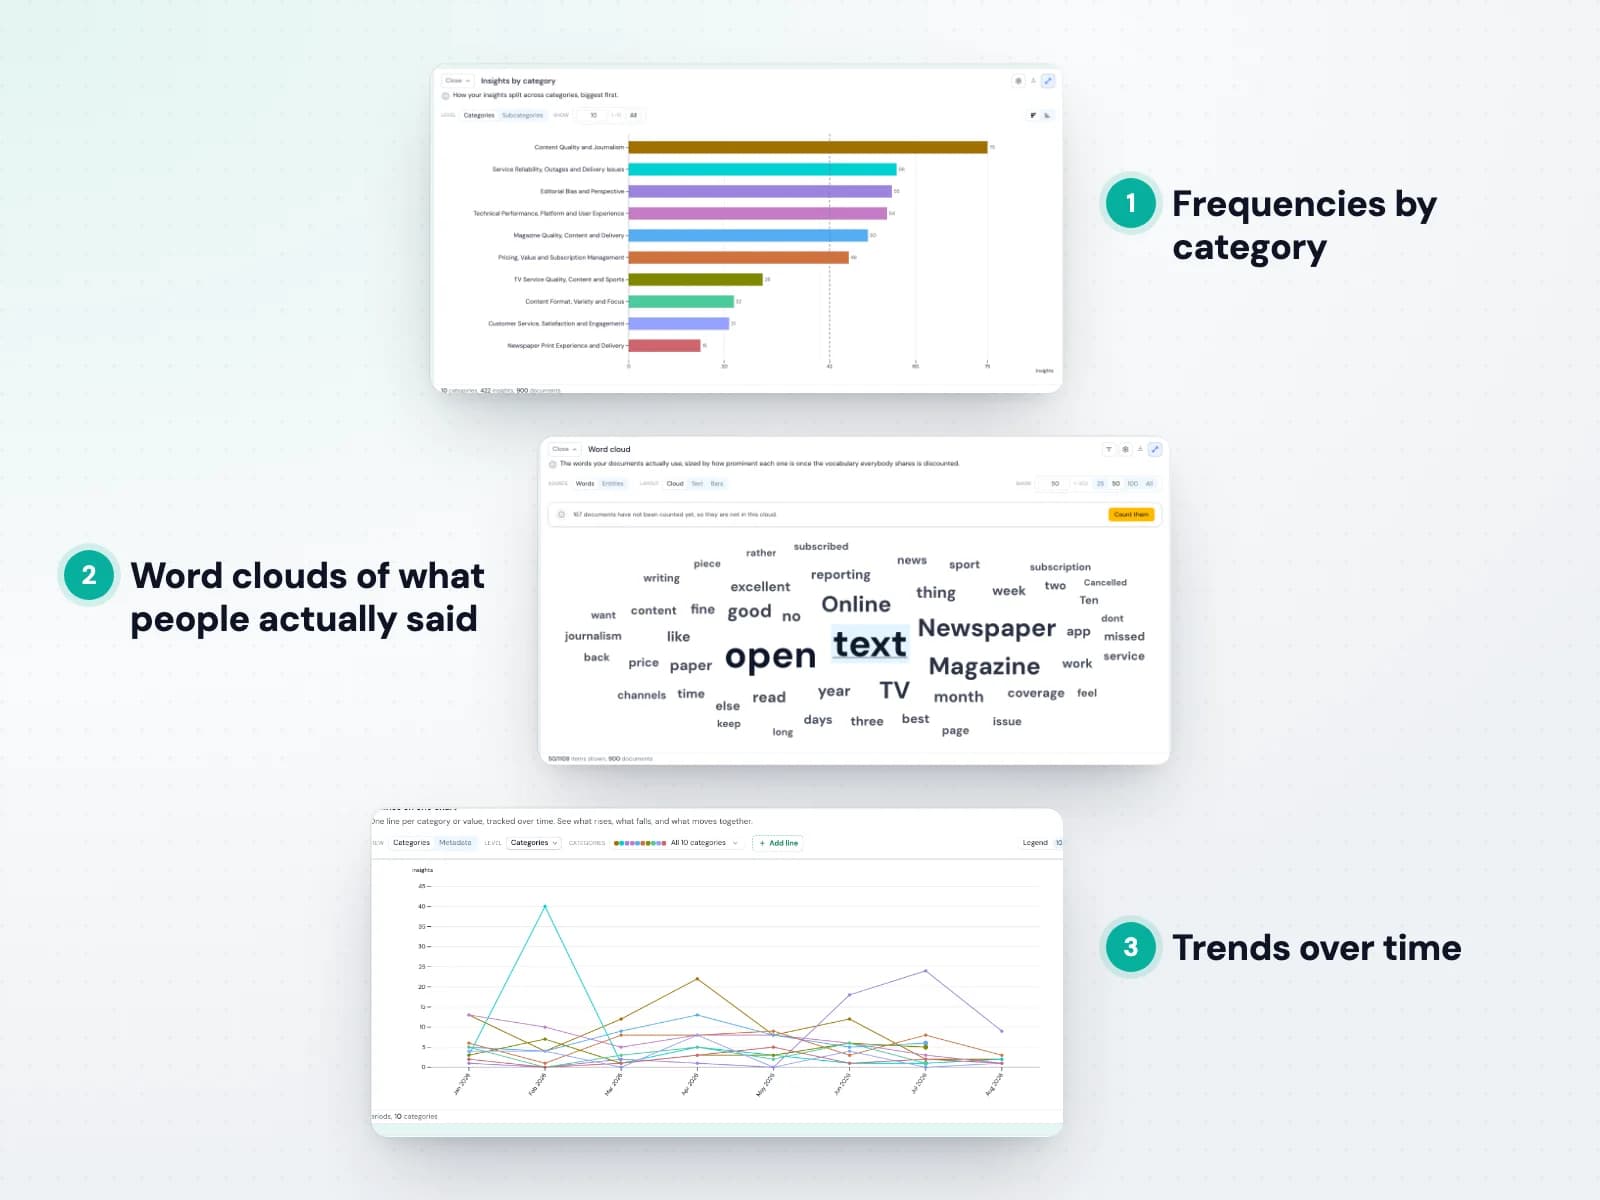
دادهٔ کدگذاریشدهٔ شما به عددهایی قابل اعتماد تبدیل میشود، چون هر شمارش بر بینشهای تأییدشده تکیه دارد. فراوانی بر اساس دسته، ابر واژه، نقشهٔ حرارتی میان اسناد و روندها در طول زمان را بررسی کنید. نمای آمار را ببینید.
نماها با پالایش ساختار بهروز میشوند و هر ستون یا نقطه شما را به بینشها و نقلقولهای پشتش میبرد؛ پس عددها و روایتها همیشه با هم جورند.
- فراوانی، ابر واژه و نقشهٔ حرارتی
- روندها در طول زمان
- هر عدد تا نقلقولهایش قابل ردیابی
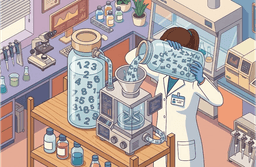
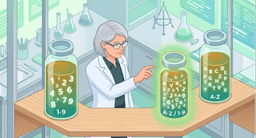
کشف الگوها با فراداده

هر دو گروه از اسناد را بر اساس فرادادهشان مقایسه کنید تا Skimle نشان دهد هر گروه کدام دستهها را بیشتر از دیگری مطرح میکند. سپس مینویسد چه چیزی دو گروه را از هم جدا میکند و چه چیزی میانشان مشترک است، همراه با ارجاع. نحوهٔ تحلیل فراداده را ببینید.
مطمئن نیستید کدام تفکیک مهم است؟ Skimle هر تفکیک فرادادهای را بر اساس میزان فاصلهای که میان گروهها ایجاد میکند رتبهبندی میکند تا بهجای آزمودن یکییکی، تفاوتهای ارزشمند برای گزارش را بیابید.
- مقایسهٔ گروهها با خلاصهٔ نوشتاری
- هر تفکیک رتبهبندیشده بر اساس اندازهٔ اثر
- فراداده از دادههای شما یا استنباطشده با هوش مصنوعی
گفتوگوی عاملمحور بهعنوان دستیار پژوهشی شما
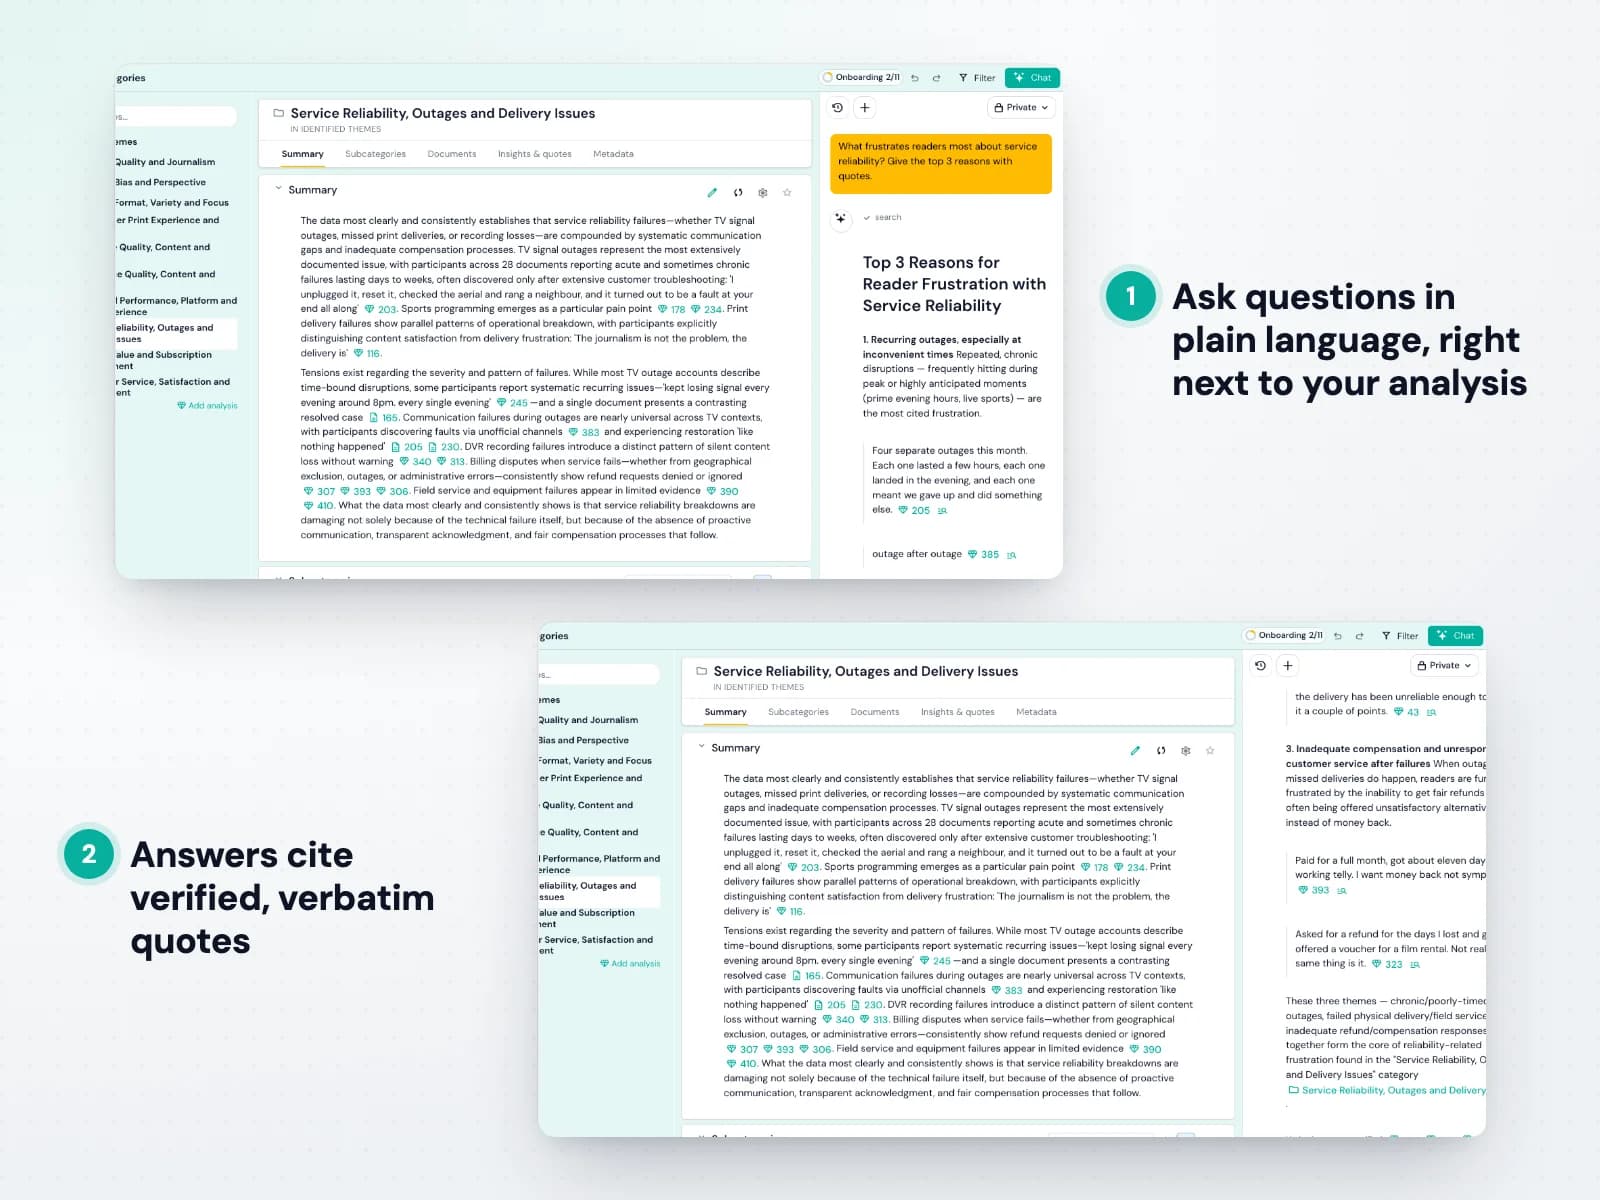
دستیار پژوهشی بهجای اسناد خام روی تحلیل ساختاریافتهٔ شما کار میکند. پرسشهایتان را به زبان ساده بپرسید تا در بینشهای کدگذاریشده جستوجو کند، گامبهگام و قابل پیگیری استدلال کند و با نقلقولهای عینی تأییدشده پاسخ دهد. نحوهٔ استفاده از گفتوگوی هوش مصنوعی را ببینید.
دستیار میتواند روی تحلیل هم اقدام کند: بینش بسازد، دستهها را دوباره سازمان دهد و یادداشت بیفزاید؛ همه با همان فرمانهایی که خودتان استفاده میکنید، تا هر تغییر دیدنی و برگشتپذیر بماند.
- پاسخهای متکی بر نقلقولهای تأییدشده
- جستوجو در همهٔ بینشهای کدگذاریشده
- توانایی سازماندهی دوباره و حاشیهنویسی تحلیل
گام ۳
خروجی و یکپارچهسازی
یافتهها را بهصورت ارائه و گزارش به اشتراک بگذارید، به ابزارهایی که استفاده میکنید خروجی بدهید و سامانهها و عاملهای هوش مصنوعی خود را وصل کنید.
ارائههای گیرا
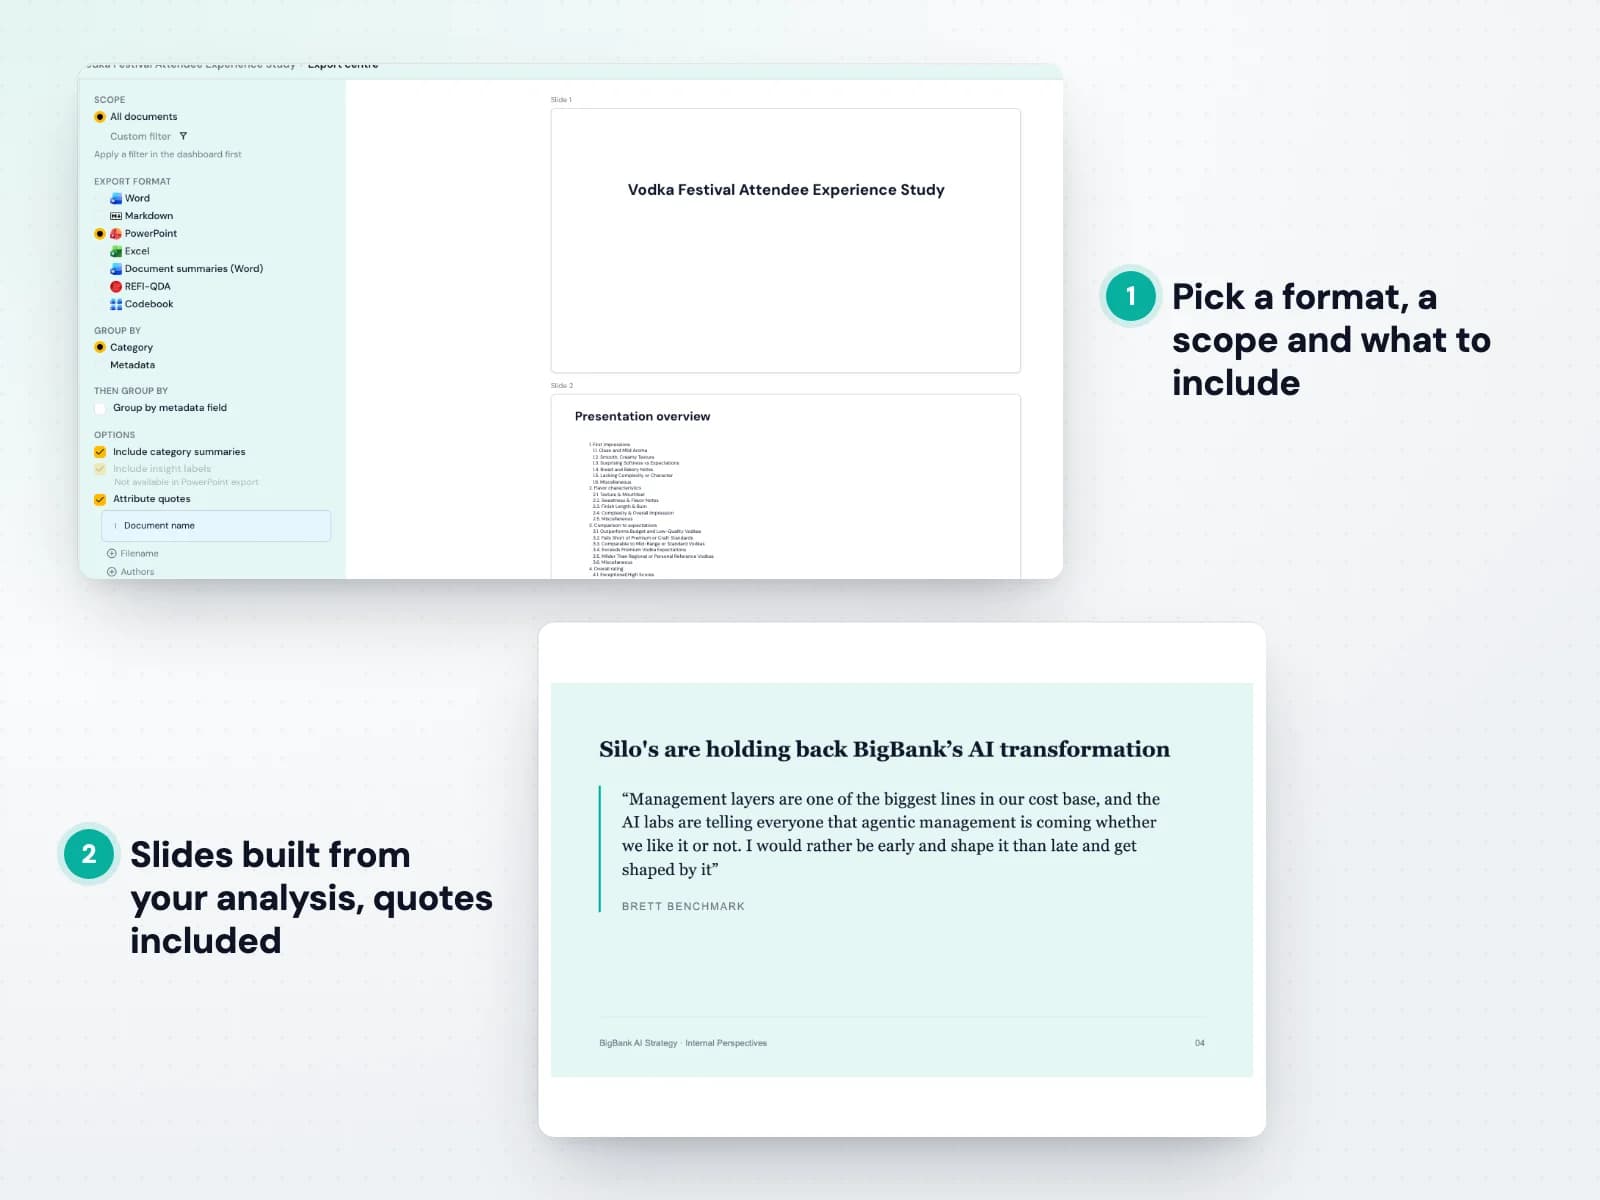
تحلیلتان را بهصورت اسلاید PowerPoint یا گزارش Word خروجی بگیرید. دامنه را انتخاب کنید، یافتهها را بر اساس دسته یا فراداده گروهبندی کنید و تعیین کنید خلاصهها، ارجاعها و نقلقولهای منتسب گنجانده شوند یا نه. نحوهٔ خروجی گرفتن به Office را ببینید.
نتیجه نقطهٔ شروعی آماده برای گزارش یا ارائهٔ شماست: موضوعها، شواهد و نقلقولها از پیش در جای خود، و هر کدام قابل ردیابی تا تحلیل.
- اسلایدهای PowerPoint و گزارشهای Word
- خلاصهها، ارجاعها و نقلقولهای منتسب
- دامنه و گروهبندی به انتخاب شما
اتصالدهندههای API و MCP
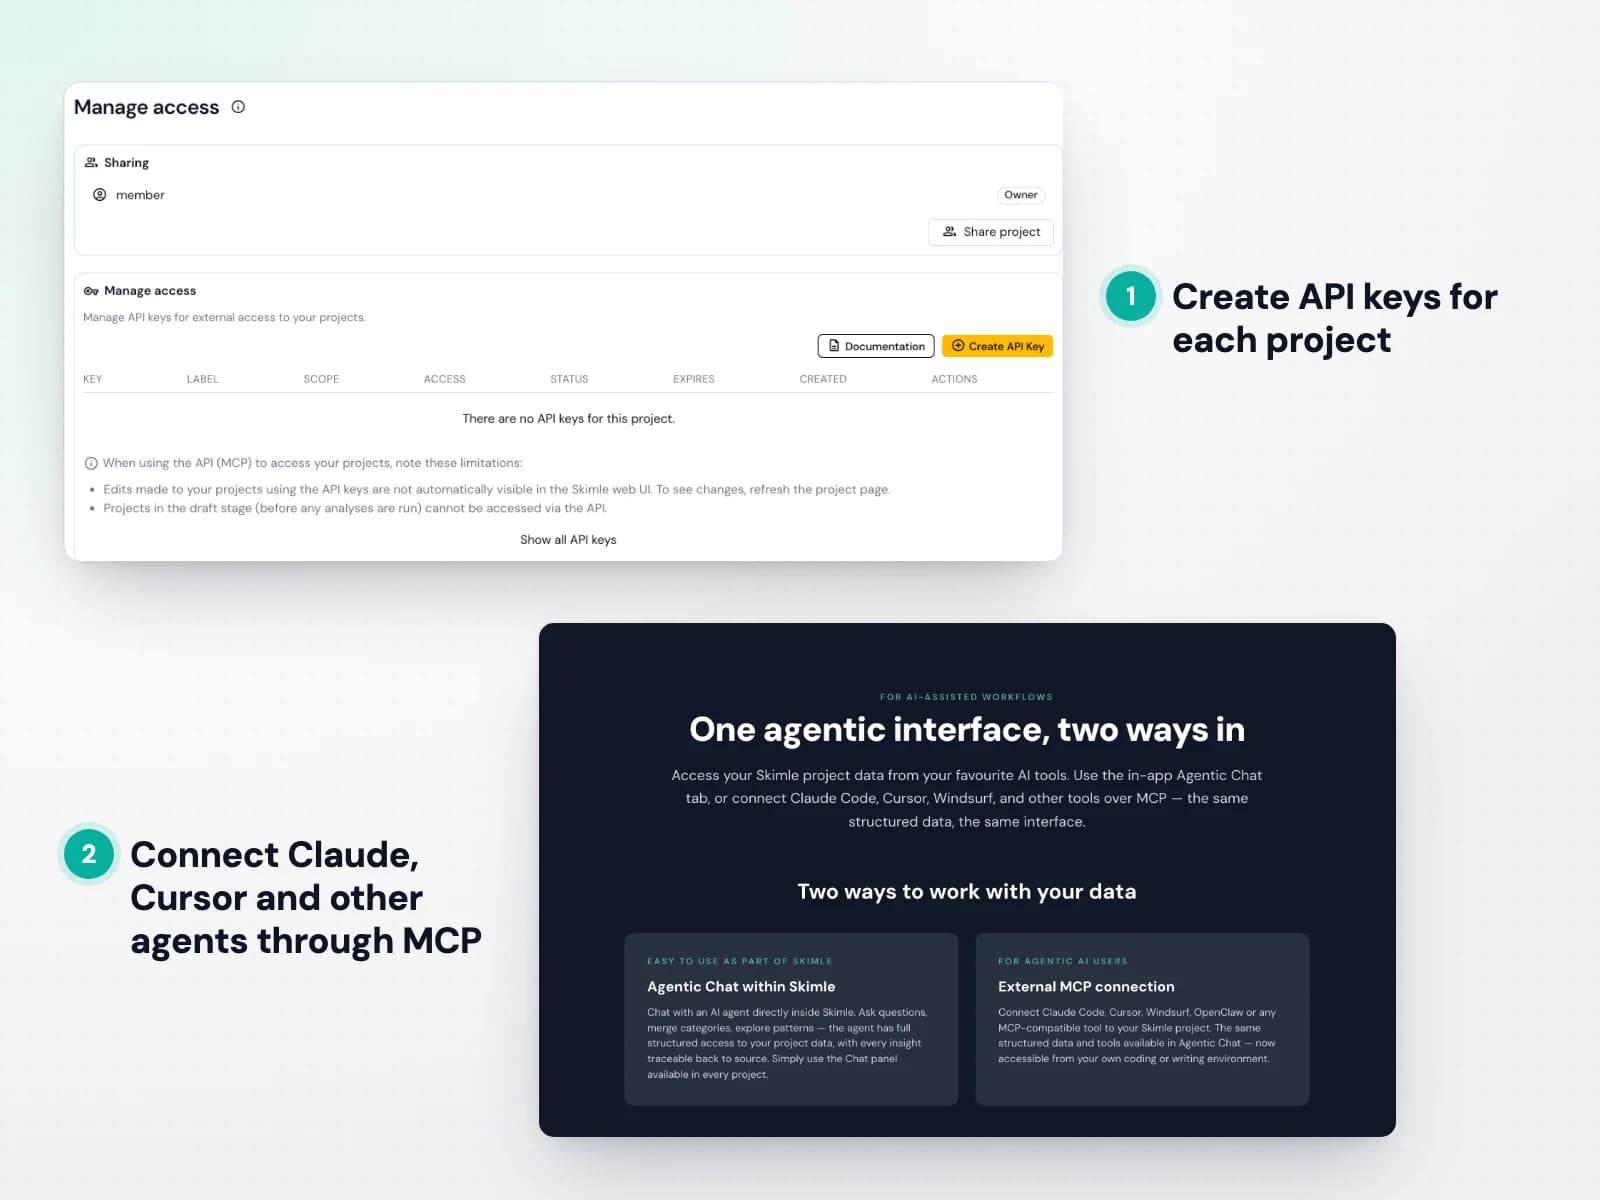
سرور MCP در Skimle به Claude، Cursor، Windsurf و دیگر عاملهای سازگار امکان میدهد با دادهٔ ساختاریافتهٔ پروژهٔ شما کار کنند، با همان ابزارهایی که عامل درون برنامه به کار میبرد. دربارهٔ اتصال با MCP بیشتر بخوانید.
REST API به سامانههای خودتان امکان میدهد دادهٔ پروژه را بخوانند و بنویسند یا یک پروژه را از آغاز تا پایان اجرا کنند. از تنظیمات دسترسی پروژه، برای هر پروژه کلید API با دسترسی خواندن یا ویرایش بسازید.
- MCP برای Claude، Cursor و دیگر عاملها
- REST API برای خواندن و نوشتن دادهٔ پروژه
- کلید API برای هر پروژه
خروجی داده
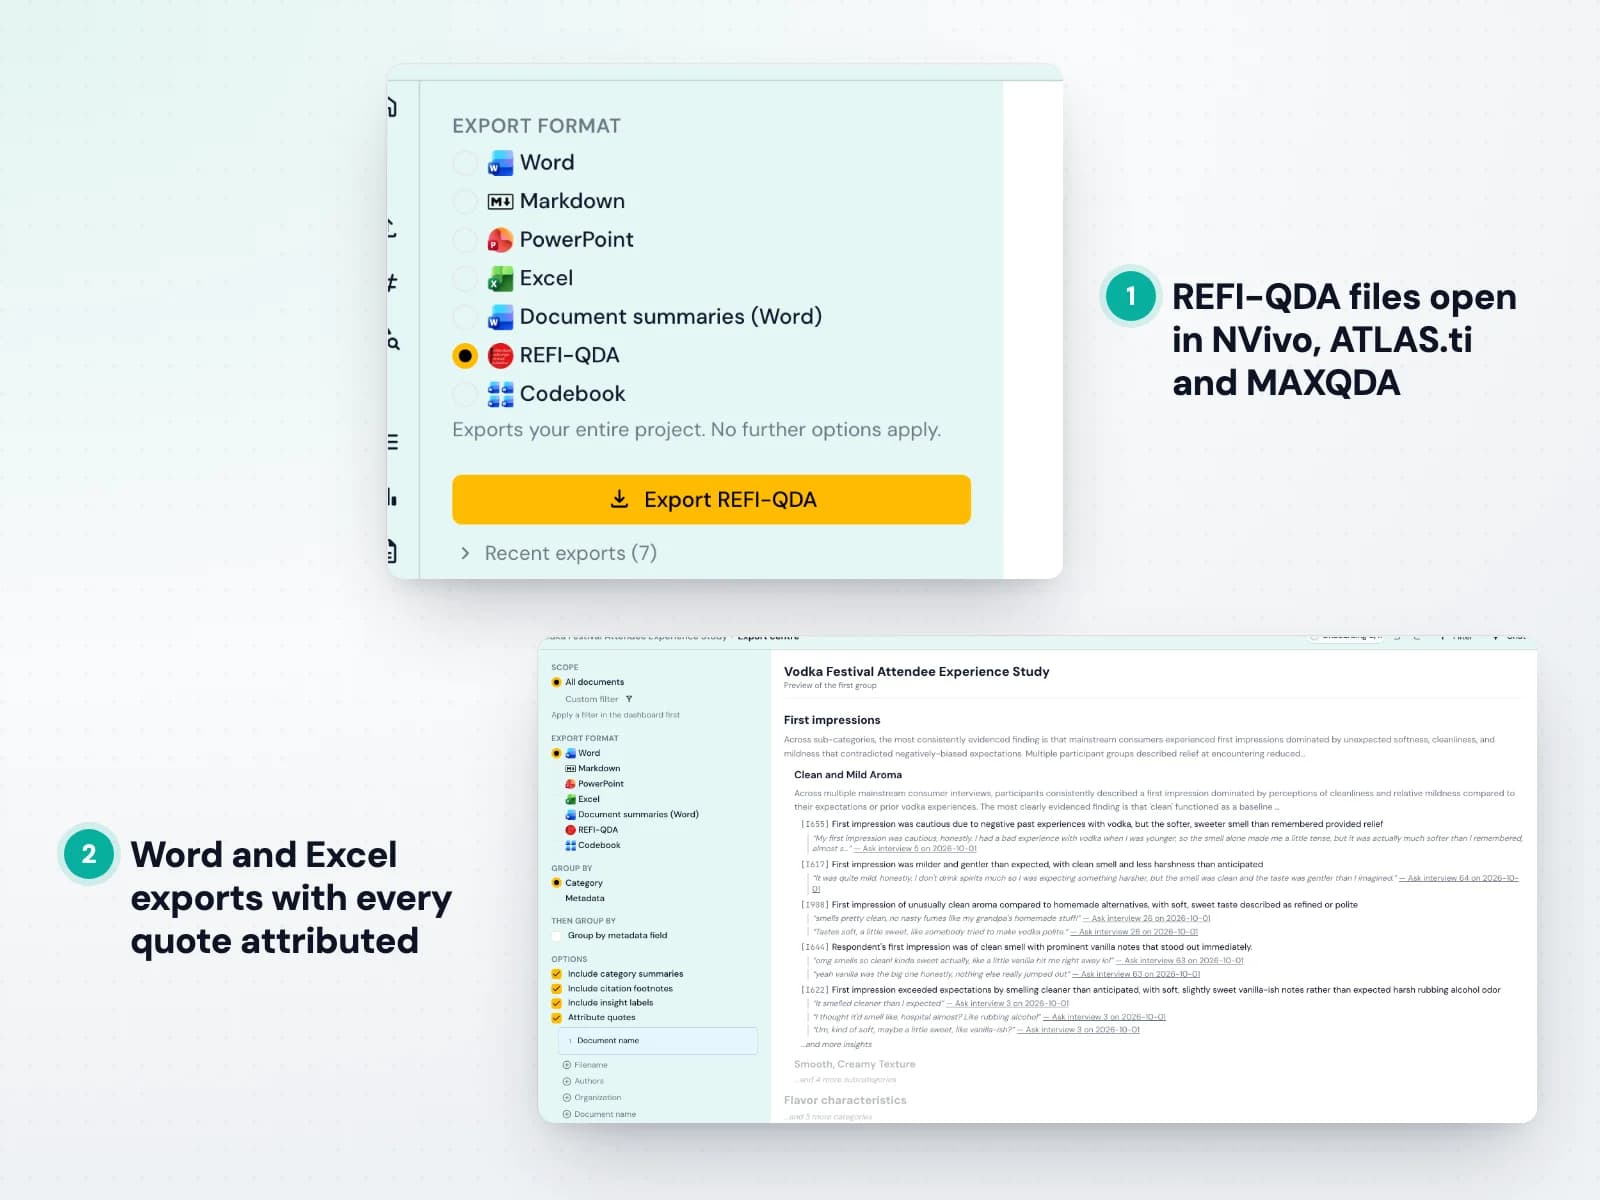
تحلیلتان را هر جا لازم است ببرید: Excel برای کل جدول Skimle، Word با نمایش کدگذاری بهصورت توضیح، و قالب باز REFI-QDA برای NVivo، ATLAS.ti و MAXQDA. نحوهٔ خروجی گرفتن به REFI-QDA را ببینید.
نظام دستهها را خروجی بگیرید، نسخهای از کل تحلیل را کنار دادههای پژوهشیتان نگه دارید یا کدگذاری دستی را در یک ابزار قدیمی ادامه دهید.
- Excel، Word و REFI-QDA (qdpx)
- خروجی نظام دستهها
- سازگار با NVivo، ATLAS.ti و MAXQDA
پلتفرم
پلتفرمی امن برای همکاری
حفاظت از داده در سطح سازمانی، با همکاری تیمتان روی یک تحلیل مشترک.
پلتفرم امن
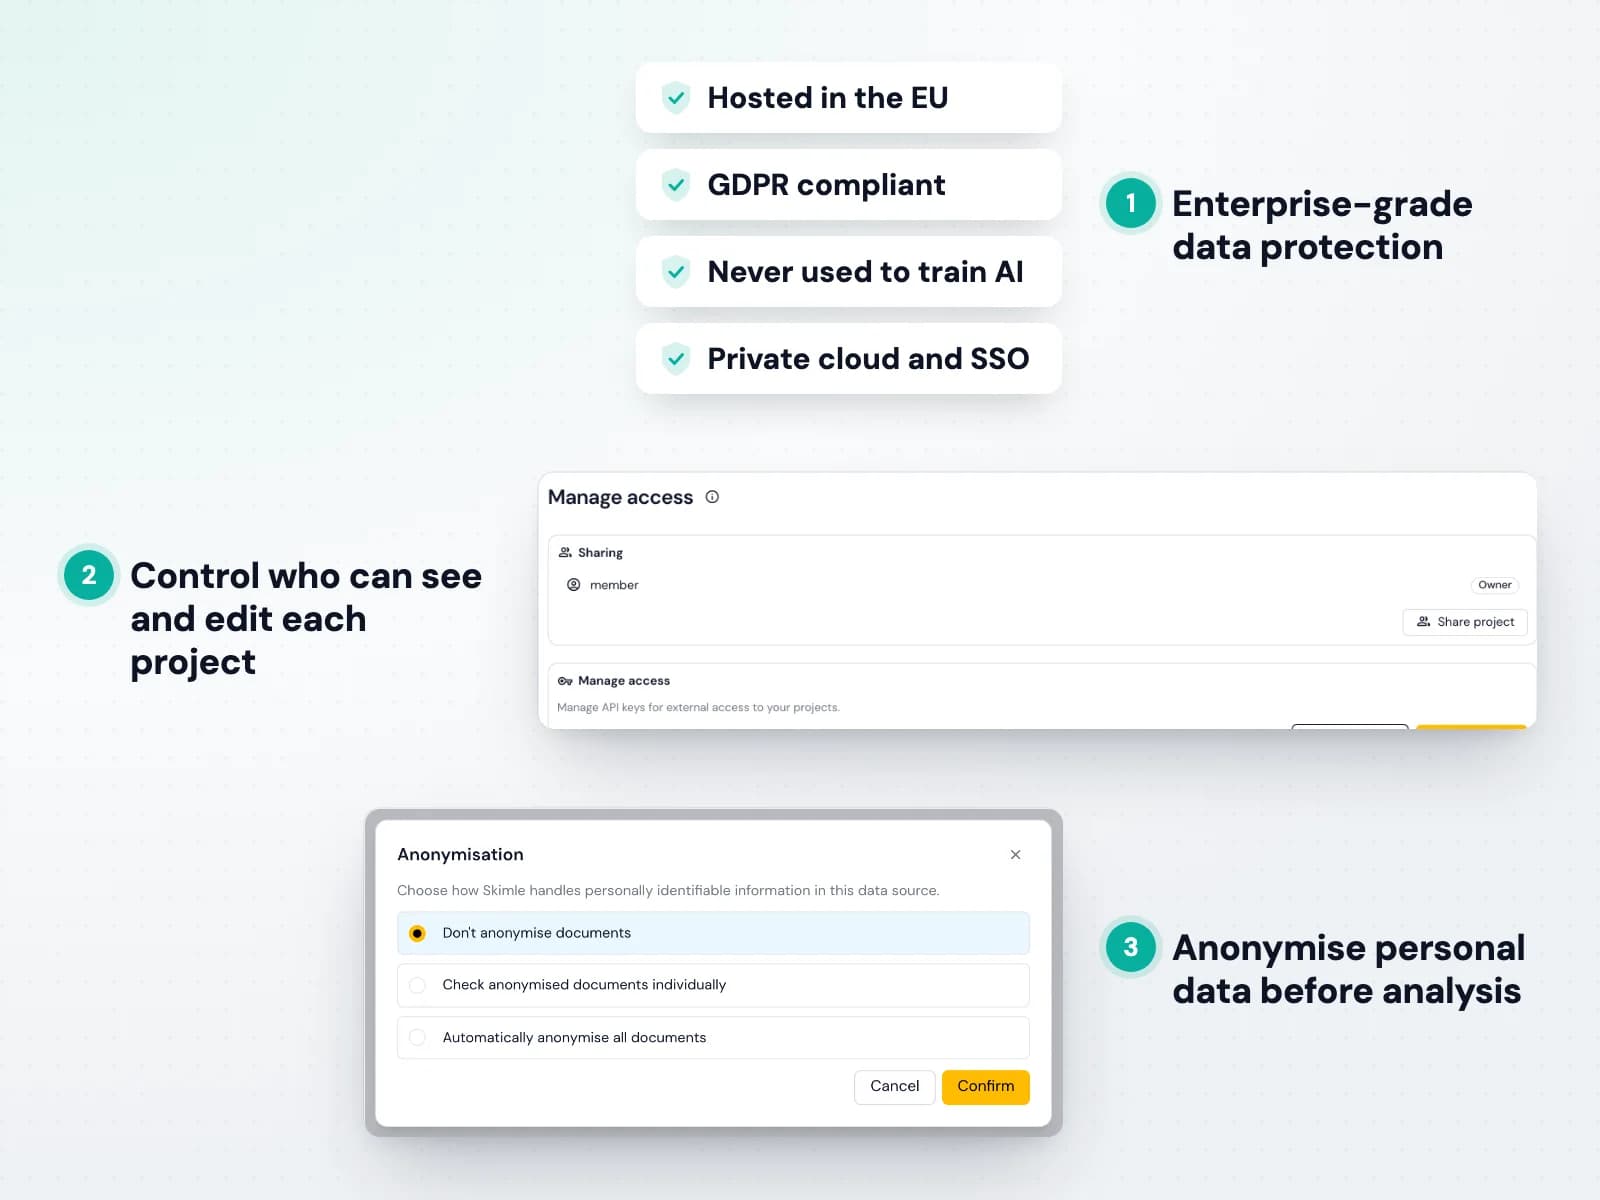
Skimle برای پژوهشهای حساس ساخته شده است. همهٔ دادهها در اتحادیهٔ اروپا میزبانی میشوند، هنگام انتقال و ذخیره رمزگذاری میشوند و هرگز برای آموزش مدلهای هوش مصنوعی استفاده نمیشوند. سیاست حریم خصوصی ما را بخوانید.
شما تعیین میکنید چه کسی هر پروژه را ببیند و ویرایش کند، دادهٔ شخصی را میتوان پیش از تحلیل ناشناس کرد و توافقنامهٔ پردازش داده در دسترس است. مشتریان سازمانی میتوانند استقرار ابر خصوصی و ورود یکپارچه را انتخاب کنند.
- میزبانی در اتحادیهٔ اروپا و انطباق با GDPR
- هرگز برای آموزش مدلهای هوش مصنوعی استفاده نمیشود
- ابر خصوصی و SSO برای سازمانها
همکاری
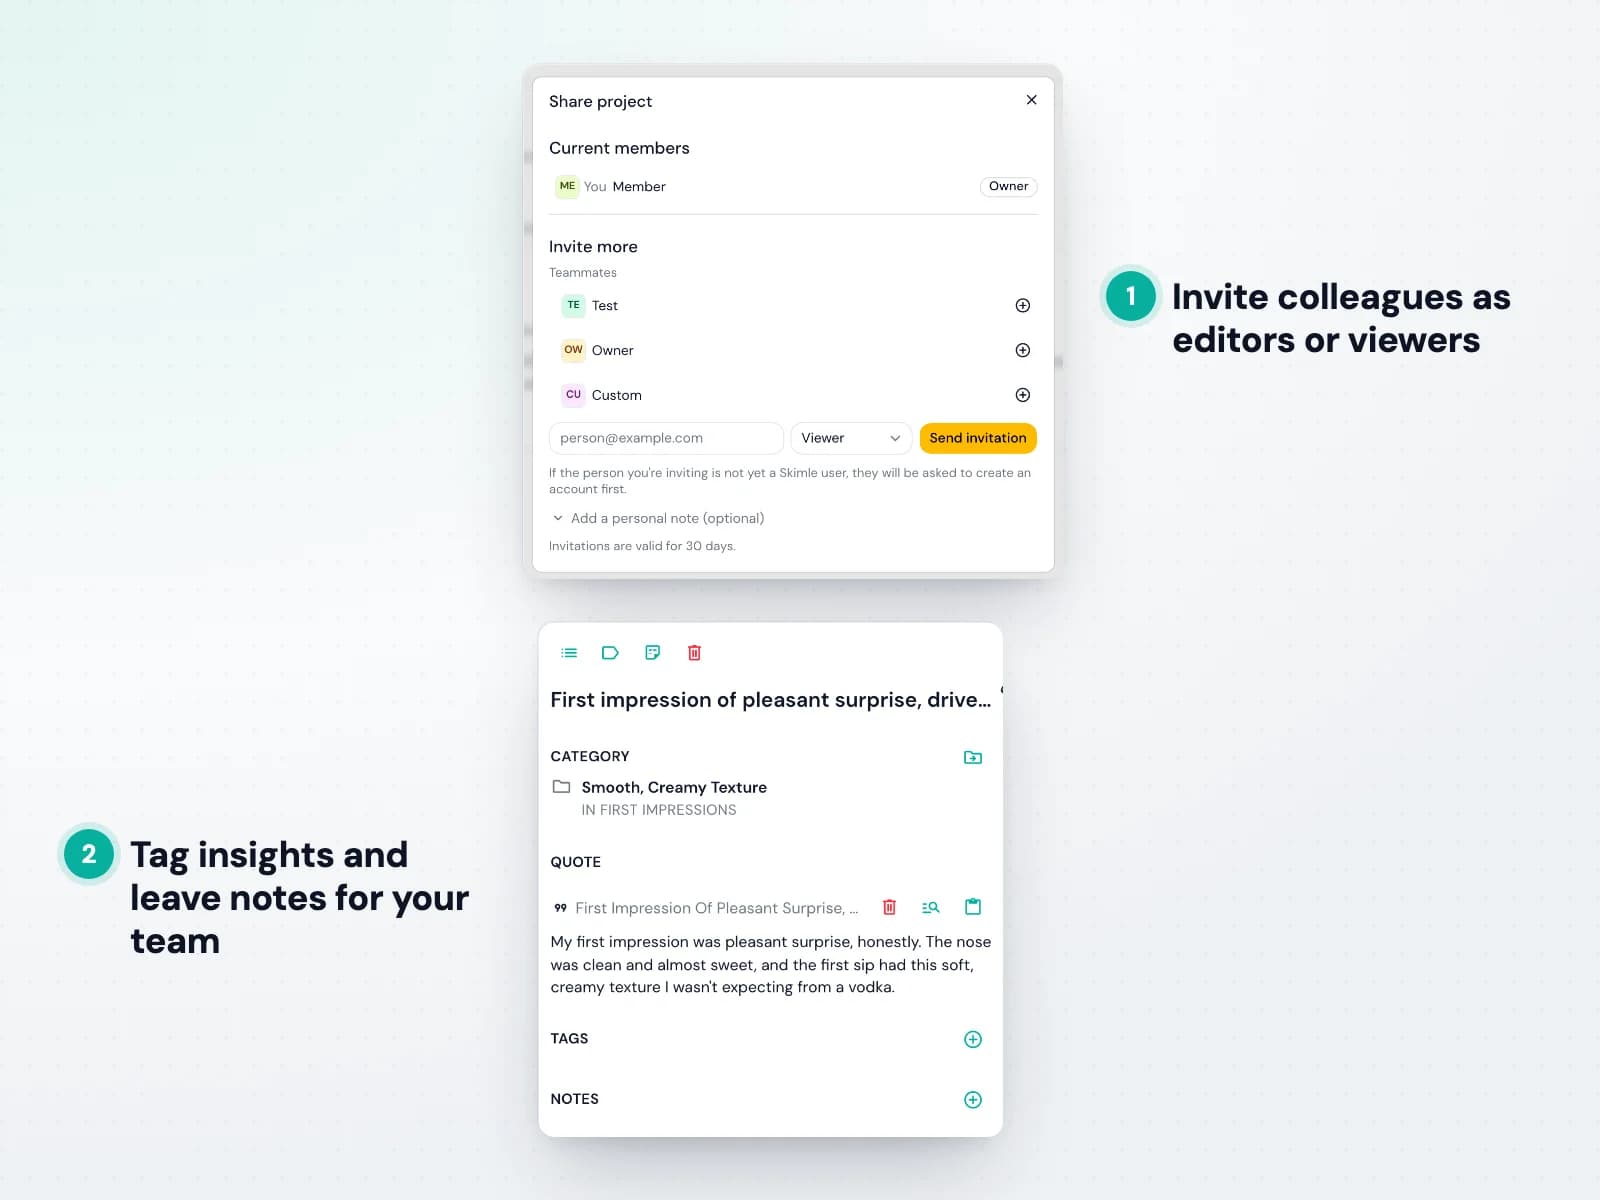
هر پروژهٔ Skimle یک فضای کاری مشترک است. همکاران را بهعنوان ویرایشگر که میتوانند بارگذاری و ویرایش کنند، یا بیننده که میتوانند همه چیز را بدون تغییر ببینند دعوت کنید. نحوهٔ اشتراکگذاری را ببینید.
تصمیمهای کدگذاری، برچسبها و یادداشتها در یک جا میمانند تا تیم پژوهش، مشتری یا استاد راهنما همیشه همان تحلیل بهروز را ببینند.
- نقش ویرایشگر و بیننده
- برچسب و یادداشت روی بینشها
- یک تحلیل مشترک و بهروز
Skimle در مقایسه با دیگران
ابزارهای دستی دقیق اما کندند، هوش مصنوعی عمومی سریع است اما قابل بررسی نیست و ابزارهای تخصصی برای یک کار و با قیمت بالا ساخته شدهاند. فقط Skimle موتور تحلیلی دقیق، شفافیت کامل و کاربرد گسترده را یکجا دارد، از ۲۰ یورو برای هر کاربر در ماه.
| ابزارهای دستی NVivo، MAXQDA، ATLAS.ti… | ابزارهای عمومی هوش مصنوعی ChatGPT، Claude… | ابزارهای تخصصی CoLoop، Listen Labs… | Skimle | |
|---|---|---|---|---|
| موتور تحلیلی دقیق |  | | | |
| شفافیت دوسویه، از خلاصه تا منبع | | | | |
| کاربرد گسترده در انواع داده و موارد استفاده | | | | |
| سریع | | | | |
| یادگیری آسان | | | | |
| قیمت | حدود ۸۰ یورو برای هر کاربر در ماه | حدود ۲۰ یورو برای هر کاربر در ماه | از ۴۰۰ یورو در ماه به بالا | از ۲۰ یورو در ماه، دورهٔ آزمایشی رایگان |
| مقیاس | محدود به توان کدگذاری دستی | بافت محدود، پوشش غیرقابل راستیآزمایی | بسته به ابزار | هزاران سند در هر پروژه |
| GDPR و امنیت داده | بسته به نوع استقرار | بسته به طرح و تنظیمات | بسته به فروشنده | داخلی · سرورهای اتحادیهٔ اروپا · DPA در دسترس |
| جمعبندی | دقتی در حد انتشار علمی، اما هفتهها کدگذاری دستی برای هر پروژه. | سریع، اما پاسخها با هر پرامپت تغییر میکنند و قابل ردیابی یا دفاع نیستند. | ساختهشده برای یک روند کاری، اغلب با قیمتهای سازمانی. | دقت دانشگاهی با سرعت هوش مصنوعی، کاملاً شفاف، برای هر دادهٔ کیفی. |
پرسشهای متداول
پرسشهای متداول
- Skimle چیست؟
- Skimle یک پلتفرم تحلیل دادهٔ کیفی مبتنی بر هوش مصنوعی است که اسناد بدون ساختار، مانند مصاحبهها، گزارشها، نظرخواهیها و بازخورد مشتریان، را بهطور نظاممند به مجموعهدادههایی سازمانیافته و قابل تحلیل با ردیابی کامل تبدیل میکند. برخلاف چتباتها، Skimle کل مجموعهٔ اسناد شما را از ابتدا پردازش میکند، بینشها را استخراج میکند و آنها را در موضوعهای سلسلهمراتبی سامان میدهد که در آن هر یافته به یک نقلقول عینی تأییدشده پیوند دارد.
- تفاوت Skimle با ChatGPT یا ابزارهای مبتنی بر RAG چیست؟
- ابزارهای RAG بخشهای مرتبط را در لحظهٔ پرسش بازیابی میکنند؛ پس هر بار که همان پرسش را بپرسید پاسخ متفاوتی میگیرید. Skimle کل مجموعهدادهٔ شما را از ابتدا نظاممند تحلیل میکند و ساختاری پایدار میسازد که در آن هر موضوع به نقلقولهای تأییدشده پیوند دارد. بهجای پاسخهای جعبهسیاه، پوشش جامع، نتایج یکدست و ردیابی کامل به دست میآورید.
- تفاوت Skimle با NVivo، MAXQDA یا ATLAS.ti چیست؟
- ابزارهای سنتی کدگذاری دستی همهٔ بخشها را لازم دارند؛ نظاممند اما زمانبر، از چند هفته تا چند ماه. Skimle با هوش مصنوعی فرایند کدگذاری را خودکار میکند و همان روششناسی نظاممند و شفاف را حفظ میکند. دقتی در حد NVivo را در کسری از زمان به دست میآورید، با رابط ابری سادهتری که به هفتهها آموزش نیاز ندارد.
- آیا میتوانم از Skimle برای پژوهش دانشگاهی استفاده کنم؟
- بله. Skimle را دانشگاهیان ساختهاند و از روششناسیهای شناختهشده الهام گرفته است: تحلیل مضمون (Braun & Clarke)، نظریهٔ زمینهای (Glaser & Strauss; Strauss & Corbin) و روش Gioia (Gioia, Corley & Hamilton). سابقهٔ ممیزی کامل Skimle به شما امکان میدهد دقیقاً در قالب سند ثبت کنید که موضوعها چگونه به دست آمدهاند؛ چیزی که الزامات داوری همتا را برآورده میکند. اکنون پژوهشگرانی در بیش از ۳۰ دانشگاه از Skimle استفاده میکنند و در صورت درخواست متن پیشنهادی برای استناد ارائه میکنیم.
- Skimle از چه زبانها و قالبهای فایلی پشتیبانی میکند؟
- Skimle از بیش از ۱۰۰ زبان پشتیبانی میکند و فایلهای PDF، Word (docx)، RTF، TXT، CSV، صوتی (MP3، M4A، WAV) و ویدیویی (MP4، MOV) را میپذیرد. میتوانید قالبها و زبانها را در یک پروژه ترکیب کنید؛ مصاحبههای انگلیسی، گزارشهای آلمانی و پاسخهای پیمایش اسپانیایی را با هم بارگذاری کنید. متن صوت و ویدیو بهطور خودکار پیاده میشود.
- آیا Skimle با GDPR منطبق و امن است؟
- بله. همهٔ دادهها در اتحادیهٔ اروپا ذخیره میشوند و هرگز از سرورهای اتحادیهٔ اروپا خارج نمیشوند. Skimle کاملاً با GDPR منطبق است و برای مشتریان نهادی توافقنامهٔ پردازش داده ارائه میکند. اسناد شما هرگز برای آموزش مدلهای هوش مصنوعی استفاده نمیشوند. برای مشتریان سازمانی با الزامات سختگیرانهتر حاکمیت داده، استقرار ابری تکمستأجری در دسترس است.
- Skimle چگونه از توهم هوش مصنوعی جلوگیری میکند؟
- هر بینشی که Skimle تولید میکند با اسناد منبع راستیآزمایی میشود؛ اگر هوش مصنوعی متنی بسازد که عیناً در دادههای شما وجود ندارد، سامانه آن را علامت میزند و دوباره پردازش میکند. شفافیت دوسویه به شما امکان میدهد روی هر موضوع کلیک کنید و نقلقولهای پشتیبان دقیق آن را ببینید، و هر سند را باز کنید تا ببینید کدام متن کدگذاری شده و کدام نه؛ پس هیچ چیزی ساختگی یا جاافتاده نمیماند.
- چقدر زود به نخستین نتایج میرسم؟
- پردازش بیشتر پروژهها چند دقیقه طول میکشد. مجموعهدادههای بزرگ با بیش از ۱۰۰۰ سند ممکن است زمان بیشتری بخواهند. یک مجموعهٔ معمول از ۱۰ تا ۲۰ متن مصاحبه معمولاً در کمتر از یک ساعت پردازش میشود. میتوانید بارگذاری کنید، تحلیل را آغاز کنید و همان روز موضوعهای ساختاریافته با نقلقولهای پشتیبان را بررسی کنید؛ بدون راهاندازی یا آموزش.
- آیا برای استفاده از Skimle به مهارت فنی نیاز دارم؟
- خیر. Skimle برای پژوهشگران کیفی، تحلیلگران و مشاوران طراحی شده است، نه مهندسان. اسنادتان را بارگذاری میکنید، پرسش پژوهشی خود را شرح میدهید و Skimle بقیه را انجام میدهد. ویرایش دستهها، بررسی موضوعها و خروجی گرفتن از گزارشها همه با رابطی مبتنی بر کلیک انجام میشود. نیازی به برنامهنویسی، اسکریپتنویسی یا تخصص در هوش مصنوعی نیست.
- قیمتگذاری چگونه است؟ واقعاً دورهٔ آزمایشی رایگان هست؟
- بله. Skimle دورهٔ آزمایشی رایگان با ۲۰۰ اعتبار (کافی برای حدود ۲۰۰ تا ۳۰۰ صفحه سند) ارائه میکند و به کارت اعتباری نیازی نیست. طرحهای پولی برای افراد با پرداخت سالانه از ۲۰ یورو در ماه شروع میشوند (۲۵ یورو با پرداخت ماهانه) و طرحهای بزرگتری برای کاربران پرمصرف وجود دارد. طرحهای سازمانی با حجم سفارشی، SSO و استقرار تکمستأجری بنا به درخواست در دسترس است.
- حداکثر چند سند میتوانم تحلیل کنم؟
- Skimle از هزاران سند در هر پروژه پشتیبانی میکند. این بسیار فراتر از توان هر رویکرد دستی است و بیشتر موارد استفادهٔ حرفهای را پوشش میدهد، از ۱۰ مصاحبهٔ عمیق تا بیش از ۱٬۰۰۰ پاسخ باز پیمایش. اگر مجموعهدادهٔ بسیار بزرگ یا نیاز به تحلیل مستمر دارید، برای بررسی گزینهها با ما تماس بگیرید.
ساختهشده برای متخصصان، به دست متخصصان
Skimle بیش از ۱٬۵۰۰ کاربر راضی در بیش از ۵۰ دانشگاه، نهاد دولتی، آژانس و شرکت دارد. همهٔ دادهها درون اتحادیهٔ اروپا ذخیره و بر اساس این موارد پردازش میشوند: سیاست سختگیرانهٔ GDPR ما و شرایط خدمات.
میخواهید بیشتر بدانید؟ ببینید: وبلاگ Signal & Noise، پرسشهای متداول و موارد استفاده بر اساس بخش. همچنین با کمال میل محصول را نمایش میدهیم یا بررسی میکنیم Skimle چگونه با نیازهای شما جور میشود. دربارهٔ شرکت پشت Skimle بیشتر بخوانید