קפדנות אקדמית במהירות של בינה מלאכותית
Skimle נבנה בידי אקדמאים, לאקדמאים. למייסד השותף פרופ׳ Henri Schildt עשרות שנות ניסיון במחקר איכותני ומאמרים בכתבי עת מובילים בניהול, ובהם Academy of Management Journal ו-Organization Science. נמאס לו מתהליכי העבודה האיטיים והמסורבלים של NVivo ו-MAXQDA, והדאיג אותו השימוש ב-ChatGPT לניתוח שחסרים בו שקיפות ומקיפות. לכן הוא בנה את Skimle כפלטפורמה שמשחזרת מתודולוגיה איכותנית קפדנית ושקופה, אבל עם בינה מלאכותית בבסיס.
קידוד ראשוני של ראיונות יכול לקחת שבועות ביד. Skimle מטפל בו בלי לוותר על קפדנות מתודולוגית, ולעיתים קרובות קולט ציטוטים שאדם היה מפספס. כל נושא מקושר לציטוט מילולי מאומת. מסלול הביקורת המלא מספק את השופטים העמיתים.
חומרי הוראה →ניתוח קפדני שמאפשר להתמקד בתרומה התיאורטית שלכם
הגישה של Skimle שואבת השראה מתיאוריה מעוגנת (Glaser & Strauss; Strauss & Corbin) ומשיטת Gioia. היא מפיקה את הניתוח השיטתי והשקוף ששיפוט עמיתים דורש, בלי שבועות של קידוד מכני שגוזלים זמן שעדיף להשקיע בתיאוריה. היא עובדת ביותר מ-100 שפות ומטפלת בעד 1,000 מסמכים בכל פרויקט.
- קידוד ראשוני אוטומטי, כל ציטוט מקושר לקטגוריה שלו
- מסלול ביקורת דו-כיווני מלא לשיפוט עמיתים ולשקיפות מתודולוגית
- מערכת קטגוריות בשליטתכם: מיזוג, פיצול, שינוי שם וארגון מחדש של קטגוריות בחופשיות
- עובד ביותר מ-100 שפות בלי תרגום
- מטפל בראיונות, שמע/וידאו, ספרים, מסמכים וחומרי ארכיון
- Skimle Academic, תוכנית מוזלת, זמינה
תמלול והתממה של ראיונות
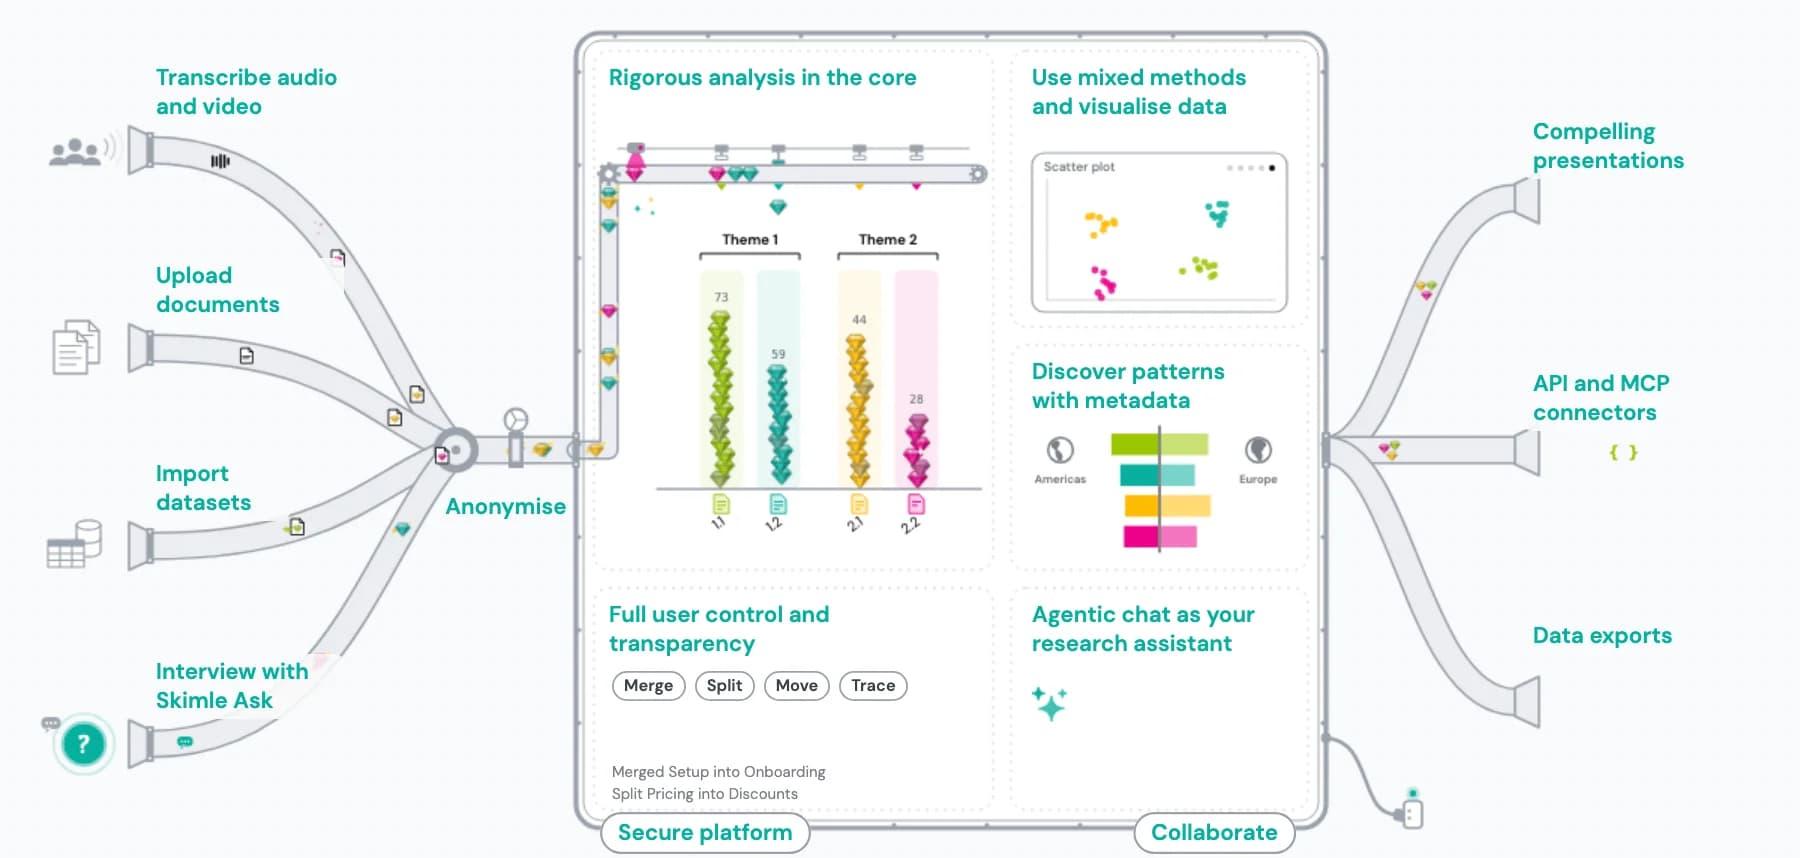
הפיכת הקלטות שדה לנתונים שמישים דרך שירות חיצוני היא איטית ויקרה, והתמלילים שמתקבלים כוללים שמות, השתייכויות ומקומות שיוצרים חובות לפי GDPR ואתיקה עוד לפני שאפשר לשתף, לארכב או לצטט אותם. Skimle מתמלל שמע ווידאו בתוך הסביבה המאובטחת שלו ב-EU, ואז מתמם בפסאודונימיזציה ברמה מחקרית, כך שמקבלים באותו יום תמליל תואם ומוכן לקידוד, בלי שהנתונים יוצאים מתשתית שעומדת ב-GDPR.
איך זה עובד
- 1. העלאת שמע, וידאו או טקסט
העלו קובצי MP3, M4A, WAV, MP4, MOV, PDF או Word ישירות. בלי שירות תמלול חיצוני, ועם תמיכה מובנית ביותר מ-100 שפות.
- 2. תמלול עם תיוג דוברים
Skimle מתמלל את ההקלטה, מזהה החלפות דוברים ומתמודד עם מבטאים ואיכות שמע משתנה. בדקו ותקנו את התוצאה לפני תחילת הניתוח.
- 3. זיהוי אוטומטי של מזהים
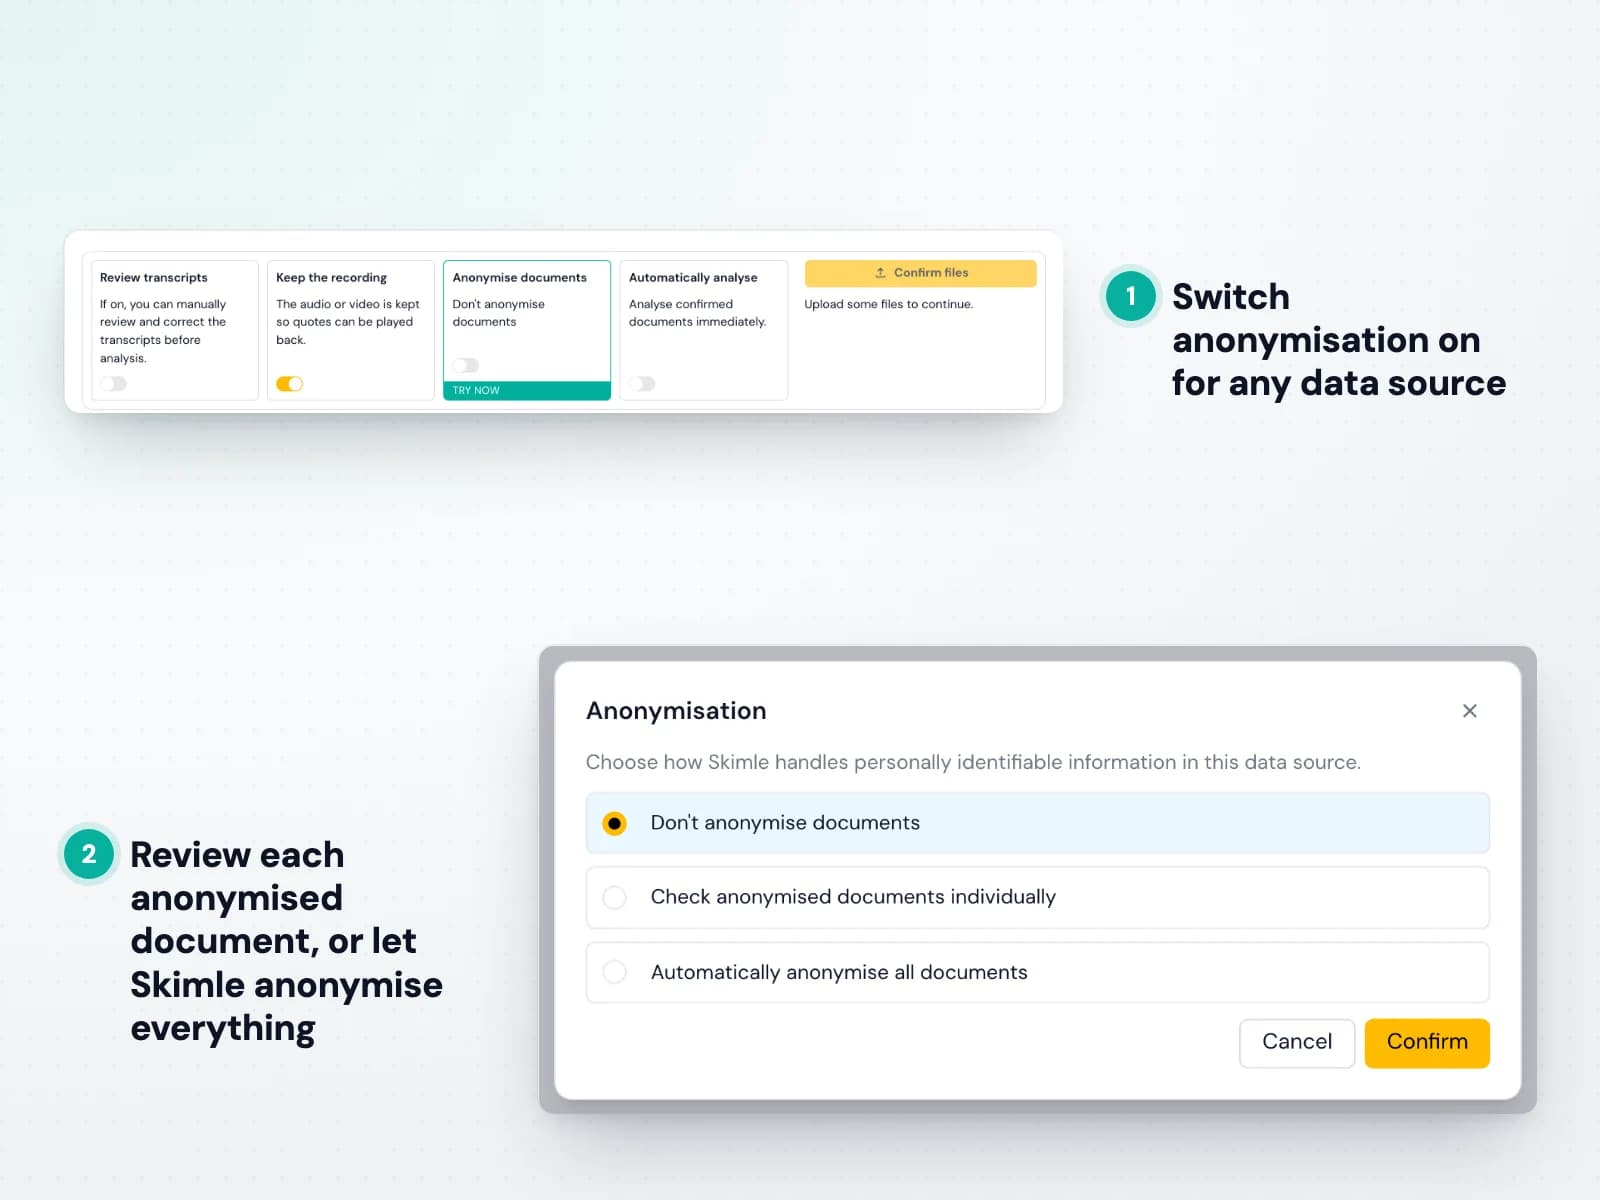
Skimle Anonymise מסמן מזהים בשש קטגוריות: שמות, תפקידים ותארים, מקומות, ארגונים, תאריכים ואחר, בכל מסמך, עם עקביות בין קבצים כך שאותו אדם שומר על אותו כינוי.
- 4. בחירת רמת ההתממה
בחרו פסאודונימיזציה קלה, פסאודונימיזציה חזקה או התממה ברמת HIPAA שבה המפתח מושמד. כווננו כל קטגוריה בנפרד והוסיפו כללים מותאמים בשפה פשוטה.
- 5. ייצוא עם תיעוד ביקורת
ייצאו דוח ביקורת ב-PDF וטבלת המרה ב-Excel לוועדת האתיקה, ואז הזינו את התמליל הנקי ישירות לתהליך הניתוח של Skimle. קובץ השמע המקורי נמחק בבטחה לאחר מכן.

ניתוח איכותני של ראיונות בסיוע בינה מלאכותית
מחקר שמבוסס על יותר מ-40 ראיונות אמור להניב תרומה תיאורטית עשירה (למשל לדוקטורט), אבל קידוד ידני, כלומר הדגשה, ארגון, קידוד מחדש ובניית טבלאות מעקב, צורך את רוב הזמן ועדיין עלול לפספס דפוסים חשובים. Skimle קורא כל ראיון באופן שיטתי ונותן היררכיית נושאים מובנית עם ציטוטים מילוליים מצורפים, כך שתוכלו להשקיע את הזמן בפרשנות התיאורטית שרק אתם יכולים לתת.
איך זה עובד
- 1. העלאת התמלילים
גררו פנימה תמלילי ראיונות כקובצי PDF, Word או טקסט פשוט. Skimle מקבל מסמכים בכל פורמט ותומך באופן מובנה ביותר מ-100 שפות.
- 2. תיאור שאלת המחקר
הגדירו את המיקוד האנליטי, באופן רחב או ספציפי. Skimle בונה את הקידוד הראשוני סביב מה שאתם מנסים להבין תיאורטית.
- 3. בדיקת מבנה הקודים הראשוני
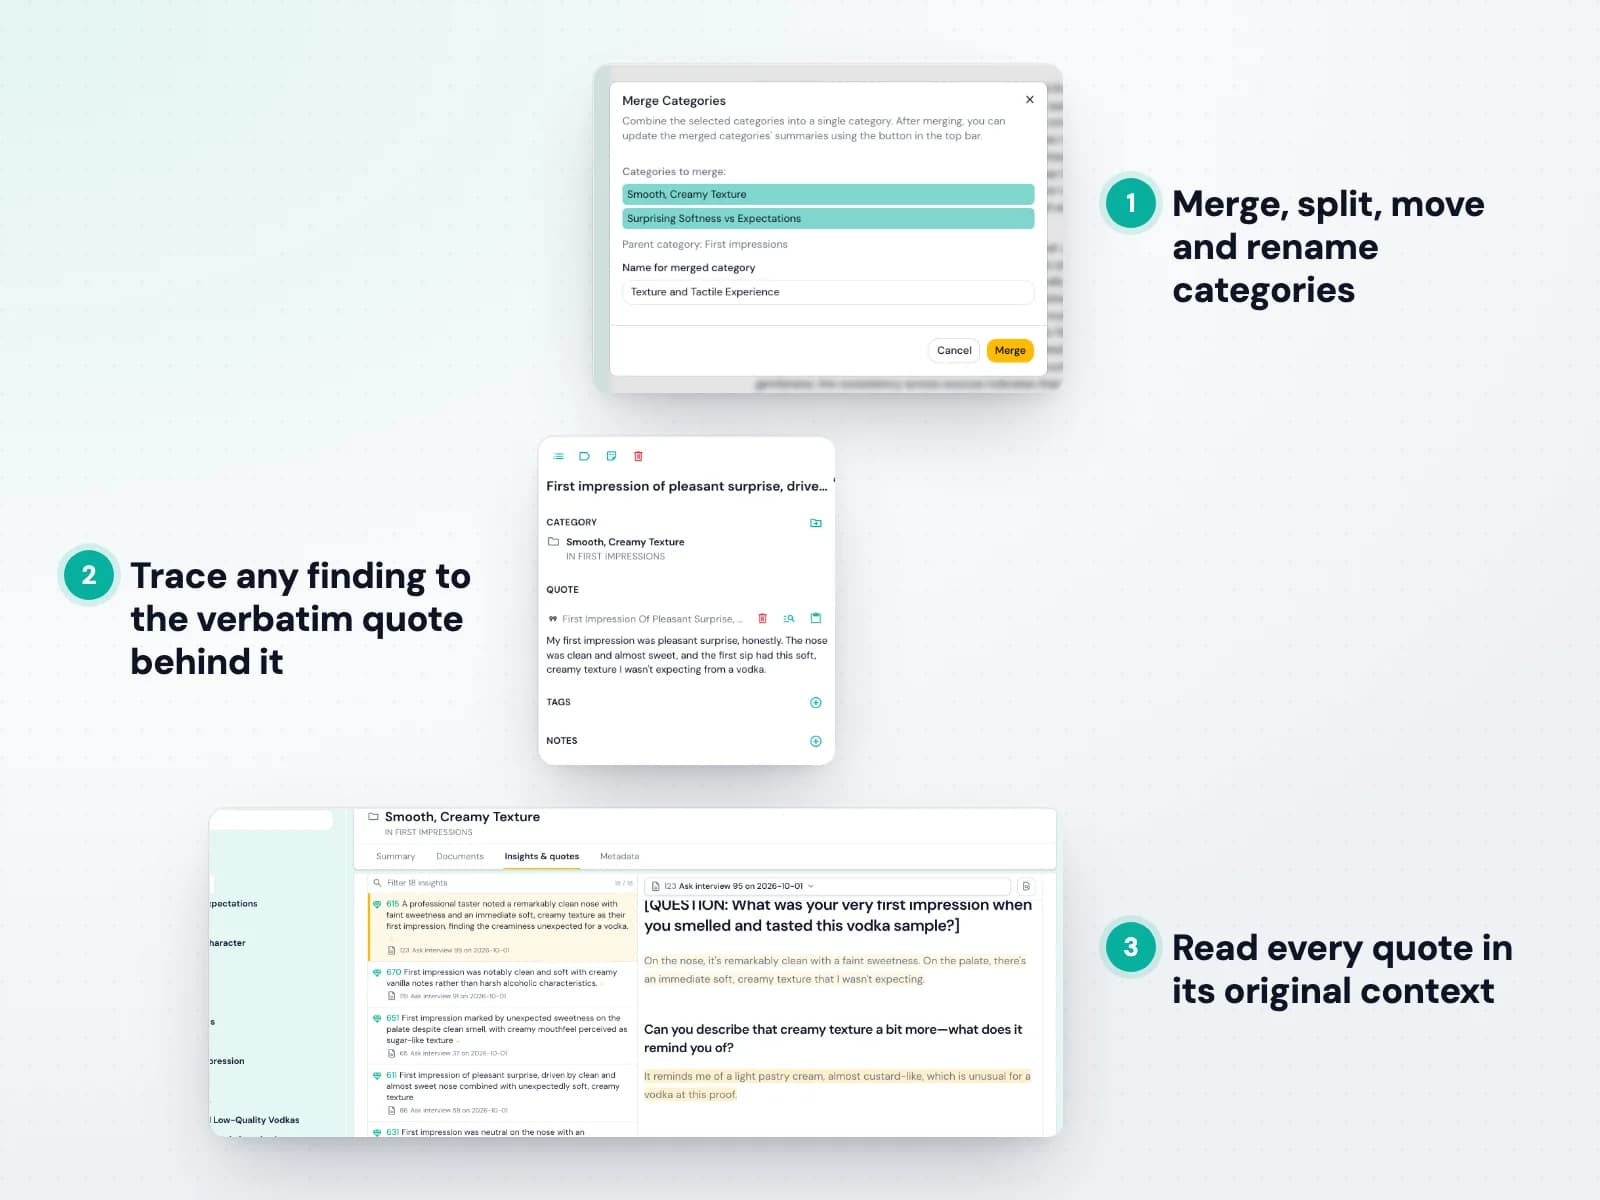
Skimle מפיק היררכיה של נושאים, כל אחד מקושר לציטוטים מילוליים מתמלילי המקור. שום דבר לא מומצא. כל קוד עקיב לטקסט.
- 4. ליטוש בהתאם למסגרת התיאורטית
מזגו, פצלו, שנו שמות וארגנו מחדש קטגוריות כך שיתאימו למודל התיאורטי המתהווה. שקיפות דו-כיוונית מאפשרת לבדוק בכל רגע אילו ציטוטים תומכים באילו קודים.
- 5. ייצוא לנספח השיטות
ייצאו את מערכת הקטגוריות והציטוטים התומכים כטקסט או בפורמט קוד פתוח REFI-QDA (qdpx) שתוכנות CAQDAS ותיקות כמו NVivo, ATLAS.ti או MAXQDA תומכות בו.
ניתוח בשיטות משולבות על פני המדגם
לממצאים איכותניים יש משקל רב יותר כשאפשר להראות איך הם משתנים במדגם: לפי מחזור, תפקיד, מגדר, אתר או מצב. הצלבה ידנית של נושאים עם מאפייני משתתפים היא מייגעת ומועדת לטעויות. Skimle מצמיד מטא-נתונים לכל מסמך ומאפשר לפלח את אותו מבנה נושאים לפי כל משתנה, כך שאפשר לעבור בין ציטוטים מילוליים עשירים לדפוסים כמותיים בלי להשאיר אף שיטה מאחור.
איך זה עובד
- 1. הצמדת מטא-נתונים למסמכים
תייגו כל תמליל במשתנים שחשובים למערך שלכם, כמו מחזור, תפקיד, מגדר, אתר, גל או תנאי ניסוי, ידנית או מעמודת CSV.
- 2. הרצת הניתוח האיכותני
Skimle בונה היררכיית נושאים אחת על פני כל המסמכים, כך שכל משתתף מקודד לפי אותו מבנה.
- 3. פילוח נושאים לפי משתנה
ראו איך כל נושא משתנה בין קבוצות, וזהו היכן דפוס הוא אוניברסלי והיכן הוא ייחודי למחזור אחד.
- 4. כימות השכיחות
קראו שכיחויות והתפלגויות של נושאים כדי לדווח עד כמה קוד נפוץ בכל פלח, כשכל ספירה עקיבה לציטוטים שיצרו אותה.
- 5. ייצוא טבלאות וציטוטים
ייצאו טבלאות הצלבה וציטוטים תומכים ל-Excel או ל-Word עבור פרק השיטות המשולבות במאמר.

שאלות נפוצות
- האם אפשר לצטט את Skimle במחקר?
- כן. תארו אותו בפרק השיטות כ-“תוכנה לקידוד איכותני בסיוע בינה מלאכותית”, כמו שהייתם מצטטים את NVivo או MAXQDA. יש לנו מאמר מתודולוגי בשיפוט עמיתים שיספק ציטוט רשמי, ועד אז נוכל להציע נוסח ציטוט לפי בקשה.
- האם שופטים עמיתים יקבלו ניתוח בסיוע בינה מלאכותית?
- יותר ויותר כן, עם תיעוד במסמכים כנדרש. מסלול הביקורת של Skimle נותן לשופטים את מה שהם מצפים לו: תהליך קידוד שיטתי ומתועד שבו כל נושא עקיב לציטוטים מסוימים, כך שפרק השיטות כמעט כותב את עצמו.
- איך Skimle בהשוואה ל-NVivo או ל-MAXQDA?
- NVivo ו-MAXQDA מתאימים לחוקרים שיש להם שבועות לניתוח ורישיון מוסדי. Skimle הופך את שלב הקידוד המכני לאוטומטי, משבועות לשעות, תוך שמירה על אותה מתודולוגיה שיטתית ושקופה, ועקומת הלמידה היא דקות. חוקרים רבים משתמשים בשניהם: Skimle לסבב הקידוד הראשון ו-NVivo לשילוב שיטות משולבות.
- האם Skimle מתאים לתיאוריה מעוגנת?
- כן. Skimle תומך בקידוד אינדוקטיבי שבו הנושאים עולים מהנתונים במקום להיכפות מראש. התחילו במיקוד רחב ותנו למבנה הקטגוריות להתפתח בהדרגה, באופן שקרוב מאוד לקידוד פתוח בתיאוריה מעוגנת.
- האם אפשר להריץ ניתוח בשיטות משולבות?
- כן. הצמידו משתני מטא-נתונים לכל מסמך, כמו מחזור, תפקיד, מגדר, אתר ותנאי, ופלחו את מבנה הנושאים לפי כל אחד מהם. מקבלים שכיחויות והתפלגויות של נושאים לפי קבוצה, כל אחת עקיבה לציטוטים מילוליים, מוכנות לפרק השיטות המשולבות במאמר.
- האם נתוני המחקר שלי מאובטחים?
- התמלילים שלכם מעובדים על תשתית ב-EU ולעולם אינם משמשים לאימון מודלים של בינה מלאכותית. אנחנו מספקים הסכמי עיבוד נתונים לדרישות אתיקה מוסדיות ויכולים לעמוד ברוב דרישות אבטחת המידע. צרו קשר עם הדרישות הספציפיות שלכם.
- האם אפשר לקבל הנחה אקדמית?
- כן. אקדמאים עם דוא״ל מוסדי תקף ודף שיוך יכולים לרכוש את חבילת Skimle Academic המוזלת. צרו קשר לרישוי מוסדי אם אתם צריכים גישת צוות לקבוצת מחקר או למעבדה.
נבנה לאנשי מקצוע, בידי אנשי מקצוע
ל-Skimle יש יותר מ-1,500 משתמשים מרוצים ביותר מ-50 אוניברסיטאות, גופים ממשלתיים, סוכנויות וחברות. כל הנתונים מאוחסנים בתוך ה-EU ומעובדים בהתאם למדיניות ה-GDPR המחמירה שלנו ובהתאם לתנאי השימוש.
רוצים לדעת עוד? עיינו בבלוג שלנו Signal & Noise, בעמוד השאלות הנפוצות ובתרחישי השימוש לפי מגזר. נשמח גם להדגים את המוצר או לבדוק איך Skimle יכול להתאים לצרכים שלכם. קראו עוד על החברה שמאחורי Skimle