סקירת התכונות של Skimle
Skimle היא תוכנה לניתוח נתונים איכותניים שנבנתה מהיסוד על בינה מלאכותית, עבור חוקרי שוק, מומחי תובנות לקוחות, חוקרים אקדמיים, יועצים ואנשי מקצוע סקרנים אחרים שרוצים להעמיק בנתונים שלהם.
העלו תמלילי ראיונות, הקלטות של קבוצות מיקוד, טבלאות עם אלפי תשובות פתוחות, מסמכים או כל נתון איכותני אחר ביותר מ-100 שפות נתמכות. תהליך העבודה הקפדני של Skimle, מלמטה למעלה, מזהה תובנות ויוצר מבנה קטגוריות שקוף שאפשר לערוך בחופשיות. אפשר להציג את הנתונים חזותית בשיטות משולבות, לגלות דפוסים בעזרת מטא-נתונים, לחבר את סוכן הבינה המלאכותית שלכם לנתונים באמצעות MCP, ליצור מצגות משכנעות ועוד.
הפלטפורמה כוללת גם את Skimle Ask, מנוע סקרים חזק בסיוע בינה מלאכותית לאיסוף תובנות איכותניות עשירות בהיקף גדול. הגדירו את מדריך הראיון, שתפו את הקישור עם המשיבים ואספו נתונים בתשובות טקסט, קול או וידאו, עם שאלות המשך חכמות.
Skimle משלב קפדנות אקדמית עם מעשיות עסקית. כלי בינה מלאכותית רבים מדלגים על הניתוח עצמו ומפיקים רק סיכום שנשמע סביר אבל אי אפשר להגן עליו, וחשוף להטיות ולהזיות. כלים ותיקים כמו NVivo, MAXQDA או ATLAS.ti מכריחים אתכם להשקיע את רוב הזמן בקידוד ידני במקום בניתוח. Skimle בנוי אחרת: תהליך ניתוח אוטומטי וקפדני בבינה מלאכותית, עם שקיפות דו-כיוונית מלאה ושליטה של המשתמש.
Skimle היא פלטפורמה מלאה לניתוח איכותני
Skimle הוא כלי רב-גוני שמאפשר לכם…
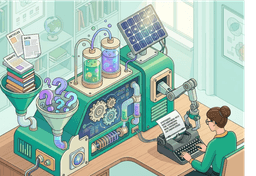
תרשים מונפש שמראה איך Skimle עובד. הנתונים נכנסים דרך ארבעה צינורות קלט: תמלול, העלאת מסמכים, ייבוא מאגרי נתונים וראיונות Skimle Ask. הם עוברים דרך שסתום התממה אל המכונה, שבה התובנות ממוינות לנושאים, נחקרות בהדמיות, מושוות לפי מטא-נתונים ונדונות עם עוזר מחקר מבוסס בינה מלאכותית. התוצאות יוצאות דרך שלושה צינורות ייצוא: מצגות, מחברי API ו-MCP, וייצוא נתונים.
מחקר אקדמי
סקירת ספרות
ייבאו מאמרים ומקורות משניים, קודדו נושאים אוטומטית במאות מסמכים, וזהו פערים ודפוסים בספרות תוך שעות במקום שבועות.
קראו עוד →ניתוח תמטי
הבינה המלאכותית של Skimle מזהה נושאים חוזרים בתמלילי ראיונות ובונה עץ קטגוריות שאפשר לבדוק, לערוך ולאמת, כשכל נושא עקיב לציטוטים מסוימים.
קראו עוד →תיאוריה מעוגנת
בנו תיאוריה באופן אינדוקטיבי מנתונים גולמיים. Skimle מקודד את התמלילים, מציף מושגים מתהווים ומאפשר ללטש את מערכת הקטגוריות בהדרגה ככל שהדפוסים מתפתחים.
קראו עוד →קידוד אינדוקטיבי
התחילו בקידוד פתוח ותנו ל-Skimle להציע קטגוריות ישירות מהנתונים. בדקו, מזגו ושנו שמות של קודים כך שיתאימו לעדשה האנליטית שלכם, עם שליטה מלאה לאורך כל הדרך.
קראו עוד →קידוד דדוקטיבי
החילו מערכת קטגוריות מוגדרת מראש על המסמכים שלכם. Skimle מתאים את הקטגוריות לנתונים חדשים עם שקיפות מלאה לגבי הציטוטים שהובילו לכל קוד.
קראו עוד →שיטות משולבות
שלבו מטא-נתונים כמותיים עם נושאים איכותניים. הצליבו קטגוריות קידוד עם מאפיינים דמוגרפיים של המשיבים כדי לחשוף דפוסים בעלי משמעות סטטיסטית.
קראו עוד →
מחקר שוק ותובנות לקוחות
מחקר שוק איכותני
נהלו ונתחו ראיונות עומק, קבוצות מיקוד ותשובות פתוחות במקום אחד: תהליך מחקר השוק האיכותני המלא, מהתמליל ועד לנושאים מגובי ציטוטים.
קראו עוד →מחקרי קבוצות מיקוד
תמללו ונתחו דיונים בקבוצות מיקוד, ועקבו מי אמר מה ואיך הנושאים משתנים בין קבוצות משתתפים, מנחים ומפגשים.
קראו עוד →ראיונות לקוחות
קודדו ראיונות עומק באופן שיטתי, זהו רוויה לאורך התוכנית וייצאו דוחות נקיים ומגובי ציטוטים למצגות ללקוחות.
קראו עוד →קול השוק
אספו וקודדו תשובות פתוחות לסקרים ממדגמים גדולים כדי להבין תפיסות שוק, צרכים שלא נענו ומגמות מתהוות בפלחים השונים.
קראו עוד →ראיונות ממוקדים
קיימו ראיונות עומק מובנים עם Skimle Ask, ואז קודדו אוטומטית את התשובות והשוו מיד ממצאים בין פלחי משיבים.
קראו עוד →
ייעוץ ובדיקת נאותות
סינתזה של שיחות מומחים
תמללו וקודדו שיחות עם רשתות מומחים לאורך הפרויקט. בנו תמונה מובנית של נקודות המבט של המומחים על דינמיקת השוק, סיכונים והזדמנויות בשבריר מהזמן.
קראו עוד →ניתוח תשומות של בעלי עניין
נתחו באופן שיטתי ראיונות עם בעלי עניין ותוצרי סדנאות, כדי לוודא שכל הקולות מיוצגים ועקיבים בהמלצות הסופיות.
קראו עוד →סיכום מסמכים
חלצו נושאים ועמדות מרכזיים מאוספי מסמכים גדולים, כמו דיווחים רגולטוריים, דוחות חברות ומאמרי מחקר, בשבריר מהזמן.
קראו עוד →ניתוח נתונים בבינה מלאכותית
השתמשו בבינה המלאכותית של Skimle כדי לקודד ולסווג לקטגוריות במהירות נתונים איכותניים מראיונות, סקרים ומסמכים, ולפנות את היועצים לסינתזה ולגיבוש תובנות.
קראו עוד →מחקר שולחני
ארגנו ונתחו מקורות מחקר משניים, עם קידוד אוטומטי של נושאים ומעקב מדויק אחר המקום שממנו הגיעה כל תובנה באוסף המסמכים.
קראו עוד →
אנשי מקצוע סקרנים
המוח הארגוני
בנו מאגר ידע ארגוני מקודד שאפשר לחפש בו: סיכומי פגישות, מסמכי אסטרטגיה ומחקרים, שהצוות יכול לשאול, לנתח ולבנות עליהם לאורך זמן.
קראו עוד →ניתוח נתונים בבינה מלאכותית
העלו כל נתון לא מובנה, כמו מיילים, דוחות והערות, ותנו ל-Skimle לארגן ולקודד אותו, כך שחומר גלם מפוזר הופך למידע מאורגן שאפשר לחפש בו.
קראו עוד →ניתוח מסמכים
נתחו חוזים, מסמכי מדיניות או מאמרי מחקר כדי לחלץ נושאים ותובנות מרכזיים בלי לקרוא כל מילה, עם ציטוטים עקיבים למקור המקורי.
קראו עוד →ניתוח חד-פעמי
הריצו ניתוח מובנה מהיר על כל מערך נתונים, כמו סיכומי ראיונות, מיילים מלקוחות ומשוב, בלי להתחייב לתוכנית מחקר ארוכה או ללמוד כלי מסובך.
קראו עוד →סינתזה של מאגרי נתונים
שלבו תובנות ממקורות נתונים רבים למערכת קטגוריות אחת, וזהו נושאים משותפים ופערים בין מאגרי נתונים מהקשרים שונים.
קראו עוד →
ניהול מוצר
ניתוח משוב לקוחות
אגדו ביקורות על האפליקציה, פניות תמיכה ותשובות לסקרים לנושאים מובנים. זהו מיד את נקודות הכאב המרכזיות ובקשות התכונות, בכל היקף נתונים.
קראו עוד →גילוי מתמשך
הריצו מחזורי ראיונות קלים וקודדו ממצאים למאגר תובנות קבוע. עקבו אחרי התפתחות הנושאים לאורך גרסאות המוצר ורבעונים.
קראו עוד →מחקר משתמשים
תמללו ונתחו מפגשי שמישות, ראיונות עומק ומחקרי יומן. הציפו תובנות מהר יותר בלי לאבד את עושר הפרטים האיכותניים שהצוות צריך.
קראו עוד →ניתוח יומני שיחות
העלו הקלטות של שיחות מכירה או תמיכה, תמללו אוטומטית וקודדו בהיקף גדול כדי לזהות התנגדויות חוזרות, בקשות לתכונות ודפוסי סנטימנט.
קראו עוד →
משאבי אנוש, אנשים ותרבות
ניתוח ראיונות עזיבה
קודדו תשובות מראיונות עזיבה בהיקף גדול כדי לזהות סיכוני שימור, דפוסי ניהול ובעיות מערכתיות לפני שהן מחריפות בכל הארגון.
קראו עוד →סקרי מעורבות עובדים
הפכו תשובות פתוחות לסקר לנושאים מובנים. הבינו מה מניע מעורבות ואי-שביעות רצון בין צוותים, מיקומים וקבוצות ותק.
קראו עוד →סקרי דופק
קיימו ראיונות קצרים ותכופים עם Skimle Ask ועקבו אחרי התפתחות נושאי הסנטימנט של העובדים לאורך זמן, כדי לתת למשאבי אנוש תמונה בזמן אמת של מצב העובדים.
קראו עוד →סקרי תרבות
נתחו נתוני הערכת תרבות איכותניים כדי לזהות פערים בין ערכים מוצהרים לערכים בפועל, עם עקיבות מלאה לציטוטים של משיבים לצורכי דיווח להנהלה.
קראו עוד →
המגזר הציבורי וניתוח מדיניות
ניתוח שימועים ציבוריים
נתחו תגובות לשימועים ציבוריים בהיקף גדול: קודדו את ההגשות וזהו את העמדות, החששות וההמלצות הנפוצים ביותר מתוך אלפי תשומות.
קראו עוד →סקירת מסמכי מדיניות
חלצו נושאים ועמדות מרכזיים ממסמכי מדיניות, דיווחים רגולטוריים וטקסטים חקיקתיים, כשכל ממצא עקיב לקטע המקור.
קראו עוד →משוב בעלי עניין
קודדו ונתחו באופן שיטתי משוב מובנה מאזרחים, ממשתמשי שירות או משותפים, כדי לוודא שכל הקולות נקלטים ומיוצגים בדיווח.
קראו עוד →הערכת תוכניות
נתחו נתוני ראיונות וסקרים ממשתתפי תוכניות כדי להעריך השפעה, להציף נושאים חוזרים ולהפיק דוחות הערכה מבוססי ראיות.
קראו עוד →
חיבור באמצעות MCP
שימוש ב-Skimle מתוך Claude
חברו את Skimle ל-Claude דרך MCP ושאלו על נתוני המחקר, הקטגוריות והתובנות בשפה טבעית, בלי להחליף הקשר.
קראו עוד →בניית תהליכי עבודה בבינה מלאכותית
השתמשו בשרת ה-MCP של Skimle כדי לשלב את נתוני המחקר האיכותני בכל כלי בינה מלאכותית תואם MCP, להפוך שלבי ניתוח לאוטומטיים ולהזרים תוצאות לתהליכים רחבים יותר.
קראו עוד →שאילתות מחקר דרך API
גשו לנתוני Skimle באופן תכנותי דרך ה-API. שלפו פרויקטים, מסמכים, קטגוריות ותובנות כדי להזין לוחות בקרה מותאמים או כלי דיווח חיצוניים.
קראו עוד →
הנושאים עולים מהנתונים
כל שינוי נרשם ואפשר לבטל אותו.
שלב 1
העלאה ואיסוף של נתונים
הביאו הקלטות, מסמכים ומערכי נתונים, או אספו נתונים חדשים בראיונות בסיוע בינה מלאכותית, והתממו אותם לפני הניתוח.
תמלול שמע ווידאו
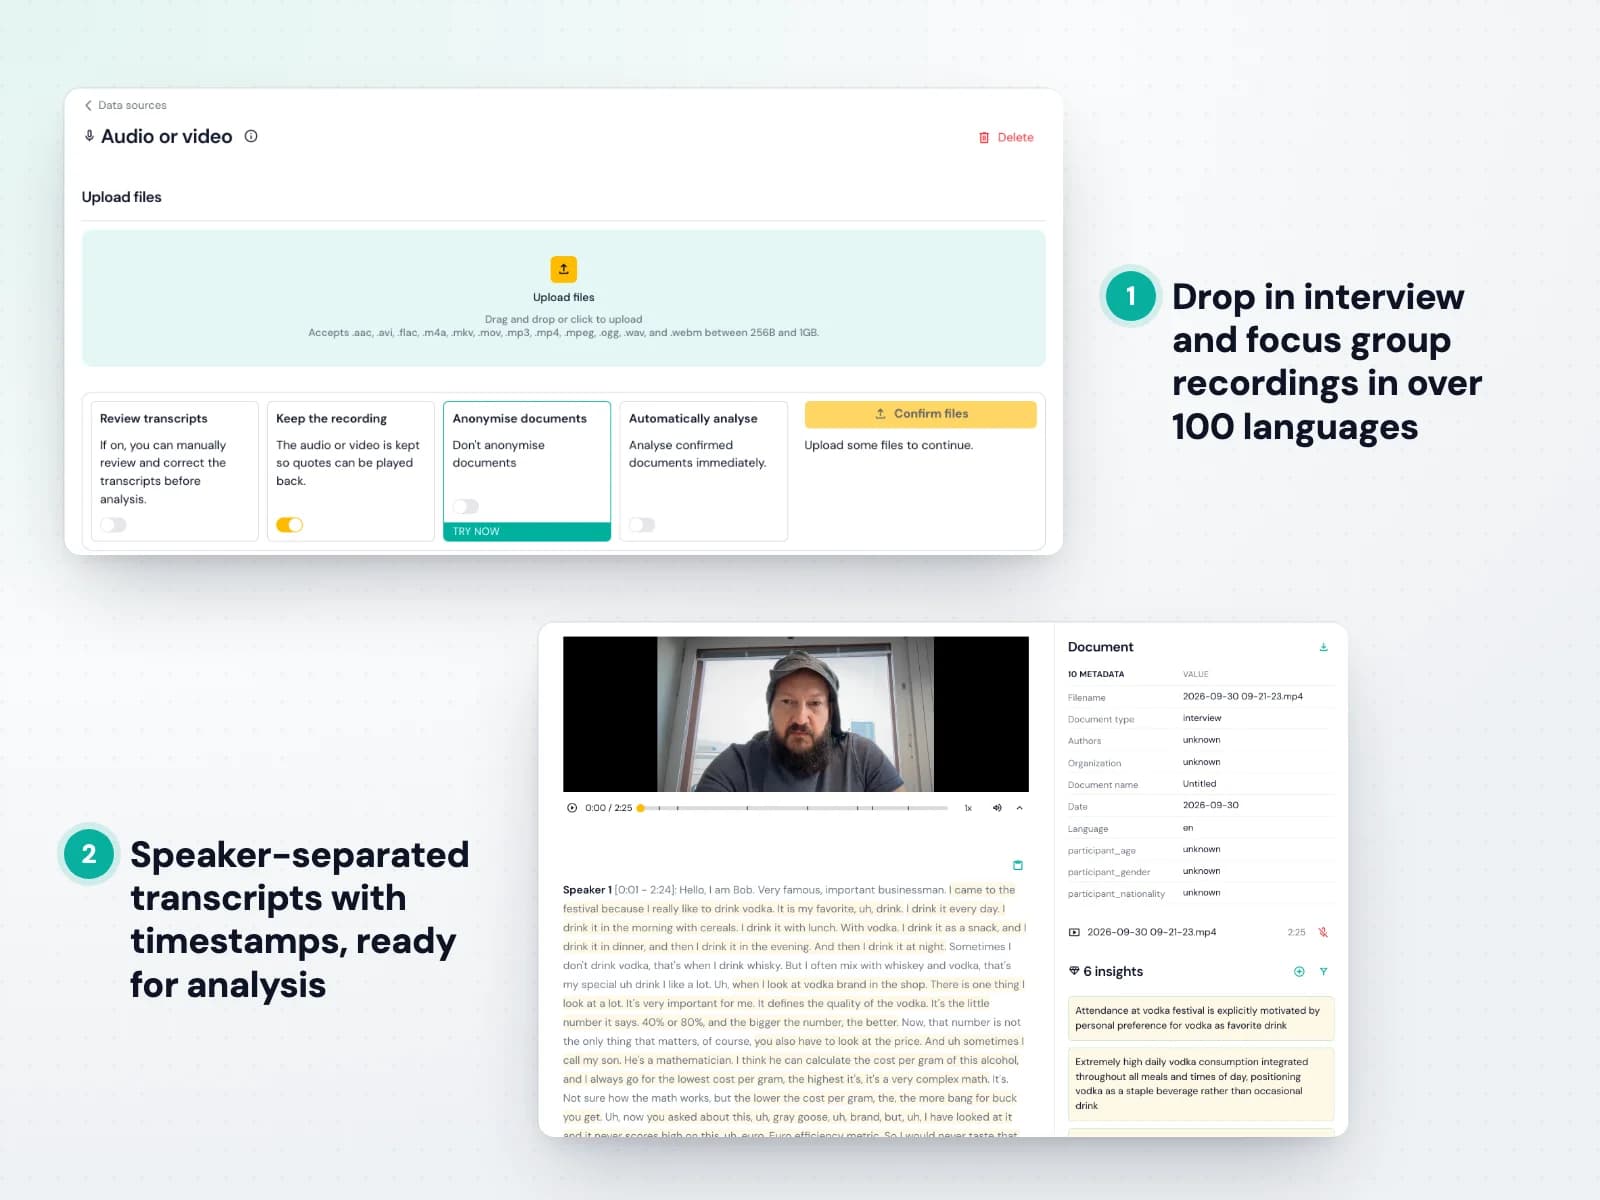
העלו שמע או וידאו ו-Skimle יהפוך אותם לתמלילים מדויקים עם כמה דוברים ביותר מ-100 שפות. אין צורך לשלם על כלי תמלול נפרד או להעביר קבצים בין מערכות: הטקסט נכנס ישר לפרויקט. ראו איך מעלים הקלטות.
לכל מקור נתונים בוחרים אם לבדוק את התמלילים לפני הניתוח, אם לשמור כל הקלטה להשמעה או למחוק אותה עד שהתמליל מוכן, ואם להתמם את הטקסט לפני כל דבר אחר.
- MP3, M4A, WAV, MP4, MOV ופורמטים נפוצים אחרים
- הפרדת דוברים וחותמות זמן
- בדיקה ידנית אופציונלית לפני הניתוח
העלאת מסמכים
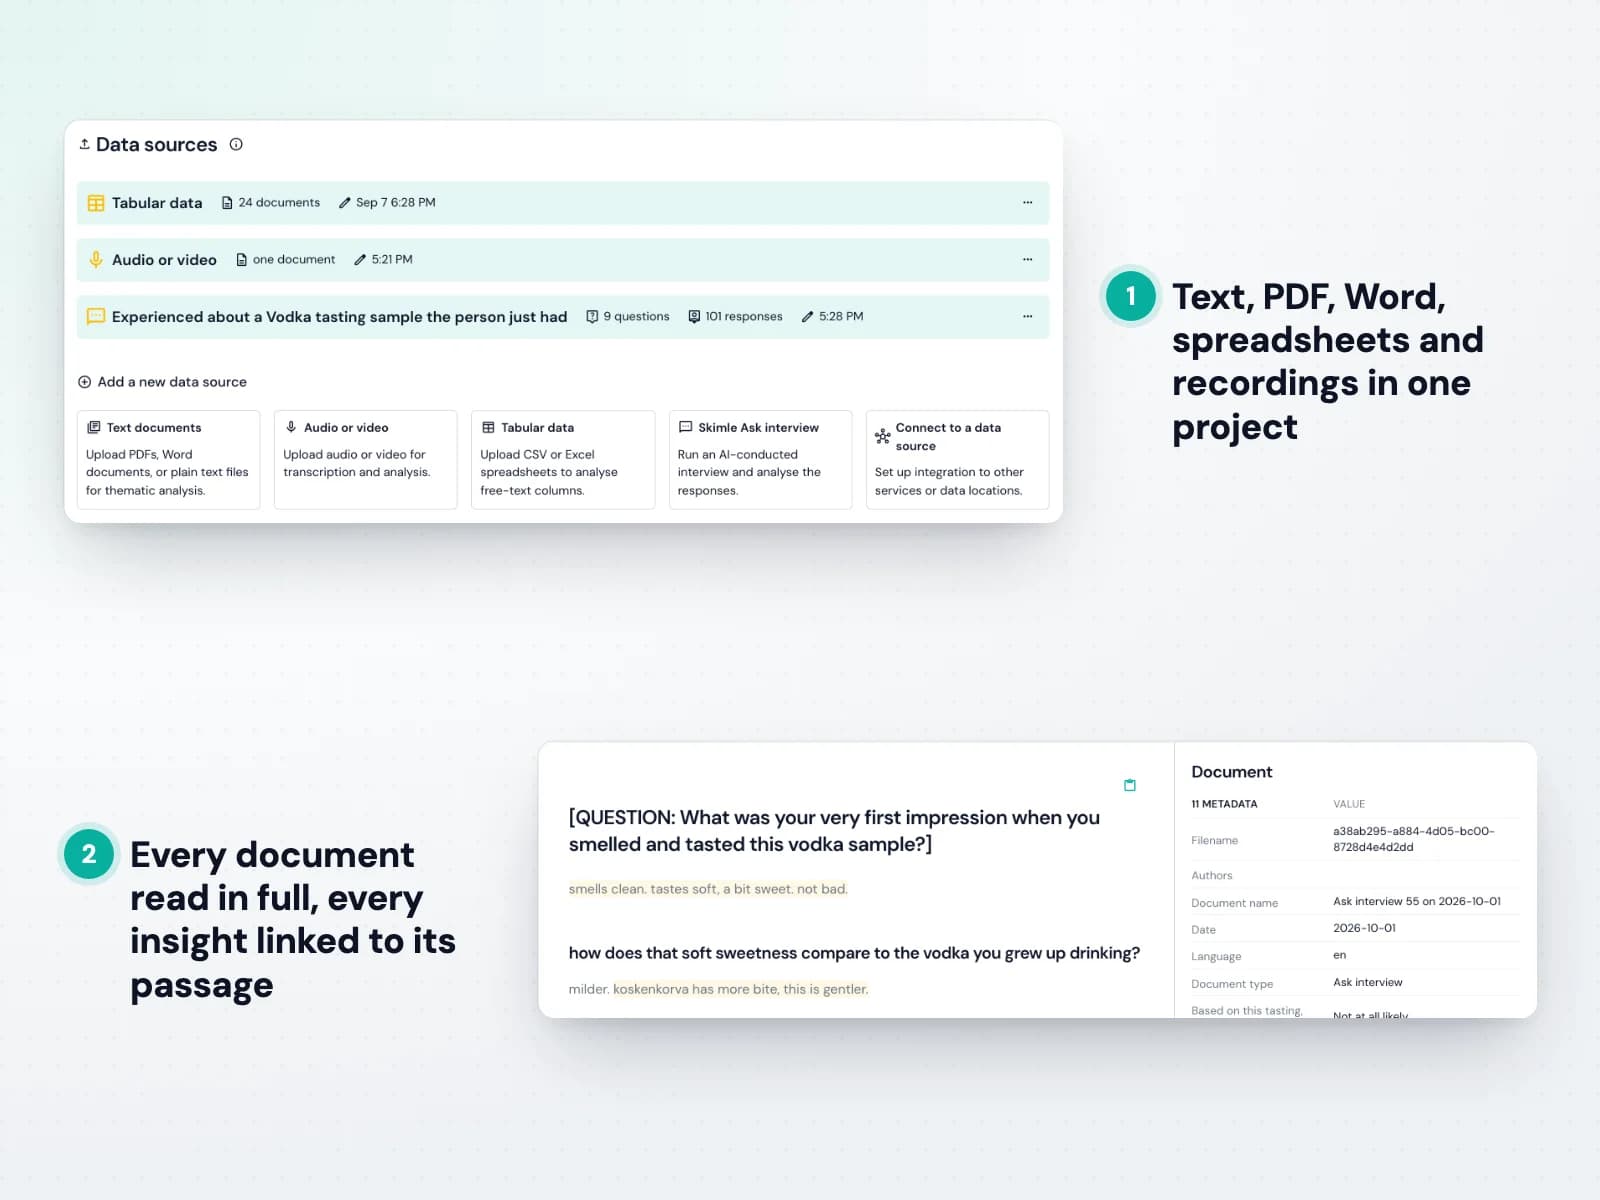
הביאו תמלילי ראיונות, דוחות, מאמרים, הערות ותשובות פתוחות בפורמטים שאתם כבר עובדים איתם, ושלבו שפות בחופשיות באותו פרויקט. ראו את הפורמטים הנתמכים.
Skimle קורא כל מסמך במלואו ושומר קישור מכל תובנה לקטע המדויק שממנו היא הגיעה, כך ששום דבר לא הולך לאיבוד והכול ניתן לבדיקה.
- PDF, Word (DOCX), RTF ו-TXT
- יותר מ-100 שפות, משולבות בפרויקט אחד
- כל תובנה מקושרת לקטע המקור שלה
ייבוא מאגרי נתונים
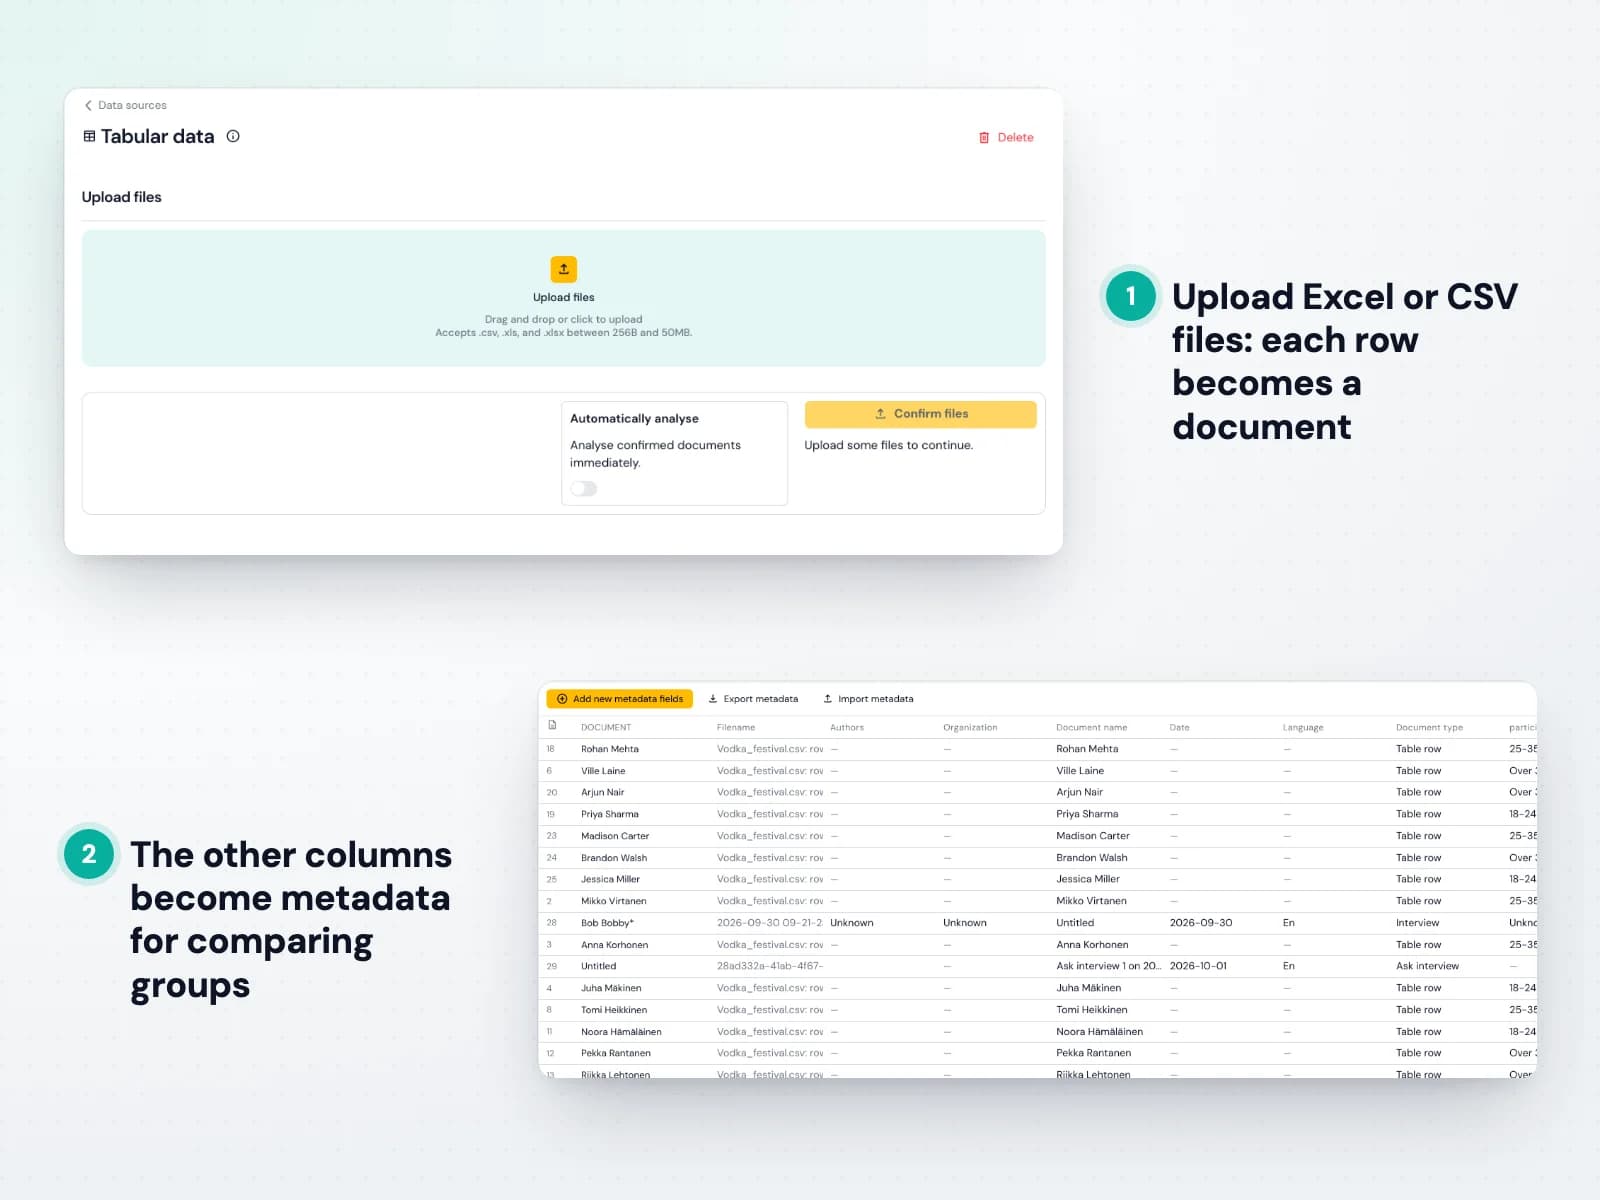
ייבאו גיליונות אלקטרוניים וייצואי סקרים בבת אחת. כל שורה הופכת למסמך, ולכל עמודה מחליטים אם היא תוכן, מטא-נתונים או שמתעלמים ממנה. ראו איך מייבאים ומוסיפים מטא-נתונים.
מאחר שהמטא-נתונים נלווים לכל תשובה, אפשר בהמשך להשוות מה אמרו קבוצות שונות של משיבים, למשל לקוחות חדשים מול נאמנים, או אזור אחד מול אחר.
- ייבוא Excel ו-CSV
- בחירת עמודות תוכן ומטא-נתונים
- אלפי תשובות בכל פרויקט
ראיונות עם Skimle Ask
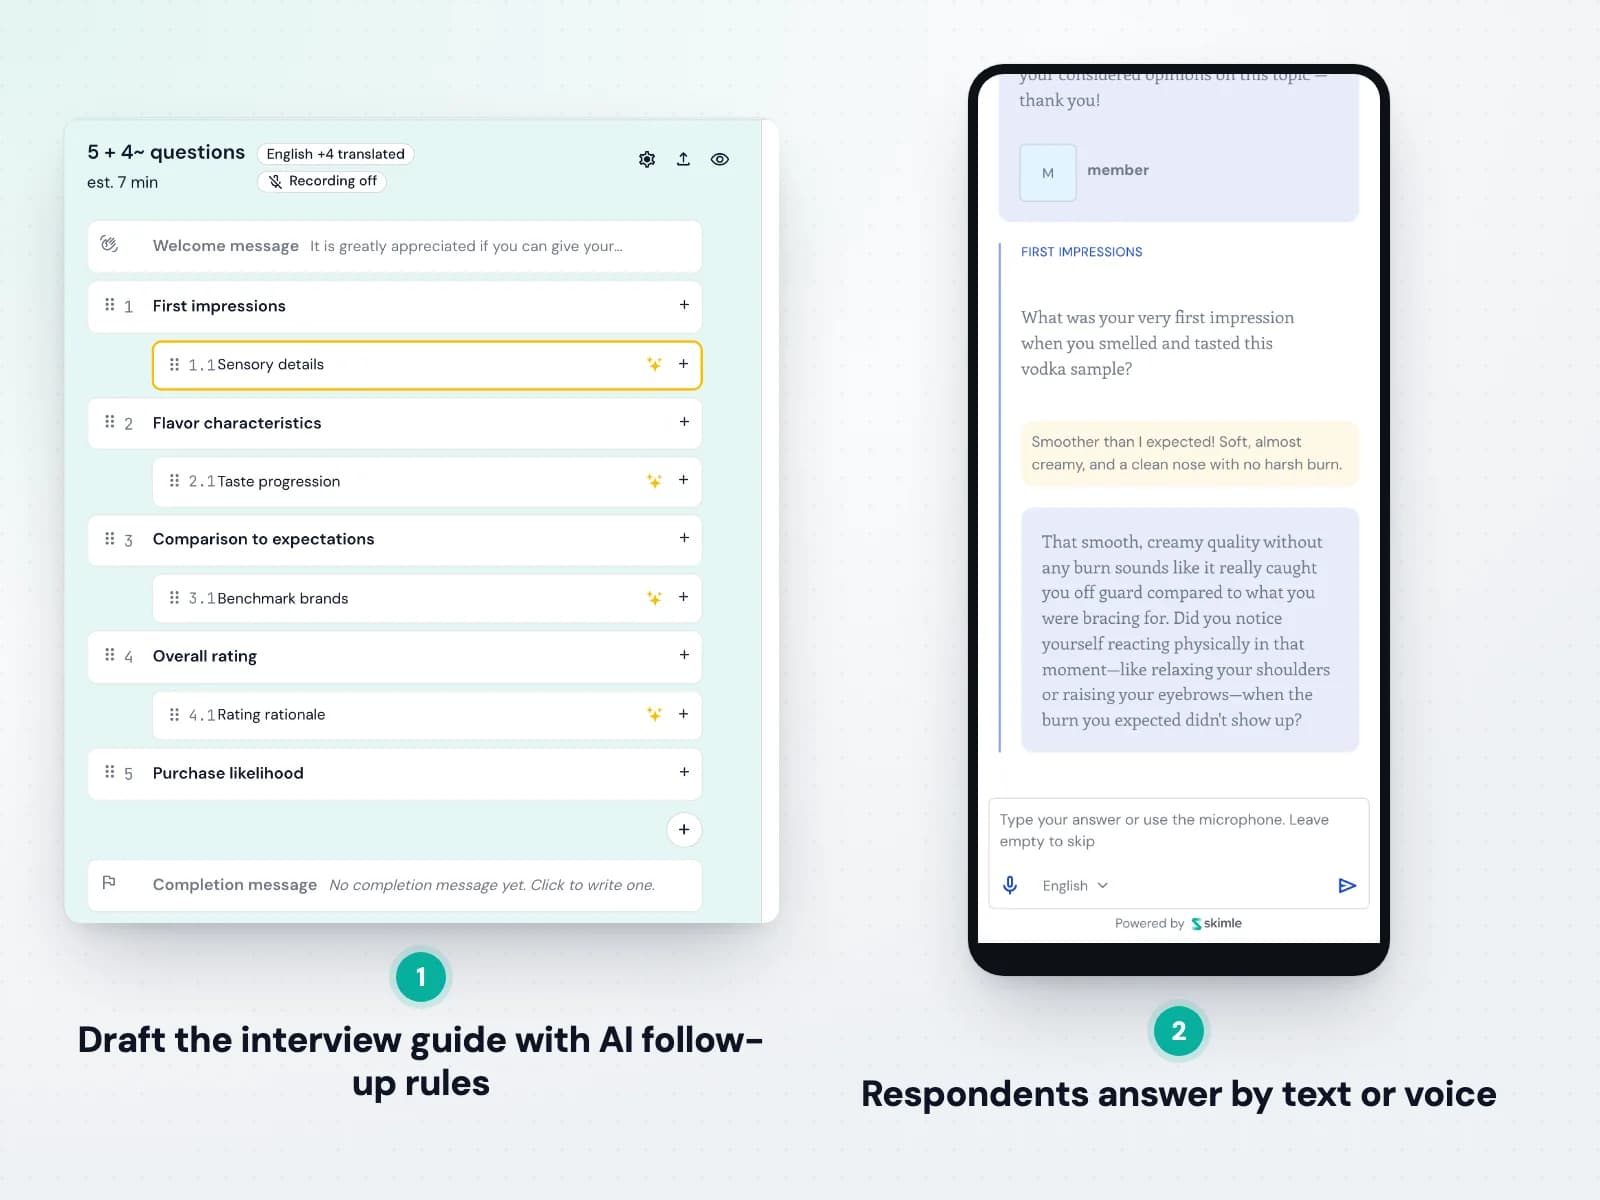
Skimle Ask מקיים ראיונות איכותניים בהיקף של סקר. תארו מה אתם רוצים ללמוד, תנו לבינה המלאכותית לנסח את מדריך הראיון, וכווננו כל שאלה ואת הנחיות ההמשך שלה. ראו איך יוצרים ראיון Ask.
המשיבים פותחים קישור, עונים בטקסט או בקול, והמראיין מבוסס הבינה המלאכותית מעמיק בפרטים כמו חוקר מיומן. ראיונות שהושלמו נכנסים ישר לניתוח לצד שאר הנתונים שלכם.
- שאלות פתוחות ושאלות רב-ברירה
- שאלות המשך בבינה מלאכותית בעומק שבשליטתכם
- ראיונות בכמה שפות

התממה
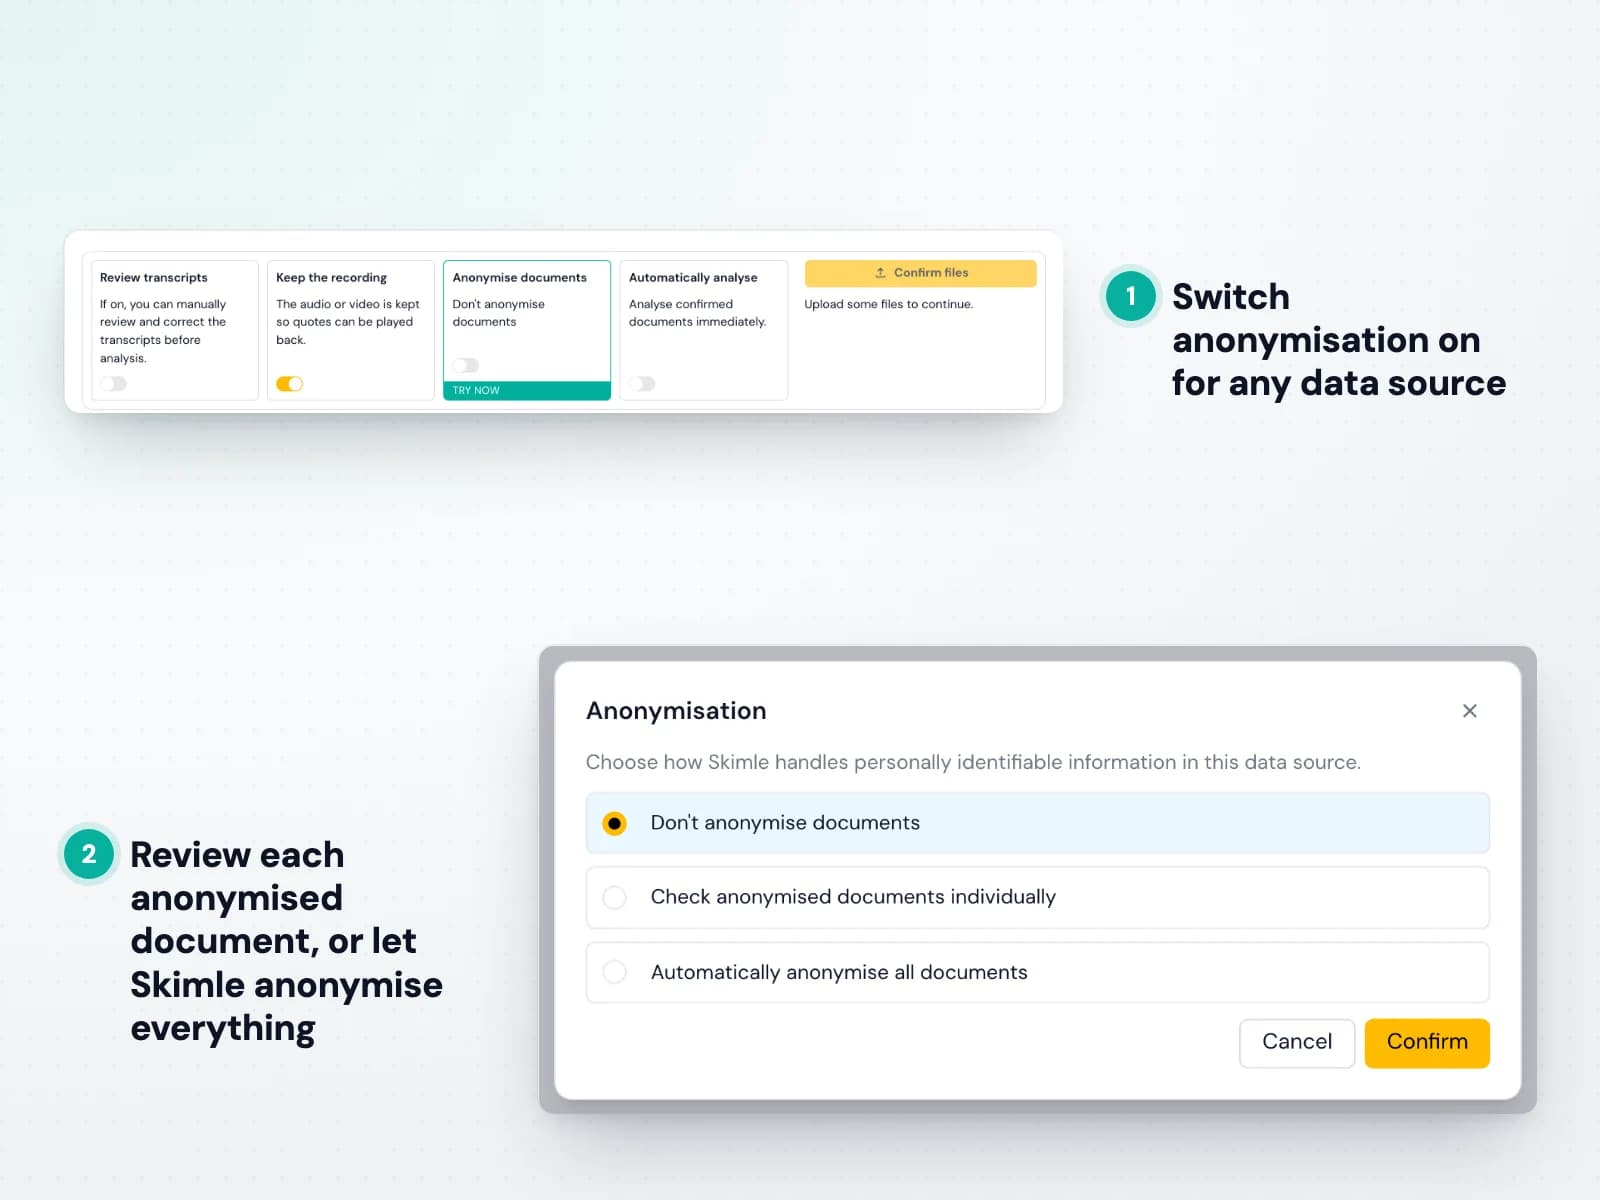
Skimle Anonymise מזהה מזהים אישיים בשש קטגוריות ומחליף אותם לפני שהנתונים מנותחים. מפעילים אותו לכל מקור נתונים בנפרד ובוחרים אם לבדוק כל מסמך או להתמם הכול אוטומטית. ראו איך ההתממה עובדת.
אותו אדם מקבל אותו כינוי בכל המסמכים, כך שהניתוח נשאר קוהרנטי, והמשיבים יכולים לדבר בחופשיות בידיעה שאי אפשר לזהות אותם.
- שמות, תפקידים, מקומות, ארגונים, תאריכים ומזהים אחרים
- כינויים עקביים בכל המסמכים
- דוח ביקורת וטבלת המרה לוועדות אתיקה
שלב 2
ניתוח וחקירה של הנתונים
מנוע ניתוח קפדני עם שקיפות ושליטה מלאות, תצוגות בשיטות משולבות, השוואות לפי מטא-נתונים ועוזר מחקר מבוסס בינה מלאכותית.
ניתוח קפדני בבסיס
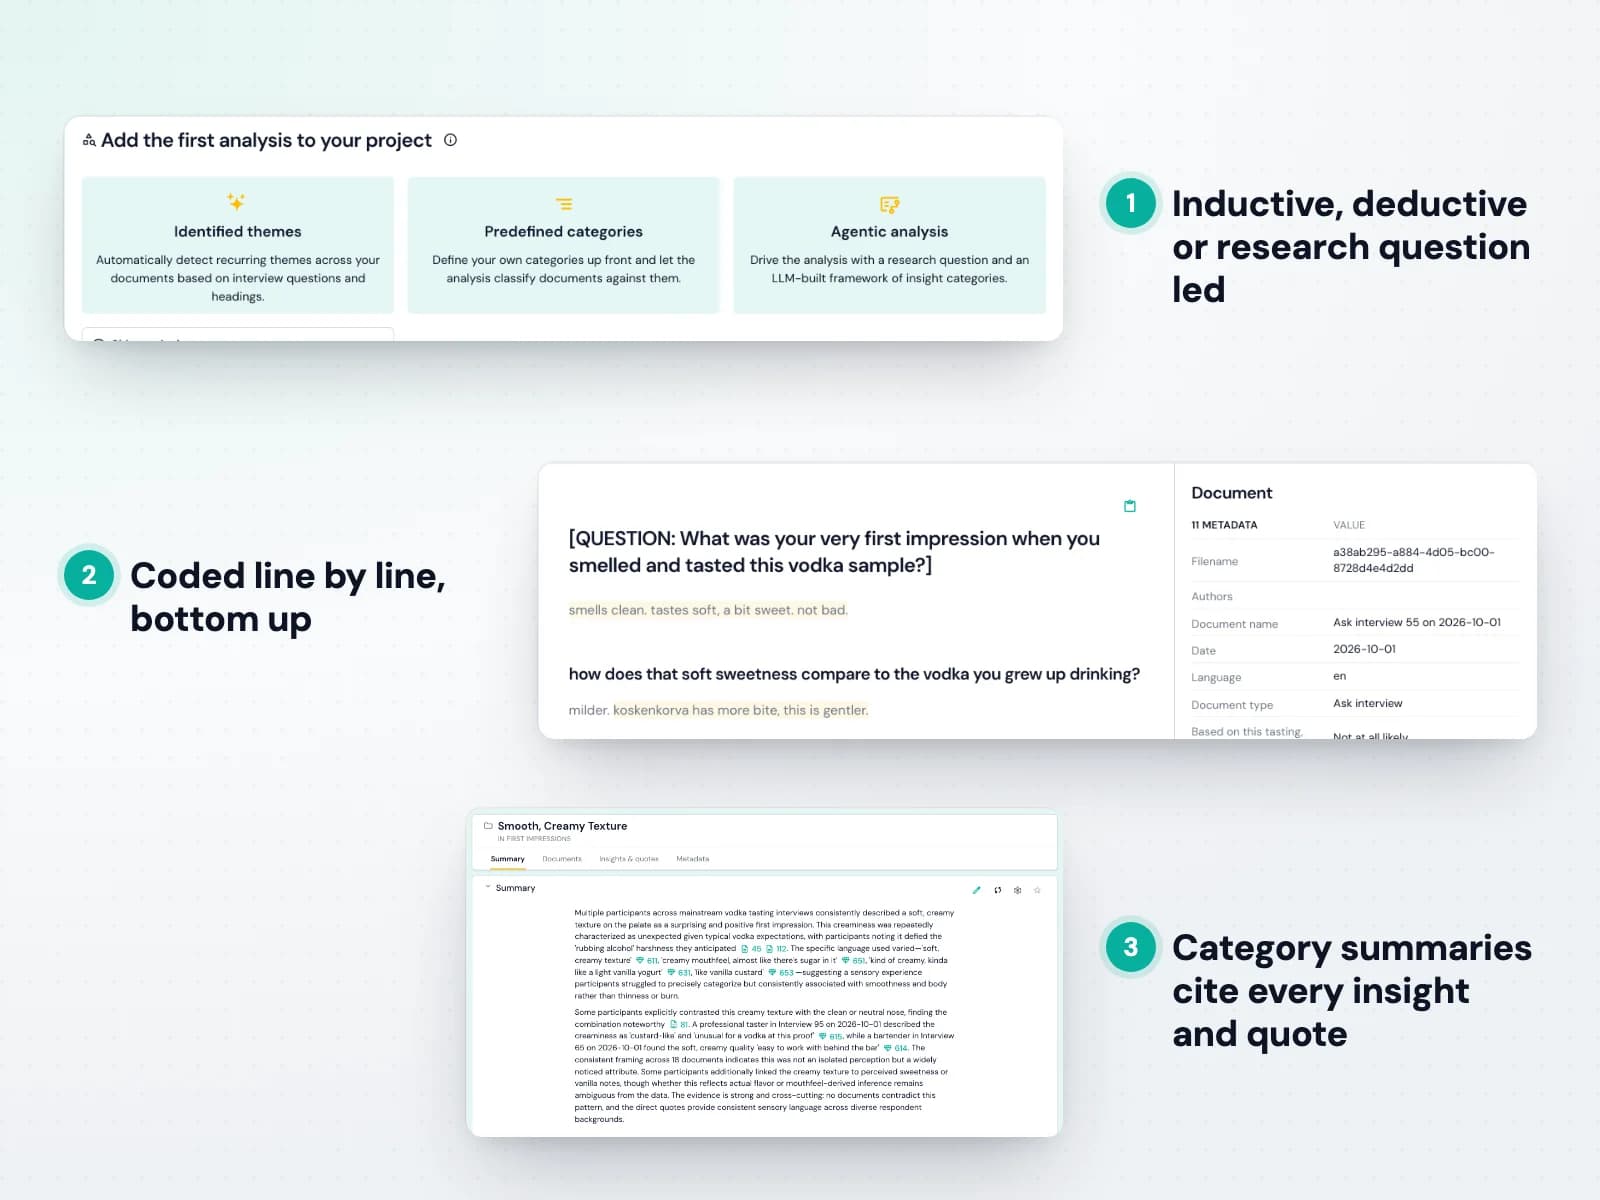
Skimle פועל לפי שיטות איכותניות מבוססות במקום לסכם. הוא קורא כל מסמך במלואו, מזהה תובנות מלמטה למעלה ומארגן אותן בקטגוריות, כשכל אחת מקושרת לציטוט המקור שלה. ראו איך הניתוח עובד.
בחרו נושאים מזוהים כדי לתת למבנה לעלות מהנתונים, קטגוריות מוגדרות מראש כדי לקודד לפי מערכת הקטגוריות שלכם, או ניתוח מבוסס סוכן שמונע משאלת המחקר שלכם. סיכומי הקטגוריות מצטטים אז כל תובנה וכל ציטוט שעליהם הם נשענים.
- ניתוח אינדוקטיבי, דדוקטיבי ומונחה שאלת מחקר
- כל תובנה מקושרת לציטוט מילולי
- סיכומים שמצטטים את הראיות שלהם
שליטה מלאה ושקיפות
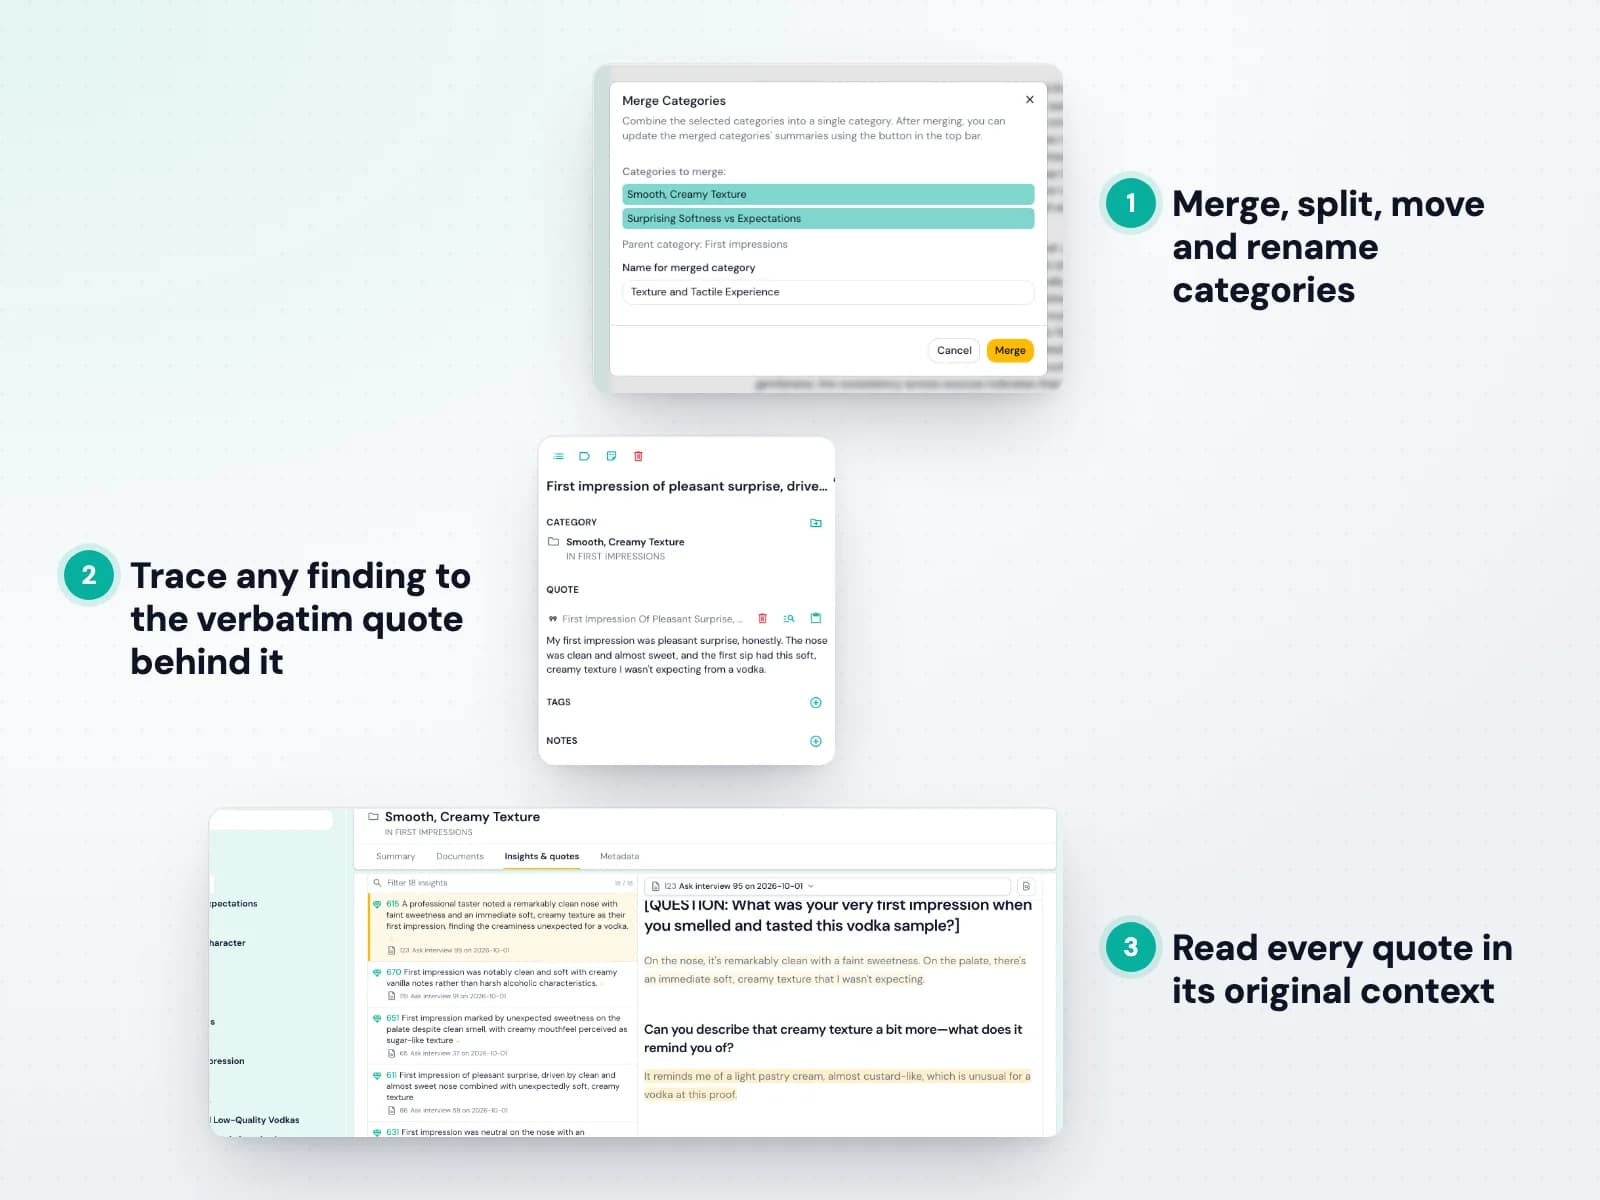
השקיפות הדו-כיוונית של Skimle אומרת שתמיד אפשר לבדוק את העבודה שלו. לחצו על כל ציטוט בסיכום כדי לראות את התובנה ואת הציטוט המילולי שמאחוריו, ופתחו את המסמך כדי לראות בדיוק מה קודד ומה לא. ראו איך מנהלים קטגוריות.
כשהמבנה לא תואם את החשיבה שלכם, שנו אותו: מזגו קטגוריות חופפות, פצלו קטגוריות רחבות מדי, תנו להן שמות במילים שלכם והעבירו תובנות ביניהן. אפשר לבטל כל שינוי.
- מיזוג, פיצול, העברה ושינוי שם של קטגוריות
- מעקב מהממצאים למקור, ומהמקורות לממצאים
- ביטול כל שינוי
שיטות משולבות והדמיית נתונים
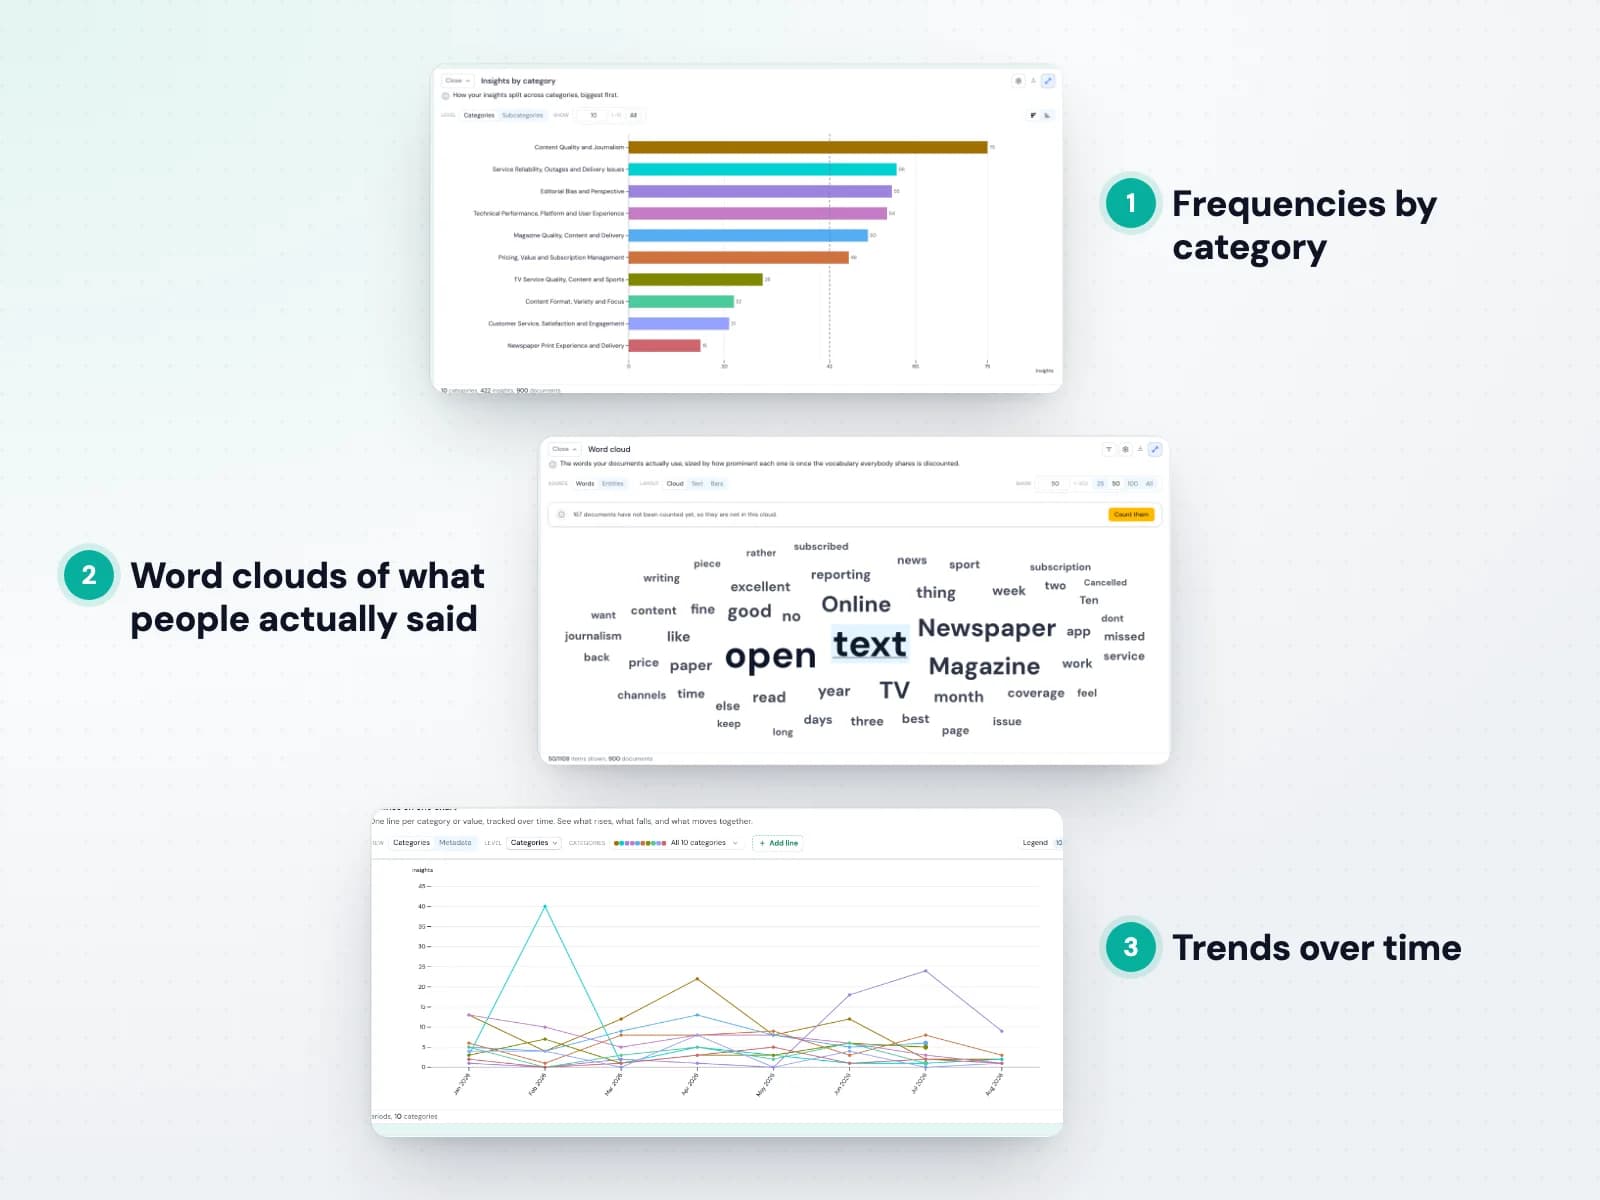
הנתונים המקודדים הופכים למספרים שאפשר לסמוך עליהם, כי כל ספירה נשענת על תובנות מאומתות. חקרו שכיחויות לפי קטגוריה, ענני מילים, מפות חום בין מסמכים ומגמות לאורך זמן. ראו את תצוגת הסטטיסטיקה.
התצוגות מתעדכנות כשאתם משפרים את המבנה, וכל עמודה או נקודה מובילות חזרה לתובנות ולציטוטים שמאחוריהן, כך שהמספרים והסיפורים תמיד תואמים.
- שכיחויות, ענני מילים ומפות חום
- מגמות לאורך זמן
- כל מספר עקיב לציטוטים שלו
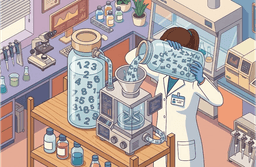
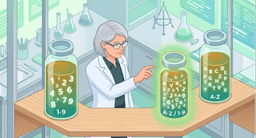
גילוי דפוסים בעזרת מטא-נתונים

השוו בין כל שתי קבוצות של מסמכים לפי המטא-נתונים שלהן, ו-Skimle יראה אילו קטגוריות כל קבוצה מעלה יותר מהאחרת. אחר כך הוא כותב מה מבדיל בין הקבוצות ומה משותף להן, עם ציטוטים. ראו איך מנתחים מטא-נתונים.
לא בטוחים איזה פילוח חשוב? Skimle מדרג כל פילוח לפי מטא-נתונים לפי המידה שבה הוא מרחיק בין הקבוצות, כך שתמצאו את ההבדלים ששווה לדווח עליהם במקום לבדוק אותם אחד אחד.
- השוואות קבוצות עם סיכומים כתובים
- כל פילוח מדורג לפי גודל אפקט
- מטא-נתונים מהנתונים שלכם או כאלה שהבינה המלאכותית מסיקה
צ׳אט מבוסס סוכנים כעוזר המחקר שלכם
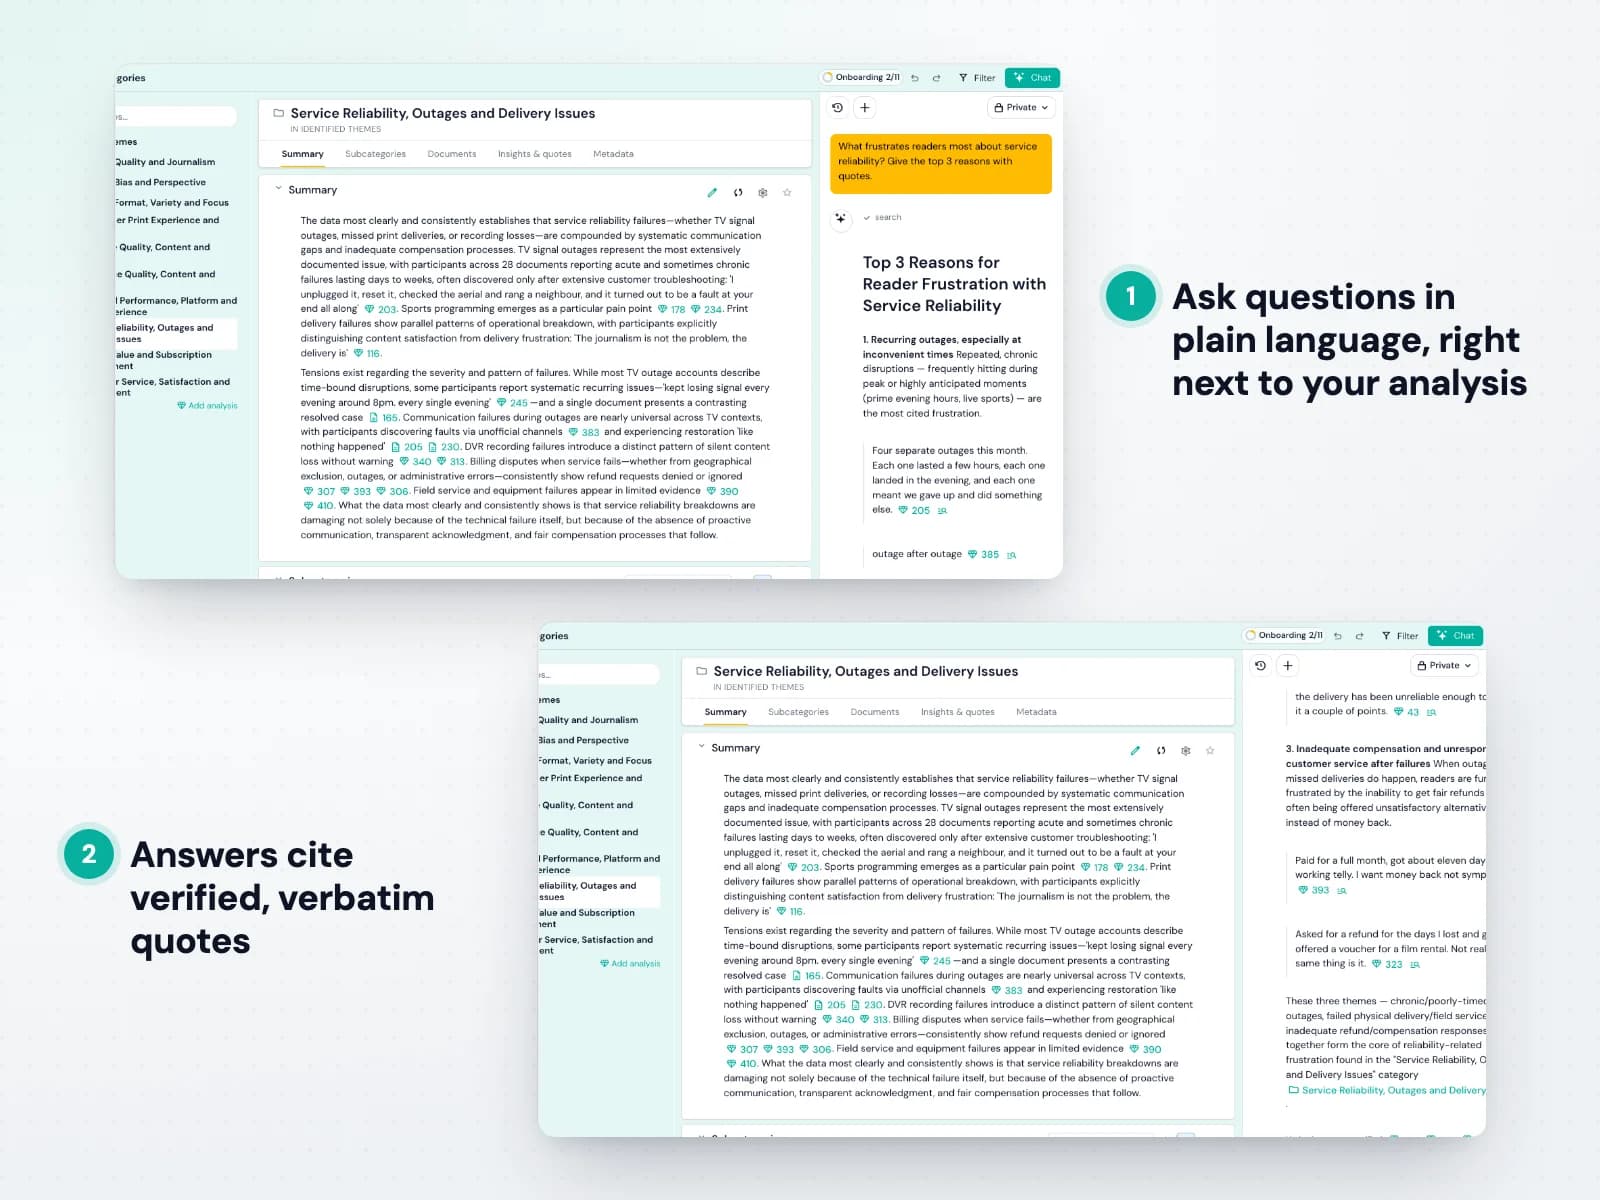
עוזר המחקר עובד על גבי הניתוח המובנה שלכם ולא על מסמכים גולמיים. שאלו שאלות בשפה פשוטה, והוא יחפש בתובנות המקודדות, יסיק בשלבים שאפשר לעקוב אחריהם ויענה עם ציטוטים מילוליים מאומתים. ראו איך משתמשים בצ׳אט הבינה המלאכותית.
הוא יכול גם לפעול על הניתוח: ליצור תובנות, לארגן מחדש קטגוריות ולהוסיף הערות, הכול באמצעות אותן פקודות שאתם משתמשים בהן, כך שכל שינוי נשאר גלוי והפיך.
- תשובות שמבוססות על ציטוטים מאומתים
- חיפוש בכל תובנה מקודדת
- יכול לארגן מחדש את הניתוח ולהוסיף לו הערות
שלב 3
ייצוא ושילוב
שתפו ממצאים כמצגות וכדוחות, ייצאו לכלים שאתם עובדים איתם וחברו את המערכות וסוכני הבינה המלאכותית שלכם.
מצגות משכנעות
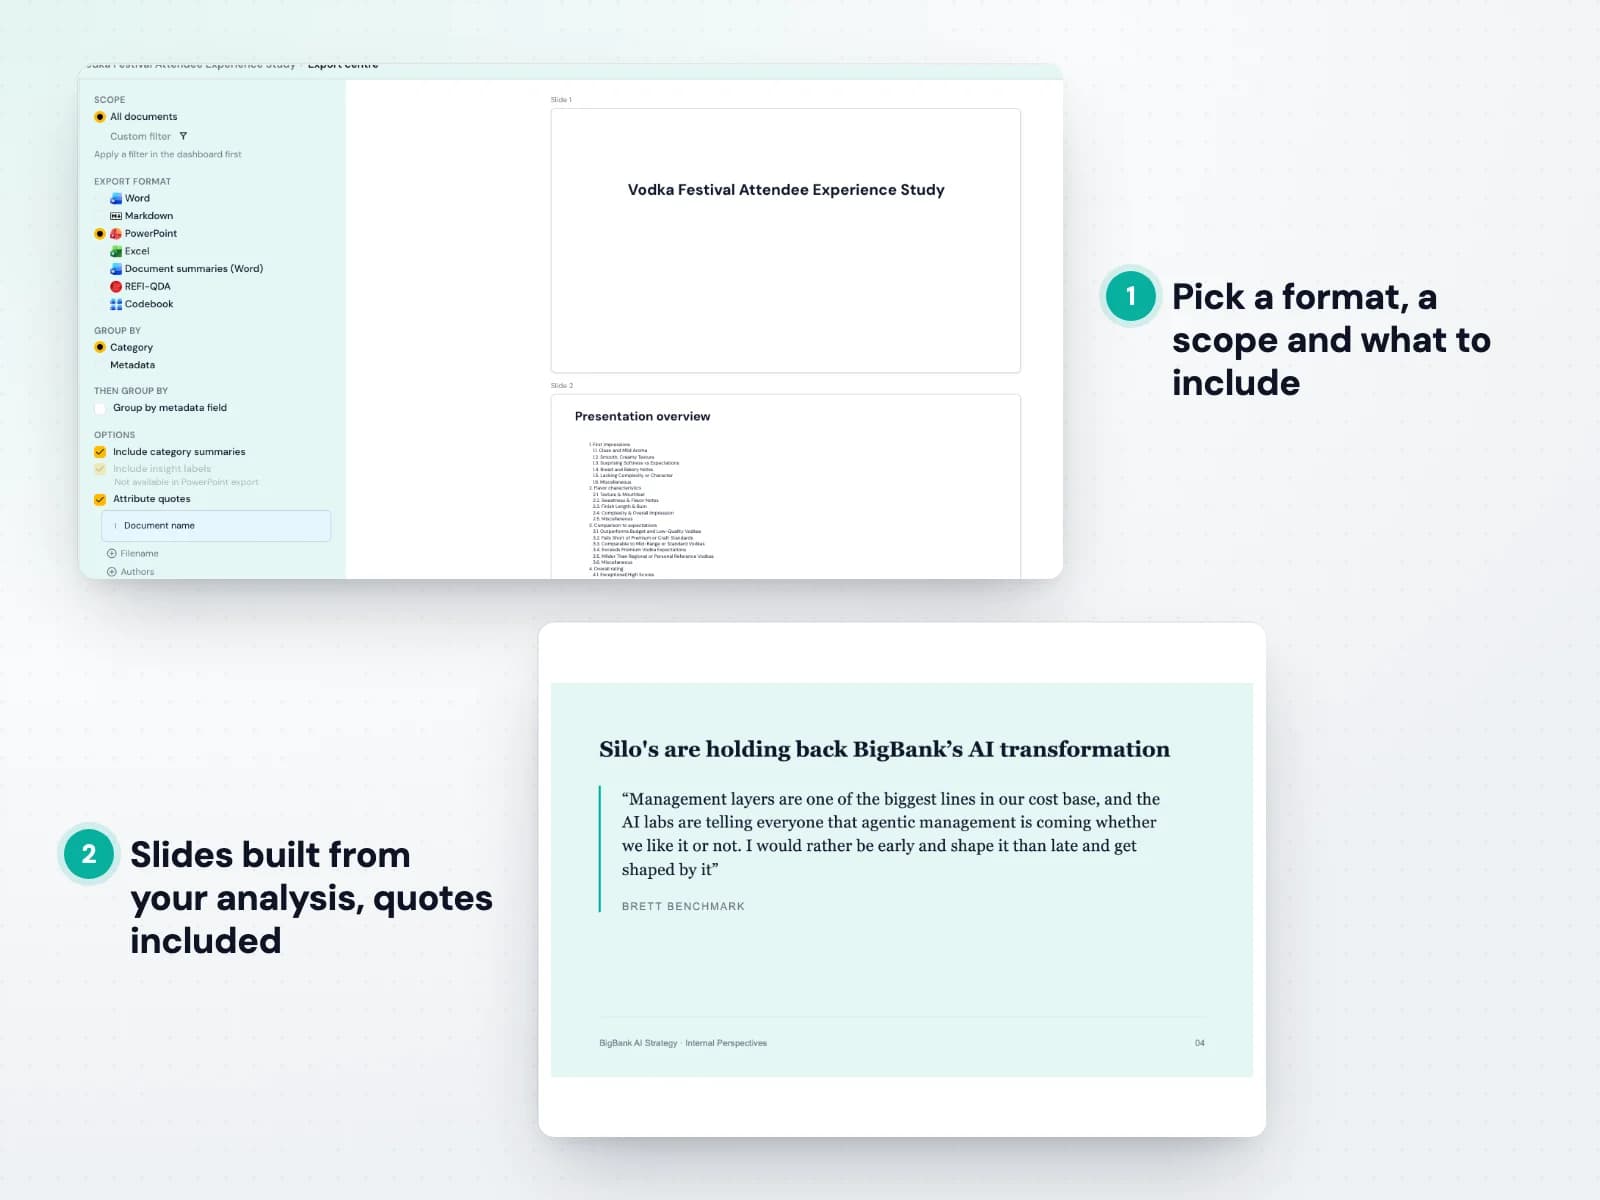
ייצאו את הניתוח כמצגת PowerPoint או כדוח Word. בחרו את ההיקף, קבצו את הממצאים לפי קטגוריה או מטא-נתונים, והחליטו אם לכלול סיכומים, ציטוטי מקור וציטוטים עם ייחוס. ראו איך מייצאים ל-Office.
התוצאה היא נקודת פתיחה מוכנה לדוח או למצגת: נושאים, ראיות וציטוטים כבר במקומם, וכל אחד מהם עקיב חזרה לניתוח.
- מצגות PowerPoint ודוחות Word
- סיכומים, ציטוטי מקור וציטוטים עם ייחוס
- היקף וקיבוץ לבחירתכם
מחברי API ו-MCP
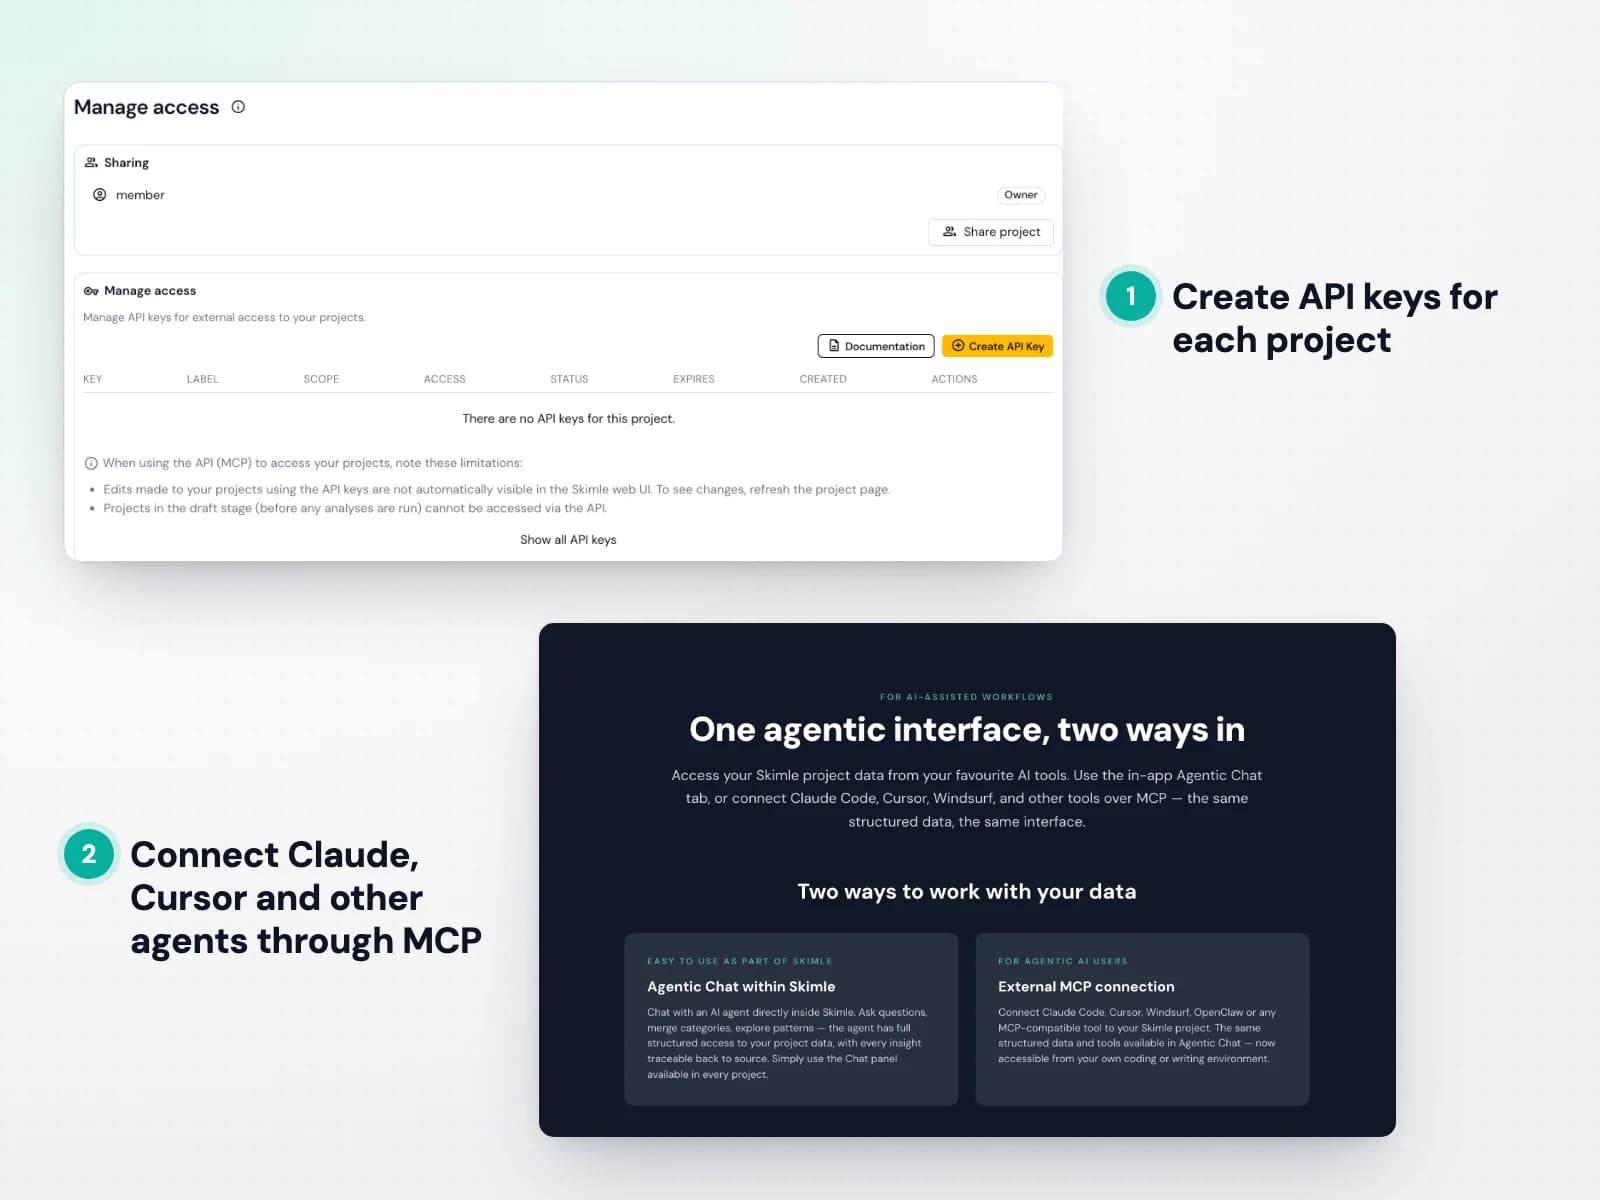
שרת ה-MCP של Skimle מאפשר ל-Claude, Cursor, Windsurf ולסוכנים תואמים אחרים לעבוד עם נתוני הפרויקט המובנים שלכם, באותם כלים שהסוכן שבתוך האפליקציה משתמש בהם. קראו עוד על חיבור באמצעות MCP.
ה-REST API מאפשר למערכות שלכם לקרוא ולכתוב נתוני פרויקט או להריץ פרויקט מקצה לקצה. יוצרים מפתחות API לכל פרויקט, עם הרשאת קריאה או עריכה, מהגדרות הגישה של הפרויקט.
- MCP ל-Claude, ל-Cursor ולסוכנים אחרים
- REST API לקריאה ולכתיבה של נתוני פרויקט
- מפתחות API לכל פרויקט
ייצוא נתונים
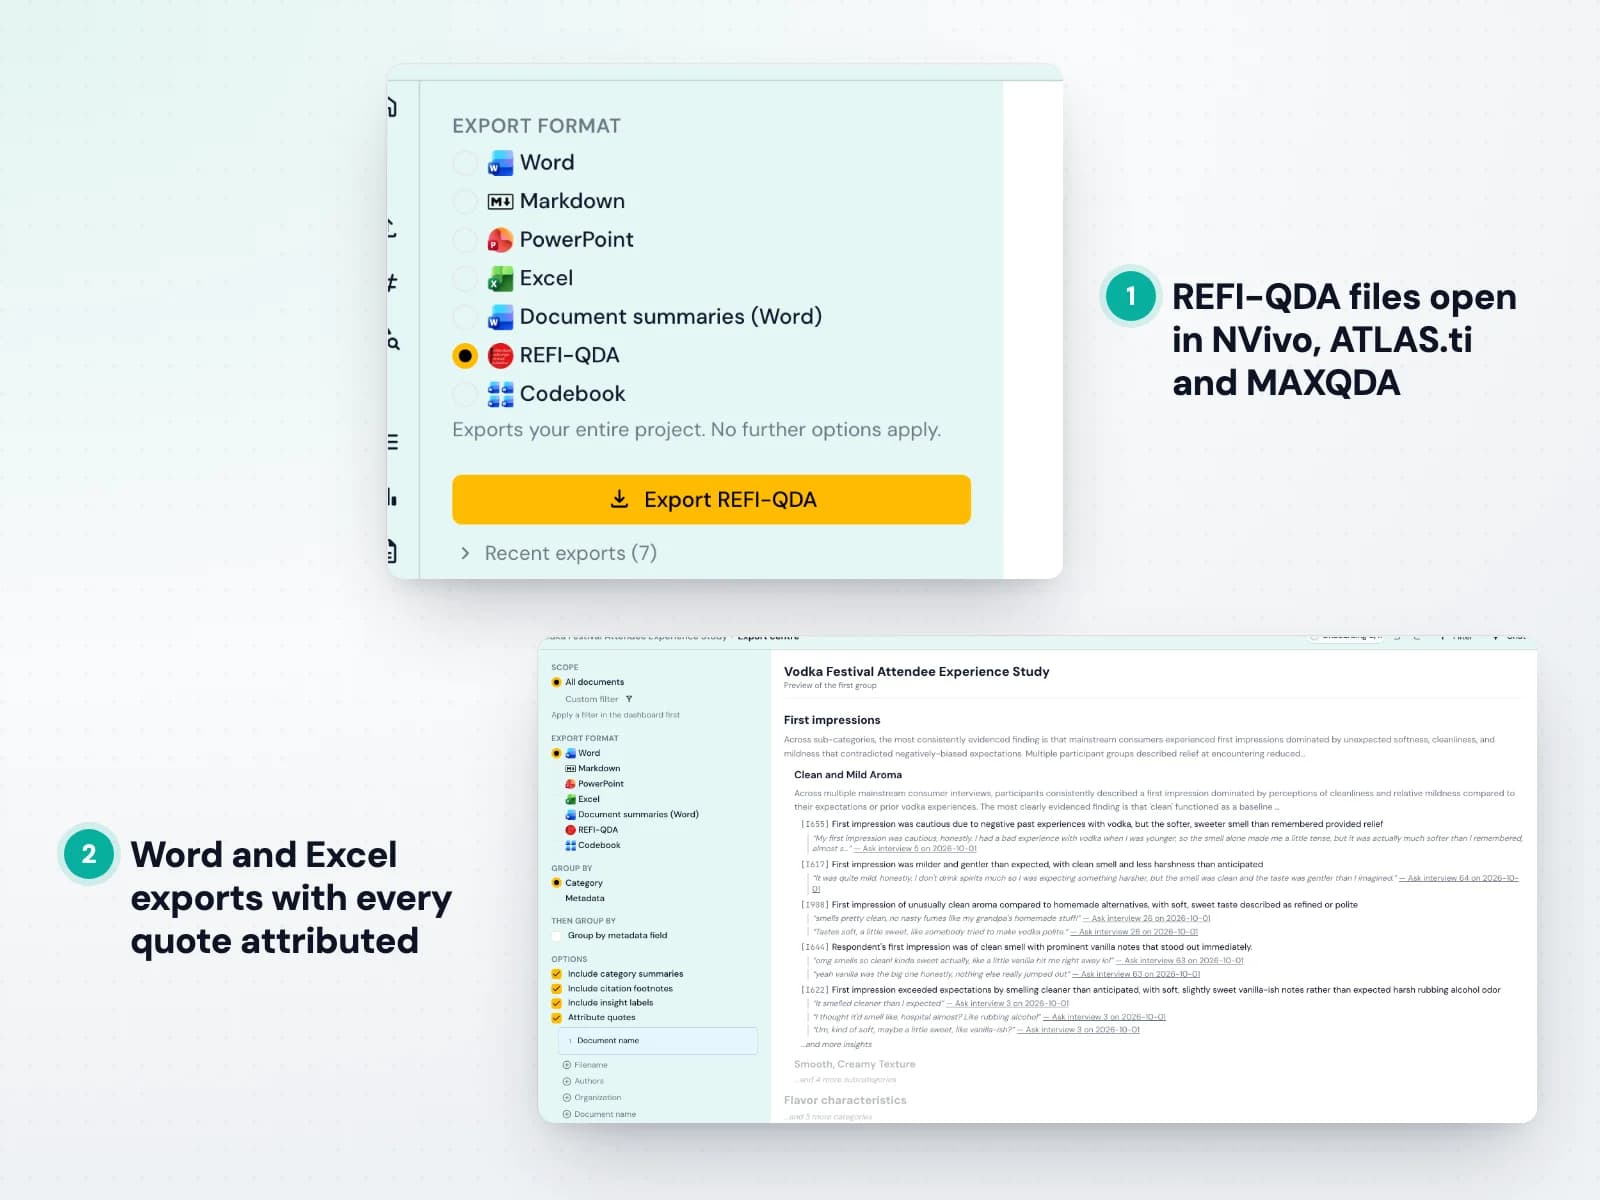
קחו את הניתוח לכל מקום שצריך: Excel לטבלת Skimle המלאה, Word עם הקידוד כהערות, והפורמט הפתוח REFI-QDA ל-NVivo, ל-ATLAS.ti ול-MAXQDA. ראו איך מייצאים ל-REFI-QDA.
ייצאו את מערכת הקטגוריות, שמרו עותק של הניתוח המלא לצד נתוני המחקר, או המשיכו בקידוד ידני בכלי ותיק.
- Excel, Word ו-REFI-QDA (qdpx)
- ייצוא מערכת הקטגוריות
- עובד עם NVivo, ATLAS.ti ו-MAXQDA
הפלטפורמה
פלטפורמה מאובטחת לשיתוף פעולה
הגנת נתונים ברמה ארגונית, כשהצוות שלכם עובד יחד על ניתוח משותף אחד.
פלטפורמה מאובטחת
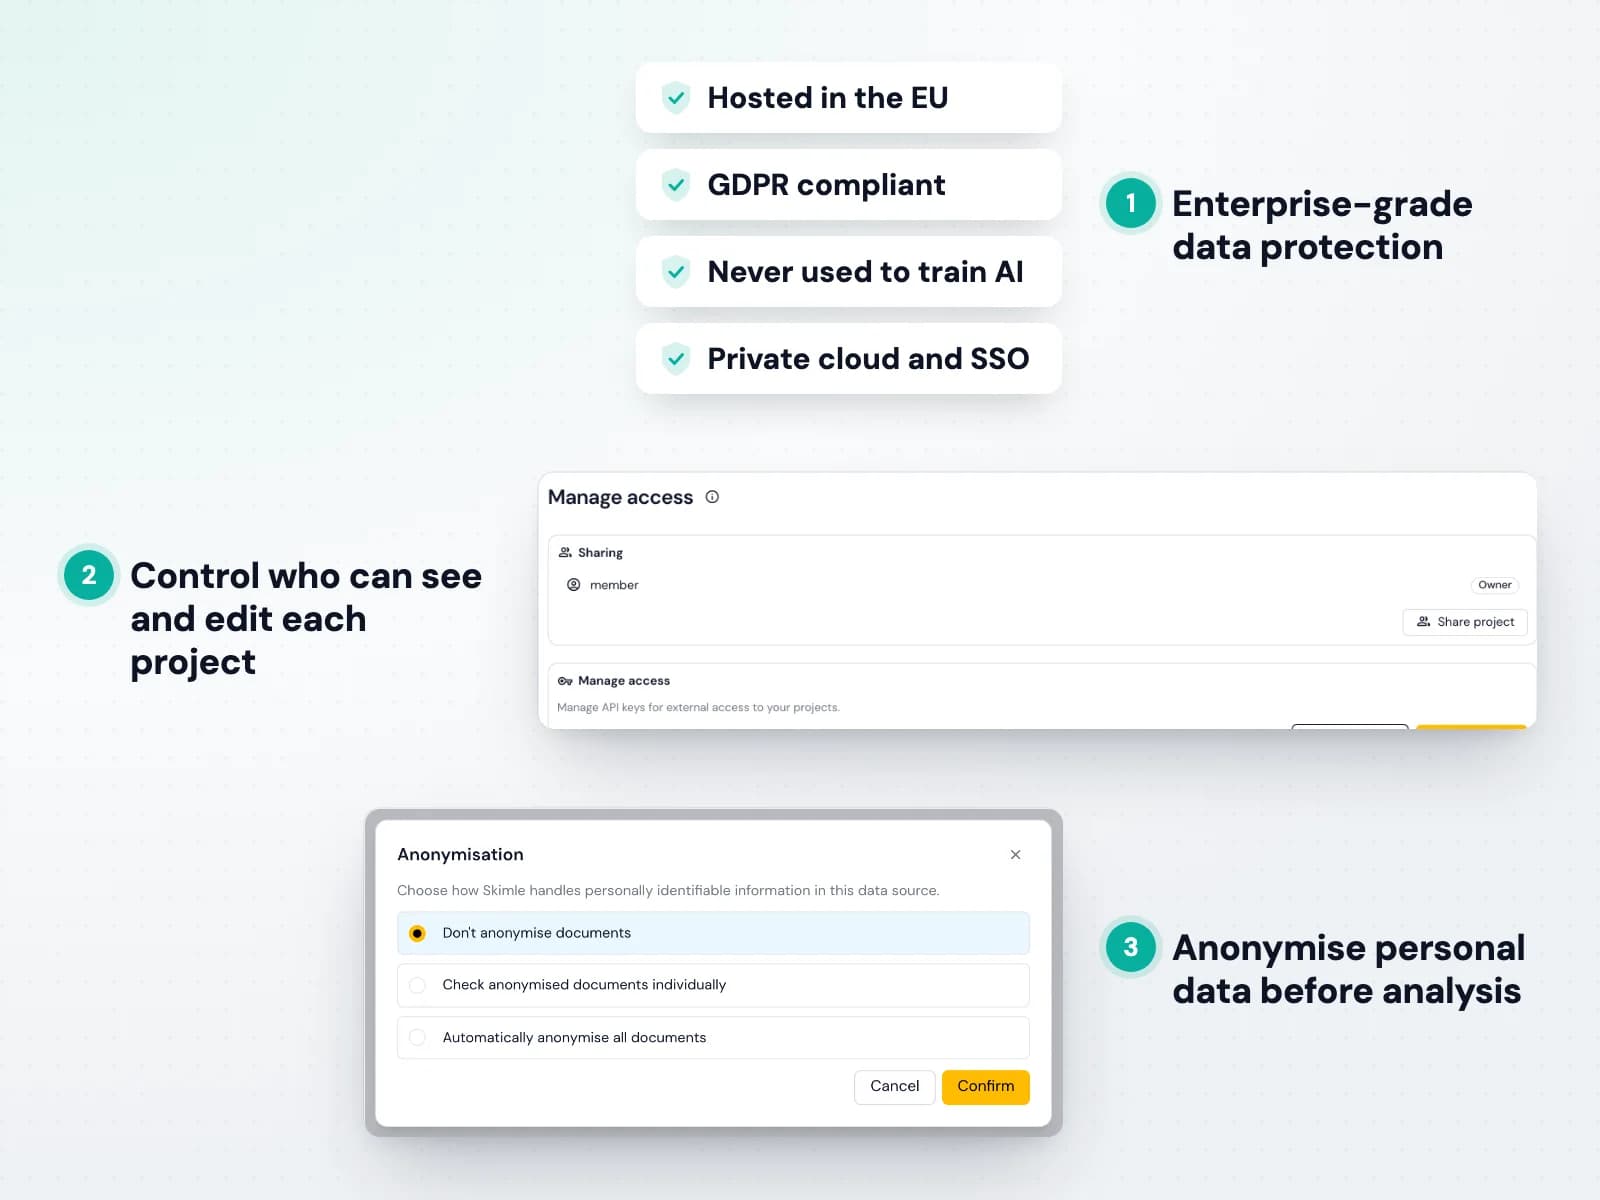
Skimle נבנה למחקר רגיש. כל הנתונים מאוחסנים ב-EU, מוצפנים בהעברה ובמנוחה, ולעולם אינם משמשים לאימון מודלים של בינה מלאכותית. קראו את מדיניות הפרטיות שלנו.
אתם קובעים מי יכול לראות ולערוך כל פרויקט, אפשר להתמם מידע אישי לפני הניתוח, וזמין הסכם עיבוד נתונים. לקוחות ארגוניים יכולים לבחור התקנה בענן פרטי והזדהות יחידה (SSO).
- אחסון ב-EU ועמידה ב-GDPR
- לעולם לא משמש לאימון מודלים של בינה מלאכותית
- ענן פרטי ו-SSO לארגונים
שיתוף פעולה
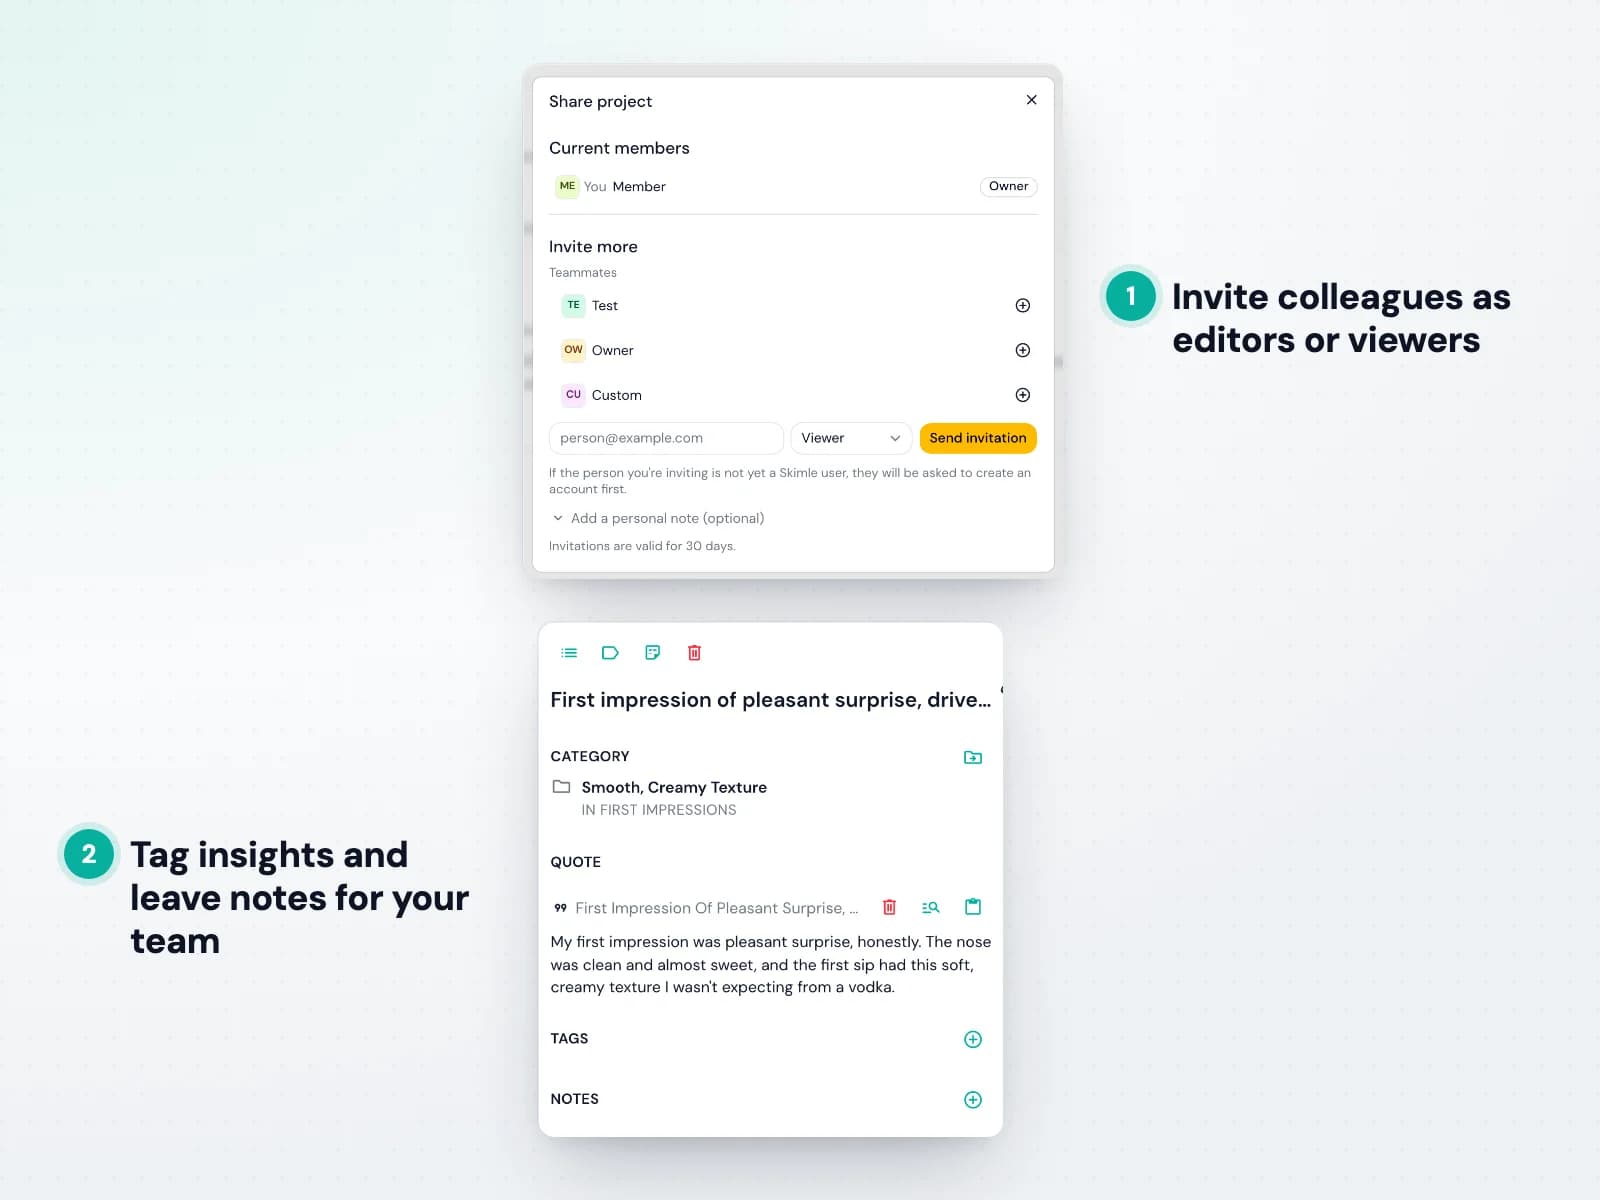
פרויקט ב-Skimle הוא סביבת עבודה משותפת. הזמינו עמיתים כעורכים שיכולים להעלות ולערוך, או כצופים שיכולים לחקור הכול בלי לשנות. ראו איך השיתוף עובד.
החלטות הקידוד, התגיות וההערות נשארות במקום אחד, כך שצוות המחקר, הלקוח או המנחה תמיד רואים את אותו ניתוח עדכני.
- תפקידי עורך וצופה
- תגיות והערות על תובנות
- ניתוח משותף ועדכני אחד
איך Skimle בהשוואה לאחרים
כלים ידניים קפדניים אבל איטיים, בינה מלאכותית כללית מהירה אבל אי אפשר לבדוק אותה, וכלים ייעודיים בנויים למשימה אחת במחיר גבוה. רק Skimle משלב מנוע ניתוח קפדני, שקיפות מלאה ורב-גוניות, החל מ-20 € למשתמש לחודש.
| כלים ידניים NVivo, MAXQDA, ATLAS.ti… | כלי בינה מלאכותית כלליים ChatGPT, Claude… | כלים ייעודיים לתחום CoLoop, Listen Labs… | Skimle | |
|---|---|---|---|---|
| מנוע ניתוח קפדני |  | | | |
| שקיפות דו-כיוונית, מהסיכום ועד המקור | | | | |
| רב-גוני בסוגי נתונים ובתרחישי שימוש | | | | |
| מהיר | | | | |
| קל ללמידה | | | | |
| מחיר | כ-80 € למשתמש לחודש | כ-20 € למשתמש לחודש | 400 € ומעלה לחודש | החל מ-20 € לחודש, ניסיון חינם |
| היקף | מוגבל במאמץ הקידוד הידני | הקשר מוגבל, כיסוי שאי אפשר לאמת | תלוי בכלי | אלפי מסמכים בכל פרויקט |
| GDPR ואבטחת נתונים | תלוי בהתקנה | תלוי בתוכנית ובהגדרות | תלוי בספק | מובנה · שרתים ב-EU · DPA זמין |
| השורה התחתונה | קפדנות ברמת פרסום, אבל שבועות של קידוד ידני בכל פרויקט. | מהיר, אבל התשובות משתנות לפי הפרומפט ואי אפשר לעקוב אחריהן או להגן עליהן. | בנויים לתהליך עבודה אחד, לרוב במחירים ארגוניים. | קפדנות ברמה אקדמית במהירות של בינה מלאכותית, שקוף לגמרי, לכל סוג של נתונים איכותניים. |
שאלות נפוצות
שאלות נפוצות
- מה זה Skimle?
- Skimle היא פלטפורמה לניתוח נתונים איכותניים מבוססת בינה מלאכותית, שמארגנת באופן שיטתי מסמכים לא מובנים, כמו ראיונות, דוחות, שימועים ומשוב לקוחות, למערכי נתונים מסודרים שאפשר לנתח, עם עקיבות מלאה. בניגוד לצ׳אטבוטים, Skimle מעבד מראש את כל אוסף המסמכים, מחלץ תובנות ומארגן אותן בנושאים היררכיים שבהם כל ממצא מקושר לציטוט מילולי מאומת.
- במה Skimle שונה מ-ChatGPT או מכלים מבוססי RAG?
- כלי RAG שולפים קטעים רלוונטיים בזמן השאילתה, ולכן בכל פעם שתשאלו את אותה שאלה תקבלו תשובה אחרת. Skimle מבצע מראש ניתוח שיטתי של כל מערך הנתונים ויוצר מבנה יציב שבו כל נושא מקושר לציטוטים מאומתים. במקום תשובות מקופסה שחורה, מקבלים כיסוי מקיף, תוצאות עקביות ועקיבות מלאה.
- במה Skimle שונה מ-NVivo, MAXQDA או ATLAS.ti?
- כלים מסורתיים דורשים קידוד ידני של כל קטע: שיטתי אבל גוזל זמן, שבועות עד חודשים. Skimle הופך את הקידוד לאוטומטי בעזרת בינה מלאכותית ושומר על אותה מתודולוגיה שיטתית ושקופה. מקבלים קפדנות ברמת NVivo בשבריר מהזמן, עם ממשק ענן אינטואיטיבי יותר שלא דורש שבועות של הכשרה.
- האם אפשר להשתמש ב-Skimle למחקר אקדמי?
- כן. Skimle נבנה בידי אקדמאים ושואב השראה משיטות מבוססות: ניתוח תמטי (Braun & Clarke), תיאוריה מעוגנת (Glaser & Strauss; Strauss & Corbin) ושיטת Gioia (Gioia, Corley & Hamilton). מסלול הביקורת המלא של Skimle מאפשר לתעד במסמך בדיוק איך הנושאים נגזרו, וכך עונה על דרישות שיפוט העמיתים. כיום חוקרים ביותר מ-30 אוניברסיטאות משתמשים ב-Skimle, ולפי בקשה נספק נוסח מוצע לציטוט.
- באילו שפות ופורמטים של קבצים Skimle תומך?
- Skimle תומך ביותר מ-100 שפות ומקבל קובצי PDF, Word (docx), RTF, TXT, CSV, שמע (MP3, M4A, WAV) ווידאו (MP4, MOV). אפשר לשלב פורמטים ושפות באותו פרויקט, למשל להעלות יחד ראיונות באנגלית, דוחות בגרמנית ותשובות לסקר בספרדית. שמע ווידאו מתומללים אוטומטית.
- האם Skimle עומד ב-GDPR ומאובטח?
- כן. כל הנתונים מאוחסנים באיחוד האירופי ולעולם אינם יוצאים משרתי ה-EU. Skimle עומד באופן מלא ב-GDPR ומספק הסכמי עיבוד נתונים ללקוחות מוסדיים. המסמכים שלכם לעולם אינם משמשים לאימון מודלים של בינה מלאכותית. ללקוחות ארגוניים עם דרישות מחמירות לריבונות נתונים זמינות התקנות ענן ייעודיות לדייר יחיד.
- איך Skimle מונע הזיות של בינה מלאכותית?
- כל תובנה ש-Skimle מפיק נבדקת מול מסמכי המקור: אם הבינה המלאכותית מייצרת טקסט שאינו מופיע מילה במילה בנתונים שלכם, המערכת מסמנת אותו ומעבדת מחדש. השקיפות הדו-כיוונית מאפשרת ללחוץ על כל נושא ולראות את הציטוטים המדויקים שתומכים בו, ולפתוח כל מסמך ולראות איזה טקסט קודד ואיזה לא, כך ששום דבר לא מומצא ולא מתפספס.
- כמה מהר אפשר לקבל תוצאות ראשונות?
- רוב הפרויקטים מעובדים תוך דקות. מערכי נתונים גדולים עם יותר מ-1000 מסמכים עשויים לקחת יותר זמן. סט טיפוסי של 10 עד 20 תמלילי ראיונות מעובד בדרך כלל בפחות משעה. אפשר להעלות, להתחיל ניתוח ולקבל נושאים מובנים עם ציטוטים תומכים כבר באותו יום, בלי הגדרות ובלי הכשרה.
- האם צריך כישורים טכניים כדי להשתמש ב-Skimle?
- לא. Skimle מיועד לחוקרים איכותניים, לאנליסטים וליועצים, לא למהנדסים. מעלים את המסמכים, מתארים את שאלת המחקר, ו-Skimle מטפל בשאר. עריכת קטגוריות, עיון בנושאים וייצוא דוחות מתבצעים כולם בממשק של הצבעה ולחיצה. לא נדרשים תכנות, סקריפטים או מומחיות בבינה מלאכותית.
- איך עובד התמחור? יש באמת ניסיון חינם?
- כן. Skimle מציע ניסיון חינם עם 200 קרדיטים (מספיק לכ-200 עד 300 עמודי מסמכים) בלי צורך בכרטיס אשראי. תוכניות בתשלום מתחילות ב-20 € לחודש ליחידים בחיוב שנתי (25 € בחיוב חודשי), ויש תוכניות גדולות יותר למשתמשים כבדים. תוכניות לארגונים עם נפחים מותאמים, SSO והתקנות לדייר יחיד זמינות לפי בקשה.
- מהו המספר המרבי של מסמכים שאפשר לנתח?
- Skimle תומך באלפי מסמכים בכל פרויקט. זה הרבה מעבר למה שכל גישה ידנית יכולה להתמודד איתו, ומכסה את רוב תרחישי השימוש המקצועיים, מ-10 ראיונות עומק ועד יותר מ-1,000 תשובות פתוחות לסקר. אם יש לכם מערך נתונים גדול במיוחד או צורך בניתוח מתמשך, צרו קשר כדי לדון באפשרויות.
נבנה לאנשי מקצוע, בידי אנשי מקצוע
ל-Skimle יש יותר מ-1,500 משתמשים מרוצים ביותר מ-50 אוניברסיטאות, גופים ממשלתיים, סוכנויות וחברות. כל הנתונים מאוחסנים בתוך ה-EU ומעובדים בהתאם למדיניות ה-GDPR המחמירה שלנו ובהתאם לתנאי השימוש.
רוצים לדעת עוד? עיינו בבלוג שלנו Signal & Noise, בעמוד השאלות הנפוצות ובתרחישי השימוש לפי מגזר. נשמח גם להדגים את המוצר או לבדוק איך Skimle יכול להתאים לצרכים שלכם. קראו עוד על החברה שמאחורי Skimle