כל משיב נשמע. כל תובנה עקיבה. כל דדליין עומד.
נבנה לסוכנויות מחקר שוק שמספקות ללקוחות, ולצוותי תובנות לקוחות פנימיים שמספקים לעסק. שניהם מתמודדים עם אותו לחץ: נתונים איכותניים הם האות העשיר ביותר שיש לכם, ויש מהם הרבה יותר מדי כדי לקרוא בעיון ביד. מסוכנויות מבקשים תובנות עמוקות יותר בלוחות זמנים קצרים יותר ובשכר נמוך יותר. מצוותים פנימיים מבקשים לעמוד בקצב של החלטות מוצר ומסחר שלא יחכו שבועיים.
Skimle עושה את הקידוד המכני שאוכל את רוב השבוע של אנליסט. אתם עושים את הפרשנות, את ה-“אז מה” ואת ההמלצה. שבועיים של קידוד הופכים ליומיים, והניואנסים שורדים את הדחיסה.
ניתוח ברמה מקצועית שגדל עם היקף המחקר שלכם
60 ראיונות עומק, 8 קבוצות מיקוד בארבעה שווקים או 5,000 הערות מילוליות של NPS: ההיקף גדול מכדי לקרוא בעיון ביד, וכלים שטחיים מאבדים את הניואנסים שהלקוח או מנהל המסחר ישאלו עליהם. Skimle גדל בלי לוותר על עומק.
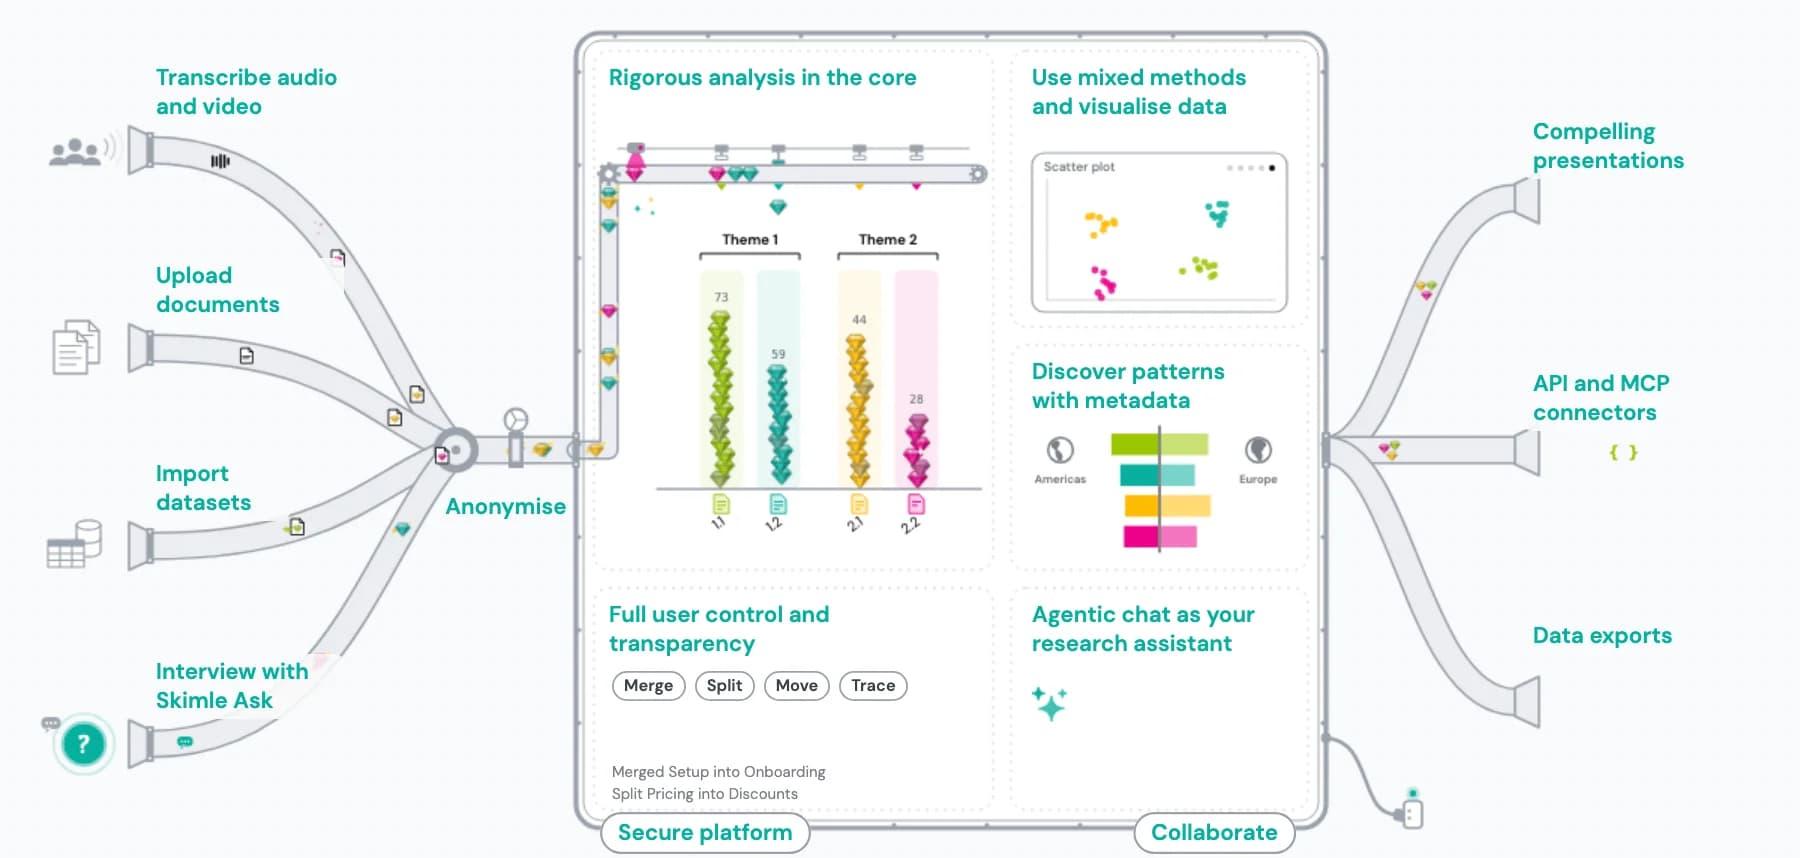
- מטפל בראיונות, קבוצות מיקוד, סקרים פתוחים, ביקורות ופניות תמיכה בפרויקט אחד
- כל נושא מקושר לציטוטים מילוליים של לקוחות, מכל המאגר ולא ממדגם
- ניתוח פלחים מובנה: השוואה לפי דמוגרפיה, רמות מוצר, גאוגרפיה וטווחי NPS
- יותר מ-100 שפות בפרויקט אחד, בלי שלב תרגום
- ייצואים מוכנים להצגה ל-Word, ל-PowerPoint ול-Excel תוך דקות
ניתוח קבוצות מיקוד וראיונות לקוחות בהיקף גדול
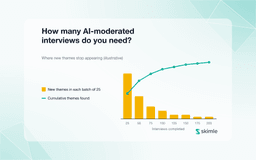
קבוצות מיקוד הן הנתונים האיכותניים הקשים ביותר לניתוח טוב. משתתף קולני אחד נראה זהה לארבעה קולות עצמאיים אם לא עוקבים אחרי הראיות. ראיונות עומק נכשלים אחרת: ב-20, 40 או 60 תמלילים, לקודד את האחרון כמו שקודד הראשון הופך לצוואר הבקבוק. Skimle בונה מבנה נושאים אחד לכל המפגשים ומראה מה היה עקבי, מה השתנה לפי פלח ומה היה חריג בודד, כך שהממצא מחזיק מעמד כשלקוח או בעל עניין מערערים עליו.
איך זה עובד
- 1. ייבוא כל מפגש כמסמך
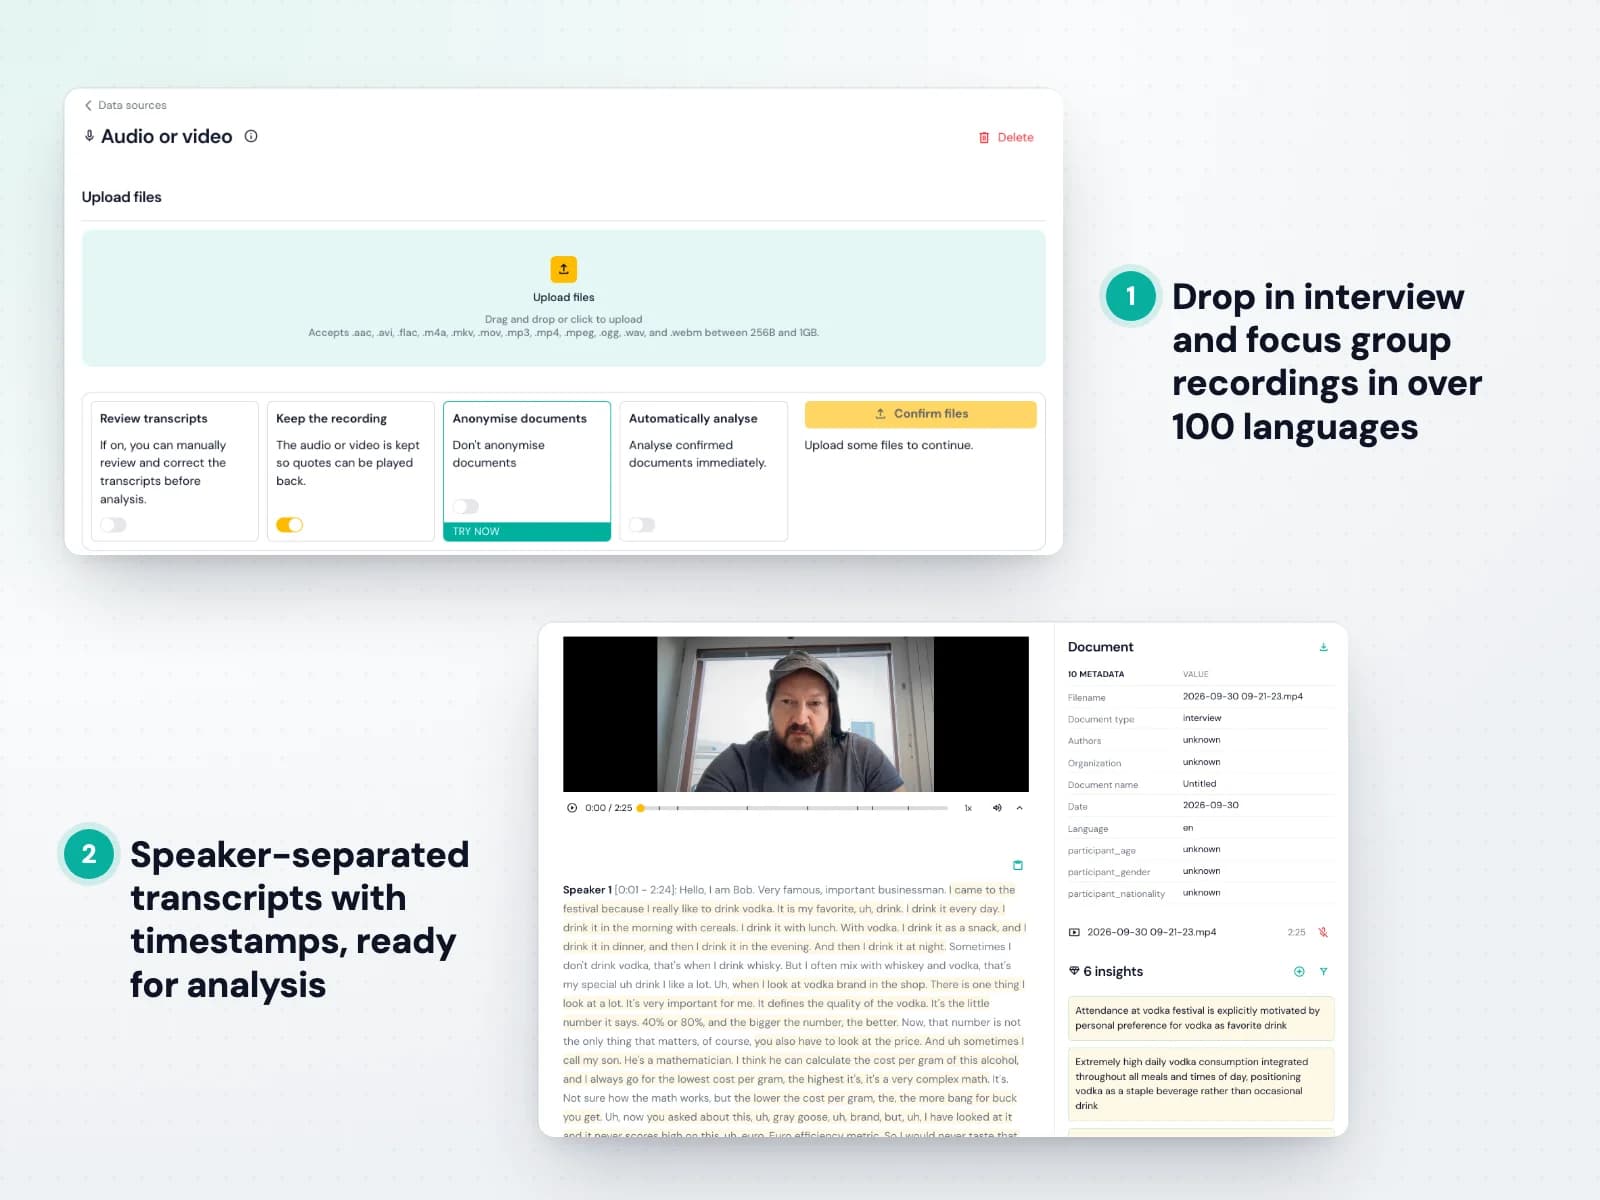
העלו תמלילים או הקלטות מ-Zoom, Teams, Otter או Fireflies. Skimle מתמלל שמע ווידאו ישירות, כך שכל מפגש הופך למסמך אחד שמוכן לניתוח.
- 2. הרצת ניתוח על כל המפגשים
Skimle קורא כל תמליל ובונה נושאים מהתוכן של כל המפגשים. הוא מגלה על מה באמת דיברו במקום לכפות מערכת קטגוריות מוכנה מראש.
- 3. לראות מה היה עקבי ומה השתנה
כל נושא מראה אילו קבוצות תרמו לו ובאיזו תדירות, ומפריד את האות האוניברסלי ממפגש בודד או משוק בודד.
- 4. הערכת התפלגות הראיות
לחצו על כל נושא כדי לקרוא את הציטוטים התומכים ולראות מאילו מפגשים הם הגיעו. שפטו את השפעת הקול הדומיננטי ישירות, לא מהזיכרון.
- 5. ייצוא ללקוח
הפיקו את מסמך הסינתזה עם ציטוטים מייצגים לפי קבוצה, מוכן למצגת או לדוח המלא.
קידוד סקרים פתוחים והשוואה בין פלחים
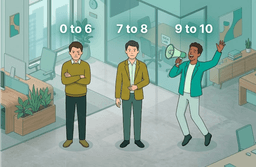
רשימת נושאים כוללת אחת לעולם לא עונה על השאלה שהעסק באמת שאל: מי מרגיש כך, ואיך זה שונה לפי פלח? מול אלפי תשובות מילוליות, רוב הצוותים מרפרפים על מדגם ומאבדים את דעות המיעוט שנושאות את האות החד ביותר. Skimle מקודד כל תשובה ומאפשר לחתוך את אותו מבנה נושאים לפי כל משתנה מטא-נתונים, בין אם טווח NPS, רמת מוצר, שוק או דמוגרפיה, והופך את השאלות הפתוחות של סקר מעקב לתמונה בשיטות מעורבות שאפשר לפעול לפיה.
איך זה עובד
- 1. העלאת תשובות עם מטא-נתונים
ייבאו תשובות פתוחות כקובץ CSV מ-SurveyMonkey, Typeform או Qualtrics, יחד עם עמודות המטא-נתונים של המשיבים, כך שכל תשובה נושאת את הפלח שלה.
- 2. בניית מבנה הנושאים המלא
Skimle מקודד כל תשובה להיררכיית נושאים, לא רק את הנפוצים, כך שנקודות מבט של מיעוט נשארות גלויות.
- 3. פילוח לפי כל משתנה
סננו והשוו נושאים לפי טווח NPS, רמת מוצר, גאוגרפיה או דמוגרפיה כדי לראות אילו נושאים חשובים ביותר לאילו לקוחות.
- 4. אימות הראיות
כל דפוס מוביל לציטוטים מילוליים, כך שפער בין שני פלחים נתמך בדיוק בתשובות שיצרו אותו.
- 5. ייצוא תוצרים מוכנים ללקוח
הפיקו דוח לפי נושאים עם ציטוטים מילוליים והצלבות, תוך דקות ולא ימים.

כל ערוצי המשוב בתמונת תובנות אחת
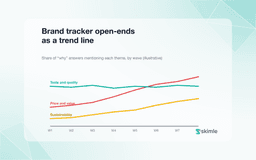
ראיונות, הערות NPS מילוליות, פניות תמיכה, ביקורות, הקלטות שיחות מכירה, תחקירי זכייה והפסד, שרשורי קהילה, דוחות אנליסטים ומתחרים. כל ערוץ מקבל בדרך כלל ניתוח משלו, מצגת משלו ואוצר מילים משלו, כך ששום דבר לא מצטבר ואותה בעיית לקוח מדווחת שלוש פעמים בשלושה שמות. Skimle מקודד כל מקור מול מבנה קטגוריות אחד בפרויקט אחד, ואז מראה איך כל ערוץ משקלל את אותו נושא. סוכנויות משתמשות בו כדי לשלב מחקר משרדי וחומר משני במחקר ראשוני. צוותים פנימיים משתמשים בו כדי להחזיק תמונה רציפה של הלקוח.
איך זה עובד
- 1. איחוד הערוצים בפרויקט אחד
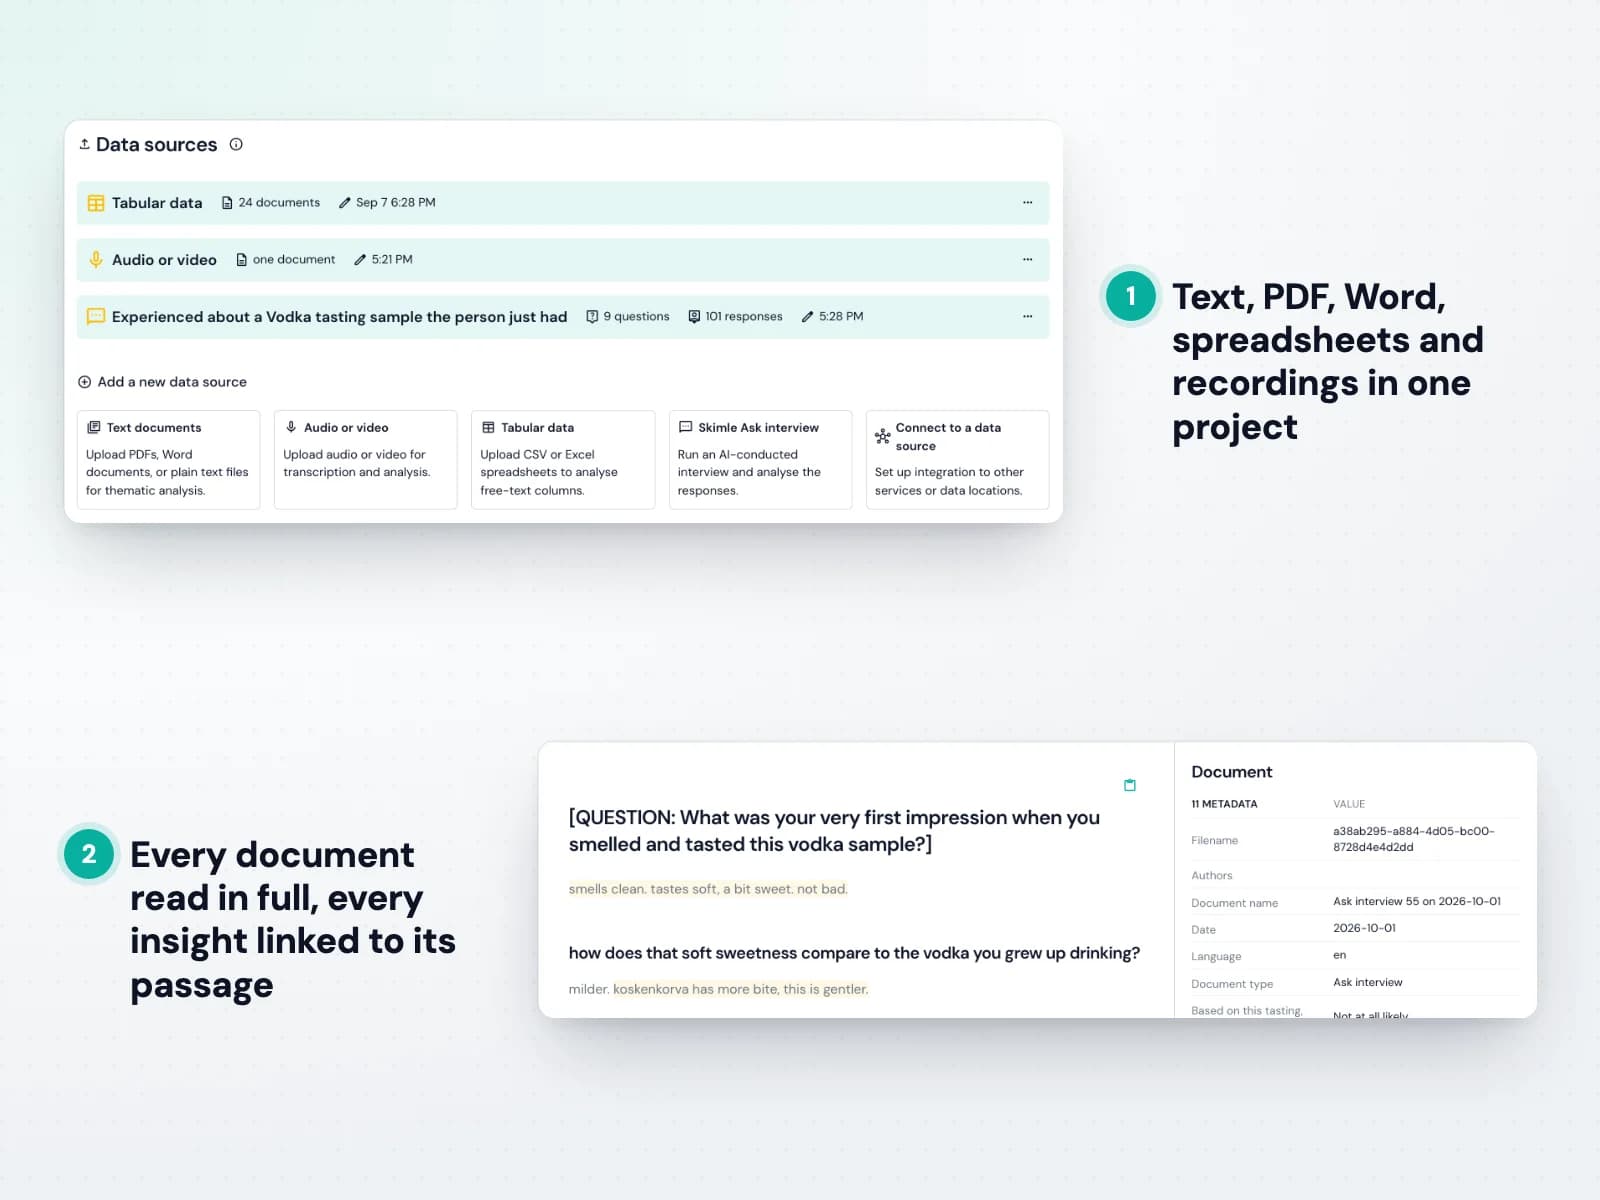
העלו תמלילים, ייצואי CSV, קובצי PDF והקלטות זה לצד זה. ייצואי פניות, ערימות ביקורות, דוחות אנליסטים ושמע של ראיונות הופכים כולם למסמכים באותו פרויקט.
- 2. תיוג כל מסמך לפי הערוץ שלו
ערוץ, פלח, שוק ותאריך נכנסים כמטא-נתונים, כך שכל השוואה מאוחרת בין מקורות היא מסנן ולא ניתוח חדש.
- 3. קידוד הכול מול מבנה אחד
Skimle בונה מבנה נושאים אחד לכל המקורות, או מחיל את המסגרת שלפיה אתם כבר מדווחים, כך שלממצא יש אותה משמעות בכל ערוץ.
- 4. השוואה של מה שכל ערוץ מספר לכם
לראות היכן המקורות מסכימים והיכן הם סותרים. נושא שבולט בפניות ונעדר מהראיונות הוא ממצא, לא פער שצריך ליישב.
- 5. הוספת הגל הבא בלי להתחיל מחדש
הנתונים של הרבעון הבא מקודדים לאותו מבנה, כך שסקר המעקב שומר על השוואתיות והדוח המעודכן הוא ייצוא מחדש ולא בנייה מחדש.
שאלות נפוצות
אלה השאלות שצוותי תובנות ומובילי מחקר בסוכנויות שואלים אותנו הכי הרבה, כולל אלה שמגיעות ישר מתהליך רכש. רשימת התיוג הניטרלית ל-RFP שלנו מציגה את אותן שאלות שכדאי לשאול כל ספק שאתם מדרגים, כולל אותנו.
- איך זה עוזר לנו להתחרות בחלופות זולות ושטחיות?
- ספקים זולים ועטיפות בינה מלאכותית דקות מתחרים במחיר עם ענני מילים ורשימת נושאים שטוחה. Skimle נותן עומק במהירות שלהם, כך שסוכנות מתבדלת באיכות ה-"אז מה" ולא במחירון, וצוות פנימי מוציא יותר מחקרים מתקציב קבוע. שעות האנליסטים עוברות מקידוד מכני לפרשנות, שזה החלק שכל אחד באמת משלם עליו. לראות לאן הכסף במחקר איכותני באמת הולך ←
- מה אומרים כשלקוח או בעל עניין מערערים על ניתוח בסיוע בינה מלאכותית?
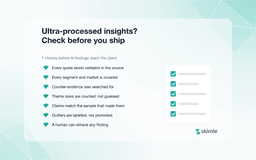
- תארו את זה במדויק: הבינה המלאכותית עושה את הסיווג המכני לקטגוריות, חוקר עם שם בודק כל נושא וכותב את הפרשנות. ואז הראו את הראיות. כל טענה בדוח של Skimle נפתחת לציטוט המילולי ולמסמך שממנו הגיע, וזו תשובה חזקה יותר ממה שסינתזה ידנית יכולה לתת, כי שם היגיון הקידוד היה קיים רק בראש של מישהו. 7 כללים לשימוש אחראי בבינה מלאכותית במחקר שוק איכותני ←
- האם Skimle מנתח את כל מאגר הנתונים או מדגם ממנו?
- את כל המאגר. כדאי לשאול את זה כל ספק, כי כמה כלים שולפים תת-קבוצה מהמסמכים שלכם בחיפוש embedding, מנתחים אותה ולעולם לא מדווחים אילו מסמכים לא נכנסו. התוצר נקרא כאילו הוא מכסה את כל הקורפוס, והוא לא. Skimle מקודד כל מסמך, ואפשר לפתוח כל אחד מהם ולראות בדיוק אילו קטעים קודדו ואילו לא.
- האם אפשר להחיל מערכת קטגוריות משלנו, או רק לקבל את מה שהבינה המלאכותית מייצרת?
- גם וגם, ושניהם על אותו קורפוס. הביאו מערכת קטגוריות קיימת ו-Skimle יקודד מולה דדוקטיבית, או תנו לו לבנות את המבנה אינדוקטיבית מהנתונים. אפשר אחר כך למזג, לפצל, לשנות שם, לסדר מחדש ולמחוק קטגוריות, והניתוח עוקב אחרי העריכות שלכם. סוכנויות שמריצות סקר מעקב או מסגרת סטנדרטית של לקוח שנה אחרי שנה עובדות בדרך כלל דדוקטיבית; מחקרים גישושיים מתחילים בדרך כלל להפך.
- מה מונע מציטוט מפוברק להגיע לדוח שלנו?
- כל ציטוט נבדק מכנית מול מסמך המקור. אם המודל מייצר טקסט שלא קיים מילה במילה בנתונים שלכם, Skimle מסמן אותו ומעבד מחדש במקום להציג אותו, כך שציטוט מומצא לא מגיע למצגת ללקוח. אפשר גם לפתוח כל מסמך ולראות אילו קטעים קודדו ואילו לא, וכך תופסים את הכשל ההפוך, שמשהו הוחמץ. איך עובדת שקיפות דו-כיוונית ←
- איך כדאי להעריך את Skimle מול הכלים האחרים ברשימה שלנו?
- הריצו פיילוט במקום לצפות בהדגמות. קחו קורפוס שכבר ניתחתם, כדי שתדעו מה התשובה צריכה להיות, כתבו שלוש משימות לפני שמתחילים (קידוד אחד, השוואת פלחים אחת, חיפוש ראיות אחד), מדדו זמן לכל אחת כולל עבודת התיקונים, והתווכחו בכוונה עם הכלי כדי לראות כמה מהר אפשר לארגן מחדש את התוצר שלו. נשמח להריץ פרויקט חי אחד במקביל לכלי הקיים שלכם, והמסלול החינמי מאפשר לחוקר אחד לגבש דעה תוך אחר צהריים לפני כל זה. רשימת תיוג RFP בשבעה תחומים ותבנית ניקוד ←
- כמה נתונים Skimle יכול לעבד, ובכמה שפות?
- עד 1,000 מסמכים לפרויקט, וזה מכסה הכול ממחקר של 20 ראיונות ועד סקר מעקב גלובלי עם אלפי תשובות, ויותר מ-100 שפות שמנותחות בשפת המקור בלי שלב תרגום. פרויקט אחד יכול לשלב אנגלית, ספרדית, מנדרינית, גרמנית וערבית, לבנות מבנה נושאים אחד לכולן ולשמור כל ציטוט בשפת המקור. אם אתם עובדים באופן קבוע בקצה העליון של הטווח הזה, דברו איתנו על הסדרי נפח.
- האם נתוני הלקוחות מאובטחים וחסויים?
- כל הנתונים מאוחסנים ומעובדים בתוך ה-EU על AWS, בסביבה שהוגדרה בידי צד שלישי מוסמך, ונתוני לקוחות לעולם אינם משמשים לאימון מודלים. הסכמי עיבוד נתונים זמינים, אנחנו עובדים תחת הסכמי סודיות של לקוחות, פסאודונימיזציה מובנית בתהליך העבודה, והתקנה לדייר יחיד או בענן פרטי זמינה היכן שריבונות נתונים מחייבת זאת.
- מה קורה לניתוח שלנו אם נפסיק להשתמש ב-Skimle?
- אתם לוקחים אותו איתכם, בכל תוכנית. ייצאו נתונים מקודדים בתקן הפתוח REFI-QDA (qdpx) והמשיכו ב-NVivo, ב-ATLAS.ti או ב-MAXQDA, או קחו תוצרי Word, PowerPoint ו-Excel עם ציטוטים מאורגנים לפי נושא. אנחנו מיישמים את תקן יכולת הפעולה ההדדית בדיוק כדי שההישארות תהיה בחירה ולא תוצאה.
- איך התמחור עובד כשהיקף המחקרים שלנו משתנה?
- Skimle הוא מינוי קל לפי מושב עם הקצאת קרדיטים כלולה, ועוד חבילות קרדיטים שקונים בחודשים שבהם רץ מחקר גדול. המינוי שומר את כל הצוות בכלי בין פרויקטים; החבילות מצמידות את העלות לפרויקט שגרם לה, וזה חשוב לסוכנויות שמחייבות לקוחות. בעלי עניין שרק צריכים לקרוא ממצאים לא צריכים מושב, כי ייצואים ודוחות מחקר להדפסה מכסים את זה.
- האם כמה חוקרים יכולים לעבוד על אותו פרויקט?
- כן, בו-זמנית, כשהעריכות וההערות של כל אחד נשמרות. זה מתאים לביקורת עמיתים ולבקרת איכות, ומתאים לחלוקת מחקר גדול בין חוקרים זוטרים ובכירים, כשמוביל בכיר אחד מכוון את מבנה הקטגוריות.
נבנה לאנשי מקצוע, בידי אנשי מקצוע
ל-Skimle יש יותר מ-1,500 משתמשים מרוצים ביותר מ-50 אוניברסיטאות, גופים ממשלתיים, סוכנויות וחברות. כל הנתונים מאוחסנים בתוך ה-EU ומעובדים בהתאם למדיניות ה-GDPR המחמירה שלנו ובהתאם לתנאי השימוש.
רוצים לדעת עוד? עיינו בבלוג שלנו Signal & Noise, בעמוד השאלות הנפוצות ובתרחישי השימוש לפי מגזר. נשמח גם להדגים את המוצר או לבדוק איך Skimle יכול להתאים לצרכים שלכם. קראו עוד על החברה שמאחורי Skimle