Кожного респондента почуто. Кожне спостереження можна простежити. Кожен дедлайн дотримано.
Створено для агенцій маркетингових досліджень, що працюють на клієнтів, і для внутрішніх команд клієнтських спостережень, що працюють на бізнес. І ті, й інші під однаковим тиском: якісні дані дають найбагатший сигнал, але їх надто багато, щоб уважно прочитати все вручну. Від агенцій чекають глибших висновків у коротші терміни за менші гроші. Внутрішні команди мають встигати за продуктовими й комерційними рішеннями, які не чекатимуть два тижні.
Skimle виконує механічне кодування, що забирає більшу частину тижня аналітика. Ви займаєтеся інтерпретацією, висновком «і що з того» та рекомендацією. Два тижні кодування перетворюються на два дні, і нюанси не губляться при стисненні.
Професійний аналіз, що масштабується разом з обсягом Ваших досліджень
60 глибинних інтерв’ю, 8 фокус-груп на чотирьох ринках або 5000 дослівних відповідей NPS: такий обсяг неможливо уважно прочитати вручну, а поверхові інструменти втрачають нюанси, про які спитає клієнт чи комерційний директор. Skimle масштабується без втрати глибини.
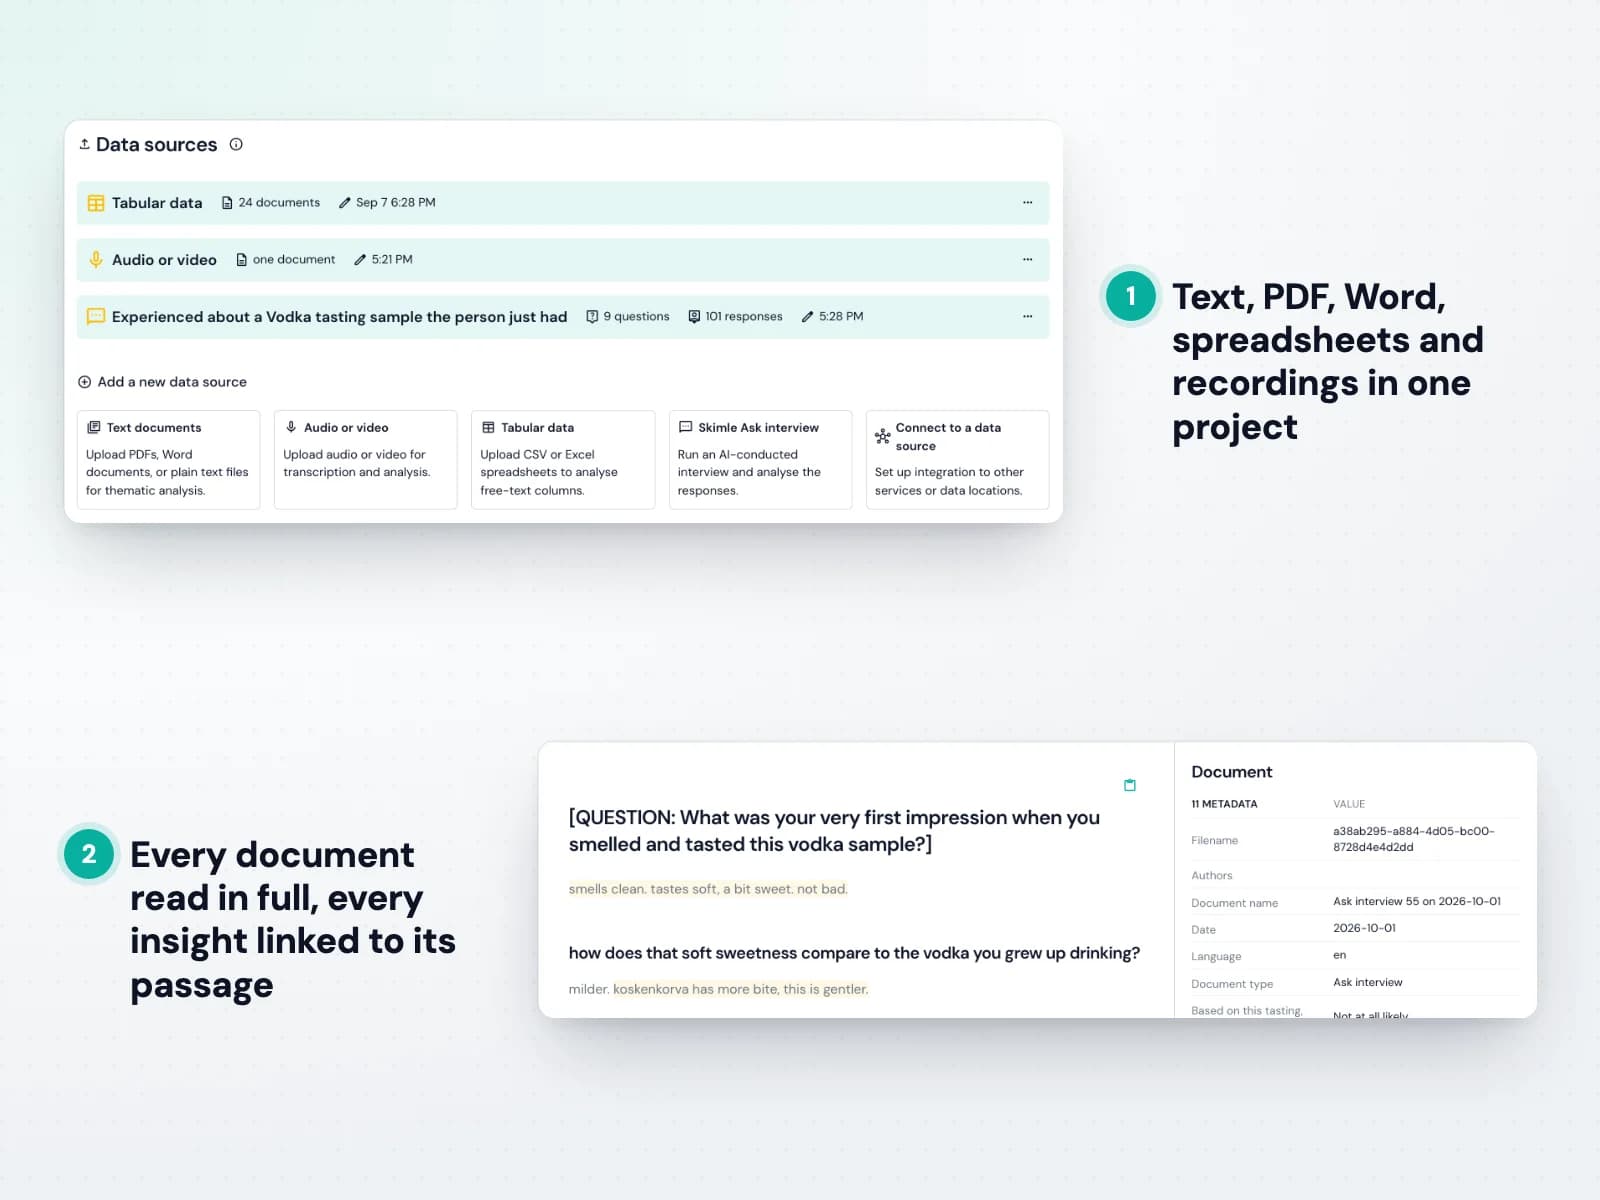
- Опрацьовує інтерв’ю, фокус-групи, опитування з відкритими питаннями, відгуки й звернення до підтримки в одному проєкті
- Кожна тема пов’язана з дослівними цитатами клієнтів з усього набору даних, а не з вибірки
- Вбудований аналіз сегментів: порівнюйте за демографією, рівнями продукту, географією, групами NPS
- Понад 100 мов в одному проєкті, без кроку перекладу
- Готові до презентації експорти у Word, PowerPoint та Excel за хвилини
Аналізуйте фокус-групи й інтерв’ю з клієнтами в масштабі
Фокус-групи є найскладнішими якісними даними для якісного аналізу. Один гучний учасник виглядає так само, як чотири незалежні голоси, якщо не відстежувати докази. Глибинні інтерв’ю підводять інакше: коли транскриптів 20, 40 чи 60, закодувати останній так само, як перший, стає вузьким місцем. Skimle будує одну структуру тем для всіх сесій і показує, що було стабільним, що різнилося за сегментами, а що було поодиноким винятком, тож висновок витримає заперечення клієнта чи стейкхолдера.
Як це працює
- 1. Імпортуйте кожну сесію як документ
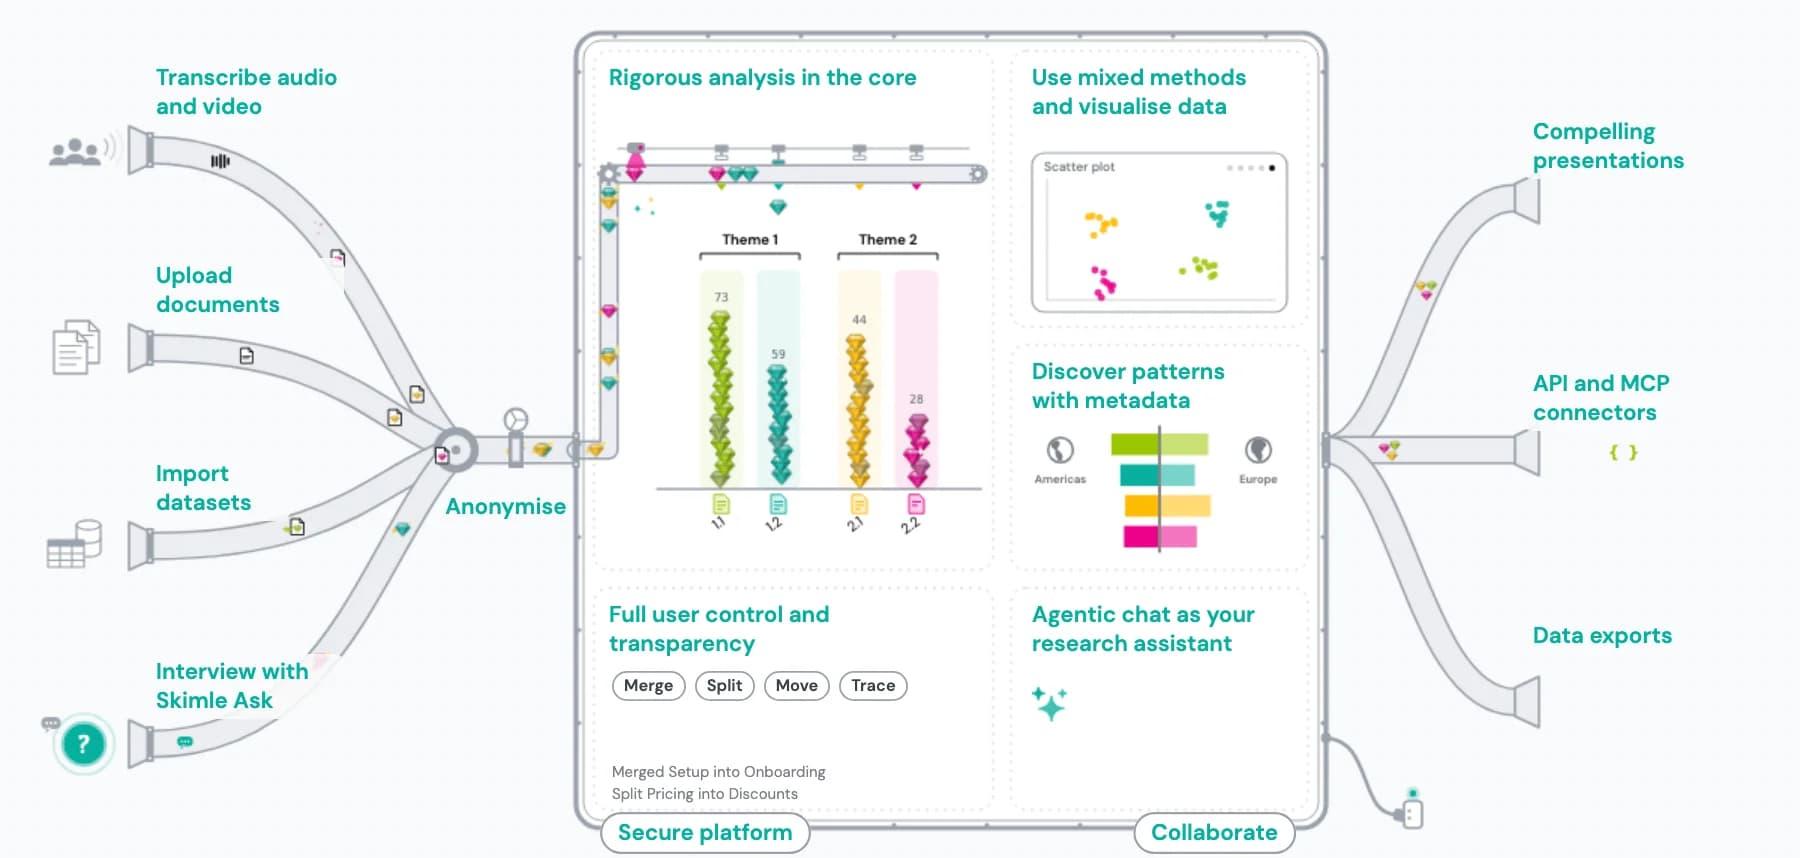
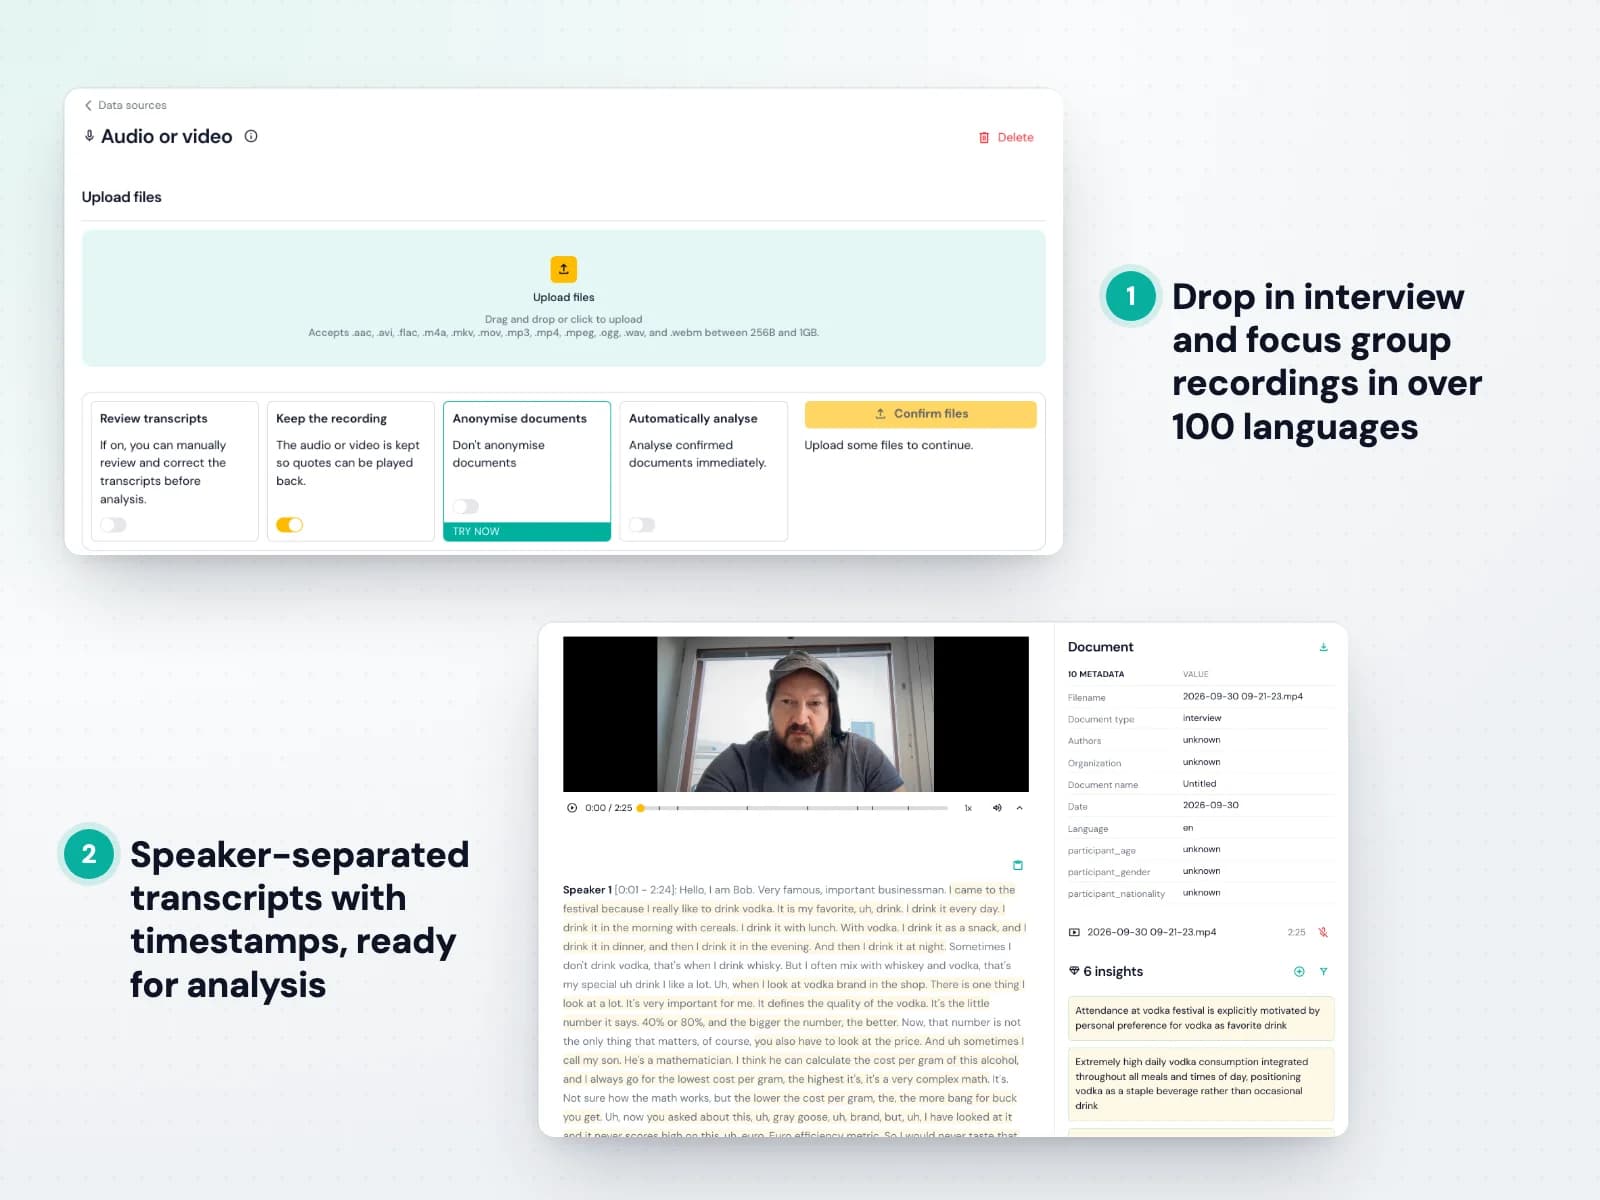
Завантажуйте транскрипти чи записи із Zoom, Teams, Otter або Fireflies. Skimle транскрибує аудіо й відео безпосередньо, тож кожна сесія стає одним документом, готовим до аналізу.
- 2. Запустіть аналіз усіх сесій
Skimle читає кожен транскрипт і будує теми зі змісту всіх сесій. Він виявляє, що насправді обговорювали, а не нав’язує наперед задану систему категорій.
- 3. Подивіться, що було стабільним, а що різнилося
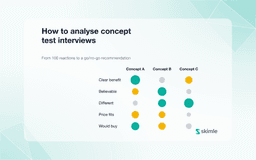
Кожна тема показує, які групи до неї долучилися і як часто, відокремлюючи універсальний сигнал від однієї сесії чи одного ринку.
- 4. Оцініть розподіл доказів
Клацніть будь-яку тему, щоб прочитати цитати-докази й побачити, з яких сесій вони походять. Оцінюйте вплив домінантних голосів безпосередньо, а не з пам’яті.
- 5. Експортуйте для клієнта
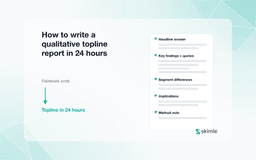
Створіть синтезований документ з репрезентативними цитатами за групами, готовий для презентації чи повного звіту.
Кодуйте опитування з відкритими питаннями й порівнюйте сегменти
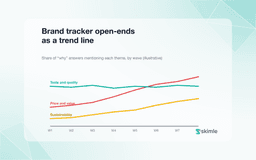
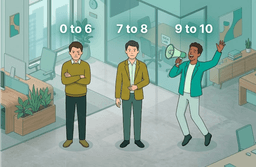
Один загальний список тем ніколи не відповідає на питання, яке насправді ставить бізнес: хто так вважає і як це різниться за сегментами? Маючи тисячі дослівних відповідей, більшість команд переглядає вибірку й губить думки меншості, що несуть найгостріший сигнал. Skimle кодує кожну відповідь і дає змогу розрізати ту саму структуру тем за будь-якою змінною метаданих, чи то група NPS, рівень продукту, ринок чи демографія, перетворюючи відкриті відповіді трекера на погляд змішаними методами, на основі якого можна діяти.
Як це працює
- 1. Завантажте відповіді з метаданими
Імпортуйте відкриті відповіді як CSV із SurveyMonkey, Typeform чи Qualtrics разом зі стовпцями метаданих респондентів, тож кожна відповідь несе свій сегмент.
- 2. Побудуйте повну структуру тем
Skimle кодує кожну відповідь в ієрархію тем, а не лише поширені, тож думки меншості залишаються видимими.
- 3. Сегментуйте за будь-якою змінною
Фільтруйте й порівнюйте теми за групою NPS, рівнем продукту, географією чи демографією, щоб побачити, які питання найважливіші для яких клієнтів.
- 4. Перевірте докази
Кожну закономірність можна простежити до дослівних цитат, тож розрив між двома сегментами підкріплено саме тими відповідями, що його створили.
- 5. Експортуйте результат, готовий для клієнта
Створіть тематичний звіт з дослівними цитатами й перехресними таблицями за хвилини, а не дні.

Зведіть усі канали відгуків в одну картину спостережень
Інтерв’ю, дослівні відповіді NPS, звернення до підтримки, відгуки, записи продажних дзвінків, розбори виграних і програних угод, обговорення в спільнотах, звіти аналітиків і конкурентів. Кожен канал зазвичай має власний аналіз, власну презентацію й власну лексику, тож нічого не складається докупи, а та сама проблема клієнта звучить тричі під трьома назвами. Skimle кодує кожне джерело за єдиною структурою категорій в одному проєкті, а потім показує, яку вагу кожен канал надає тій самій темі. Агенції використовують це, щоб вбудувати кабінетні дослідження та вторинні матеріали в первинне дослідження. Внутрішні команди використовують це для постійного погляду на клієнта.
Як це працює
- 1. Зберіть канали в одному проєкті
Завантажуйте поруч транскрипти, експорти CSV, PDF і записи. Експорти звернень, вивантаження відгуків, звіти аналітиків і аудіо інтерв’ю стають документами в одному проєкті.
- 2. Позначте кожен документ його каналом
Канал, сегмент, ринок і дата заносяться як метадані, тож кожне подальше порівняння джерел є фільтром, а не новим аналізом.
- 3. Закодуйте все за однією структурою
Skimle будує одну структуру тем для всіх джерел або застосовує рамку, за якою Ви вже звітуєте, тож висновок означає те саме в кожному каналі.
- 4. Порівняйте, що каже кожен канал
Дивіться, де джерела збігаються, а де суперечать одне одному. Тема, гучна у зверненнях і відсутня в інтерв’ю, є висновком, а не розбіжністю, яку треба згладити.
- 5. Додайте наступну хвилю, не починаючи з нуля
Дані наступного кварталу кодуються за тією самою структурою, тож трекер зберігає порівнянність, а оновлений звіт є повторним експортом, а не перебудовою.
Поширені запитання
Ось питання, які команди клієнтських спостережень і керівники досліджень в агенціях ставлять нам найчастіше, зокрема ті, що виникають просто під час закупівель. Наш нейтральний щодо постачальників чекліст RFP містить ті самі питання, які варто поставити кожному постачальнику, якого Ви оцінюєте, зокрема й нам.
- Як це допомагає нам конкурувати з дешевими поверховими альтернативами?
- Дешеві постачальники й тонкі ШІ-обгортки конкурують ціною з хмарами слів і пласким списком тем. Skimle дає глибину з їхньою швидкістю, тож агенція вирізняється якістю висновку «і що з того», а не тарифною сіткою, а внутрішня команда отримує більше досліджень за той самий бюджет. Години аналітиків переходять від механічного кодування до інтерпретації, а саме за неї насправді й платять. Подивіться, куди насправді йдуть гроші в якісному дослідженні →
- Що відповідати, коли клієнт чи стейкхолдер ставить під сумнів аналіз за допомогою ШІ?
- Опишіть його точно: ШІ механічно розподіляє дані за категоріями, а названий дослідник перевіряє кожну тему й пише інтерпретацію. Потім покажіть докази. Кожне твердження у звіті Skimle відкриває дослівну цитату й документ, з якого вона походить, і це сильніша відповідь, ніж може дати ручний синтез, адже там логіка кодування існувала лише в чиїйсь голові. 7 правил відповідального використання ШІ в якісних маркетингових дослідженнях →
- Skimle аналізує весь набір даних чи лише вибірку?
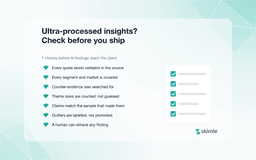
- Весь набір даних. Це варто запитувати в кожного постачальника, бо деякі інструменти через пошук за ембедингами вибирають лише частину документів, аналізують її й ніколи не повідомляють, які документи не потрапили до аналізу. Результат виглядає так, ніби охоплює весь корпус, хоча це не так. Skimle кодує кожен документ, і Ви можете відкрити будь-який із них, щоб побачити, які саме фрагменти закодовано, а які ні.
- Чи можемо ми застосувати власну систему категорій, чи лише приймати те, що створює ШІ?
- І те, і те, навіть на тому самому корпусі. Принесіть наявну систему категорій, і Skimle кодуватиме за нею дедуктивно, або дозвольте йому побудувати структуру індуктивно з даних. Згодом категорії можна об’єднувати, розділяти, перейменовувати, переставляти й видаляти, а аналіз слідує за Вашими змінами. Агенції, що рік у рік ведуть трекер чи стандартну рамку клієнта, зазвичай працюють дедуктивно; дослідницькі проєкти зазвичай починають з іншого боку.
- Що не дає вигаданій цитаті потрапити в наш звіт?
- Кожна цитата механічно звіряється з документом-джерелом. Якщо модель видає текст, якого дослівно немає у Ваших даних, Skimle позначає його й обробляє повторно замість того, щоб показати, тож вигадана цитата не потрапить у презентацію для клієнта. Ви також можете відкрити будь-який документ і побачити, які фрагменти закодовано, а які ні, і так виявити протилежну помилку, коли щось пропущено. Як працює двостороння прозорість →
- Як нам оцінити Skimle порівняно з іншими інструментами з нашого списку?
- Проведіть пілот замість перегляду демо. Візьміть корпус, який Ви вже проаналізували, щоб знати, якою має бути відповідь, сформулюйте три завдання до початку (кодування, порівняння сегментів, пошук доказів), засікайте час на кожне разом із виправленнями й навмисно не погоджуйтеся з інструментом, щоб побачити, як швидко можна перебудувати його результат. Ми охоче проведемо один живий проєкт паралельно з Вашим поточним інструментом, а безкоштовний рівень дає змогу одному досліднику скласти думку за пообіддя ще до всього цього. Чекліст RFP із 7 доменів і шаблон оцінювання →
- Скільки даних може опрацювати Skimle і якими мовами?
- До 1000 документів у проєкті, чого вистачає на все, від дослідження з 20 інтерв’ю до глобального трекера з тисячами відповідей на опитування, а понад 100 мов аналізуються безпосередньо, без кроку перекладу. Один проєкт може поєднувати англійську, іспанську, китайську, німецьку й арабську, будувати одну структуру тем для всього й зберігати кожну цитату мовою оригіналу. Якщо Ви регулярно працюєте на верхній межі цього діапазону, поговорімо про домовленості щодо обсягів.
- Чи захищені й конфіденційні дані клієнтів?
- Усі дані зберігаються й обробляються в ЄС на AWS, у середовищі, налаштованому сертифікованою третьою стороною, а дані клієнтів ніколи не використовуються для навчання моделей. Доступні угоди про обробку даних, ми працюємо за NDA клієнтів, псевдонімізацію вбудовано в робочий процес, а там, де цього вимагає суверенітет даних, доступне розгортання з виділеним середовищем чи в приватній хмарі.
- Що станеться з нашим аналізом, якщо ми перестанемо користуватися Skimle?
- Ви забираєте його із собою, на будь-якому плані. Експортуйте закодовані дані у відкритий стандарт REFI-QDA (.qdpx) і продовжуйте в NVivo, ATLAS.ti чи MAXQDA або забирайте результати у Word, PowerPoint та Excel із цитатами, впорядкованими за темами. Ми реалізуємо стандарт сумісності саме для того, щоб залишатися з нами було вибором, а не наслідком.
- Як працює ціноутворення, коли обсяг досліджень коливається?
- Skimle є легкою підпискою за місце з включеним запасом кредитів, плюс пакети кредитів, які Ви купуєте на місяці, коли триває велике дослідження. Підписка тримає всю команду в інструменті між проєктами, а пакети прив’язують витрати до проєкту, який їх спричинив, що важливо для агенцій, які перевиставляють витрати клієнтам. Стейкхолдерам, яким потрібно лише читати висновки, місце не потрібне: для цього є експорти й звіти, придатні до друку.
- Чи можуть кілька дослідників працювати над одним проєктом?
- Так, одночасно, і зміни та анотації кожного зберігаються. Це підходить для взаємної перевірки й контролю якості, а також для розподілу великого дослідження між молодшими й старшими дослідниками, де один старший керівник спрямовує структуру категорій.
Створено професіоналами для професіоналів
Skimle має понад 1 500 задоволених користувачів у понад 50 університетах, державних установах, агенціях і компаніях. Усі дані зберігаються в ЄС і обробляються відповідно до нашої суворої політики GDPR та умов надання послуг.
Хочете дізнатися більше? Перегляньте наш блог Signal & Noise, наші поширені запитання і сценарії використання за галузями. Ми також охоче покажемо продукт або обговоримо, як Skimle може відповісти Вашим потребам. Дізнайтеся більше про компанію, що створила Skimle