AI کی رفتار سے تعلیمی باریک بینی
Skimle ماہرین تعلیم نے ماہرین تعلیم کے لیے بنایا ہے۔ شریک بانی پروفیسر Henri Schildt کو کیفیتی تحقیق کا دہائیوں کا تجربہ ہے اور ان کے مضامین Academy of Management Journal اور Organization Science سمیت مینجمنٹ کے اعلیٰ جرائد میں شائع ہوئے ہیں۔ وہ NVivo اور MAXQDA کے سست، بوجھل ورک فلوز سے تنگ آ گئے تھے، اور تجزیے میں ChatGPT کے ایسے استعمال سے پریشان تھے جس میں شفافیت اور جامعیت کی کمی ہے۔ اس لیے انہوں نے Skimle کو ایسے پلیٹ فارم کے طور پر بنایا جو باریک بین، شفاف کیفیتی طریقۂ کار کو دہراتا ہے، لیکن جس کے مرکز میں AI ہے۔
انٹرویوز کی ابتدائی کوڈنگ میں ہاتھ سے ہفتے لگ سکتے ہیں۔ Skimle اسے طریقۂ کار کی باریک بینی پر سمجھوتہ کیے بغیر سنبھالتا ہے، اور اکثر ایسے اقتباسات پکڑ لیتا ہے جو انسان سے چھوٹ سکتے ہیں۔ ہر موضوع ایک تصدیق شدہ لفظ بہ لفظ اقتباس سے جڑا ہے۔ مکمل آڈٹ ٹریل پیئر ریویورز کو مطمئن کرتا ہے۔
تدریسی مواد →باریک بین تجزیہ جو آپ کو اپنے نظریاتی حصے پر توجہ دینے دیتا ہے
Skimle کا طریقہ گراؤنڈڈ تھیوری (Glaser & Strauss; Strauss & Corbin) اور Gioia کے طریقے سے متاثر ہے۔ یہ وہ منظم، شفاف تجزیہ دیتا ہے جس کا پیئر ریویو تقاضا کرتا ہے، ان ہفتوں کی میکانکی کوڈنگ کے بغیر جو وہ وقت کھا جاتی ہے جو نظریے پر بہتر طور پر لگ سکتا ہے۔ یہ 100 سے زائد زبانوں میں کام کرتا ہے اور فی پروجیکٹ 1,000 دستاویزات تک سنبھالتا ہے۔
- خودکار ابتدائی کوڈنگ، ہر اقتباس اپنے زمرے سے جڑا
- پیئر ریویو اور طریقۂ کار کی شفافیت کے لیے مکمل دو طرفہ آڈٹ ٹریل
- آپ کے اختیار میں اقسام کا نظام: اقسام کو آزادانہ ضم، تقسیم، نام تبدیل اور ازسرنو ترتیب دیں
- بغیر ترجمے کے 100 سے زائد زبانوں میں کام کرتا ہے
- انٹرویوز، آڈیو/ویڈیو، کتابیں، دستاویزات اور آرکائیوی مواد سنبھالتا ہے
- Skimle Academic، ایک رعایتی پلان، دستیاب
انٹرویوز ٹرانسکرائب اور گمنام کریں
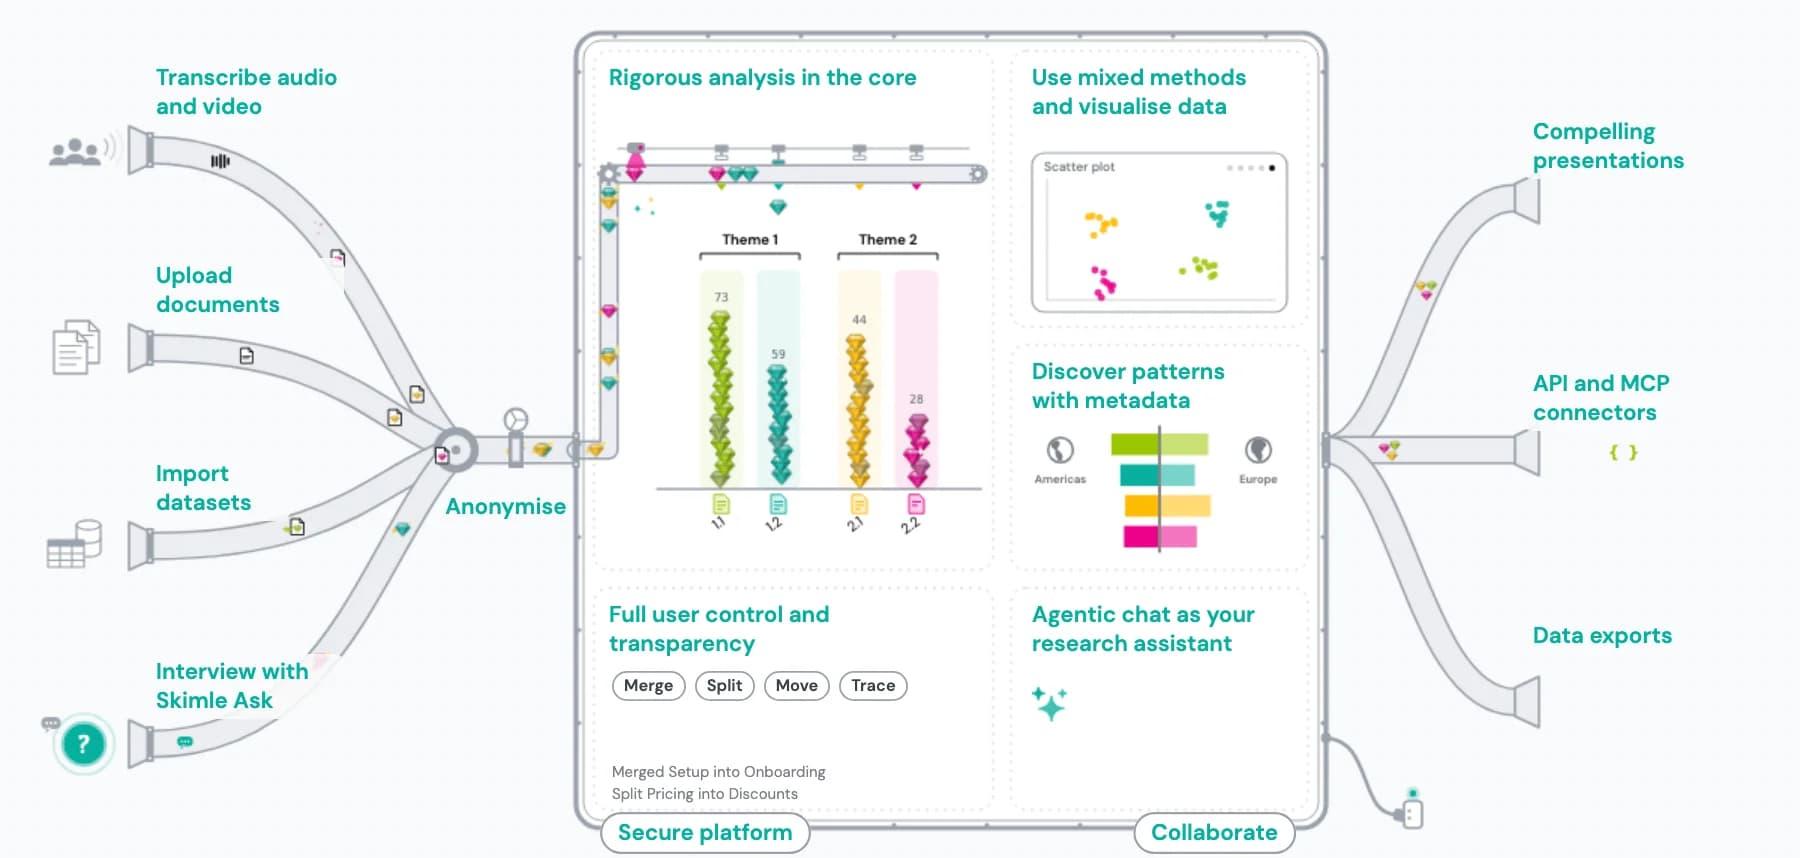
کسی تیسرے فریق کی سروس سے فیلڈ ریکارڈنگز کو قابل استعمال ڈیٹا میں بدلنا سست اور مہنگا ہے، اور حاصل ہونے والے ٹرانسکرپٹس میں نام، وابستگیاں اور مقامات ہوتے ہیں جو شیئر، محفوظ یا اقتباس کرنے سے پہلے GDPR اور اخلاقیات کی ذمہ داریاں پیدا کرتے ہیں۔ Skimle اپنے محفوظ، EU میں ہوسٹ کیے گئے ماحول میں آڈیو اور ویڈیو ٹرانسکرائب کرتا ہے، پھر تحقیقی معیار کی فرضی نام سازی سے گمنام بناتا ہے، تاکہ آپ کو اسی دن تعمیل شدہ، کوڈنگ کے لیے تیار ٹرانسکرپٹ ملے، اور ڈیٹا کبھی GDPR کے مطابق انفراسٹرکچر سے باہر نہ جائے۔
یہ کیسے کام کرتا ہے
- 1. آڈیو، ویڈیو یا متن اپ لوڈ کریں
MP3، M4A، WAV، MP4، MOV، PDF یا Word فائلیں براہ راست اپ لوڈ کریں۔ کسی بیرونی ٹرانسکرپشن سروس کی ضرورت نہیں، اور 100 سے زائد زبانیں بنیادی طور پر معاون۔
- 2. بولنے والوں کے لیبلز کے ساتھ ٹرانسکرائب کریں
Skimle ریکارڈنگ ٹرانسکرائب کرتا ہے، بولنے والوں کی تبدیلی پہچانتا ہے، اور مختلف لہجوں اور آڈیو معیار کو سنبھالتا ہے۔ تجزیہ شروع ہونے سے پہلے نتیجے کا جائزہ لیں اور درست کریں۔
- 3. شناختی معلومات خود بخود پہچانیں
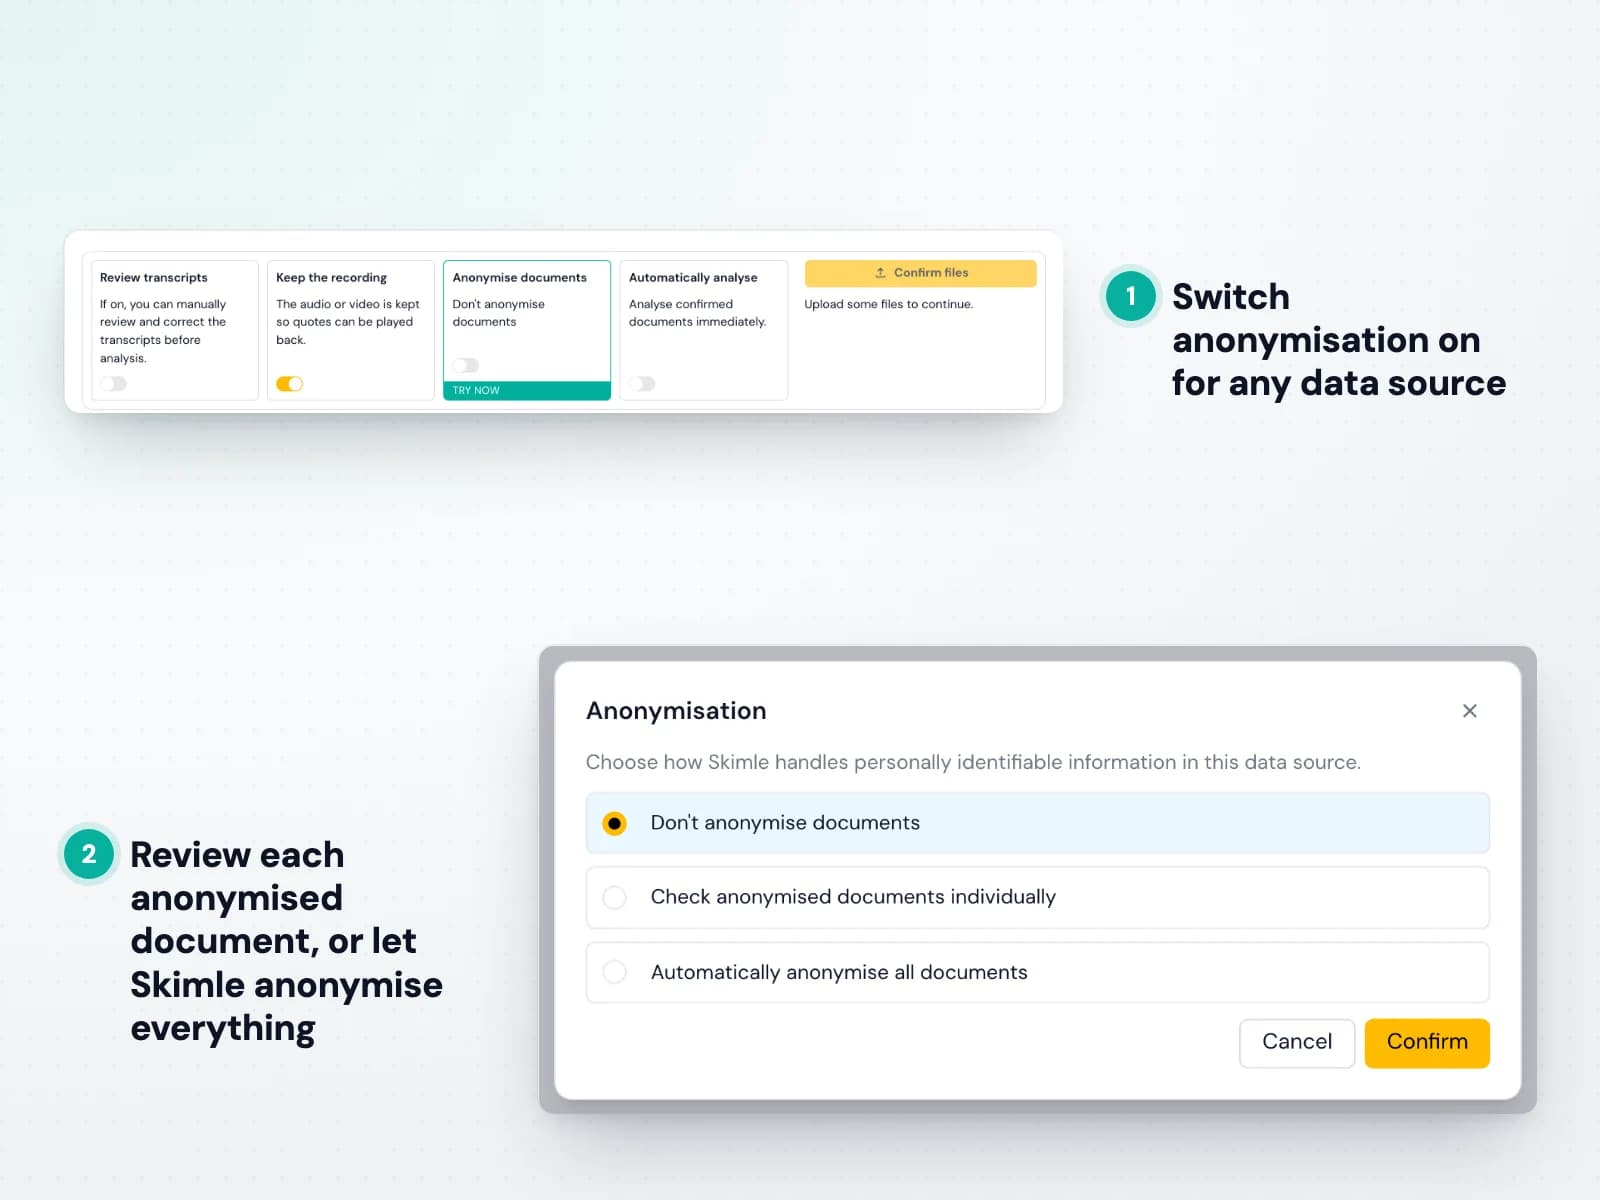
Skimle Anonymise ہر دستاویز میں شناخت کی چھ اقسام کو نشان زد کرتا ہے: نام، عہدے اور کردار، مقامات، ادارے، تاریخیں اور دیگر، فائلوں میں یکسانیت کے ساتھ تاکہ ایک ہی شخص کو ایک ہی فرضی نام ملے۔
- 4. اپنی گمنامی کی سطح منتخب کریں
ہلکی فرضی نام سازی، مضبوط فرضی نام سازی، یا کلید تلف کرنے والی HIPAA معیار کی گمنامی منتخب کریں۔ ہر قسم کو الگ سے ترتیب دیں اور سادہ زبان میں حسب ضرورت اصول شامل کریں۔
- 5. آڈٹ دستاویزات کے ساتھ ایکسپورٹ کریں
اپنے اخلاقیات بورڈ کے لیے PDF آڈٹ رپورٹ اور Excel تبدیلی کا جدول ایکسپورٹ کریں، پھر صاف ٹرانسکرپٹ کو سیدھا Skimle کے تجزیاتی ورک فلو میں بھیجیں۔ اس کے بعد ماخذ آڈیو محفوظ طریقے سے حذف کر دیا جاتا ہے۔

AI کی مدد سے انٹرویوز کا کیفیتی تجزیہ کریں
40 سے زائد انٹرویوز پر مبنی تحقیق سے ایک بھرپور نظریاتی حصہ نکلنا چاہیے (مثلاً آپ کی پی ایچ ڈی کے لیے)، لیکن دستی کوڈنگ، یعنی نمایاں کرنا، ترتیب دینا، دوبارہ کوڈ کرنا اور ٹریکرز بنانا، دستیاب وقت کا زیادہ تر حصہ کھا جاتی ہے اور پھر بھی اہم پیٹرنز چھوٹ سکتے ہیں۔ Skimle ہر انٹرویو کو منظم طریقے سے پڑھتا ہے اور لفظ بہ لفظ اقتباسات کے ساتھ موضوعات کی منظم درجہ بندی دیتا ہے، تاکہ آپ اس نظریاتی تشریح پر وقت لگا سکیں جو صرف آپ ہی دے سکتے ہیں۔
یہ کیسے کام کرتا ہے
- 1. اپنے ٹرانسکرپٹس اپ لوڈ کریں
انٹرویو ٹرانسکرپٹس PDF، Word فائلوں یا سادہ متن کے طور پر گھسیٹ کر ڈالیں۔ Skimle کسی بھی فارمیٹ میں دستاویزات قبول کرتا ہے اور 100 سے زائد زبانیں بنیادی طور پر سنبھالتا ہے۔
- 2. اپنا تحقیقی سوال بیان کریں
اپنا تجزیاتی مرکز وسیع یا مخصوص طور پر طے کریں۔ Skimle ابتدائی کوڈنگ کو اس چیز کے گرد ترتیب دیتا ہے جسے آپ نظریاتی طور پر سمجھنا چاہتے ہیں۔
- 3. ابتدائی کوڈ ڈھانچے کا جائزہ لیں
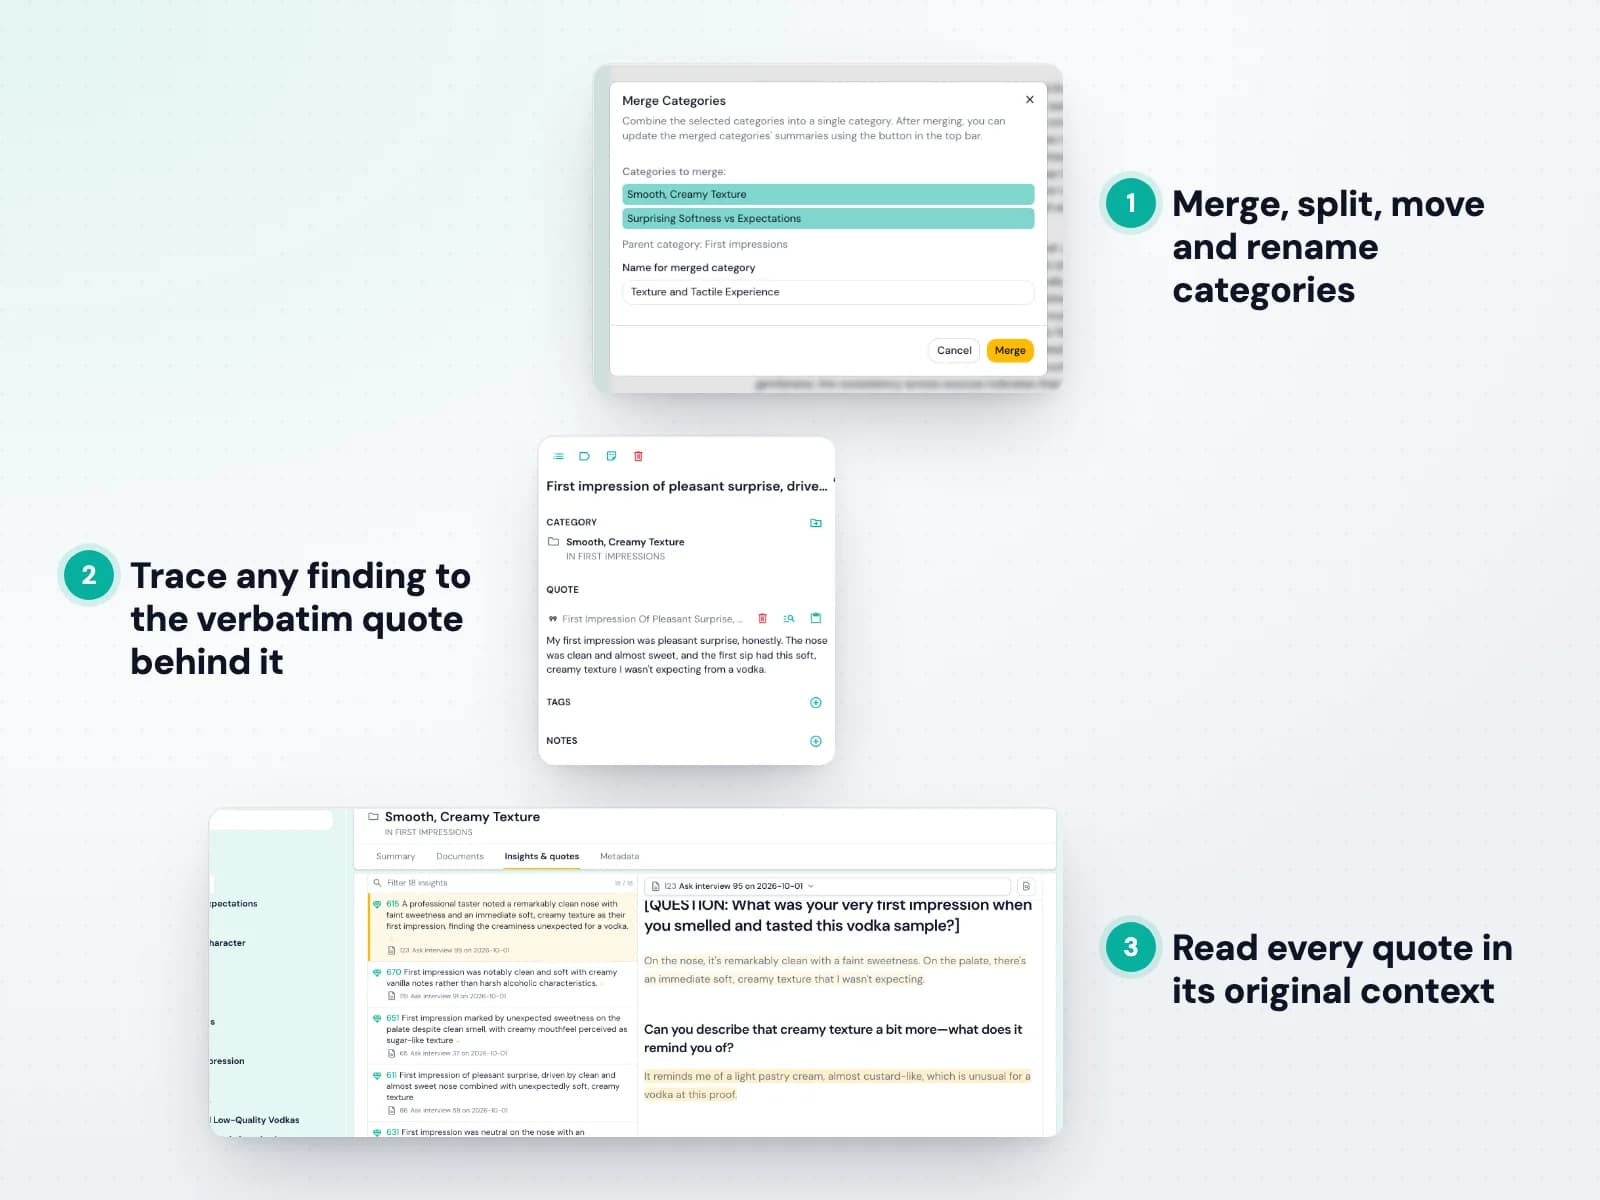
Skimle موضوعات کی درجہ بندی بناتا ہے، ہر ایک ماخذ ٹرانسکرپٹس کے لفظ بہ لفظ اقتباسات سے جڑا۔ کچھ بھی گھڑا نہیں جاتا۔ ہر کوڈ متن تک قابل سراغ ہے۔
- 4. اپنے نظریاتی فریم ورک کے مطابق بہتر بنائیں
اپنے ابھرتے نظریاتی ماڈل کے مطابق اقسام کو ضم، تقسیم، نام تبدیل اور ازسرنو ترتیب دیں۔ دو طرفہ شفافیت سے آپ کسی بھی وقت تصدیق کر سکتے ہیں کہ کون سے اقتباسات کن کوڈز کی تائید کرتے ہیں۔
- 5. اپنے طریقۂ کار کے ضمیمے کے لیے ایکسپورٹ کریں
اپنا اقسام کا نظام اور معاون اقتباسات متن کے طور پر، یا NVivo، ATLAS.ti یا MAXQDA جیسے پرانے CAQDAS پروگراموں کے معاون اوپن سورس REFI-QDA (qdpx) فارمیٹ میں ایکسپورٹ کریں۔
اپنے نمونے پر مخلوط طریقوں کا تجزیہ چلائیں
کیفیتی نتائج کا وزن تب بڑھتا ہے جب آپ دکھا سکیں کہ وہ نمونے میں کیسے مختلف ہیں: گروہ، کردار، جنس، مقام یا حالت کے لحاظ سے۔ شرکاء کی خصوصیات کے ساتھ موضوعات کی ہاتھ سے کراس ٹیبولیشن تھکا دینے والی اور غلطی کا شکار ہے۔ Skimle ہر دستاویز کے ساتھ میٹا ڈیٹا جوڑتا ہے اور آپ کو اسی موضوعاتی ڈھانچے کو کسی بھی متغیر کے لحاظ سے تقسیم کرنے دیتا ہے، تاکہ آپ کسی طریقۂ کار کو پیچھے چھوڑے بغیر بھرپور لفظ بہ لفظ اقتباسات اور مقداری پیٹرنز کے درمیان آ جا سکیں۔
یہ کیسے کام کرتا ہے
- 1. دستاویزات کے ساتھ میٹا ڈیٹا جوڑیں
ہر ٹرانسکرپٹ کو ان متغیرات سے ٹیگ کریں جو آپ کے ڈیزائن کے لیے اہم ہیں، جیسے گروہ، کردار، جنس، مقام، مرحلہ یا تجرباتی حالت، دستی طور پر یا CSV کالم سے۔
- 2. کیفیتی تجزیہ چلائیں
Skimle تمام دستاویزات میں موضوعات کی ایک ہی درجہ بندی بناتا ہے، تاکہ ہر شریک کی کوڈنگ ایک ہی ڈھانچے کے مطابق ہو۔
- 3. متغیرات کے لحاظ سے موضوعات تقسیم کریں
دیکھیں کہ ہر موضوع گروہوں میں کیسے بدلتا ہے، اور پہچانیں کہ کوئی پیٹرن کہاں عالمگیر ہے یا کسی ایک گروہ تک محدود۔
- 4. پھیلاؤ کی پیمائش کریں
موضوعات کا تعدد اور تقسیم پڑھیں تاکہ بتا سکیں کہ کوئی کوڈ ہر طبقے میں کتنا عام ہے، ہر گنتی ان اقتباسات تک قابل سراغ جن سے وہ بنی۔
- 5. ٹیبلز اور اقتباسات ایکسپورٹ کریں
اپنے مقالے کے مخلوط طریقوں کے حصے کے لیے کراس ٹیبولیشنز اور معاون اقتباسات Excel یا Word میں ایکسپورٹ کریں۔

اکثر پوچھے جانے والے سوالات
- کیا میں اپنی تحقیق میں Skimle کا حوالہ دے سکتا ہوں؟
- جی ہاں۔ اپنے طریقۂ کار کے حصے میں اسے ‘AI کی مدد سے کیفیتی کوڈنگ سافٹ ویئر’ کے طور پر بیان کریں، جیسے آپ NVivo یا MAXQDA کا حوالہ دیتے۔ ہمارا ایک طریقۂ کار کا مضمون پیئر ریویو میں ہے جو باضابطہ حوالہ فراہم کرے گا، اور تب تک درخواست پر ہم حوالے کی عبارت تجویز کر سکتے ہیں۔
- کیا پیئر ریویورز AI کی مدد سے کیا گیا تجزیہ قبول کریں گے؟
- مناسب دستاویز بندی کے ساتھ، بڑھتی ہوئی حد تک ہاں۔ Skimle کا آڈٹ ٹریل جائزہ کاروں کو وہی دیتا ہے جس کی وہ توقع رکھتے ہیں: ایک دستاویزی، منظم کوڈنگ کا عمل جس میں ہر موضوع مخصوص اقتباسات تک قابل سراغ ہے، اس لیے طریقۂ کار کا حصہ تقریباً خود لکھا جاتا ہے۔
- Skimle کا NVivo یا MAXQDA سے موازنہ کیسا ہے؟
- NVivo اور MAXQDA ان محققین کے لیے موزوں ہیں جن کے پاس تجزیے کے لیے ہفتے اور ادارہ جاتی لائسنس ہو۔ Skimle میکانکی کوڈنگ کا مرحلہ خودکار بناتا ہے، ہفتوں سے گھنٹوں تک، اسی منظم اور شفاف طریقۂ کار کو برقرار رکھتے ہوئے، اور اسے سیکھنے میں منٹ لگتے ہیں۔ بہت سے محققین دونوں استعمال کرتے ہیں: ابتدائی کوڈنگ کے لیے Skimle، مخلوط طریقوں کے انضمام کے لیے NVivo۔
- کیا Skimle گراؤنڈڈ تھیوری کے لیے کام کرتا ہے؟
- جی ہاں۔ Skimle استقرائی کوڈنگ کی معاونت کرتا ہے جس میں موضوعات پہلے سے مسلط ہونے کے بجائے ڈیٹا سے ابھرتے ہیں۔ ایک وسیع مرکز سے شروع کریں اور اقسام کے ڈھانچے کو بتدریج بننے دیں، جو گراؤنڈڈ تھیوری کی اوپن کوڈنگ سے بہت قریب ہے۔
- کیا میں مخلوط طریقوں کا تجزیہ چلا سکتا ہوں؟
- جی ہاں۔ ہر دستاویز کے ساتھ میٹا ڈیٹا متغیرات جوڑیں، جیسے گروہ، کردار، جنس، مقام، حالت، اور موضوعاتی ڈھانچے کو ان میں سے کسی کے لحاظ سے تقسیم کریں۔ آپ کو گروہ وار موضوعات کا تعدد اور تقسیم ملتی ہے، ہر ایک لفظ بہ لفظ اقتباسات تک قابل سراغ، آپ کے مقالے کے مخلوط طریقوں کے حصے کے لیے تیار۔
- کیا میرا تحقیقی ڈیٹا محفوظ ہے؟
- آپ کے ٹرانسکرپٹس EU میں ہوسٹ کیے گئے انفراسٹرکچر پر پروسیس ہوتے ہیں اور کبھی بھی AI ماڈلز کی تربیت میں استعمال نہیں ہوتے۔ ہم ادارہ جاتی اخلاقیات کے تقاضوں کے لیے ڈیٹا پروسیسنگ معاہدے فراہم کرتے ہیں اور زیادہ تر IT سیکیورٹی ضروریات پوری کر سکتے ہیں۔ مخصوص تقاضوں کے ساتھ ہم سے رابطہ کریں۔
- کیا مجھے تعلیمی رعایت مل سکتی ہے؟
- جی ہاں۔ درست ادارہ جاتی ای میل اور وابستگی کے صفحے والے ماہرین تعلیم رعایتی Skimle Academic پیکج خرید سکتے ہیں۔ اگر آپ کو کسی تحقیقی گروپ یا لیب کے لیے ٹیم رسائی درکار ہے تو ادارہ جاتی لائسنس کے لیے ہم سے رابطہ کریں۔
پیشہ ور افراد کے لیے، پیشہ ور افراد کا بنایا ہوا
Skimle کے 50 سے زائد جامعات، سرکاری اداروں، ایجنسیوں اور کاروباری اداروں میں 1,500 سے زائد مطمئن صارفین ہیں۔ تمام ڈیٹا EU کے اندر محفوظ کیا جاتا ہے اور ان کے مطابق پروسیس ہوتا ہے: ہماری سخت GDPR پالیسی اور سروس کی شرائط.
مزید جاننا چاہتے ہیں؟ ملاحظہ کریں ہمارا Signal & Noise بلاگ، ہمارے عمومی سوالات اور شعبوں کے لحاظ سے استعمال کے مواقع۔ ہمیں پروڈکٹ کا ڈیمو دینے یا یہ جاننے میں بھی خوشی ہوگی کہ Skimle آپ کی ضروریات میں کیسے فٹ ہو سکتا ہے۔ Skimle کے پیچھے موجود کمپنی کے بارے میں مزید پڑھیں