客户体验与洞察团队
把 NPS 评论、评价、工单和问卷开放题回答汇集到一个项目中,找出产生贬损者的原因,并在同一周内与业务部门分享答案。
- 按分数段进行驱动因素分析
- 跨调查轮次的趋势
- 业务部门可据以行动的演示文稿
导入数据集
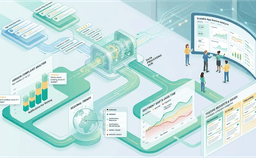
导入包含客户原声、问卷开放题回答、客服工单或社交媒体帖子的 CSV 或 Excel 文件。Skimle 会阅读每一条回答,构建主题,展示各细分群体之间的差异,并把发现整理成演示文稿。
免费试用含 200 积分,约可分析 6,000 条简短回答。无需信用卡。
每一行成为一条回答,每一列被赋予一个角色。文本列成为 Skimle 分析的内容。日期、评分、细分群体和国家成为可用于筛选和比较的元数据。不需要的列直接略过即可。
Skimle 会逐条处理整个数据集,记录每条回答说了什么,因此第 11,902 行的评论与第 12 行的评论同样重要。不会根据关键词猜测,也不会为了塞进上下文窗口而丢弃任何内容。
已编码的回答会被归入层级化的主题,每个主题都附有数量、摘要和背后的原声。您可以重命名、合并或拆分主题;如果已有自己的类别系统,也可以从它开始。
可视化会按您的元数据拆分每个主题:贬损者对比推荐者、一个市场对比另一个市场、本季度对比上季度。最大的差异会自动排序,让规律在您动手寻找之前就主动浮现。
Skimle 会根据发现生成演示文稿,在符合品牌风格的幻灯片上呈现图表、主题摘要和原文引语。您可以直接演示、以链接形式发布,或下载为 PowerPoint 或 PDF。下一轮数据到来时,导入后即可刷新幻灯片。
NPS 和 CSAT 评论、评价和投诉,附带评分、渠道和客户细分群体。
市场调研和品牌追踪的开放题回答,一个文件中可包含多个问题,旁边附有受访者画像。
从其他系统以 CSV 文件导出的客服工单、应用商店评价、聊天记录或 CRM 备注。
来自社交平台或舆情监测工具的帖子、评论和回复,附带平台、作者类型和日期。
已带有编码、实验条件或参与者变量的数据集,例如已编码的公众意见征集或学术研究资料。把您的编码作为元数据导入,与 Skimle 的发现进行比较。
敬业度调查、脉搏调查和离职调查中的评论,可按团队、司龄和工作地点细分。
| 已忽略 | 元数据 | 元数据 | 元数据 | 内容 |
|---|---|---|---|---|
| ID | 日期 | 渠道 | NPS | 评论 |
| C-20418 | 2026-03-02 | 应用 | 3 | 包裹晚到了四天,物流信息一直没更新。 |
| C-20419 | 2026-03-02 | 网站 | 9 | 结账很方便,客服团队当天就帮我办好了退货。 |
| C-20420 | 2026-03-03 | 邮件 | 6 | 质量不错,但运费到最后一步才显示出来。 |
| C-20421 | 2026-03-03 | 应用 | 2 | 在聊天里等了 40 分钟,结果被告知去发邮件。 |
每一行在 Skimle 中都会成为一份独立的文档。如果一个人回答了多个问题,请把他的回答放在同一行的不同列中。
第一行用来命名各列。内容列的名称会成为每份文档中的标题,元数据列的名称会成为字段名,因此请让它们清晰易读。
把每个开放式问题都标记为内容。Skimle 会将这些回答作为不同章节分开保存,日后您可以把分析范围限定在单个问题上。
日期、评分、细分群体、国家、渠道、调查轮次或研究条件:凡是您想用来筛选或拆分主题的维度,都应放在元数据列中。
日期使用统一格式,评分使用纯数字,这样字段才能获得正确的类型,您也才能绘制随时间变化的趋势和不同分数段之间的差异。
Skimle 不依赖固定的编码方案或模板,而是从数据中归纳式地创建类别。
每条回答都会被单独阅读和编码,因此主题的统计来自整个数据集,而不是根据样本估算。
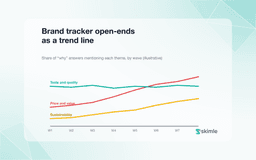
每个主题都会显示有多少条回答提到它,以及这一比例在不同细分群体之间、随时间如何变化。打开任意主题或图表中的柱条,即可看到背后的回答,相关段落已高亮显示。
编辑、合并和拆分主题,应用您自己的类别系统,或向 AI 对话提问有关数据的问题。分析由您来塑造。
把 NPS 评论、评价、工单和问卷开放题回答汇集到一个项目中,找出产生贬损者的原因,并在同一周内与业务部门分享答案。
用几天而不是几周时间,为数千条问卷开放题回答、客户评价和竞品评价编码,每个主题都有统计数字,并有客户读得懂的原声作为支撑。
以透明、可在方法部分中描述的编码流程,分析大型问卷开放题数据集、公众意见征集回复或社交媒体资料。
CSV 文件和 Excel 工作簿(.xlsx)。在任意项目中通过表格数据源添加即可:每一行成为一份文档,每一列成为内容、元数据或被略过。大多数问卷、客户体验、评价和舆情监测工具都能导出为这些标准格式之一。
数万行的数据集是常规规模。文件越大,处理时间越长,但即便数据集不断增大,分析仍会阅读每一条回答,而不会改用抽样。
不需要。把每个问题所在的列都标记为内容即可。Skimle 会把每个回答保存为该受访者文档中的一个独立章节,因此您既可以一起分析所有问题,也可以把分析范围限定在其中一个问题上。
可以。把现有编码作为元数据列导入,与 Skimle 发现的主题进行比较;或者把您的类别系统录入为预定义类别,让 Skimle 将其应用到每一条回答上。
积分在导入数据时消耗,分析、可视化、对话和导出均已包含。一个积分约可处理 30 条简短的开放式回答或一页较长的文本,因此 10,000 条简短问卷评论大约需要 330 积分。免费试用包含 200 积分。
可以。不同语言的回答可以放在同一个文件中。Skimle 会跨语言构建一套统一的主题,并以原始语言保留每一条引语。
可以。您可以把已编码的数据导出到 Excel,把图表和发现导出到 PowerPoint、Word 或 PDF,或者把整个项目以 REFI-QDA 格式导出,供其他定性分析工具使用。
所有数据都存储在欧盟境内,传输和存储时均经过加密,绝不用于训练 AI 模型。您可以随时删除数据集。