AI की गति से अकादमिक कठोरता
Skimle शिक्षाविदों द्वारा शिक्षाविदों के लिए बनाया गया है। सह-संस्थापक प्रोफ़ेसर Henri Schildt को गुणात्मक शोध का दशकों का अनुभव है और उनके लेख Academy of Management Journal और Organization Science सहित प्रमुख प्रबंधन पत्रिकाओं में प्रकाशित हुए हैं। वे NVivo और MAXQDA के धीमे, बोझिल वर्कफ़्लो से थक गए थे, और विश्लेषण में ChatGPT के ऐसे उपयोग से चिंतित थे जिसमें पारदर्शिता और व्यापकता की कमी है। इसलिए उन्होंने Skimle को ऐसे प्लेटफ़ॉर्म के रूप में बनाया जो कठोर, पारदर्शी गुणात्मक पद्धति को दोहराता है, लेकिन जिसके केंद्र में AI है।
साक्षात्कारों की प्रारंभिक कोडिंग हाथ से हफ़्तों ले सकती है। Skimle इसे पद्धतिगत कठोरता से समझौता किए बिना संभालता है, और अक्सर ऐसे उद्धरण पकड़ लेता है जो इंसान से छूट सकते हैं। हर विषय एक सत्यापित शब्दशः उद्धरण से जुड़ा है। पूरा ऑडिट ट्रेल पीयर रिव्यूअर्स को संतुष्ट करता है।
शैक्षणिक सामग्री →कठोर विश्लेषण जो आपको अपने सैद्धांतिक योगदान पर ध्यान देने देता है
Skimle का दृष्टिकोण ग्राउंडेड थ्योरी (Glaser & Strauss; Strauss & Corbin) और Gioia पद्धति से प्रेरित है। यह वह व्यवस्थित, पारदर्शी विश्लेषण देता है जिसकी पीयर रिव्यू माँग करता है, उन हफ़्तों की यांत्रिक कोडिंग के बिना जो सिद्धांत पर बेहतर ढंग से लगाया जा सकने वाला समय खा जाती है। यह 100+ भाषाओं में काम करता है और प्रति परियोजना 1,000 दस्तावेज़ों तक संभालता है।
- स्वचालित प्रारंभिक कोडिंग, हर उद्धरण अपनी श्रेणी से जुड़ा
- पीयर रिव्यू और पद्धति की पारदर्शिता के लिए पूरा दो-तरफ़ा ऑडिट ट्रेल
- आपके नियंत्रण वाली श्रेणी प्रणाली: श्रेणियों को स्वतंत्र रूप से मिलाएँ, विभाजित करें, नाम बदलें, पुनर्गठित करें
- बिना अनुवाद 100+ भाषाओं में काम करता है
- साक्षात्कार, ऑडियो/वीडियो, किताबें, दस्तावेज़ और अभिलेखीय सामग्री संभालता है
- Skimle Academic, एक रियायती योजना, उपलब्ध
साक्षात्कार ट्रांसक्राइब और अनामीकृत करें
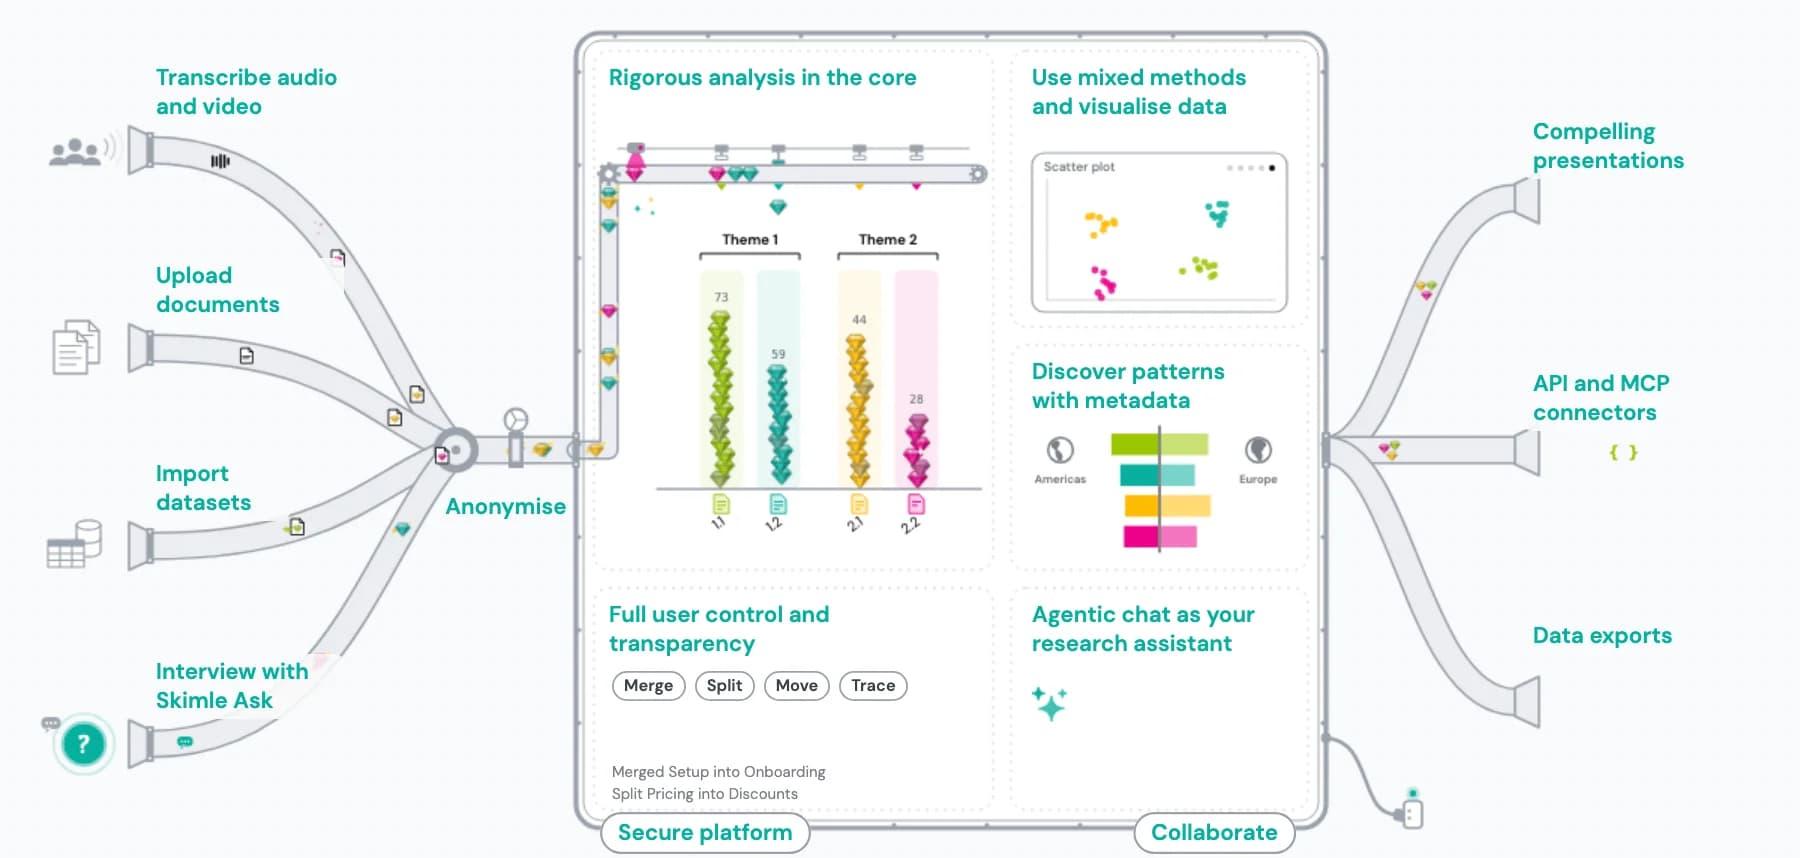
किसी तीसरे पक्ष की सेवा से फ़ील्ड रिकॉर्डिंग को उपयोगी डेटा में बदलना धीमा और महँगा है, और बने हुए ट्रांसक्रिप्ट में नाम, संबद्धताएँ और स्थान होते हैं जो साझा करने, संग्रहित करने या उद्धृत करने से पहले GDPR और नैतिकता संबंधी दायित्व पैदा करते हैं। Skimle अपने सुरक्षित, EU में होस्ट किए गए परिवेश में ऑडियो और वीडियो ट्रांसक्राइब करता है, फिर शोध-स्तरीय छद्मनामीकरण से अनामीकृत करता है, ताकि आपको उसी दिन अनुपालक, कोडिंग के लिए तैयार ट्रांसक्रिप्ट मिले, और डेटा कभी GDPR-अनुरूप इन्फ्रास्ट्रक्चर से बाहर न जाए।
यह कैसे काम करता है
- 1. ऑडियो, वीडियो या टेक्स्ट अपलोड करें
MP3, M4A, WAV, MP4, MOV, PDF या Word फ़ाइलें सीधे अपलोड करें। किसी बाहरी ट्रांसक्रिप्शन सेवा की ज़रूरत नहीं, और 100+ भाषाएँ मूल रूप से समर्थित।
- 2. वक्ता लेबल के साथ ट्रांसक्राइब करें
Skimle रिकॉर्डिंग ट्रांसक्राइब करता है, वक्ताओं के बदलाव पहचानता है, और अलग-अलग लहजों तथा ऑडियो गुणवत्ता को संभालता है। विश्लेषण शुरू होने से पहले परिणाम की समीक्षा और सुधार करें।
- 3. पहचानकर्ताओं का स्वचालित पता लगाएँ
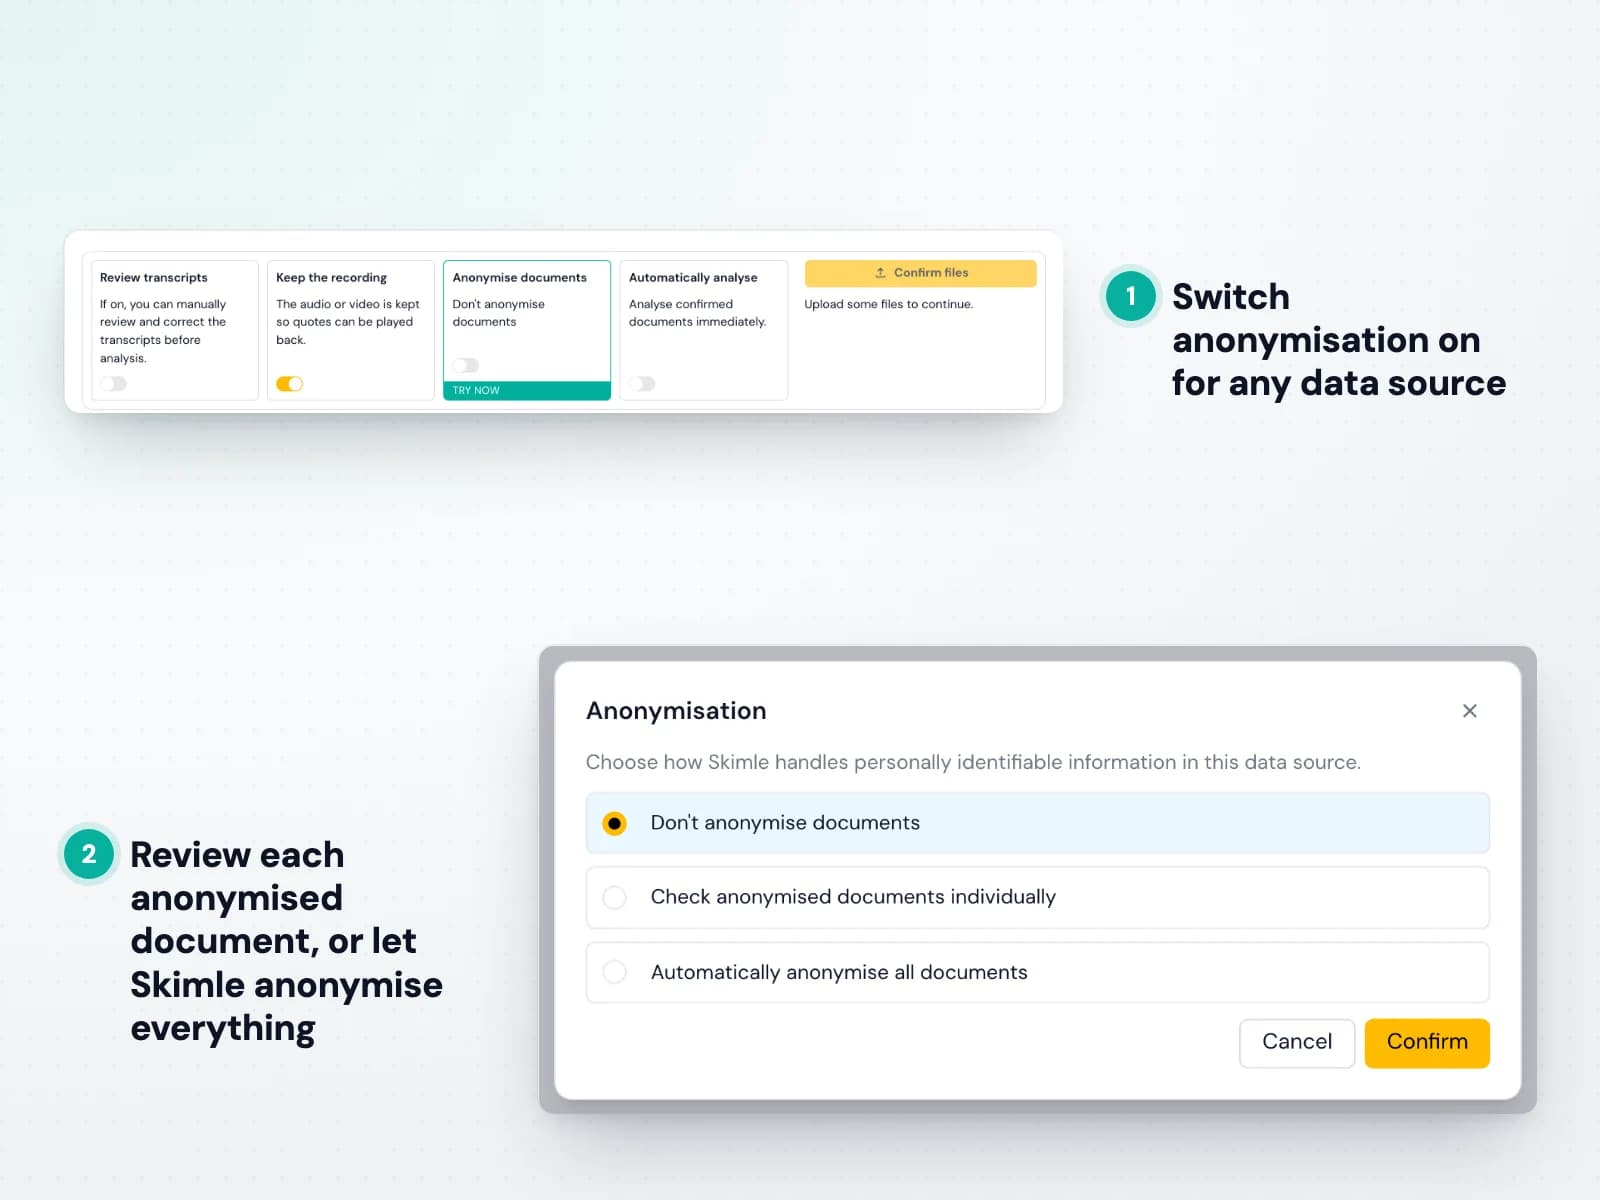
Skimle Anonymise हर दस्तावेज़ में छह श्रेणियों के पहचानकर्ताओं को चिह्नित करता है: नाम, पदनाम और भूमिकाएँ, स्थान, संगठन, तिथियाँ और अन्य, फ़ाइलों में एकरूपता के साथ ताकि एक ही व्यक्ति को एक ही छद्मनाम मिले।
- 4. अपना अनामीकरण स्तर चुनें
हल्का छद्मनामीकरण, मज़बूत छद्मनामीकरण, या कुंजी नष्ट करने वाला HIPAA-स्तरीय अनामीकरण चुनें। हर श्रेणी को अलग से समायोजित करें और सरल भाषा में कस्टम नियम जोड़ें।
- 5. ऑडिट दस्तावेज़ीकरण के साथ निर्यात करें
अपनी नैतिकता समिति के लिए PDF ऑडिट रिपोर्ट और Excel अनुवाद तालिका निर्यात करें, फिर साफ़ ट्रांसक्रिप्ट को सीधे Skimle के विश्लेषण वर्कफ़्लो में भेजें। उसके बाद स्रोत ऑडियो सुरक्षित रूप से हटा दिया जाता है।

साक्षात्कारों का AI-सहायता प्राप्त गुणात्मक विश्लेषण करें
40+ साक्षात्कारों पर आधारित शोध से एक समृद्ध सैद्धांतिक योगदान निकलना चाहिए (उदाहरण के लिए आपकी पीएचडी के लिए), लेकिन मैन्युअल कोडिंग, यानी हाइलाइट करना, व्यवस्थित करना, दोबारा कोड करना और ट्रैकर बनाना, उपलब्ध समय का अधिकांश हिस्सा खा जाती है और फिर भी ज़रूरी पैटर्न छूट सकते हैं। Skimle हर साक्षात्कार को व्यवस्थित रूप से पढ़ता है और शब्दशः उद्धरणों के साथ एक संरचित विषय पदानुक्रम देता है, ताकि आप उस सैद्धांतिक व्याख्या पर समय लगा सकें जो केवल आप दे सकते हैं।
यह कैसे काम करता है
- 1. अपने ट्रांसक्रिप्ट अपलोड करें
साक्षात्कार ट्रांसक्रिप्ट PDF, Word फ़ाइलों या सादे पाठ के रूप में खींचकर डालें। Skimle किसी भी फ़ॉर्मेट में दस्तावेज़ स्वीकार करता है और 100+ भाषाएँ मूल रूप से संभालता है।
- 2. अपना शोध प्रश्न बताएँ
अपना विश्लेषणात्मक फ़ोकस व्यापक या विशिष्ट रूप से तय करें। Skimle प्रारंभिक कोडिंग को उस चीज़ के इर्द-गिर्द संरचित करता है जिसे आप सैद्धांतिक रूप से समझना चाहते हैं।
- 3. प्रारंभिक कोड संरचना की समीक्षा करें
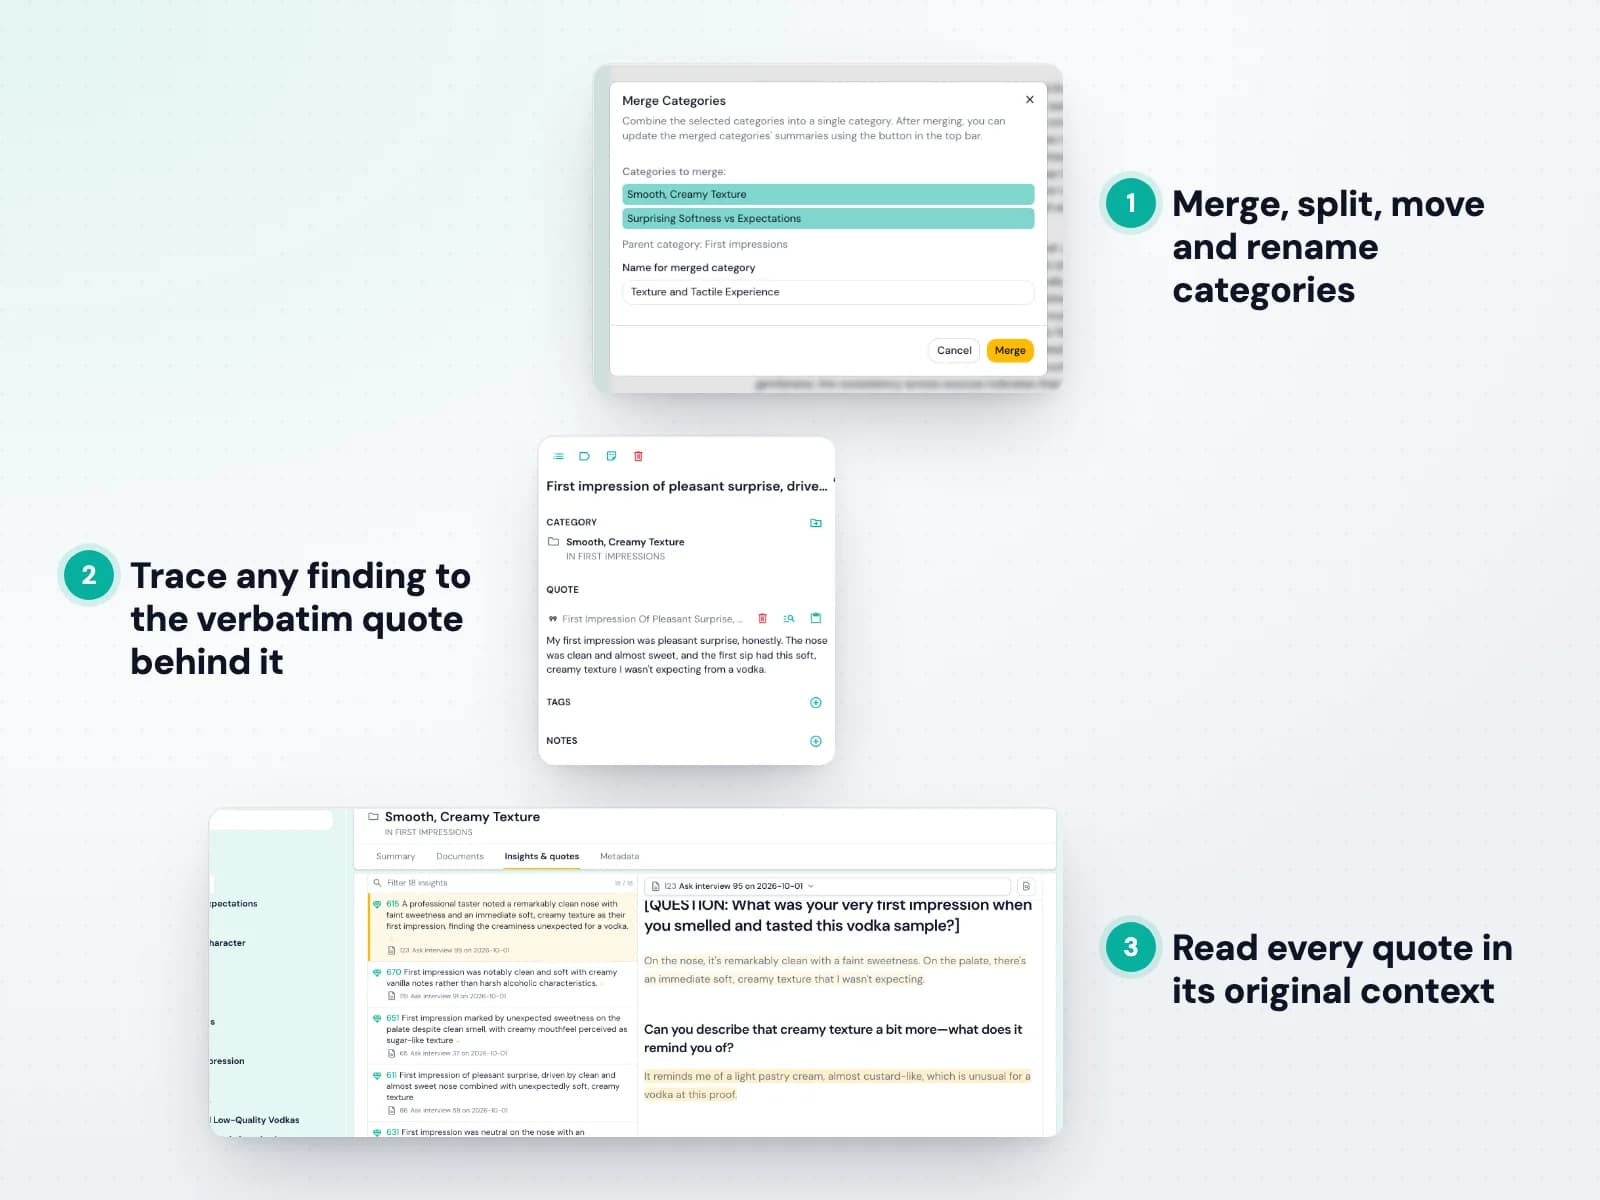
Skimle विषयों का पदानुक्रम बनाता है, हर एक स्रोत ट्रांसक्रिप्ट के शब्दशः उद्धरणों से जुड़ा। कुछ भी गढ़ा नहीं जाता। हर कोड पाठ तक ट्रेस होता है।
- 4. अपने सैद्धांतिक ढाँचे के अनुसार परिष्कृत करें
अपने उभरते सैद्धांतिक मॉडल के अनुसार श्रेणियों को मिलाएँ, विभाजित करें, नाम बदलें और पुनर्गठित करें। दो-तरफ़ा पारदर्शिता से आप किसी भी समय जाँच सकते हैं कि कौन-से उद्धरण किन कोड का समर्थन करते हैं।
- 5. अपने पद्धति परिशिष्ट के लिए निर्यात करें
अपनी श्रेणी प्रणाली और समर्थक उद्धरण पाठ के रूप में, या NVivo, ATLAS.ti या MAXQDA जैसे पुराने CAQDAS प्रोग्रामों द्वारा समर्थित ओपन सोर्स REFI-QDA (.qdpx) फ़ॉर्मेट में निर्यात करें।
अपने नमूने पर मिश्रित-विधि विश्लेषण चलाएँ
गुणात्मक निष्कर्षों का वज़न तब बढ़ता है जब आप दिखा सकें कि वे नमूने में कैसे बदलते हैं: समूह, भूमिका, लिंग, स्थल या स्थिति के अनुसार। प्रतिभागियों की विशेषताओं के साथ विषयों को हाथ से क्रॉस-टैबुलेट करना थकाऊ है और इसमें गलती आसान है। Skimle हर दस्तावेज़ से मेटाडेटा जोड़ता है और आपको उसी विषय संरचना को किसी भी चर के अनुसार विभाजित करने देता है, ताकि आप किसी पद्धति को पीछे छोड़े बिना समृद्ध शब्दशः उद्धरणों और मात्रात्मक पैटर्न के बीच आ-जा सकें।
यह कैसे काम करता है
- 1. दस्तावेज़ों के साथ मेटाडेटा जोड़ें
हर ट्रांसक्रिप्ट को उन चरों से टैग करें जो आपके डिज़ाइन के लिए मायने रखते हैं, जैसे समूह, भूमिका, लिंग, स्थल, चरण या प्रयोगात्मक स्थिति, हाथ से या CSV कॉलम से।
- 2. गुणात्मक विश्लेषण चलाएँ
Skimle सभी दस्तावेज़ों में एक ही विषय पदानुक्रम बनाता है, ताकि हर प्रतिभागी की कोडिंग एक ही संरचना के अनुसार हो।
- 3. चरों के अनुसार विषयों को विभाजित करें
देखें कि हर विषय समूहों में कैसे बदलता है, और पहचानें कि कोई पैटर्न सार्वभौमिक है या किसी एक समूह तक सीमित।
- 4. प्रचलन मापें
विषयों की आवृत्तियाँ और वितरण पढ़ें ताकि बता सकें कि कोई कोड हर खंड में कितना आम है, हर गिनती उन उद्धरणों तक ट्रेस करने योग्य जिनसे वह बनी।
- 5. तालिकाएँ और उद्धरण निर्यात करें
अपने शोधपत्र के मिश्रित-विधि अनुभाग के लिए क्रॉस-टैबुलेशन और समर्थक उद्धरण Excel या Word में निर्यात करें।

अक्सर पूछे जाने वाले प्रश्न
- क्या मैं अपने शोध में Skimle का हवाला दे सकता हूँ?
- हाँ। अपने पद्धति अनुभाग में इसे ‘AI-सहायता प्राप्त गुणात्मक कोडिंग सॉफ़्टवेयर’ के रूप में बताएँ, जैसे आप NVivo या MAXQDA का हवाला देते। हमारा एक पद्धति लेख पीयर रिव्यू में है जो औपचारिक उद्धरण देगा, और तब तक अनुरोध पर हम उद्धरण भाषा सुझा सकते हैं।
- क्या पीयर रिव्यूअर AI-सहायता प्राप्त विश्लेषण स्वीकार करेंगे?
- उचित दस्तावेज़ीकरण के साथ, अधिकाधिक हाँ। Skimle का ऑडिट ट्रेल समीक्षकों को वही देता है जिसकी वे अपेक्षा करते हैं: एक दस्तावेज़ीकृत, व्यवस्थित कोडिंग प्रक्रिया जिसमें हर विषय विशिष्ट उद्धरणों तक ट्रेस होता है, ताकि पद्धति अनुभाग लगभग अपने आप लिख जाए।
- Skimle की NVivo या MAXQDA से तुलना कैसी है?
- NVivo और MAXQDA उन शोधकर्ताओं के लिए उपयुक्त हैं जिनके पास विश्लेषण के लिए हफ़्ते और संस्थागत लाइसेंस है। Skimle यांत्रिक कोडिंग चरण को स्वचालित करता है, हफ़्तों से घंटों तक, उसी व्यवस्थित, पारदर्शी पद्धति को बनाए रखते हुए, और इसे सीखने में मिनट लगते हैं। कई शोधकर्ता दोनों का उपयोग करते हैं: प्रारंभिक कोडिंग के लिए Skimle, मिश्रित-विधि एकीकरण के लिए NVivo।
- क्या Skimle ग्राउंडेड थ्योरी के लिए काम करता है?
- हाँ। Skimle आगमनात्मक कोडिंग का समर्थन करता है जिसमें विषय पहले से थोपे जाने के बजाय डेटा से उभरते हैं। एक व्यापक फ़ोकस से शुरू करें और श्रेणी संरचना को बार-बार विकसित होने दें, जो ग्राउंडेड थ्योरी की ओपन कोडिंग से काफ़ी मेल खाता है।
- क्या मैं मिश्रित-विधि विश्लेषण चला सकता हूँ?
- हाँ। हर दस्तावेज़ से मेटाडेटा चर जोड़ें, जैसे समूह, भूमिका, लिंग, स्थल, स्थिति, और विषय संरचना को इनमें से किसी के भी अनुसार विभाजित करें। आपको समूहवार विषय आवृत्तियाँ और वितरण मिलते हैं, हर एक शब्दशः उद्धरणों तक ट्रेस करने योग्य, आपके शोधपत्र के मिश्रित-विधि अनुभाग के लिए तैयार।
- क्या मेरा शोध डेटा सुरक्षित है?
- आपके ट्रांसक्रिप्ट EU में होस्ट किए गए इन्फ्रास्ट्रक्चर पर प्रोसेस होते हैं और कभी भी AI मॉडल प्रशिक्षित करने में उपयोग नहीं होते। हम संस्थागत नैतिकता आवश्यकताओं के लिए डेटा प्रोसेसिंग अनुबंध देते हैं और अधिकांश IT सुरक्षा ज़रूरतें पूरी कर सकते हैं। विशिष्ट आवश्यकताओं के साथ हमसे संपर्क करें।
- क्या मुझे अकादमिक छूट मिल सकती है?
- हाँ। वैध संस्थागत ईमेल और संबद्धता पेज वाले शिक्षाविद रियायती Skimle Academic पैकेज ख़रीद सकते हैं। अगर आपको किसी शोध समूह या प्रयोगशाला के लिए टीम एक्सेस चाहिए, तो संस्थागत लाइसेंस के लिए हमसे संपर्क करें।
पेशेवरों के लिए, पेशेवरों द्वारा
Skimle के 50 से अधिक विश्वविद्यालयों, सरकारी संस्थाओं, एजेंसियों और उद्यमों में 1,500 से अधिक संतुष्ट उपयोगकर्ता हैं। सारा डेटा EU में संग्रहीत होता है और इनके अनुसार प्रोसेस होता है: हमारी सख़्त GDPR नीति और सेवा की शर्तें.
और जानना चाहते हैं? देखें हमारा Signal & Noise ब्लॉग, हमारे अक्सर पूछे जाने वाले प्रश्न और क्षेत्र के अनुसार उपयोग के मामले। हमें उत्पाद का डेमो देने या यह जानने में भी ख़ुशी होगी कि Skimle आपकी ज़रूरतों में कैसे फिट हो सकता है। Skimle के पीछे की कंपनी के बारे में और पढ़ें