すべての回答者の声を聞く。すべてのインサイトをたどれる。すべての締め切りを守る。
クライアントに成果を届ける市場調査会社と、事業部門に成果を届ける社内の顧客インサイトチームのために作られています。どちらも同じ板挟みにあります。質的データは手元にある最も豊かなシグナルなのに、量が多すぎて手作業では丁寧に読み切れません。調査会社には、より短い期間とより低い費用でより深いインサイトが求められます。社内チームには、2週間も待ってくれない製品や営業の意思決定に追いつくことが求められます。
Skimle は、アナリストの1週間の大半を占める機械的なコーディングを引き受けます。解釈、「だから何なのか」、提言はあなたが担います。2週間のコーディングが2日になり、圧縮してもニュアンスは失われません。
調査量に合わせて拡張できるプロ品質の分析
60件のデプスインタビュー、4つの市場での8回のフォーカスグループ、5,000件の NPS の自由回答。この量は丁寧に手作業で読める範囲を超えており、表面的なツールではクライアントや営業責任者が必ず尋ねるニュアンスが失われます。Skimle は深さを犠牲にせずに規模を拡大できます。
- インタビュー、フォーカスグループ、自由回答式アンケート、レビュー、サポートへの問い合わせを1つのプロジェクトで扱える
- すべてのテーマが、サンプルではなくデータセット全体からの顧客の逐語引用にリンク
- セグメント分析を標準搭載:属性、製品のグレード、地域、NPS の区分で比較
- 1つのプロジェクトで100以上の言語に対応し、翻訳の手順は不要
- プレゼンテーションにそのまま使える Word、PowerPoint、Excel への書き出しが数分で
フォーカスグループと顧客インタビューを大規模に分析
フォーカスグループは、うまく分析するのが最も難しい質的データです。根拠を追跡しなければ、声の大きい参加者1人の意見も、独立した4人の声と同じに見えてしまいます。デプスインタビューは別の形でつまずきます。記録が20件、40件、60件になると、最後の1件を最初の1件と同じようにコード化することがボトルネックになります。Skimle はすべてのセッションにわたって1つのテーマ構造を作り、何が一貫していたか、何がセグメントによって異なったか、何が単独の外れ値だったかを示すので、クライアントやステークホルダーに反論されても結果は揺らぎません。
しくみ
- 1. 各セッションを1つの文書として取り込む
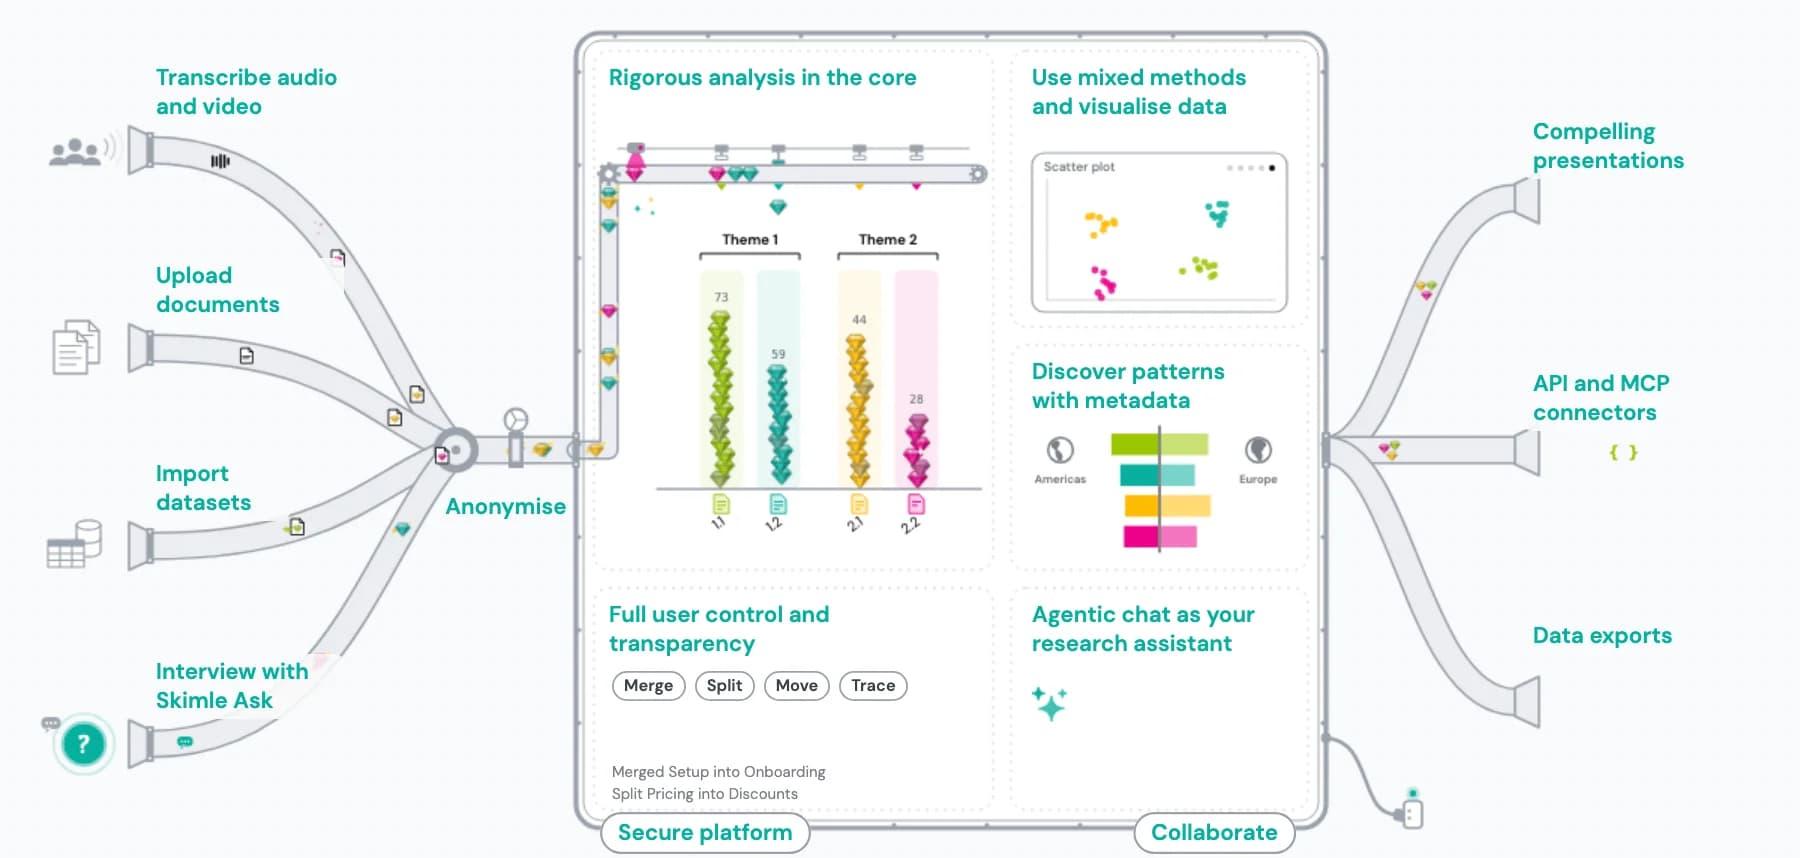
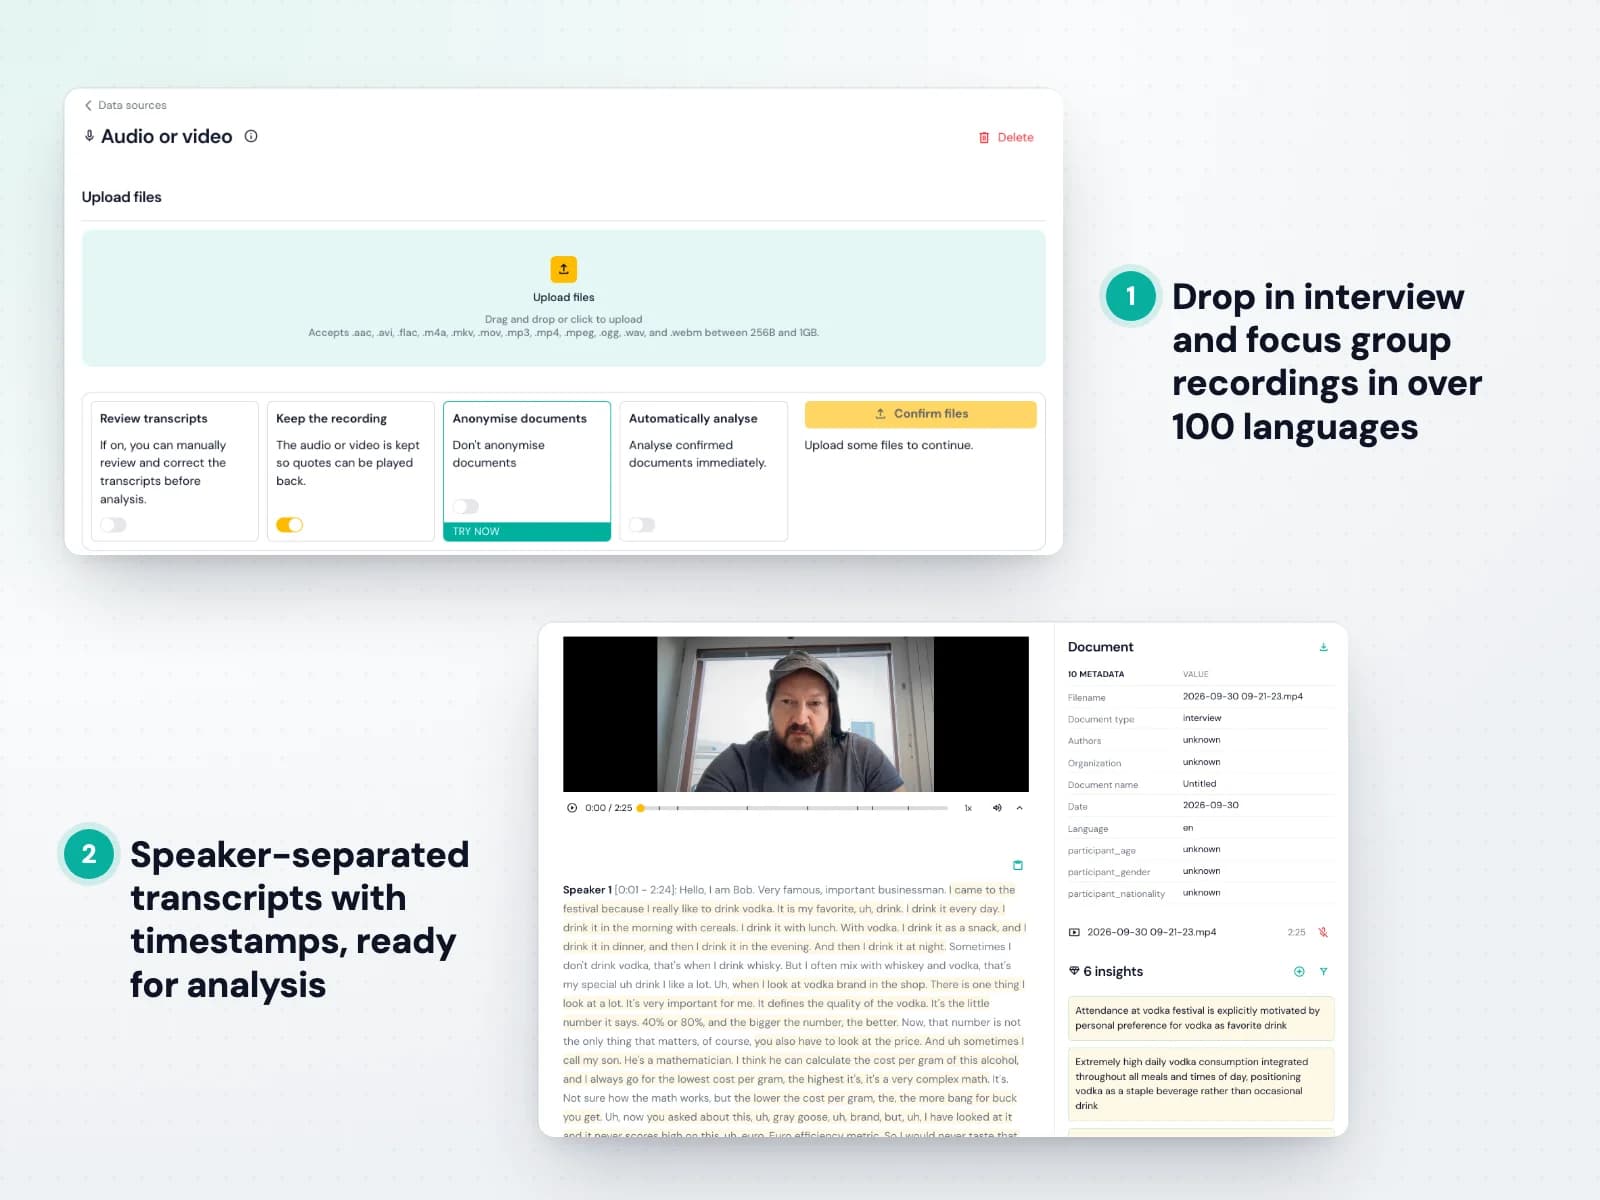
Zoom、Teams、Otter、Fireflies から記録や録音をアップロードできます。Skimle は音声と動画を直接文字起こしするので、各セッションがすぐに分析できる1つの文書になります。
- 2. 全セッションで分析を実行
Skimle はすべての記録を読み、全セッションの内容からテーマを作ります。あらかじめ決めたカテゴリ体系を押しつけるのではなく、実際に何が話されたかを見つけ出します。
- 3. 一貫していた点と異なった点を確認
各テーマには、どのグループが寄与したかとその頻度が表示され、普遍的なシグナルを1つのセッションや1つの市場だけのものと区別できます。
- 4. 根拠の分布を評価
どのテーマをクリックしても根拠の引用を読め、それがどのセッションから来たかがわかります。声の大きい参加者の影響を記憶に頼らず直接判断できます。
- 5. クライアント向けに書き出す
グループ別の代表的な引用を含む統合文書を作成でき、資料にも報告書全文にもそのまま使えます。
自由回答式のアンケートをコード化し、セグメント間で比較
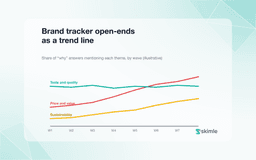
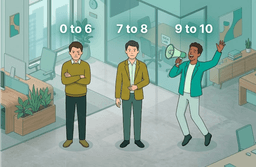
全体のテーマ一覧だけでは、ビジネスが本当に知りたい問い、つまり誰がそう感じていて、それがセグメントによってどう違うのかには答えられません。数千件の自由回答を前にすると、ほとんどのチームは一部をざっと読むだけで、最も鋭いシグナルを持つ少数意見を見落とします。Skimle はすべての回答をコード化し、NPS の区分、製品のグレード、市場、属性など、あらゆるメタデータ変数で同じテーマ構造を切り分けられるので、トラッキング調査の自由回答を、行動につなげられる混合研究法の視点に変えられます。
しくみ
- 1. メタデータ付きで回答をアップロード
SurveyMonkey、Typeform、Qualtrics から、回答者のメタデータの列と一緒に自由回答を CSV で取り込めます。すべての回答にセグメントが付きます。
- 2. テーマ構造全体を作る
Skimle は多い回答だけでなくすべての回答をテーマの階層にコード化するので、少数意見も見えるまま残ります。
- 3. 任意の変数で分ける
NPS の区分、製品のグレード、地域、属性でテーマを絞り込んで比較し、どの顧客にとってどの問題が最も重要かを把握できます。
- 4. 根拠を検証
すべてのパターンは逐語引用までたどれるので、2つのセグメント間の差は、それを生んだ回答そのものに裏づけられます。
- 5. クライアントにそのまま出せる成果を書き出す
逐語引用とクロス集計を含むテーマ別レポートを作成でき、数日ではなく数分で終わります。

すべてのフィードバックチャネルを1つのインサイトにまとめる
インタビュー、NPS の自由回答、サポートへの問い合わせ、レビュー、営業通話の録音、受注・失注の振り返り、コミュニティの投稿、アナリストや競合のレポート。チャネルごとに別々の分析、別々の資料、別々の用語が使われがちなので、全体がかみ合わず、同じ顧客の問題が3つの名前で3回報告されます。Skimle は1つのプロジェクトですべての情報源を1つのカテゴリ構造でコード化し、各チャネルが同じテーマをどれだけ重視しているかを示します。調査会社はデスクリサーチや二次資料を一次調査に組み込むために、社内チームは顧客を常に把握するために使っています。
しくみ
- 1. チャネルを1つのプロジェクトに集める
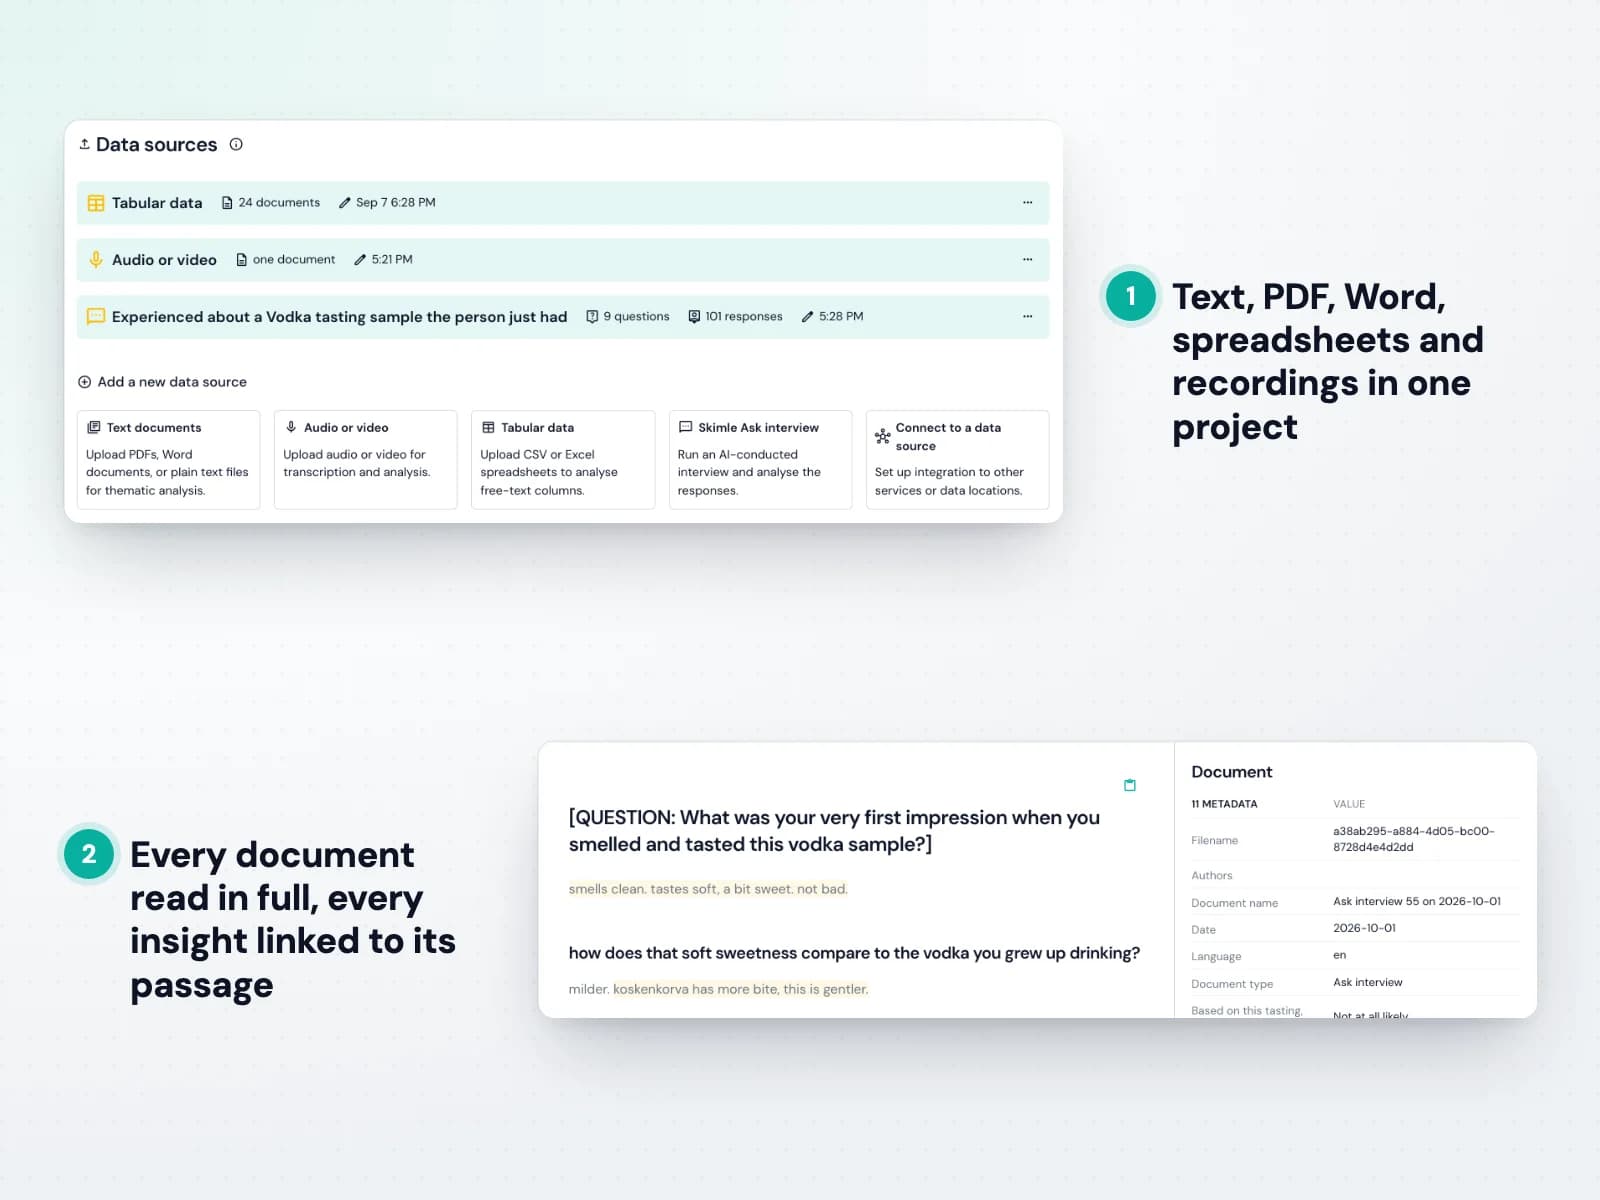
記録、CSV の書き出しデータ、PDF、録音を並べてアップロードできます。問い合わせの書き出しデータ、レビューのデータ、アナリストのレポート、インタビューの音声が、すべて同じプロジェクトの文書になります。
- 2. 各文書にチャネルをタグ付け
チャネル、セグメント、市場、日付をメタデータとして入れておけば、以降の情報源の比較は新たな分析ではなく絞り込みで済みます。
- 3. すべてを1つの構造でコード化
Skimle はすべての情報源にわたって1つのテーマ構造を作るか、すでに報告に使っている枠組みを適用するので、どのチャネルでも同じ結果は同じ意味を持ちます。
- 4. 各チャネルが伝えていることを比較
情報源が一致する点と矛盾する点がわかります。問い合わせでは目立つのにインタビューには出てこないテーマは、帳尻を合わせるべき食い違いではなく、1つの発見です。
- 5. やり直さずに次の調査回を追加
次の四半期のデータも同じ構造でコード化されるので、トラッキング調査の比較可能性が保たれ、更新したレポートは作り直しではなく再書き出しで済みます。
よくある質問
インサイトチームや調査会社のリサーチ責任者から最もよく寄せられる質問をまとめました。購買プロセスでそのまま出てくる質問も含まれています。ベンダーに中立な RFP チェックリストには、評価するすべてのベンダー(当社を含む)に尋ねるべき同じ質問を載せています。
- 安くて浅い代替手段と競ううえで、どう役立ちますか?
- 低価格の業者や薄い AI ラッパーは、ワードクラウドと平板なテーマ一覧で価格競争をしています。Skimle はそれらと同じスピードで深さを提供するので、調査会社は料金ではなく「だから何なのか」の質で差別化でき、社内チームは同じ予算でより多くの調査をこなせます。アナリストの時間は機械的なコーディングから解釈へ移ります。誰もが本当にお金を払っているのは、その部分です。 質的調査のお金が実際にどこへ消えているかを見る →
- クライアントやステークホルダーが AI を活用した分析を疑問視したら、どう答えればよいですか?
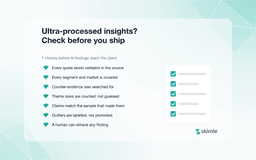
- 正確に説明してください。AI は機械的な分類を行い、名前のある研究者がすべてのテーマを確認して解釈を書きます。そのうえで根拠を示します。Skimle のレポートのすべての主張は、逐語引用とその出典の文書に開けます。手作業のまとめでは、コーディングの論理が誰かの頭の中にしか存在しなかったので、これはそれよりも強い答えになります。 質的市場調査で AI を責任をもって使うための7つのルール →
- Skimle はデータセット全体を分析しますか、それとも一部のサンプルだけですか?
- データセット全体です。これはどのベンダーにも聞く価値があります。ツールによっては、埋め込み検索で文書の一部だけを取り出して分析し、どの文書が含まれなかったかを一切報告しないからです。出力はコーパス全体を網羅しているように読めますが、実際にはそうではありません。Skimle はすべての文書をコード化し、どの文書を開いても、どの箇所がコード化され、どこがされなかったかを正確に確認できます。
- 自社のカテゴリ体系を適用できますか?それとも AI が作ったものを受け入れるしかありませんか?
- どちらも可能で、同じコーパスで両方使うこともできます。既存のカテゴリ体系を持ち込めば Skimle がそれに沿って演繹的にコード化し、データから帰納的に構造を作らせることもできます。カテゴリは後から統合、分割、名前変更、並べ替え、削除ができ、分析はあなたの編集に追従します。トラッキング調査やクライアント標準の枠組みを毎年回している調査会社は通常演繹的に進め、探索的な調査は通常その逆から始めます。
- 捏造された引用がレポートに載るのを、何が防いでいますか?
- すべての引用は、出典の文書と機械的に照合されます。モデルがデータに逐語で存在しないテキストを出力した場合、Skimle はそれを表示せずに検出して再処理するので、作り出された引用がクライアント向けの資料に載ることはありません。どの文書を開いても、どの箇所がコード化され、どこがされなかったかを確認できるので、何かが見落とされるという逆の失敗も見つけられます。 双方向の透明性のしくみ →
- 候補リストのほかのツールと比べて、Skimle をどう評価すべきですか?
- デモを見るより、試験導入をしてください。答えがわかっている、すでに分析済みのコーパスを使い、始める前に3つのタスク(コーディング、セグメント比較、根拠探し)を決め、修正作業も含めて各タスクの時間を測り、あえてツールに反対してみて、その出力をどれだけ早く組み替えられるかを確かめます。現在お使いのツールと並行して実際のプロジェクトを1つ行うこともでき、その前に無料プランで研究者1人が午後のうちに判断材料を得ることもできます。 7つの領域からなる RFP チェックリストと採点テンプレート →
- Skimle はどれくらいのデータを、何言語で扱えますか?
- 1プロジェクトあたり最大1,000件の文書に対応しており、20件のインタビュー調査から数千件のアンケート回答を含むグローバルなトラッキング調査まで、すべてをカバーします。100以上の言語を翻訳なしでそのまま分析します。1つのプロジェクトで英語、スペイン語、中国語、ドイツ語、アラビア語を混在させ、すべてにわたって1つのテーマ構造を作り、各引用を原文のまま保持できます。この上限近くの規模を日常的に扱う場合は、ボリュームについてご相談ください。
- クライアントのデータは安全で、機密は守られますか?
- すべてのデータは EU 内の AWS 上で、認定を受けた第三者が構成した環境で保管・処理され、お客様のデータがモデルの学習に使われることは一切ありません。データ処理契約をご用意しており、クライアントとの NDA のもとで業務を行い、仮名化はワークフローに組み込まれています。データ主権の観点で必要な場合は、シングルテナントやプライベートクラウドでの導入も可能です。
- Skimle の利用をやめたら、分析はどうなりますか?
- どのプランでも持ち出せます。コード化したデータをオープン標準の REFI-QDA(.qdpx)で書き出して NVivo、ATLAS.ti、MAXQDA で作業を続けることも、テーマ別に引用を整理した Word、PowerPoint、Excel の成果物を持ち出すこともできます。相互運用の標準を実装しているのは、Skimle を使い続けることが結果ではなく選択であるようにするためです。
- 調査量が変動する場合、料金はどうなりますか?
- Skimle は、クレジットの付いた軽量な席単位のサブスクリプションと、大規模な調査を行う月に購入するクレジットパックで構成されています。サブスクリプションでプロジェクトの合間もチーム全員がツールを使い続けられ、パックで費用を発生源のプロジェクトにひも付けられます。これはクライアントに費用を請求する調査会社にとって重要です。結果を読むだけのステークホルダーには席は不要です。書き出しデータや印刷できる調査レポートで足ります。
- 複数の研究者が同じプロジェクトで作業できますか?
- はい、同時に作業でき、各自の編集や注釈は保持されます。相互レビューや品質管理に適しており、大規模な調査を若手とベテランで分担し、1人のベテランがカテゴリ構造を主導する場合にも向いています。
プロフェッショナルによる、プロフェッショナルのためのツール
Skimle は、50以上の大学、政府機関、エージェンシー、企業で1,500人を超えるユーザーに満足して使われています。すべてのデータは EU 域内に保存され、当社の厳格な規定に従って処理されます。詳しくは次をご覧ください: GDPR ポリシー および 利用規約.
さらに詳しく知りたい方は、 Signal & Noise ブログ、 よくある質問、業種別の活用例をご覧ください。製品のデモや、Skimle がお客様のニーズにどう合うかのご相談も喜んで承ります。 Skimle を運営する会社について詳しく読む