Skimle の機能一覧
Skimle は、市場調査の担当者、顧客インサイトの専門家、学術研究者、コンサルタントなど、データをより深く掘り下げたい探究心のあるプロフェッショナルのための、AI ネイティブな質的データ分析ソフトウェアです。
インタビューの文字起こし、フォーカスグループの録音、数千件の自由回答を含む表、文書など、あらゆる質的データを100以上の言語でアップロードできます。Skimle の厳密なボトムアップのワークフローがインサイトを見つけ出し、自由に編集できる透明なカテゴリ構造をつくります。混合研究法によるデータの可視化、メタデータを使ったパターンの発見、MCP による AI エージェントとの接続、説得力のあるプレゼンテーションの作成なども行えます。
プラットフォームには、質的なインサイトを大規模に集められる強力な AI 支援型の調査エンジン Skimle Ask も含まれています。インタビューガイドを設定して回答者にリンクを共有すれば、テキスト、音声、動画での回答と的確な追加質問でデータを集められます。
Skimle は学術的な厳密さとビジネスの実用性を兼ね備えています。多くの AI ツールは本来の分析を省き、もっともらしいものの根拠を示せず、偏りやハルシネーションが生じやすい要約を出すだけです。NVivo、MAXQDA、ATLAS.ti のような従来のツールでは、時間の大半を分析ではなく手作業のコーディングに費やすことになります。Skimle の設計は違います。完全な双方向の透明性とユーザーによるコントロールを備えた、厳密で自動化された AI 分析ワークフローを利用できます。
Skimle はフルサービスの質的分析プラットフォームです
Skimle は多用途なツールで、次のことができます…
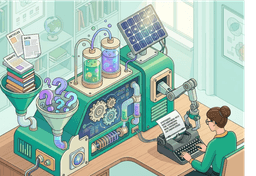
Skimle のしくみを示すアニメーション図。データは4本の入力パイプ(文字起こし、文書のアップロード、データセットの取り込み、Skimle Ask インタビュー)から入ります。匿名化バルブを通ってマシンに入り、そこでインサイトがテーマに分類され、可視化で探索され、メタデータで比較され、AI リサーチアシスタントと議論されます。結果は3本の出力パイプ(プレゼンテーション、API と MCP コネクター、データの書き出し)から出ていきます。
学術研究
グラウンデッド・セオリー
生データから帰納的に理論を構築します。Skimle が記録をコード化して浮かび上がる概念を示し、パターンが見えてくるにつれてカテゴリ体系を繰り返し磨き上げられます。
続きを読む →
コンサルティングとデューデリジェンス
専門家ヒアリングの統合
プロジェクト全体のエキスパートネットワークとの通話を文字起こしし、コード化します。市場動向、リスク、機会についての専門家の見解を、従来よりはるかに短い時間で構造化して把握できます。
続きを読む →
人事・組織・文化
パルスサーベイ
Skimle Ask で短いインタビューを頻繁に行い、従業員の感情に関するテーマが時間とともにどう変化するかを追跡し、人事が組織の健康状態をリアルタイムで把握できるようにします。
続きを読む →
テーマはデータから浮かび上がります
すべての変更は記録され、元に戻せます。
ステップ1
データをアップロードして集める
録音、文書、データセットを取り込むか、AI 支援のインタビューで新しいデータを集め、分析の前に匿名化します。
音声と動画を文字起こし
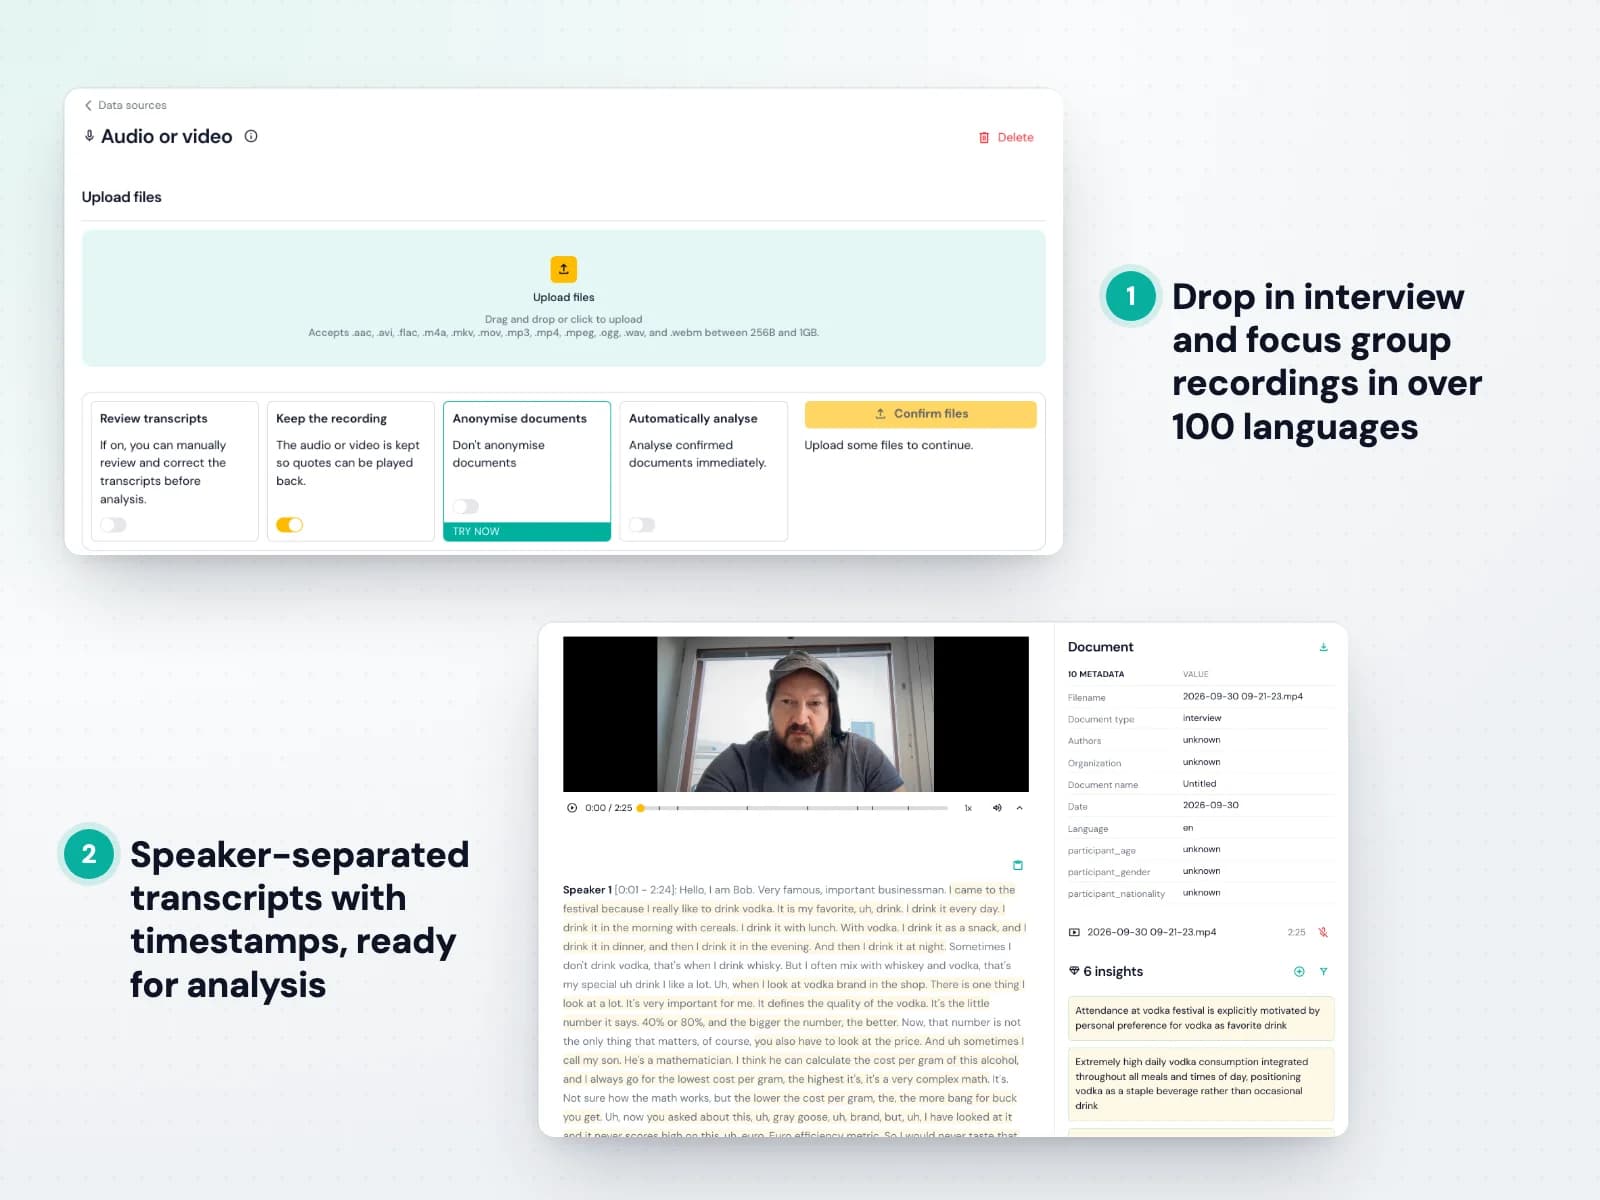
音声や動画をアップロードすると、Skimle が100以上の言語で、話者ごとに分かれた正確な文字起こしに変換します。別の文字起こしツールに費用を払う必要も、システム間でファイルをやり取りする必要もありません。テキストはそのままプロジェクトに入ります。録音のアップロード方法をご覧ください。
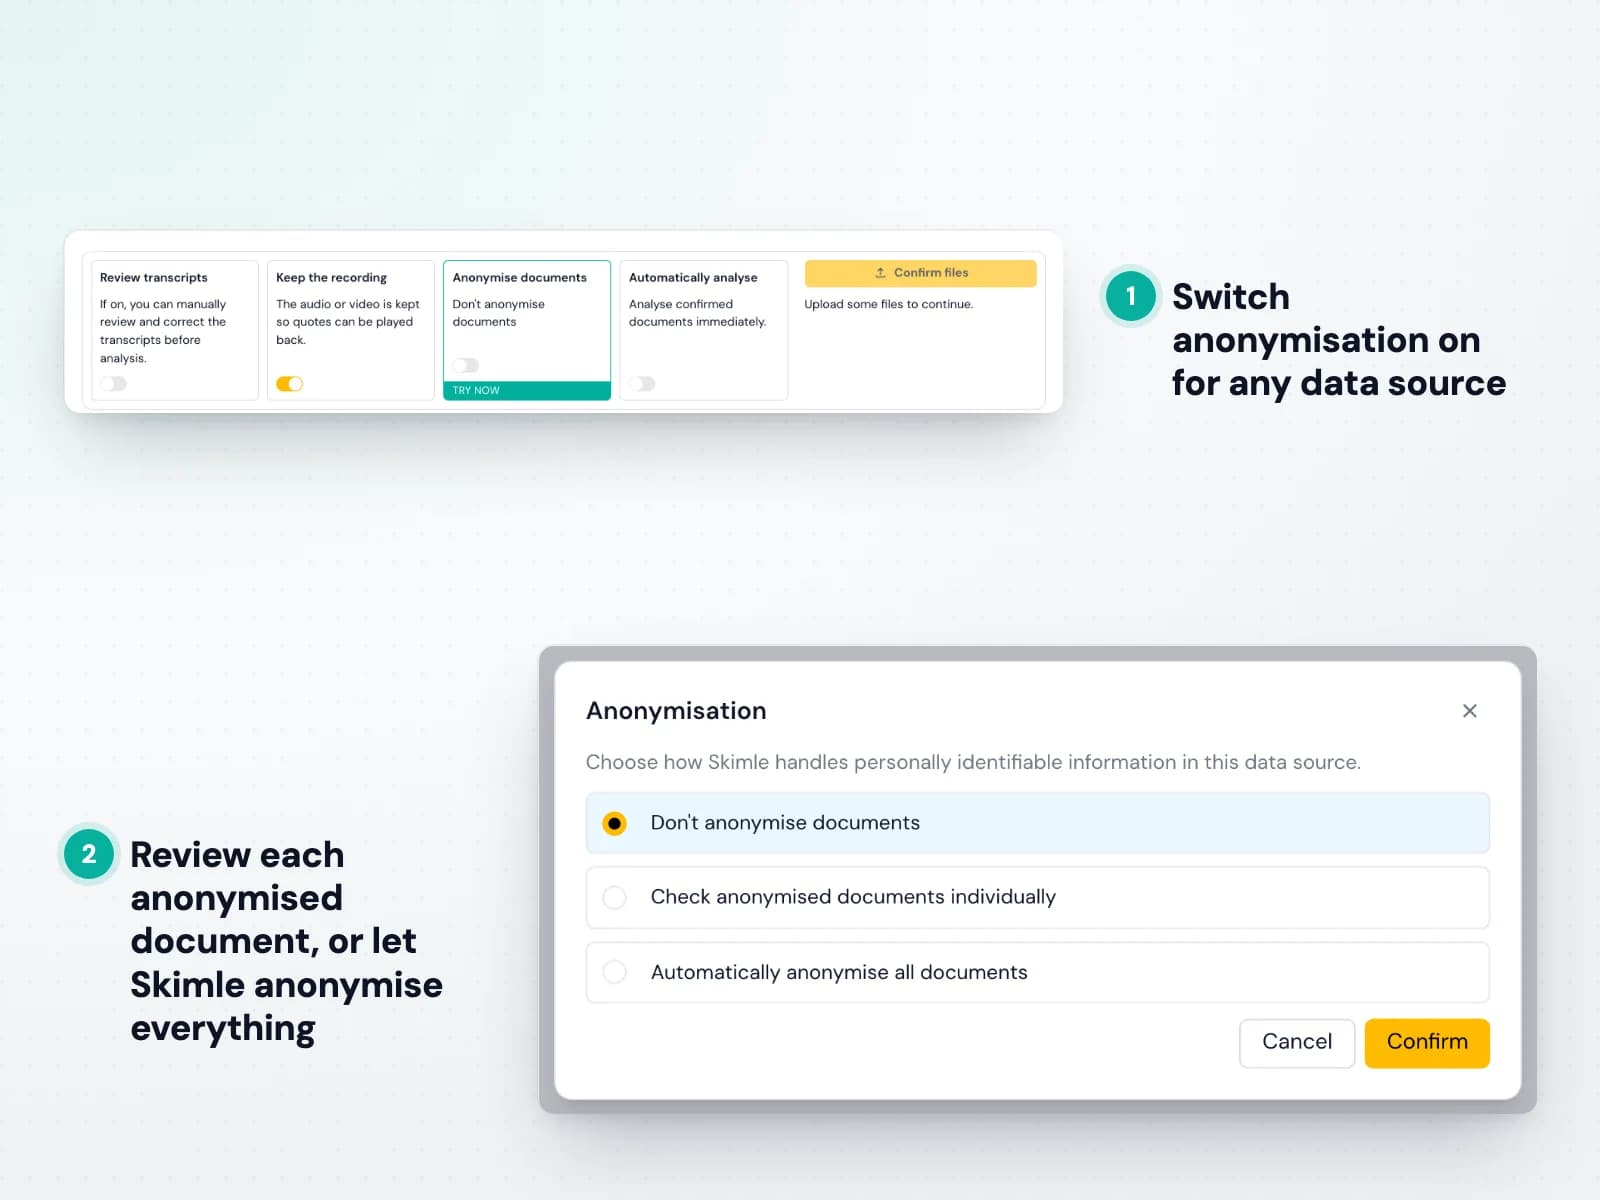
データソースごとに、分析の前に文字起こしを確認するか、各録音を再生用に残すか文字起こしの完了時に削除するか、そして最初にテキストを匿名化するかを選べます。
- MP3、M4A、WAV、MP4、MOV などの一般的な形式
- 話者の分離とタイムスタンプ
- 分析前の任意の手動確認
文書をアップロード
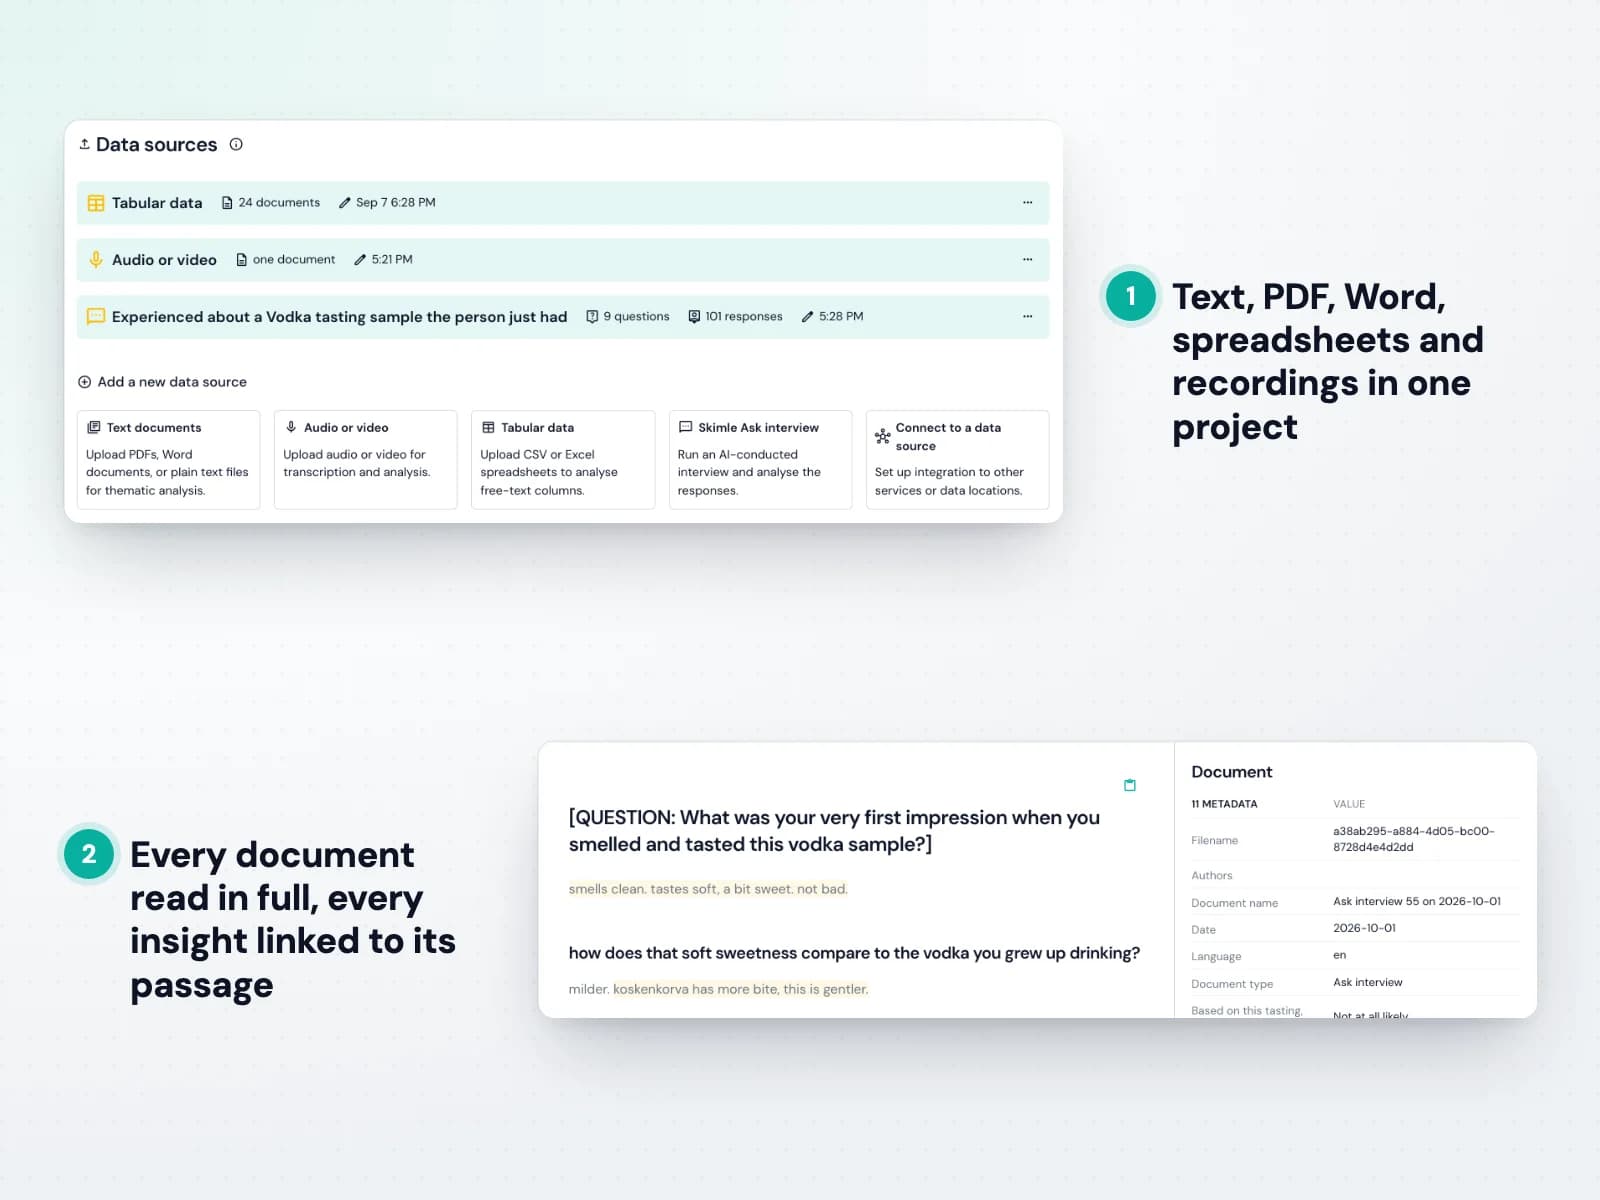
インタビューの文字起こし、報告書、記事、メモ、自由回答を、普段お使いの形式のまま取り込めます。1つのプロジェクトで言語を自由に混在させることもできます。対応形式をご覧ください。
Skimle はすべての文書を最後まで読み、各インサイトとその出典となる箇所とのつながりを保持します。そのため何も失われず、すべてを確認できます。
- PDF、Word(DOCX)、RTF、TXT
- 100以上の言語を1つのプロジェクトで混在可能
- すべてのインサイトが出典の箇所にリンク
データセットを取り込む
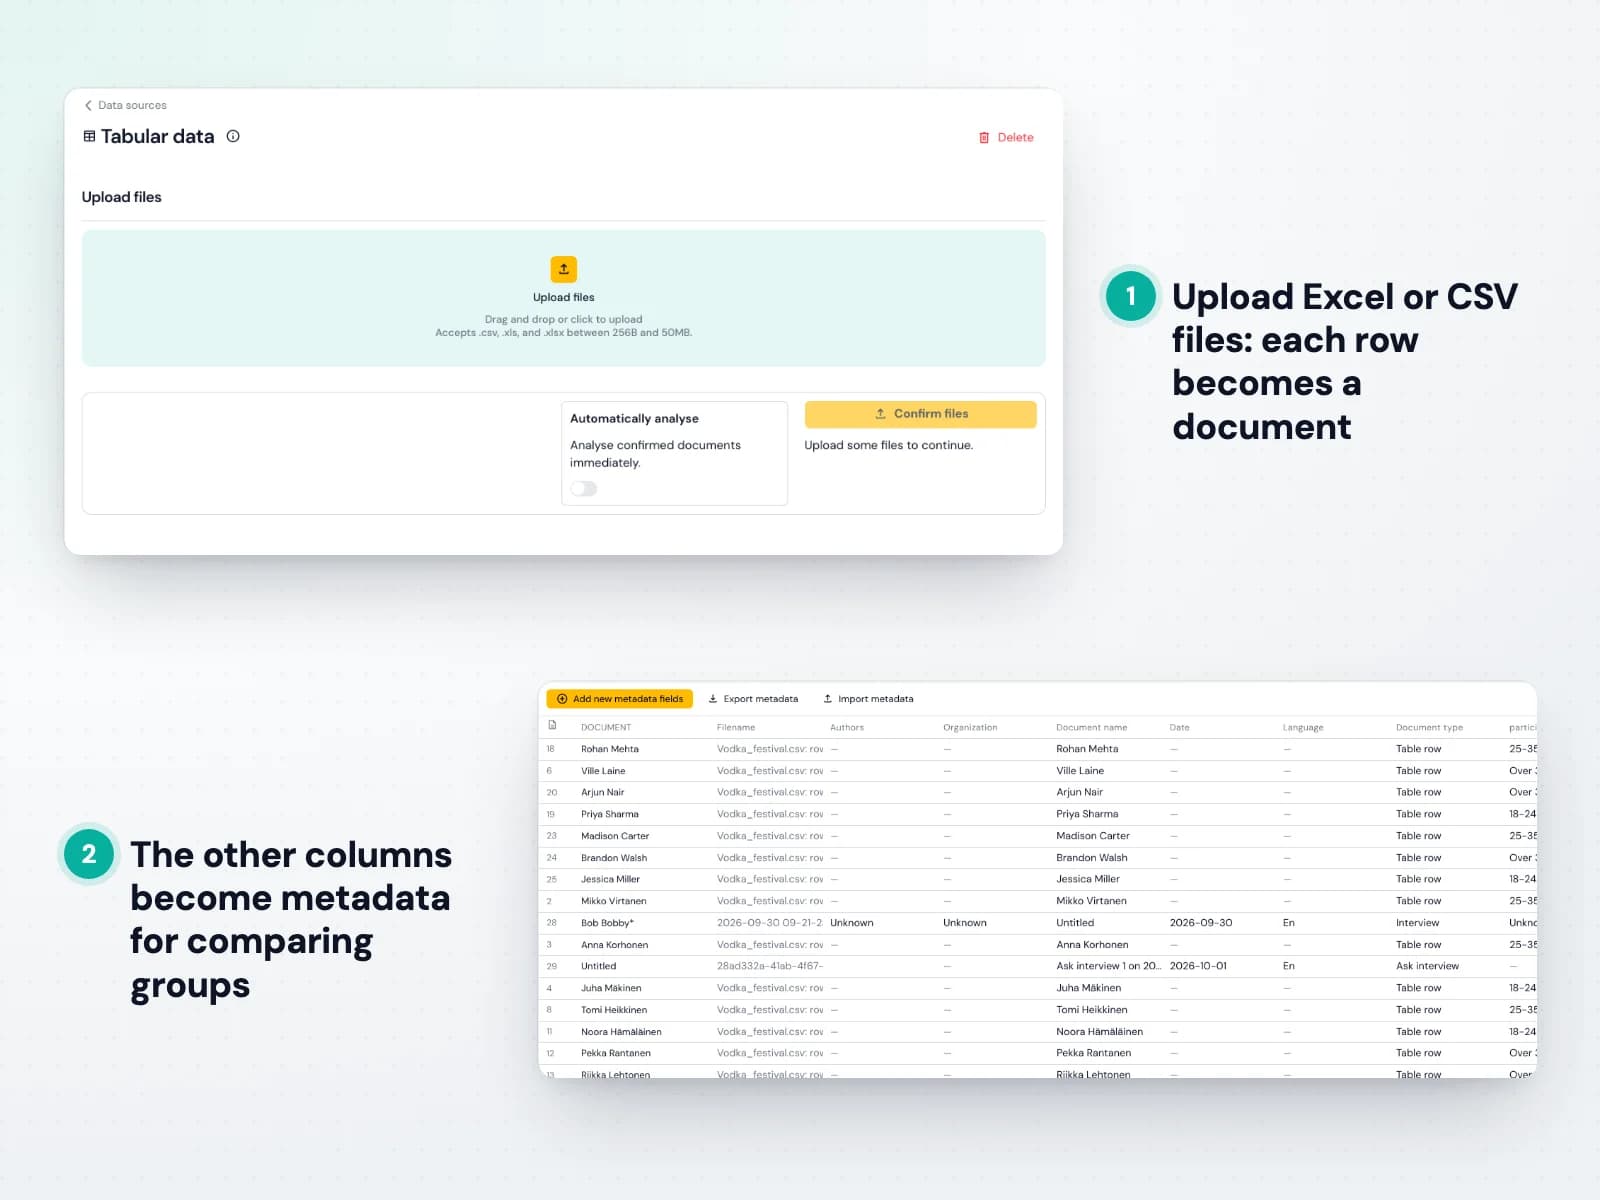
スプレッドシートやアンケートのエクスポートを一度に取り込めます。各行が1つの文書になり、各列を内容、メタデータ、無視のどれとして扱うかを選べます。データの取り込みとメタデータの追加方法をご覧ください。
メタデータは各回答とともに保持されるため、あとから新規顧客と既存顧客、ある地域とほかの地域など、回答者のグループごとの違いを比較できます。
- Excel と CSV の取り込み
- 内容の列とメタデータの列を選択
- 1プロジェクトで数千件の回答
Skimle Ask でインタビュー
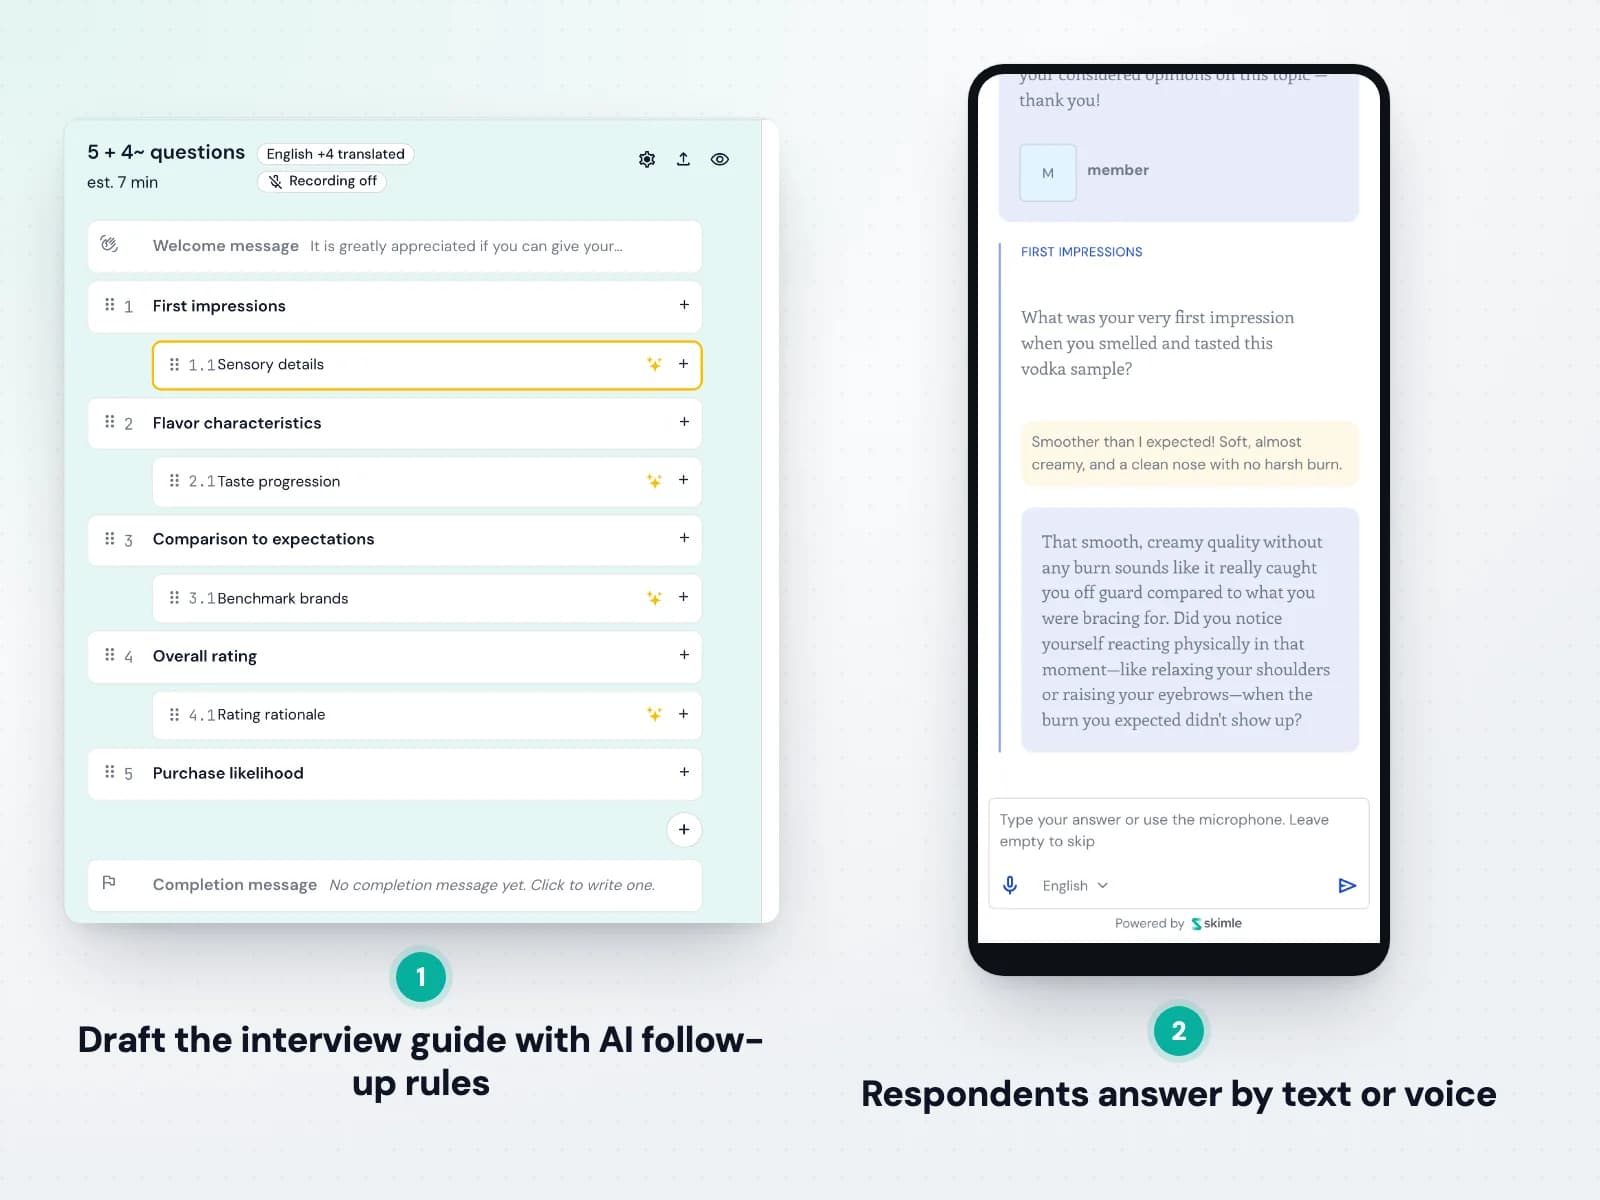
Skimle Ask は、アンケートの規模で質的インタビューを実施します。知りたいことを説明すると AI がインタビューガイドの下書きを作成し、各質問と追加質問の指示を細かく調整できます。Ask インタビューの作成方法をご覧ください。
回答者はリンクを開いてテキストか音声で答え、AI インタビュアーが熟練の研究者のように詳しく掘り下げます。完了したインタビューは、ほかのデータと一緒にそのまま分析に回ります。
- 自由回答式と選択式の質問
- 深さを調整できる AI の追加質問
- 複数言語でのインタビュー

ステップ2
データを分析して探索する
完全な透明性とコントロールを備えた厳密な分析エンジン、混合研究法のビュー、メタデータによる比較、AI リサーチアシスタント。
中核にあるのは厳密な分析
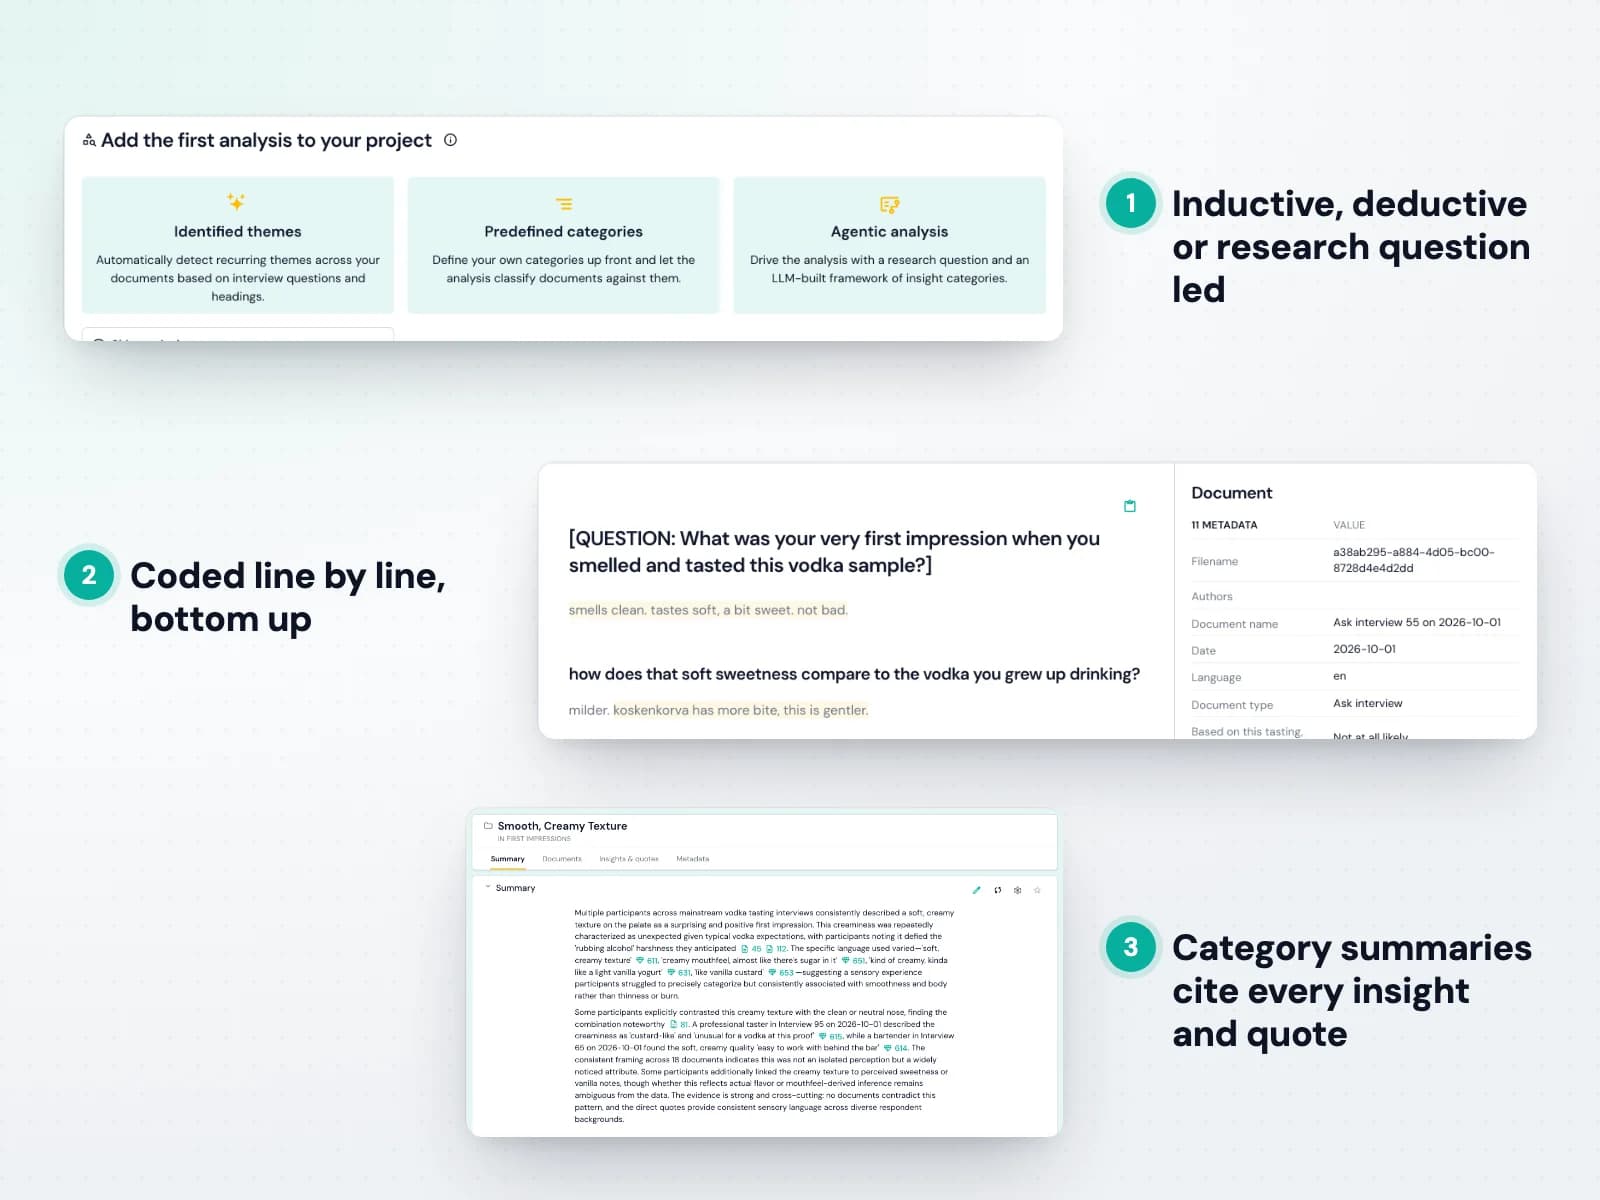
Skimle は要約するのではなく、確立された質的研究の手法に従います。すべての文書を最後まで読み、ボトムアップでインサイトを見つけ、それぞれが出典の引用にリンクしたカテゴリへと整理します。分析の仕組みをご覧ください。
データから構造を浮かび上がらせるテーマ抽出、独自のカテゴリ体系に沿ってコーディングする事前定義カテゴリ、リサーチクエスチョンが主導するエージェント分析から選べます。各カテゴリの要約は、根拠となるすべてのインサイトと引用を示します。
- 帰納的、演繹的、リサーチクエスチョン主導の分析
- すべてのインサイトが原文の引用にリンク
- 根拠を示す要約
完全なユーザーコントロールと透明性
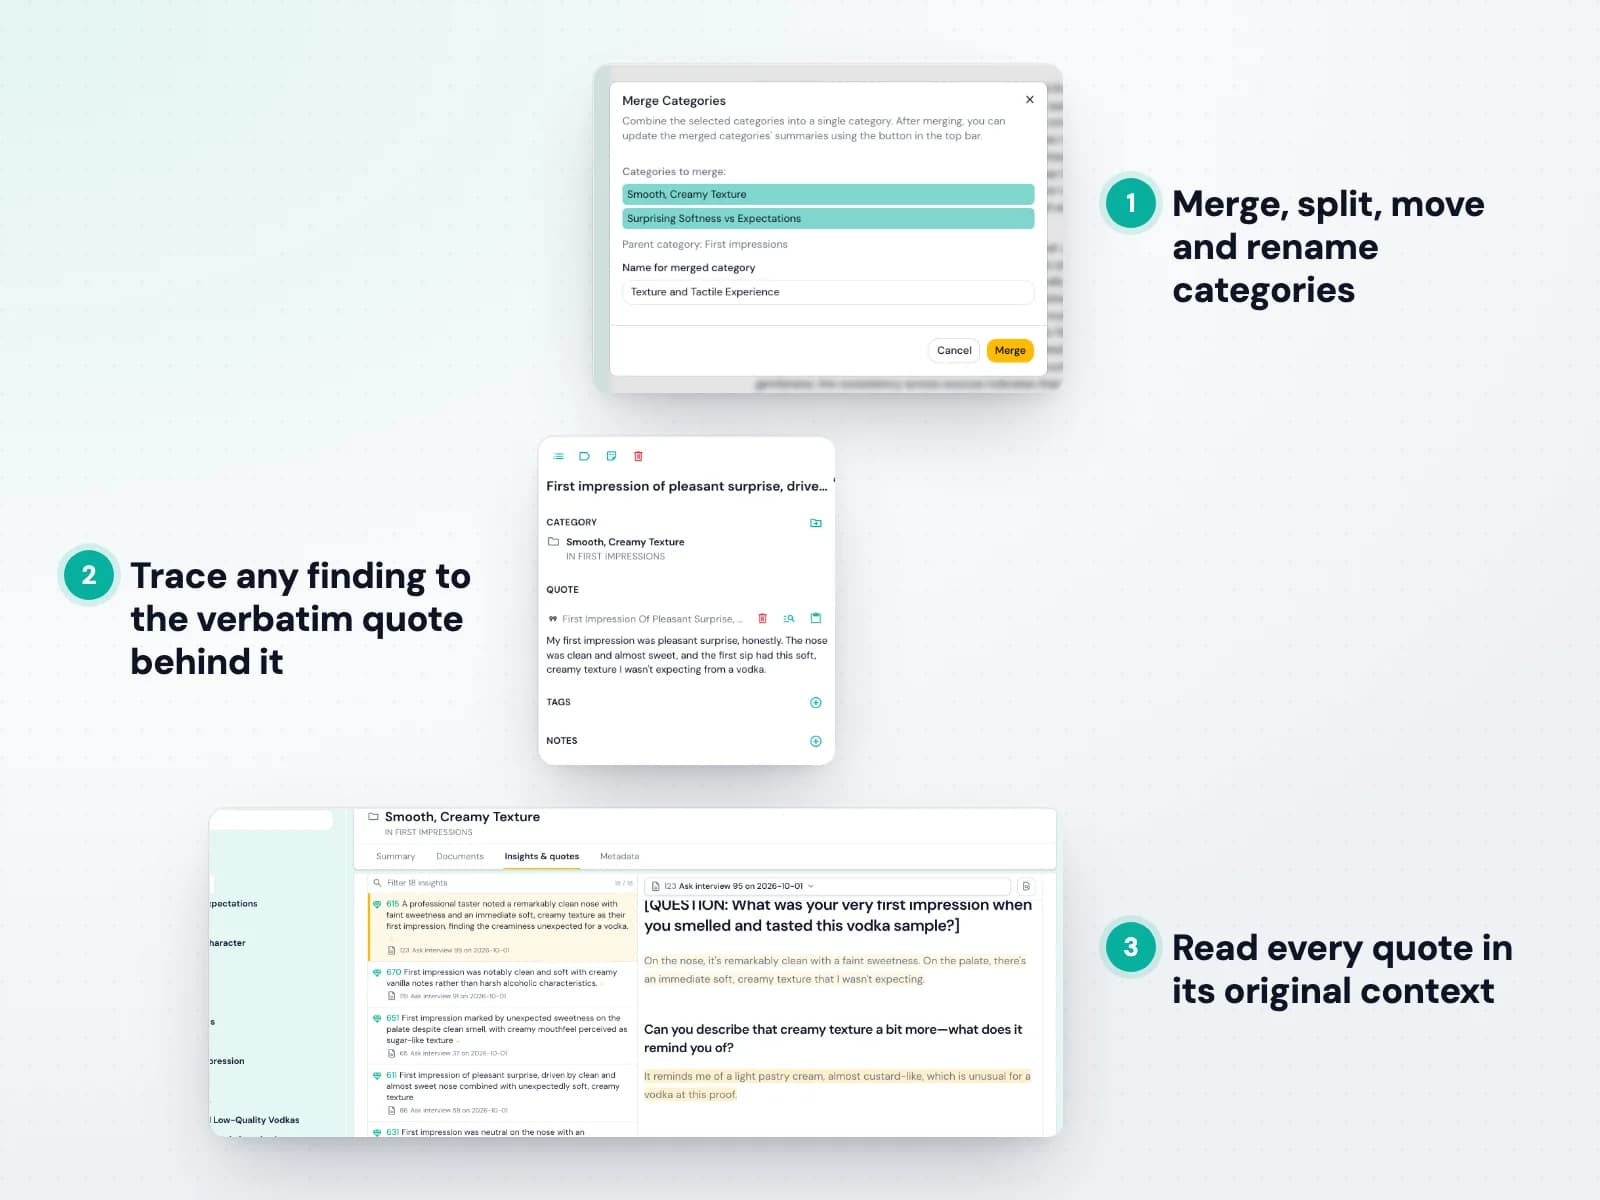
Skimle の双方向の透明性により、その作業をいつでも確認できます。要約内の出典をクリックすれば背後にあるインサイトと原文の引用を確認でき、文書を開けば何がコーディングされ何がされていないかを正確に確認できます。カテゴリの管理方法をご覧ください。
構造が考えと合わない場合は変更しましょう。重なり合うカテゴリを統合し、広すぎるカテゴリを分割し、自分の言葉で名前を変え、インサイトをカテゴリ間で移動できます。変更はすべて元に戻せます。
- カテゴリの統合、分割、移動、名前の変更
- 結果から出典へ、出典から結果へたどれる
- どの変更も元に戻せる
混合研究法でデータを可視化
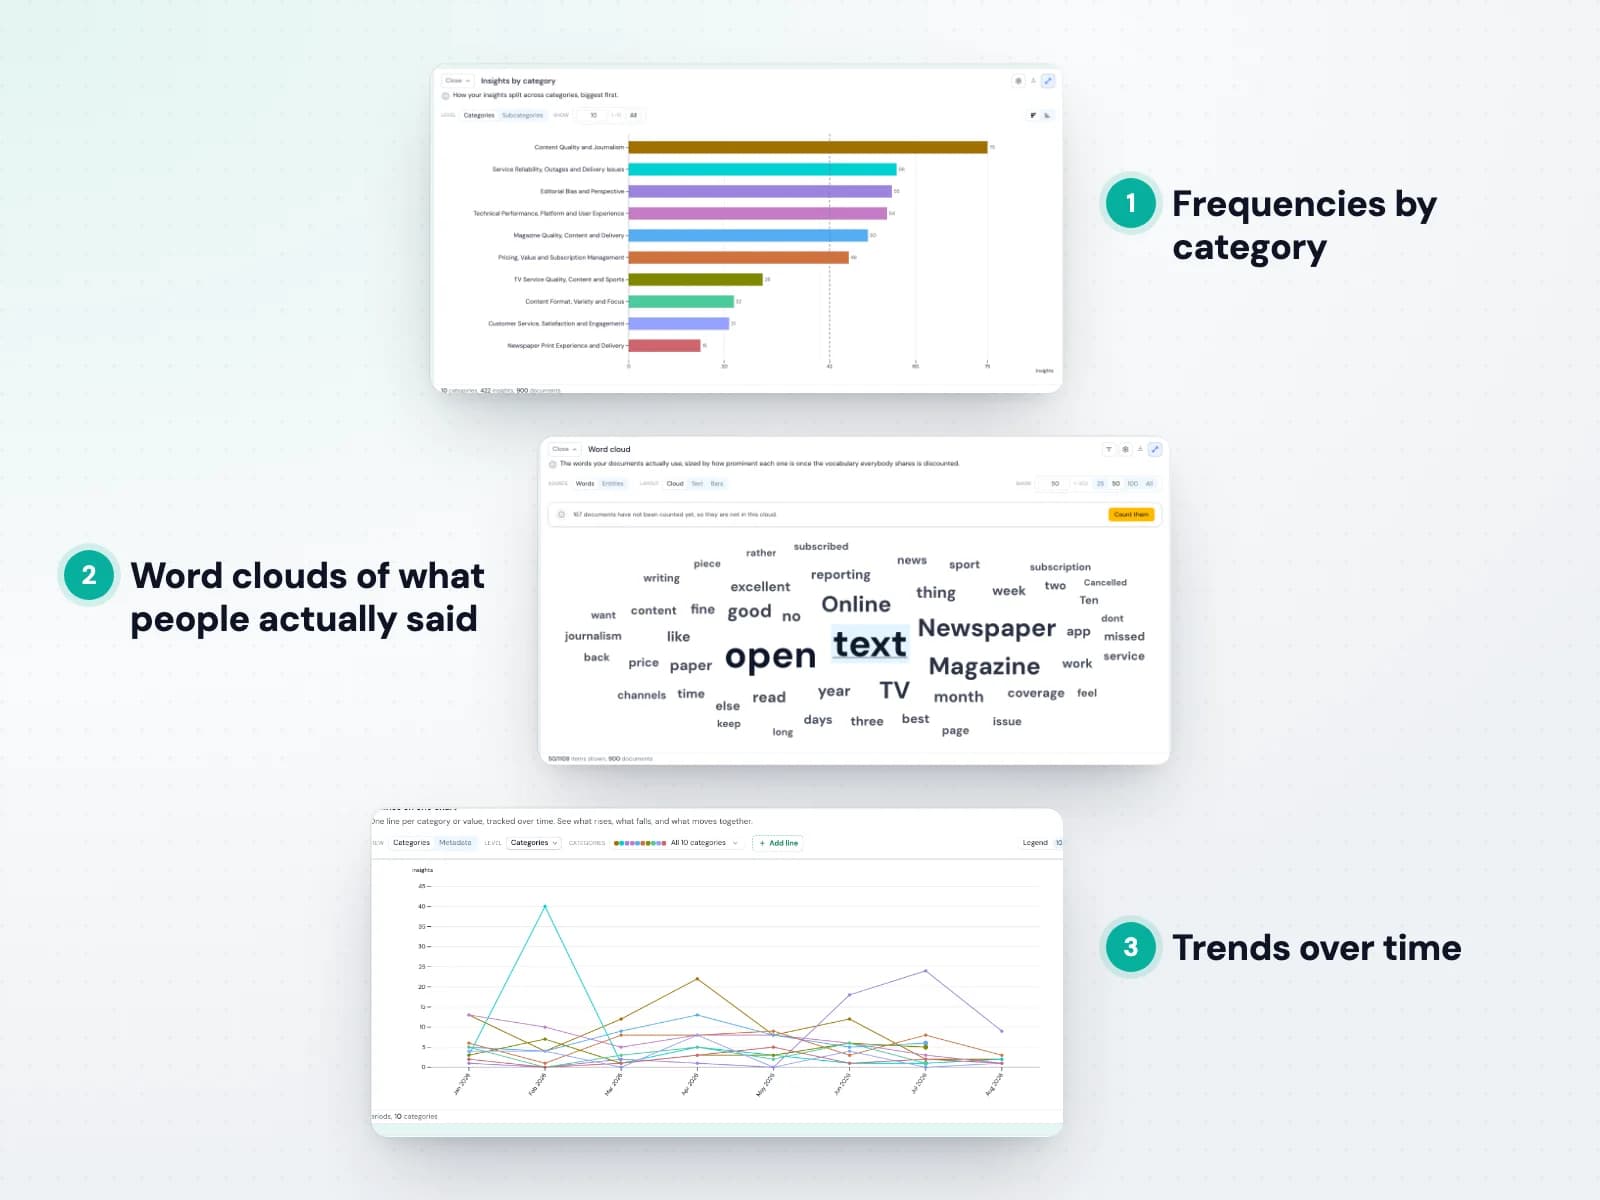
すべての集計が検証済みのインサイトに基づくため、コード化したデータを信頼できる数値に変えられます。カテゴリ別の頻度、ワードクラウド、文書横断のヒートマップ、時系列の傾向を確認できます。統計ビューをご覧ください。
構造を磨き上げるたびにビューも更新され、すべての棒グラフや点からその背後にあるインサイトと引用に移動できるので、数値とストーリーが常に一致します。
- 頻度、ワードクラウド、ヒートマップ
- 時系列の傾向
- すべての数値を引用までたどれる
メタデータでパターンを発見

メタデータで任意の2つの文書グループを比較すると、Skimle はそれぞれのグループがもう一方より多く取り上げているカテゴリを示します。さらに、グループを分けるものと共通するものを、引用付きで文章にまとめます。メタデータの分析方法をご覧ください。
どの切り口が重要かわからない場合も、Skimle がすべてのメタデータの切り口をグループ間の差の大きさで順位付けするため、ひとつずつ試さなくても報告に値する違いが見つかります。
- 文章の要約付きグループ比較
- すべての切り口を効果量で順位付け
- データ由来または AI が推定したメタデータ
リサーチアシスタントとしてのエージェント型チャット
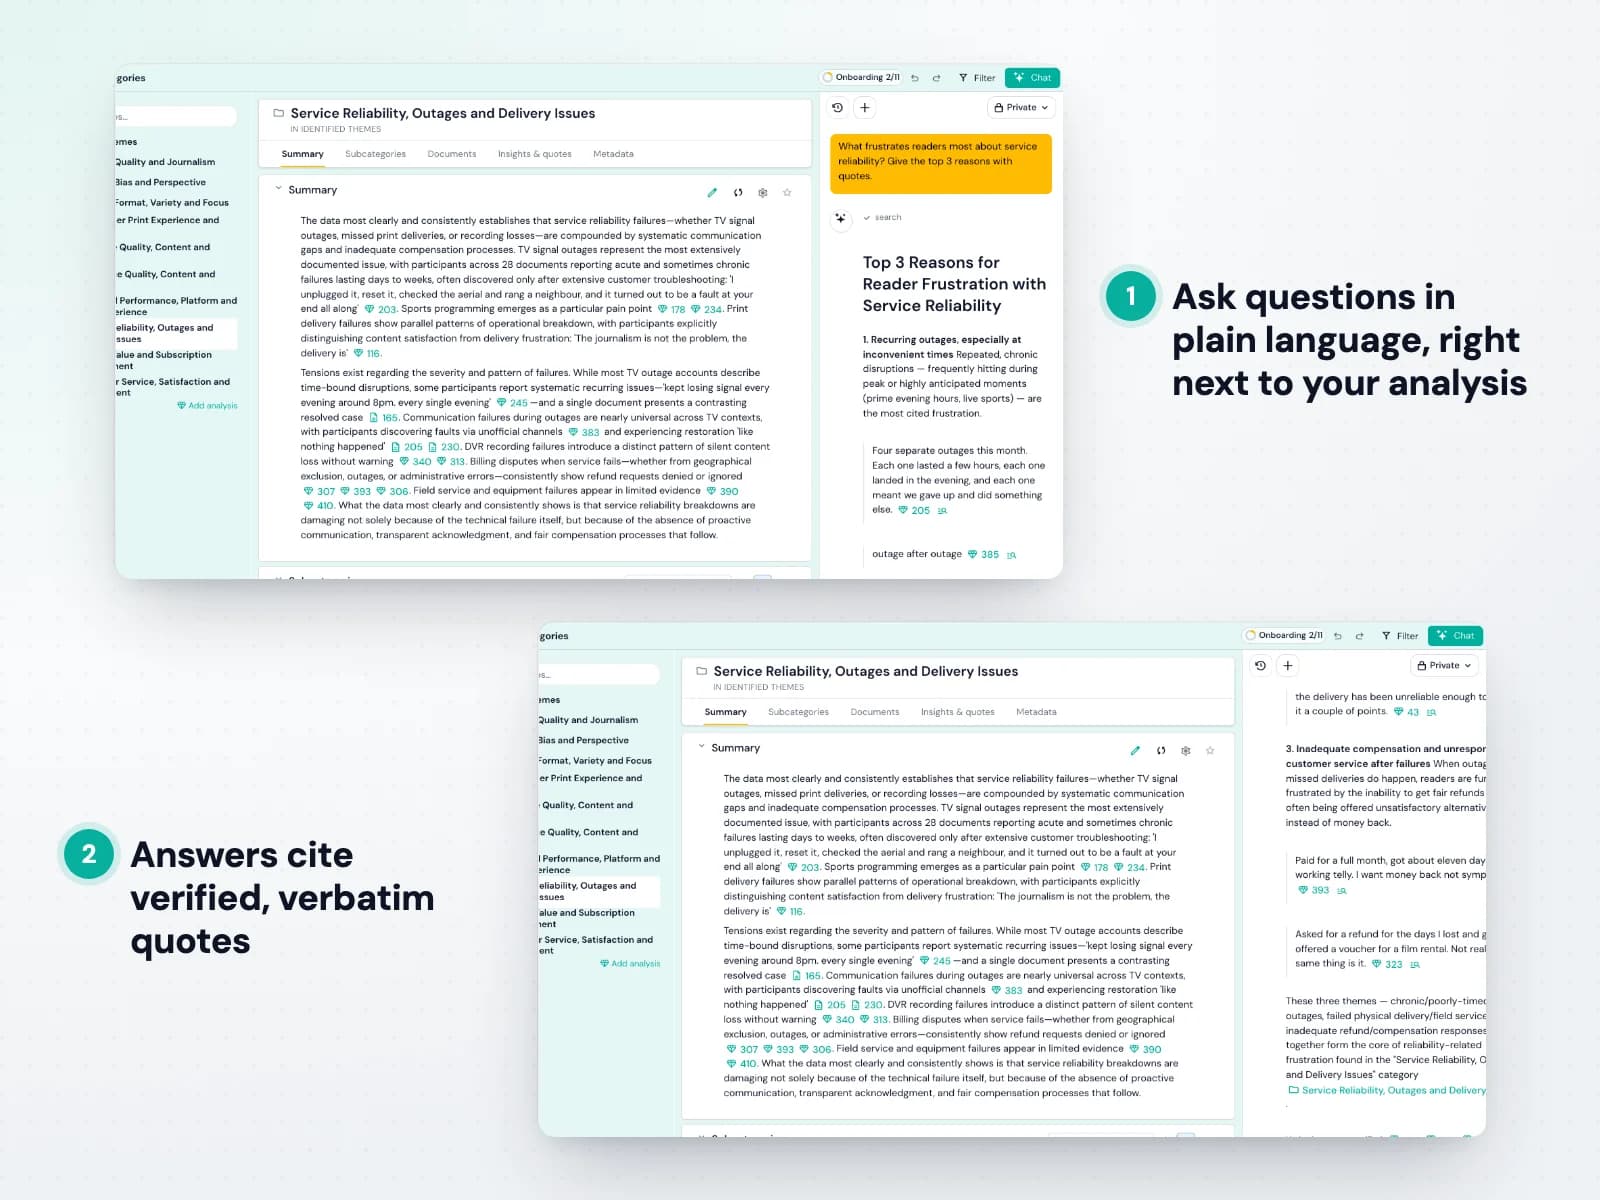
リサーチアシスタントは生の文書ではなく、構造化された分析の上で動作します。普段の言葉で質問すると、コード化されたインサイトを検索し、たどれる手順で推論し、検証済みの逐語引用を添えて回答します。AI チャットの使い方をご覧ください。
分析を操作することもできます。インサイトの作成、カテゴリの再編成、メモの追加を、あなたが使うのと同じコマンドで行うため、すべての変更が見える形で残り、元に戻せます。
- 検証済みの引用に基づく回答
- コード化されたすべてのインサイトを検索
- 分析の再編成とメモの追加が可能
ステップ3
エクスポートして連携する
結果をプレゼンテーションやレポートとして共有し、普段使っているツールへエクスポートし、自社のシステムや AI エージェントと接続できます。
説得力のあるプレゼンテーション
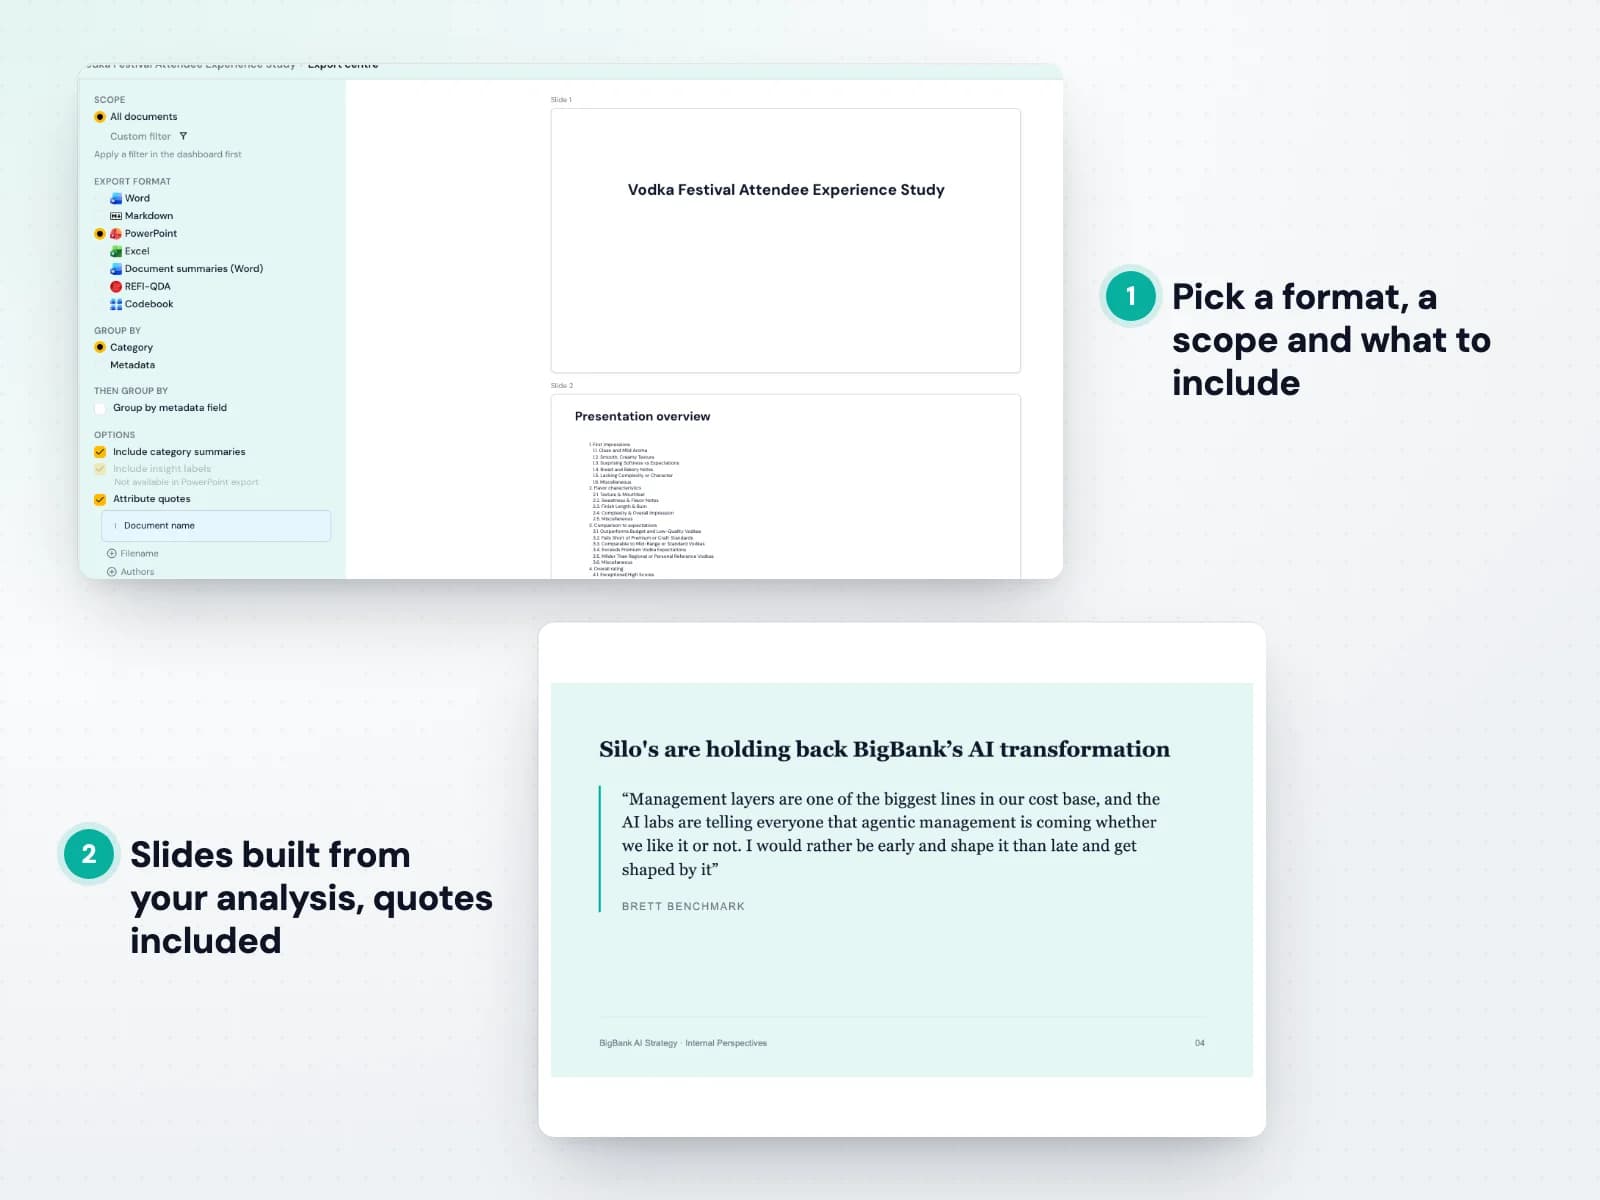
分析を PowerPoint のプレゼンテーションや Word のレポートとして書き出せます。範囲を選び、結果をカテゴリやメタデータでグループ化し、要約、出典、出典付き引用を含めるかどうかを決めます。Office への書き出し方法をご覧ください。
出力はそのままレポートやプレゼンテーションの出発点になります。テーマ、根拠、引用がそろっており、それぞれを分析までたどれます。
- PowerPoint のプレゼンテーションと Word のレポート
- 要約、出典、出典付き引用
- 範囲とグループ化を自由に選択
API と MCP コネクター
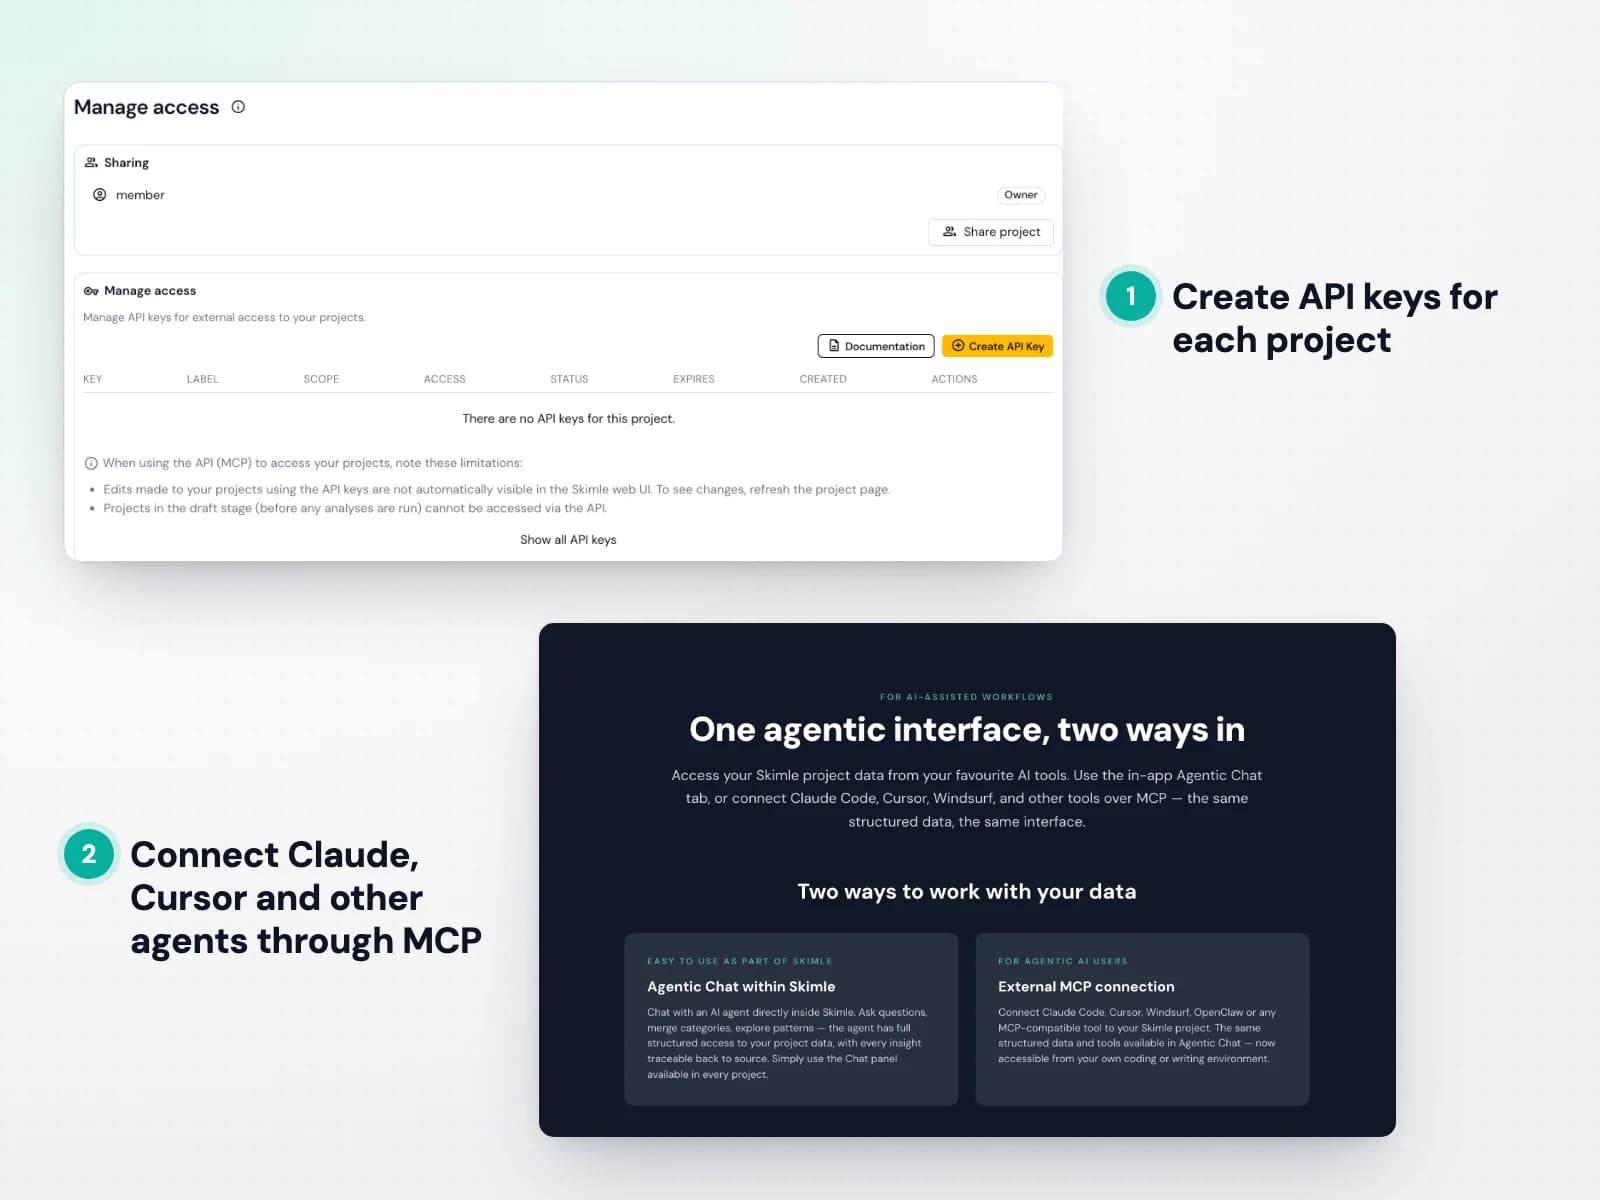
Skimle の MCP サーバーを使うと、Claude、Cursor、Windsurf などの対応エージェントが、アプリ内のエージェントと同じツールで構造化されたプロジェクトデータを扱えます。MCP での接続について詳しくはこちら。
REST API を使えば、自社のシステムからプロジェクトデータを読み書きしたり、プロジェクトを最初から最後まで実行したりできます。プロジェクトのアクセス設定で、プロジェクトごとに閲覧用または編集用の API キーを作成します。
- Claude、Cursor などのエージェント向け MCP
- プロジェクトデータを読み書きする REST API
- プロジェクト単位の API キー
データの書き出し
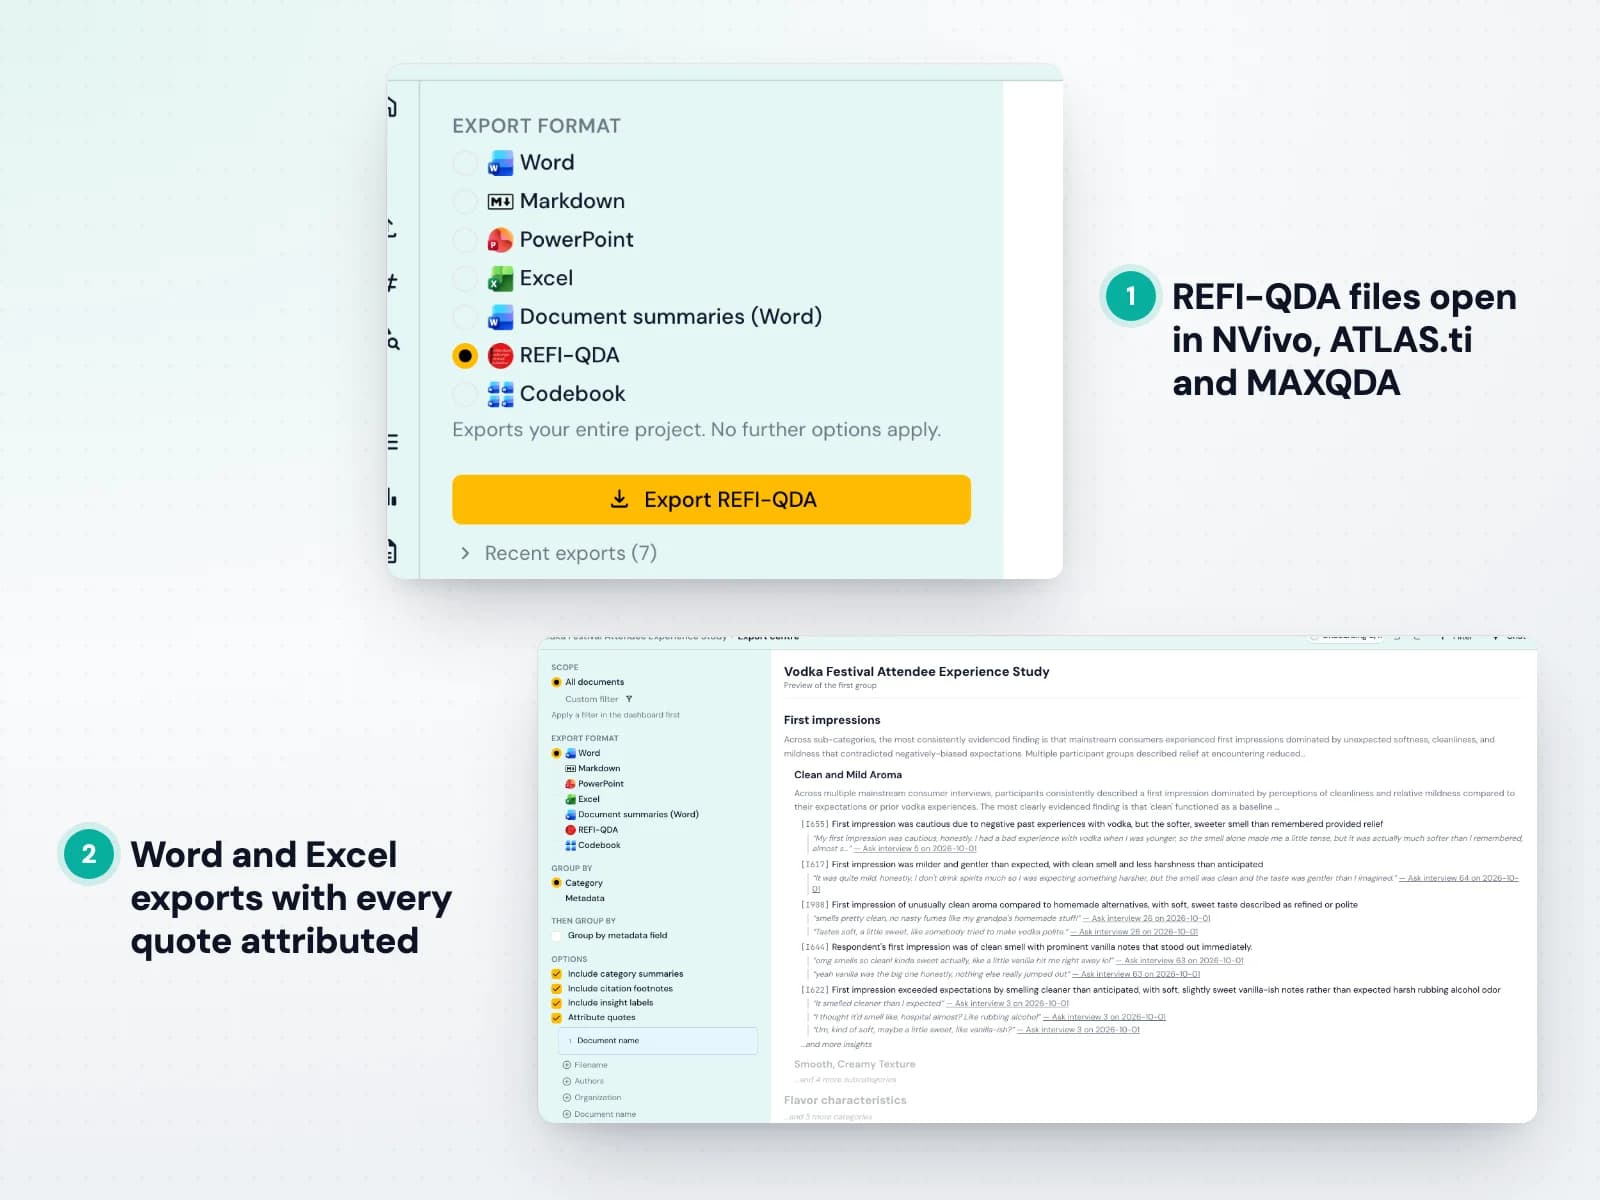
分析を必要な場所へ持ち出せます。Skimle の表全体には Excel、コーディングをコメントとして表示する Word、そして NVivo、ATLAS.ti、MAXQDA 向けのオープンな REFI-QDA 形式があります。REFI-QDA への書き出し方法をご覧ください。
カテゴリ体系を書き出したり、分析全体のコピーを研究データと一緒に保管したり、従来のツールで手作業のコーディングを続けたりできます。
- Excel、Word、REFI-QDA(.qdpx)
- カテゴリ体系の書き出し
- NVivo、ATLAS.ti、MAXQDA に対応
プラットフォーム
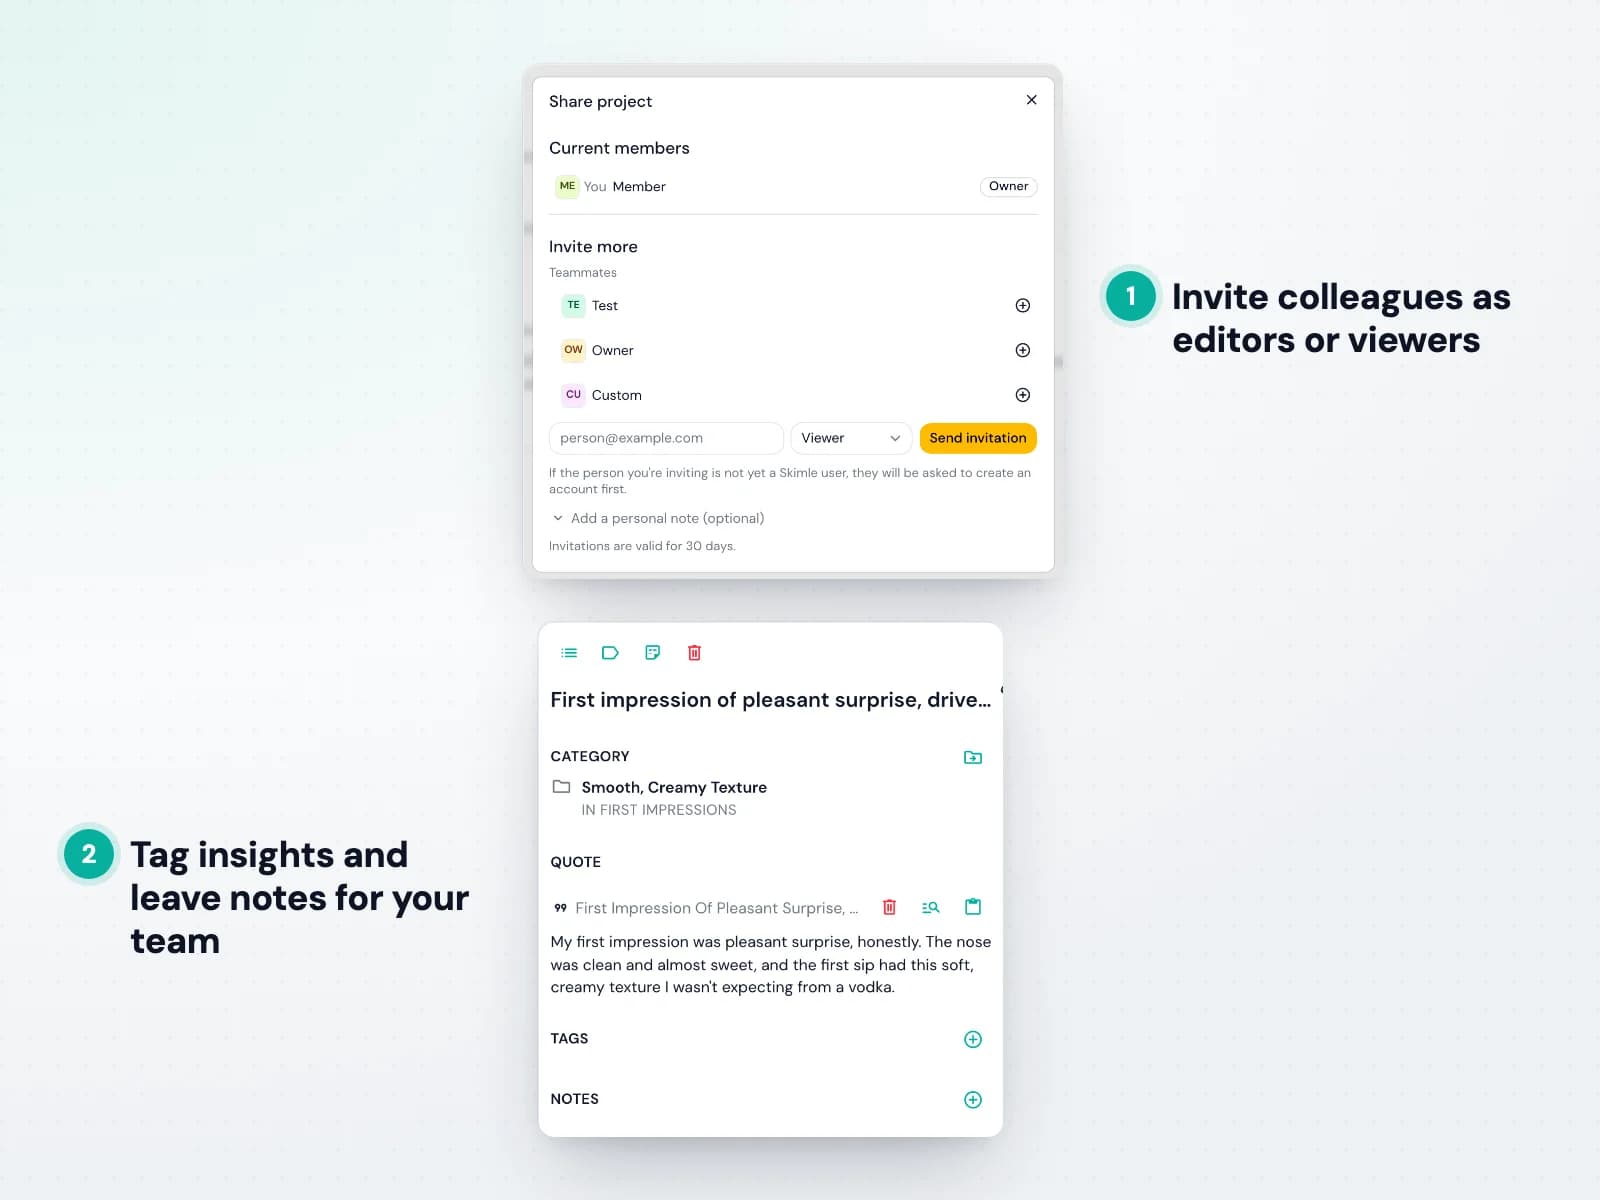
共同作業のための安全なプラットフォーム
企業レベルのデータ保護のもと、チーム全員で1つの分析に取り組めます。
安全なプラットフォーム
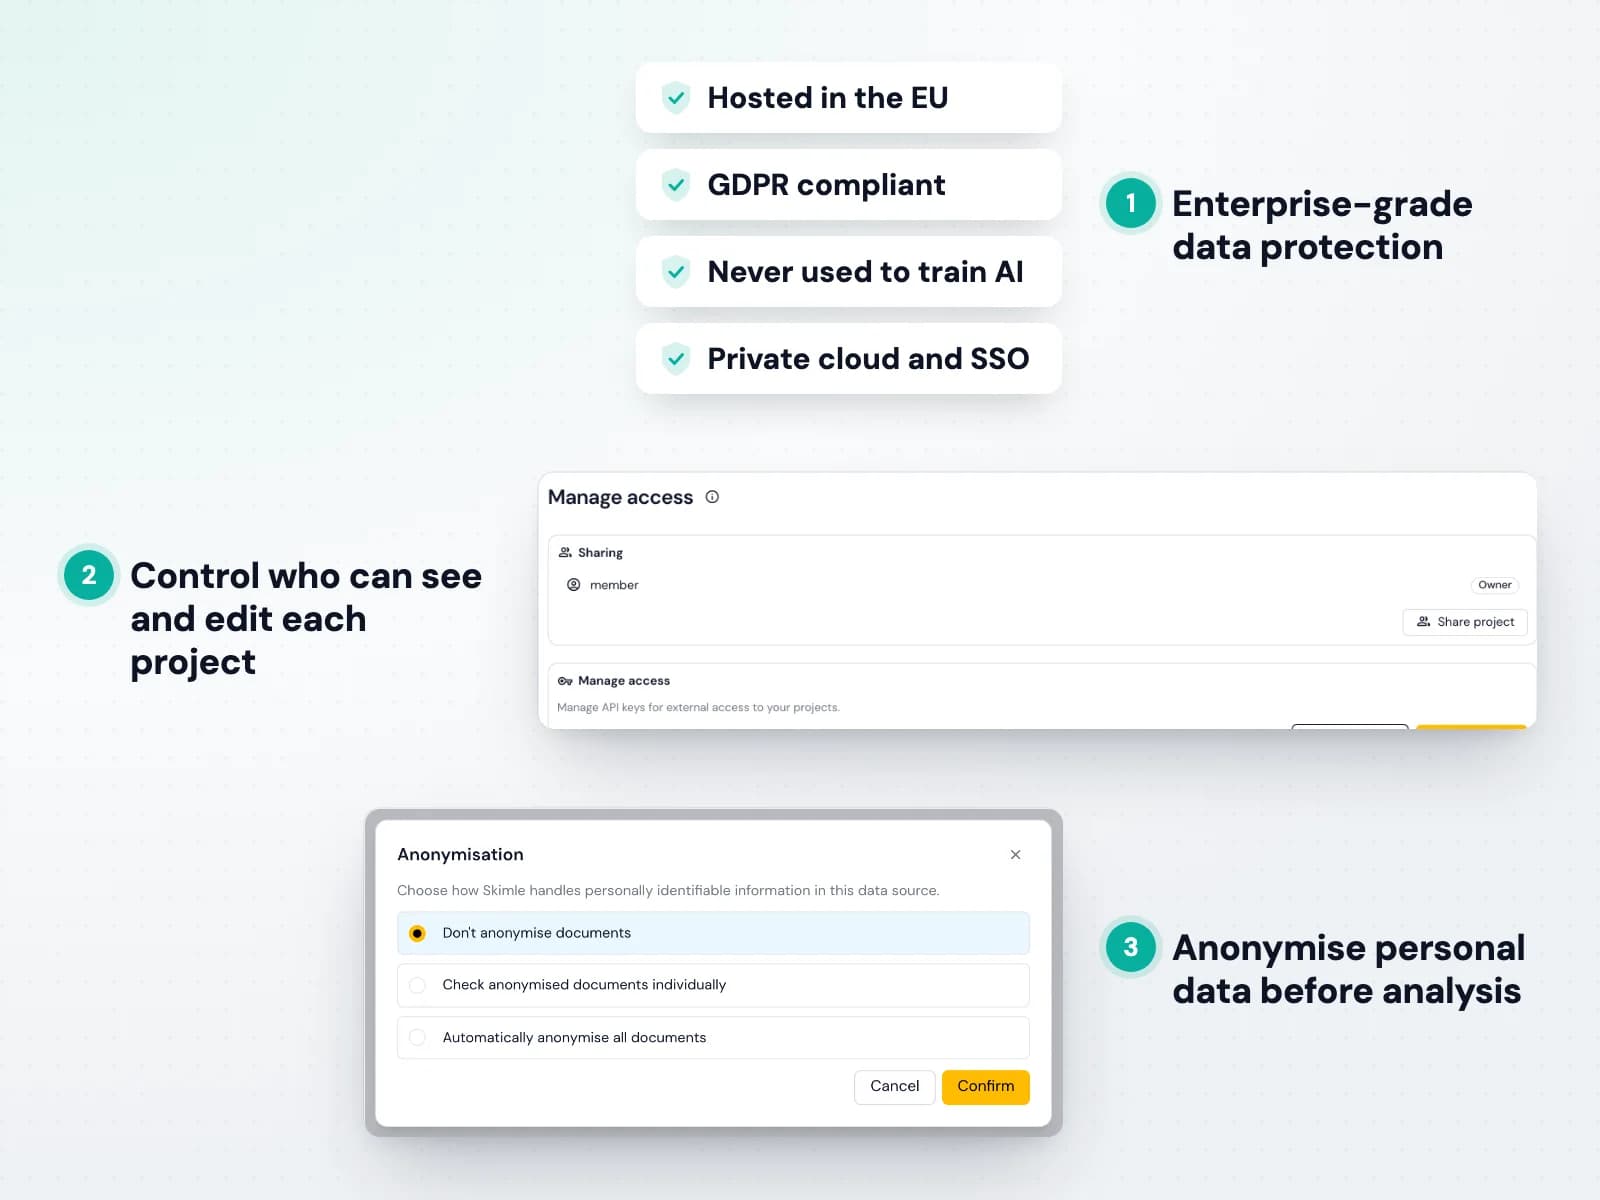
Skimle は機密性の高い研究のために作られています。すべてのデータは EU でホストされ、通信時も保存時も暗号化され、AI モデルの学習には一切使われません。プライバシーポリシーをお読みください。
各プロジェクトを誰が閲覧・編集できるかはあなたが決め、個人データは分析前に匿名化でき、データ処理契約もご用意しています。企業のお客様はプライベートクラウドでの導入やシングルサインオンも選べます。
- EU でのホスティングと GDPR 準拠
- AI モデルの学習には一切使用しない
- 企業向けのプライベートクラウドと SSO
Skimle とほかの手法の比較
手作業のツールは厳密ですが時間がかかり、汎用の AI は速いものの検証できず、業界特化型のツールは1つの用途向けで高価です。厳密な分析エンジン、完全な透明性、汎用性を、1ユーザーあたり月額20ユーロからの価格で兼ね備えているのは Skimle だけです。
| 手作業のツール NVivo、MAXQDA、ATLAS.ti… | 汎用の AI ツール ChatGPT、Claude… | 業界特化型のツール CoLoop、Listen Labs… | Skimle | |
|---|---|---|---|---|
| 厳密な分析エンジン |  | | | |
| 要約から出典までの双方向の透明性 | | | | |
| データの種類や用途を問わない汎用性 | | | | |
| スピード | | | | |
| 習得のしやすさ | | | | |
| 価格 | 1ユーザーあたり月額約80ユーロ | 1ユーザーあたり月額約20ユーロ | 月額400ユーロ以上 | 月額20ユーロから、無料トライアルあり |
| 規模 | 手作業のコーディング量に左右される | コンテキストに限りがあり、網羅性を検証できない | ツールによる | 1プロジェクトで数千件の文書 |
| GDPR とデータセキュリティ | 導入形態による | プランと設定による | ベンダーによる | 標準対応 · EU 内のサーバー · データ処理契約あり |
| 総評 | 論文レベルの厳密さだが、プロジェクトごとに数週間の手作業のコーディングが必要。 | 速いが、回答はプロンプト次第で変わり、追跡も説明もできない。 | 1つのワークフロー向けにつくられ、多くは企業向けの価格。 | AI のスピードで学術レベルの厳密さを、完全な透明性とともに。あらゆる質的データに対応。 |
よくある質問
よくある質問
- Skimle とは何ですか?
- Skimle は、インタビュー、報告書、パブリックコメント、顧客の声といった非構造化の文書を、完全に追跡できる整理された分析可能なデータセットへと体系的に構造化する、AI を活用した質的データ分析プラットフォームです。チャットボットとは異なり、Skimle は文書群全体を最初に処理してインサイトを抽出し、すべての発見が検証済みの原文の引用に結びついた階層的なテーマに整理します。
- Skimle は ChatGPT や RAG ベースのツールと何が違いますか?
- RAG ツールは質問のたびに関連する一節を検索するため、同じ質問をしても毎回違う答えが返ってきます。Skimle はデータセット全体を最初に体系的に分析し、すべてのテーマが検証済みの引用に結びついた安定した構造をつくります。ブラックボックスの回答ではなく、網羅的なカバー範囲、一貫した結果、完全な追跡可能性が得られます。
- Skimle は NVivo、MAXQDA、ATLAS.ti と何が違いますか?
- 従来のツールでは、すべての箇所を手作業でコーディングする必要があります。体系的ではあるものの、数週間から数か月かかります。Skimle は同じ体系的で透明な方法論を保ちながら、AI でコーディングを自動化します。NVivo 並みの厳密さをわずかな時間で実現でき、数週間の研修が不要な、より直感的なクラウドネイティブの画面で使えます。
- Skimle を学術研究に使えますか?
- はい。Skimle は学術研究者がつくったツールで、テーマ分析(Braun & Clarke)、グラウンデッド・セオリー(Glaser & Strauss; Strauss & Corbin)、Gioia メソッド(Gioia, Corley & Hamilton)といった確立された方法論に基づいています。Skimle の完全な監査証跡でテーマの導き方を文書として正確に記録でき、査読の要件を満たせます。現在30以上の大学の研究者が Skimle を利用しており、ご要望に応じて推奨する引用表記もお知らせします。
- Skimle はどの言語とファイル形式に対応していますか?
- Skimle は100以上の言語に対応し、PDF、Word(.docx)、RTF、TXT、CSV、音声(MP3、M4A、WAV)、動画(MP4、MOV)のファイルを扱えます。1つのプロジェクトで形式や言語を混在させることができ、英語のインタビュー、ドイツ語のレポート、スペイン語のアンケート回答をまとめてアップロードできます。音声と動画は自動で文字起こしされます。
- Skimle は GDPR に準拠していて安全ですか?
- はい。すべてのデータは欧州連合内に保存され、EU のサーバーの外に出ることはありません。Skimle は GDPR に完全に準拠しており、機関のお客様にはデータ処理契約をご用意しています。お客様の文書が AI モデルの学習に使われることは一切ありません。データ主権に関する要件がより厳しい企業のお客様には、シングルテナントのクラウド環境もご用意しています。
- AI のハルシネーションはどのように防いでいますか?
- Skimle が生成するインサイトはすべて元の文書と照合して検証されます。データに一字一句同じ形で存在しない文章を AI が生成した場合、システムがそれを検出して再処理します。双方向の透明性により、どのテーマをクリックしても裏付けとなる正確な引用を確認でき、どの文書を開いてもコーディングされた部分とされていない部分を確認できます。そのため、何かが捏造されたり見落とされたりすることはありません。
- 最初の結果はどのくらいで得られますか?
- ほとんどのプロジェクトは数分で処理が終わります。1000件を超える文書を含む大規模なデータセットでは、もう少し時間がかかることがあります。インタビューの文字起こし10件から20件程度の一般的なセットであれば、通常1時間以内に処理されます。アップロードして分析を始めれば、裏付けとなる引用付きの構造化されたテーマをその日のうちに確認できます。設定や研修は必要ありません。
- Skimle を使うには技術的なスキルが必要ですか?
- いいえ。Skimle はエンジニアではなく、質的研究者、アナリスト、コンサルタントのために設計されています。文書をアップロードしてリサーチクエスチョンを入力すれば、あとは Skimle が処理します。カテゴリの編集、テーマの探索、レポートのエクスポートはすべてクリック操作で行えます。プログラミングやスクリプト、AI の専門知識は不要です。
- 料金の仕組みは?本当に無料トライアルがありますか?
- はい。Skimle には200クレジット付きの無料トライアルがあり(文書約200から300ページ分)、クレジットカードは不要です。有料プランは個人の年間契約で月額20ユーロから(月払いの場合は25ユーロ)、ヘビーユーザー向けの上位プランもあります。利用量のカスタマイズ、SSO、シングルテナントでの導入に対応した組織向けプランや企業向けプランは、ご要望に応じて提供しています。
- 分析できる文書の上限は何件ですか?
- Skimle は1つのプロジェクトで数千件の文書に対応しています。これは手作業で扱える量をはるかに超えており、10件の詳細なインタビューから1000件を超えるアンケートの自由回答まで、ほとんどの業務用途をカバーします。特に大規模なデータセットがある場合や継続的な分析が必要な場合は、お気軽にご相談ください。
プロフェッショナルによる、プロフェッショナルのためのツール
Skimle は、50以上の大学、政府機関、エージェンシー、企業で1,500人を超えるユーザーに満足して使われています。すべてのデータは EU 域内に保存され、当社の厳格な規定に従って処理されます。詳しくは次をご覧ください: GDPR ポリシー および 利用規約.
さらに詳しく知りたい方は、 Signal & Noise ブログ、 よくある質問、業種別の活用例をご覧ください。製品のデモや、Skimle がお客様のニーズにどう合うかのご相談も喜んで承ります。 Skimle を運営する会社について詳しく読む