探究心のあるプロフェッショナルのための質的分析

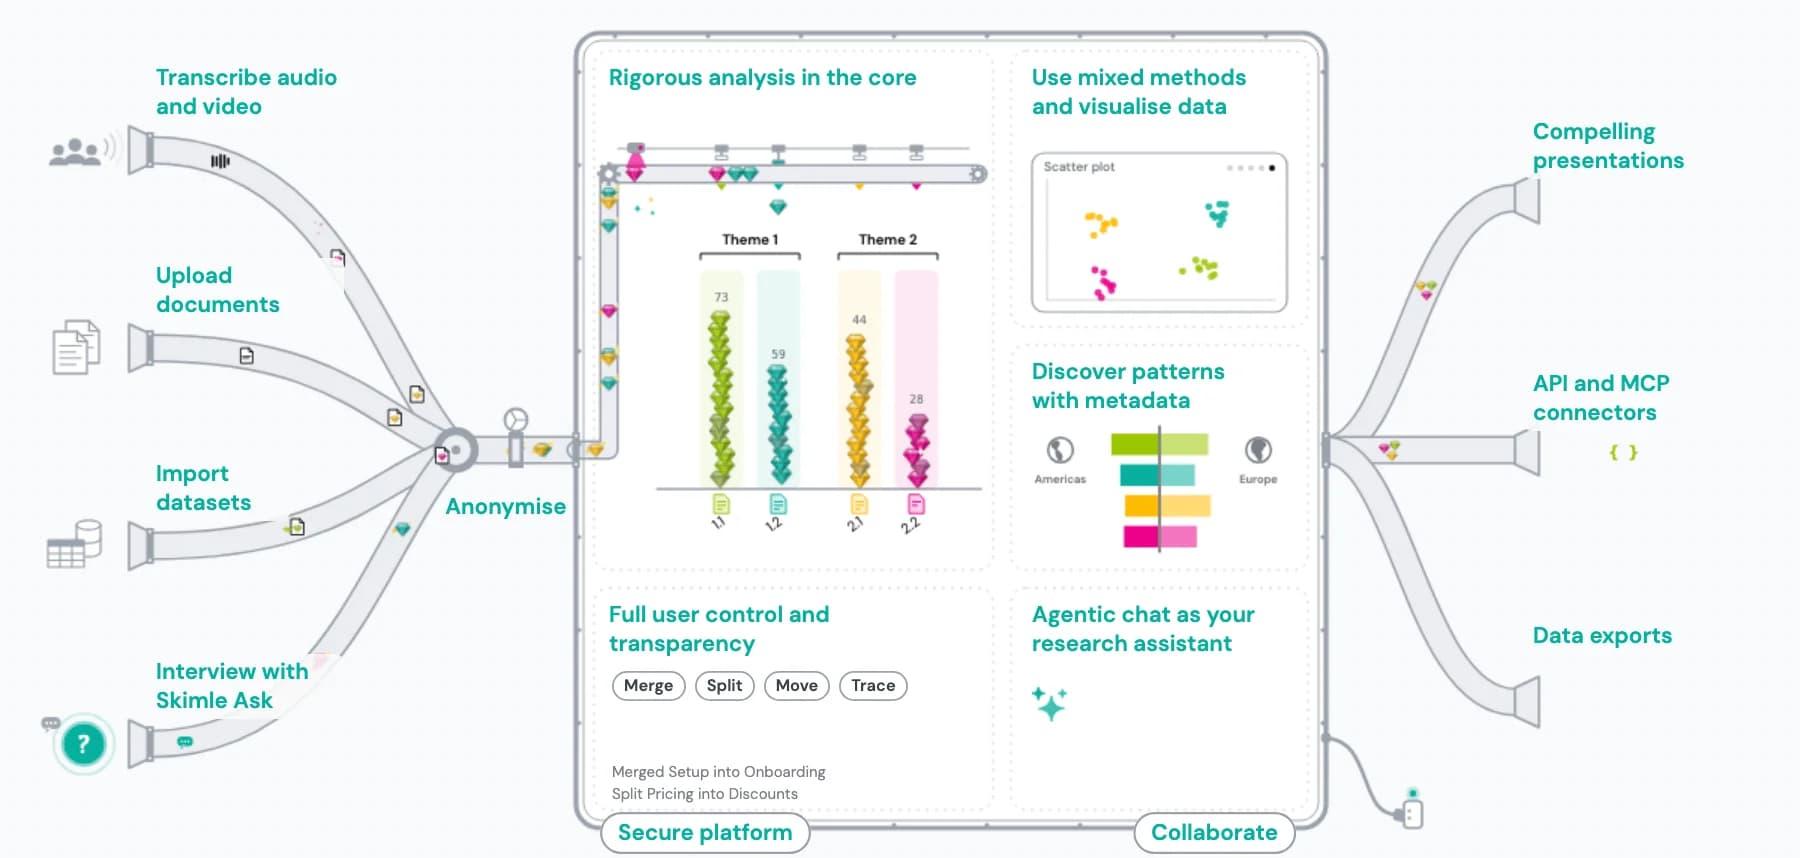
中核にあるのは厳密な質的分析
40年以上にわたる学術研究と実務での質的分析の経験を凝縮した、ボトムアップで実績のある分析ワークフロー。
多用途なワークスペース
音声、動画、テキストなどあらゆる質的データを組み合わせ、匿名化し、混合研究法で可視化し、プレゼンテーションを作成して、人とも AI とも共有できます。
双方向の透明性とコントロール
すべてのコード、カテゴリ、要約は編集でき、元のテキストまでたどれるので、専門家が自らの判断を反映できます。
Skimle Ask
これまで研究者は、量的研究の規模と、質的研究がもたらすインサイトの豊かさのどちらかを選ばなければならないことがよくありました。Skimle Ask はこの前提を変えます。AI を活用したインタビュアーで大規模にインタビューを行い、回答を分析して新たなテーマを見つけられます。
研究の目的を説明するだけで、AI がインタビューガイドの下書きを作成し、あなたが仕上げます。インタビューのリンクを共有すれば、回答者は都合のよいときに Skimle Ask の直感的でスマートな AI インタビュアーと対話できます。Skimle の高度な AI 分析で、インサイトとテーマをすぐに見つけられます。
試してみる:数秒で自分の Skimle Ask を作成
試してみる:Skimle Ask のライブデモに回答
Skimle で得られるメリット

中核にあるのは厳密な質的分析
Skimle は、インタビューの記録、アンケートの回答、レポートなどの質的データを、数百件の文書にわたって自動的に収集、コード化、分類します。ワークフローは、テーマ分析から帰納的・演繹的コーディングまで、40年以上にわたる学術研究とビジネスリサーチから抽出された確立済みの質的データ分析手法に沿っています。得られるのは浅い AI の要約ではなく、大規模でも体系的で説明可能なコーディングです。
コラボレーションと連携のための多用途なワークスペース
音声や動画、文字起こし、文書、自由回答、AI が進行する Skimle Ask インタビューなど、データがある場所から始められます。その場で文字起こしと匿名化を行い、複数のソースを1つのプロジェクトにまとめ、混合研究法のツールやメタデータによるセグメント化でパターンを探れます。共有ワークスペースで同僚や AI エージェントと協働し、Word、PowerPoint、Excel、または NVivo や MAXQDA 向けの REFI-QDA に書き出せます。
完全な双方向の透明性とコントロール
すべてのコード、カテゴリ、要約は編集でき、元のテキストまでたどれます。各引用は100%逐語であることを機械的にチェックしています。結果は監査可能で説明可能なまま保たれ、分析は省察的なまま、ブラックボックスに頼らず主導権はあなたの手に残ります。枠組みを決めるのはあなたで、AI は最初の体系的な分析を担当します。
データをアップロードして集める
さまざまなソースのデータをまとめる
Skimle は、インタビュー記録、音声、動画、自由回答、顧客との通話やチャットのログ、記事、書籍、ウェブサイト、データルームの内容、証拠開示資料、特許、レポート、契約書などを分析できます……すべて1つのプロジェクトにまとめて
100以上の言語で1,000件以上の文書
Skimle は大規模な質的データに対応しています。元の文書が異なる言語でもかまわないため、多言語の環境でも簡単に作業できます。
すべて EU 内に安全に保管
Skimle はクラウドにデータを保管しながら、GDPR と EU AI 法に完全準拠しています。データ処理契約をご用意しており、企業向けにはシングルテナントのクラウドも選べます。
スマートな AI インタビュアー:Skimle Ask
AI アシスタントと一緒にインタビューガイドを作成し、リンクを共有すれば、深掘りすべきときと先に進むべきときを判断するスマートな AI アシスタントが参加者にインタビューします。回答は Skimle の中核となる分析ツールで分析できます。
複数話者に対応した高品質な文字起こし
音声や動画のファイルをアップロードすると、話者を自動で識別・ラベル付けした正確な AI 文字起こしが得られます。100以上の言語に対応し、文字起こしはそのまま Skimle の分析ワークフローに取り込まれます。
テーマの自動 AI 分析
Skimle は、お好みのコントロールの度合いで分析を行います。AI は、インタビューの質問、文書の見出し、内容の帰納的分析に基づいて構造を提案できます。Skimle はサブカテゴリを自動で作成しますが、必要に応じて調整するのはあなたです。
文書を匿名化する
Skimle Anonymise は、記録を共有したり分析したりする前に仮名化し、個人を特定できないようにします。軽度の仮名化から HIPAA レベルの匿名化まで3つのコンプライアンスレベルがあり、コンプライアンスのための完全な監査レポートも付属します。
- ✓.pdf、.docx、.txt、.rtf、.csv、ウェブサイトなどからテキストを取り込み
- ✓動画と音声を取り込み、複数話者に対応した高品質な AI 文字起こし
- ✓100以上の言語に対応し、多言語で分析
- ✓1プロジェクトあたり1,000件以上の文書に対応
- ✓並べ替え、絞り込み、分析に使える AI 生成のメタデータ項目を自動作成
- ✓AI が作成するメタデータ:各文書へのタグ付けを Skimle に指示(例:「これは苦情か、はい/いいえ」)
- ✓帰納的分析とテーマ分析のための自動提案
- ✓カテゴリと抽出する知識を完全にコントロール
- ✓大規模データをバックグラウンドで処理し、メールで通知
- ✓チームでプロジェクトを管理・共有
- ✓記録の匿名化を3つのコンプライアンスレベルで:軽度の仮名化、強度の仮名化、HIPAA レベルの匿名化
- ✓AI が6つのカテゴリで識別子を検出:氏名、肩書きと役割、場所、組織、日付、その他
- ✓ファイル間の一貫性:同じ人物にはすべての文書で同じ仮名
- ✓PDF の監査レポートと Excel の対応表付き
14 の機能をすべて表示 ▾
- ✓.pdf、.docx、.txt、.rtf、.csv、ウェブサイトなどからテキストを取り込み
- ✓動画と音声を取り込み、複数話者に対応した高品質な AI 文字起こし
- ✓100以上の言語に対応し、多言語で分析
- ✓1プロジェクトあたり1,000件以上の文書に対応
- ✓並べ替え、絞り込み、分析に使える AI 生成のメタデータ項目を自動作成
- ✓AI が作成するメタデータ:各文書へのタグ付けを Skimle に指示(例:「これは苦情か、はい/いいえ」)
- ✓帰納的分析とテーマ分析のための自動提案
- ✓カテゴリと抽出する知識を完全にコントロール
- ✓大規模データをバックグラウンドで処理し、メールで通知
- ✓チームでプロジェクトを管理・共有
- ✓記録の匿名化を3つのコンプライアンスレベルで:軽度の仮名化、強度の仮名化、HIPAA レベルの匿名化
- ✓AI が6つのカテゴリで識別子を検出:氏名、肩書きと役割、場所、組織、日付、その他
- ✓ファイル間の一貫性:同じ人物にはすべての文書で同じ仮名
- ✓PDF の監査レポートと Excel の対応表付き
データを分析して探索する
社会科学の方法論をパワーアップ
各文書を分析して共通の分類体系を作り、カテゴリを自動生成します。ワークフローは Braun と Clarke の流れをくむ省察的テーマ分析と同じ厳密なアプローチに沿いながら、数千件の細かな LLM マイクロクエリで自動化しています。
エージェント型分析:リサーチクエスチョンから文章の回答まで
リサーチクエスチョンから始めれば、Skimle がカテゴリ体系を作り、すべての文書をコード化し、反証と出典を伴う分析的なテーマを統合します。エージェント型分析は、問いをカテゴリツリーだけでなく、根拠に裏づけられた文章の回答に変えます。
直感的で透明な「文書 × カテゴリ」の表
各文書(例:インタビュー)のインサイトを、意味のあるカテゴリ(例:リスク)と結びつけて確認できるわかりやすい表形式のビュー。各テーマに検証済みの逐語引用があり、カテゴリとデータのコーディングを完全にコントロールできます。ブラックボックスもハルシネーションもありません。
分析を完全にコントロール
独自の視点を定義すれば Skimle がインサイトを抽出・分類します。インサイトを手動で追加・削除し、強力なユーザーインターフェースで結果を簡単に再編成できます。
分析を支援するスマートな AI チャット
メタデータとカテゴリを把握した独自の推論モデルにより、「男性と女性で回答はどう違うか?」「このテーマで意見が分かれる点は何か?」といった質問をして、より深いインサイトを得られます。
可視化:メタデータ分析とパターン検出
Skimle は各文書にメタデータ(感情、時期など)を自動で割り当て、AI が入力する独自の項目も作成できます。「可視化」で文書タイプ別のトピックのヒートマップを表示し、データの違いを最もよく説明するメタデータ変数を Skimle に自動で見つけさせましょう。たとえば、顧客セグメントや時期によって回答がどう違うかがわかります。
- ✓段落ごとの分析で、すべての文書を体系的かつ網羅的にカバー
- ✓双方向の透明性:要約から引用、元の文書へとたどり、また戻れる
- ✓元の文書のハイライトで、AI が各箇所をどう分析したかが正確にわかる
- ✓抽象度の異なる要約を備えたカテゴリビュー
- ✓ユーザー主導の編集:AI の提案を承認、修正、却下
- ✓理解が深まるにつれてカテゴリの名前変更、統合、分割が可能
- ✓メタデータの自動割り当て(感情、時期、カスタム項目)
- ✓属性、日付、ソースの種類、カスタムメタデータで絞り込み・クロス集計
- ✓どのトピックがどの文書セグメントに現れるかを示すヒートマップビュー
- ✓ワードクラウド、頻度グラフ、時系列の傾向
- ✓データの違いを最もよく説明するメタデータ変数を AI が自動検出
- ✓セグメントを分けるものを説明するグループ比較。すべてのメタデータの切り口を効果量で順位付け
- ✓推論能力を備えた AI チャット:カテゴリ横断やメタデータについて質問
- ✓エージェント型分析:分析的テーマ、反証、出典を伴う、リサーチクエスチョン主導のコーディング
- ✓テーマ分析、グラウンデッド・セオリー、内容分析、質的市場調査のワークフローに対応
- ✓ハルシネーションゼロ:すべてのインサイトが検証済みの逐語引用に紐づく
16 の機能をすべて表示 ▾
- ✓段落ごとの分析で、すべての文書を体系的かつ網羅的にカバー
- ✓双方向の透明性:要約から引用、元の文書へとたどり、また戻れる
- ✓元の文書のハイライトで、AI が各箇所をどう分析したかが正確にわかる
- ✓抽象度の異なる要約を備えたカテゴリビュー
- ✓ユーザー主導の編集:AI の提案を承認、修正、却下
- ✓理解が深まるにつれてカテゴリの名前変更、統合、分割が可能
- ✓メタデータの自動割り当て(感情、時期、カスタム項目)
- ✓属性、日付、ソースの種類、カスタムメタデータで絞り込み・クロス集計
- ✓どのトピックがどの文書セグメントに現れるかを示すヒートマップビュー
- ✓ワードクラウド、頻度グラフ、時系列の傾向
- ✓データの違いを最もよく説明するメタデータ変数を AI が自動検出
- ✓セグメントを分けるものを説明するグループ比較。すべてのメタデータの切り口を効果量で順位付け
- ✓推論能力を備えた AI チャット:カテゴリ横断やメタデータについて質問
- ✓エージェント型分析:分析的テーマ、反証、出典を伴う、リサーチクエスチョン主導のコーディング
- ✓テーマ分析、グラウンデッド・セオリー、内容分析、質的市場調査のワークフローに対応
- ✓ハルシネーションゼロ:すべてのインサイトが検証済みの逐語引用に紐づく
エクスポートして連携する
Word、Excel、PowerPoint 形式のカスタマイズ可能なレポート
インサイトを、結果を伝えやすくストーリーにしやすい形式の要点を絞ったレポートにすぐ変換できます。レポートは各分野に合うようユーザーと一緒に開発しています。
REFI-QDA ファイルを NVivo、MAXQDA、ATLAS.ti などに書き出し
AI がコード化した文書を、NVivo、MAXQDA、ATLAS.ti をはじめ多くの CAQDAS(コンピューター支援質的データ分析ソフトウェア)ツールが対応するオープンソースの形式で書き出せます。コーディング、カテゴリの要約、カテゴリ体系が書き出されます。
エージェント向けの MCP アクセス
Claude Code、Cowork などのエージェントツールに、Skimle で質的データを分析・構造化する力を与えましょう。MCP サーバー経由でアップロード、編集、ダウンロードの機能をすべて利用できます。
基準に照らした文書の評価(近日公開)
記述的な分析を超えて、体系的な評価へ。カテゴリごとに採点基準を設定し、たとえば入札の提案書を技術力、コスト構造、リスク管理の観点で評価できます。Skimle は各文書の強みと不足を示し、意思決定を支援する構造化された採点マトリクスを書き出します。
- ✓全体とカテゴリ別の要約、厳選した引用を含む Word レポート
- ✓エグゼクティブサマリーと、関連する引用付きのテーマ別の詳細分析を含む PowerPoint レポート
- ✓カテゴリ、コメント、構造化データの Excel への書き出し
- ✓NVivo、ATLAS.ti、MAXQDA などの従来の QDA ツールで使える REFI-QDA への書き出し
- ✓ブランチを展開してデータをインタラクティブに探索できるカテゴリビュー
- ✓レポートのすべての項目が元の逐語引用にリンク
- ✓採点基準に照らした文書の評価と、書き出し可能なマトリクス(近日公開)
- ✓自動化されたワークフローのための REST API と MCP によるシステム連携
- ✓エンタープライズ:シングルテナントのクラウド、専用データベース、管理機能、SSO
- ✓独自の連携のための、Claude Code、Cowork、OpenClaw などのエージェント向け MCP アクセス
10 の機能をすべて表示 ▾
- ✓全体とカテゴリ別の要約、厳選した引用を含む Word レポート
- ✓エグゼクティブサマリーと、関連する引用付きのテーマ別の詳細分析を含む PowerPoint レポート
- ✓カテゴリ、コメント、構造化データの Excel への書き出し
- ✓NVivo、ATLAS.ti、MAXQDA などの従来の QDA ツールで使える REFI-QDA への書き出し
- ✓ブランチを展開してデータをインタラクティブに探索できるカテゴリビュー
- ✓レポートのすべての項目が元の逐語引用にリンク
- ✓採点基準に照らした文書の評価と、書き出し可能なマトリクス(近日公開)
- ✓自動化されたワークフローのための REST API と MCP によるシステム連携
- ✓エンタープライズ:シングルテナントのクラウド、専用データベース、管理機能、SSO
- ✓独自の連携のための、Claude Code、Cowork、OpenClaw などのエージェント向け MCP アクセス