Elke respondent gehoord. Elk inzicht herleidbaar. Elke deadline gehaald.
Gemaakt voor marktonderzoeksbureaus die aan klanten leveren en voor interne klantinzichtteams die aan de organisatie leveren. Beide zitten in dezelfde knel: kwalitatieve data zijn het rijkste signaal dat u hebt, en het is veel te veel om met de hand zorgvuldig te lezen. Van bureaus wordt dieper inzicht gevraagd in minder tijd voor een lager honorarium. Interne teams moeten bijblijven bij product- en commerciële beslissingen die geen twee weken kunnen wachten.
Skimle doet het mechanische codeerwerk dat het grootste deel van de week van een analist opslokt. U doet de interpretatie, het ‘so what’ en de aanbeveling. Twee weken coderen wordt twee dagen, en de nuance overleeft de compressie.
Analyse op professioneel niveau die meegroeit met uw onderzoeksvolume
60 diepte-interviews, 8 focusgroepen in vier markten of 5000 NPS-toelichtingen: dat volume gaat zorgvuldig handmatig lezen te boven, en oppervlakkige tools verliezen de nuance waar de klant of de commercieel directeur naar zal vragen. Skimle schaalt zonder diepgang in te leveren.
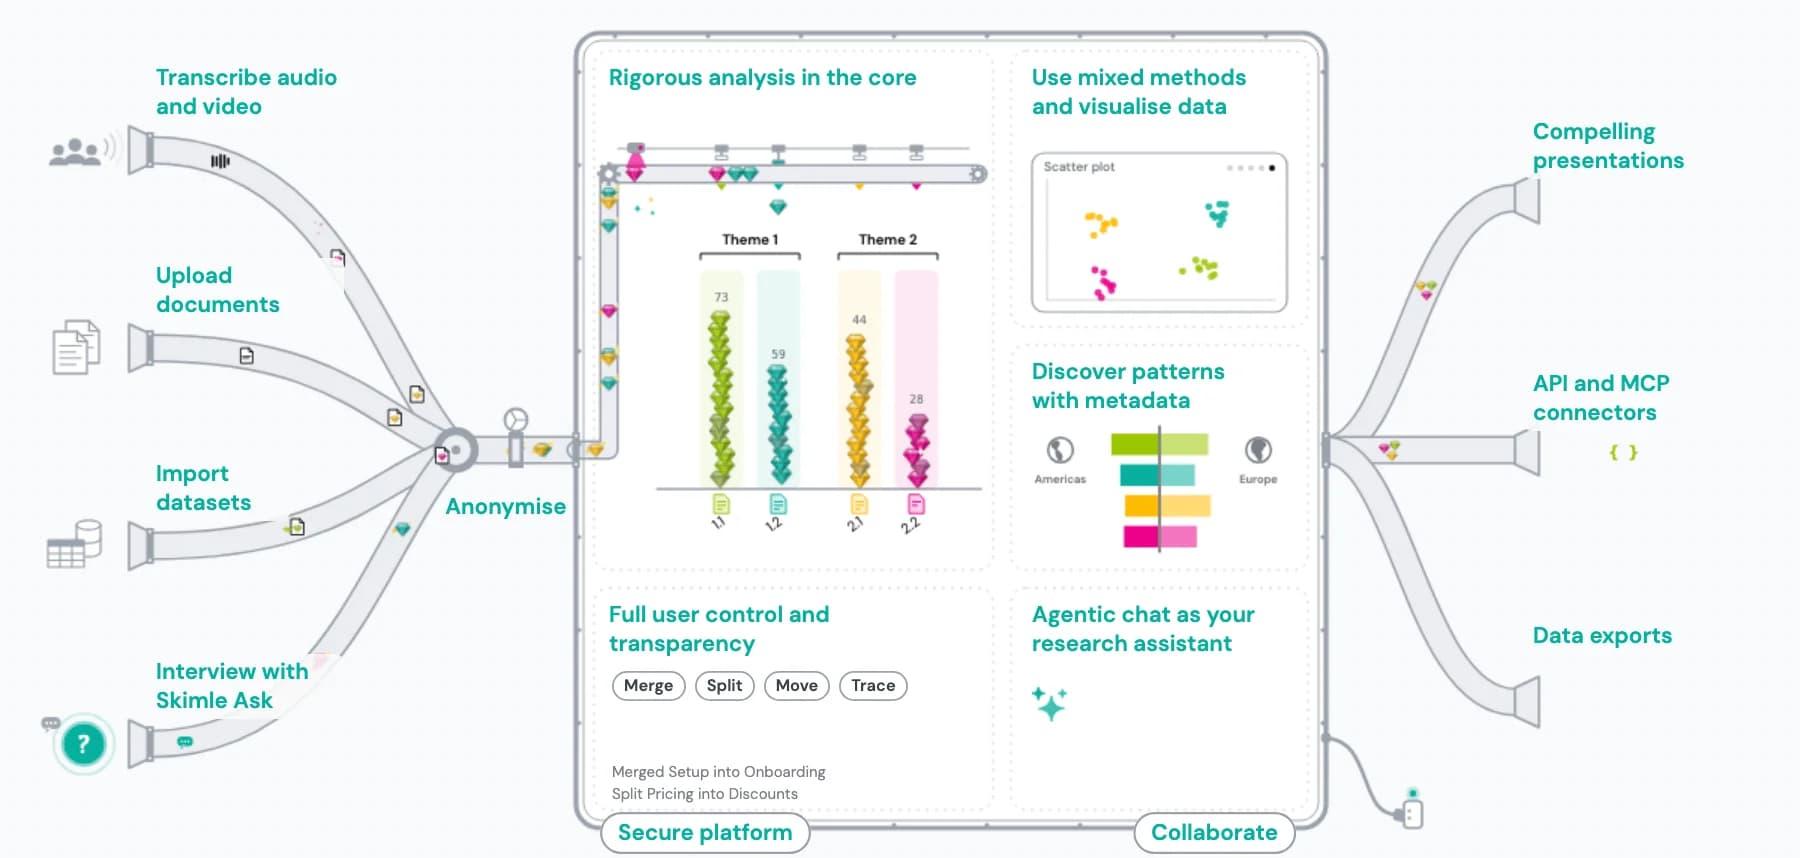
- Verwerkt interviews, focusgroepen, open enquêtevragen, recensies en supporttickets in één project
- Elk thema gekoppeld aan letterlijke klantcitaten, uit de volledige dataset en niet uit een steekproef
- Segmentanalyse ingebouwd: vergelijk op demografie, productniveau, regio en NPS-categorie
- Meer dan 100 talen in één project, zonder vertaalstap
- Exports naar Word, PowerPoint en Excel die binnen enkele minuten klaar zijn voor een presentatie
Analyseer focusgroepen en klantinterviews op grote schaal
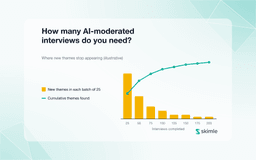
Focusgroepen zijn de kwalitatieve data die het moeilijkst goed te analyseren zijn. Eén uitgesproken deelnemer lijkt op vier onafhankelijke stemmen, tenzij u het bewijs bijhoudt. Diepte-interviews gaan op een andere manier mis: bij 20, 40 of 60 transcripten wordt het de bottleneck om het laatste op dezelfde manier te coderen als het eerste. Skimle bouwt één themastructuur over alle sessies heen en laat zien wat consistent was, wat per segment verschilde en wat een losse uitschieter was, zodat de bevinding overeind blijft als een klant of stakeholder tegengas geeft.
Hoe het werkt
- 1. Importeer elke sessie als document
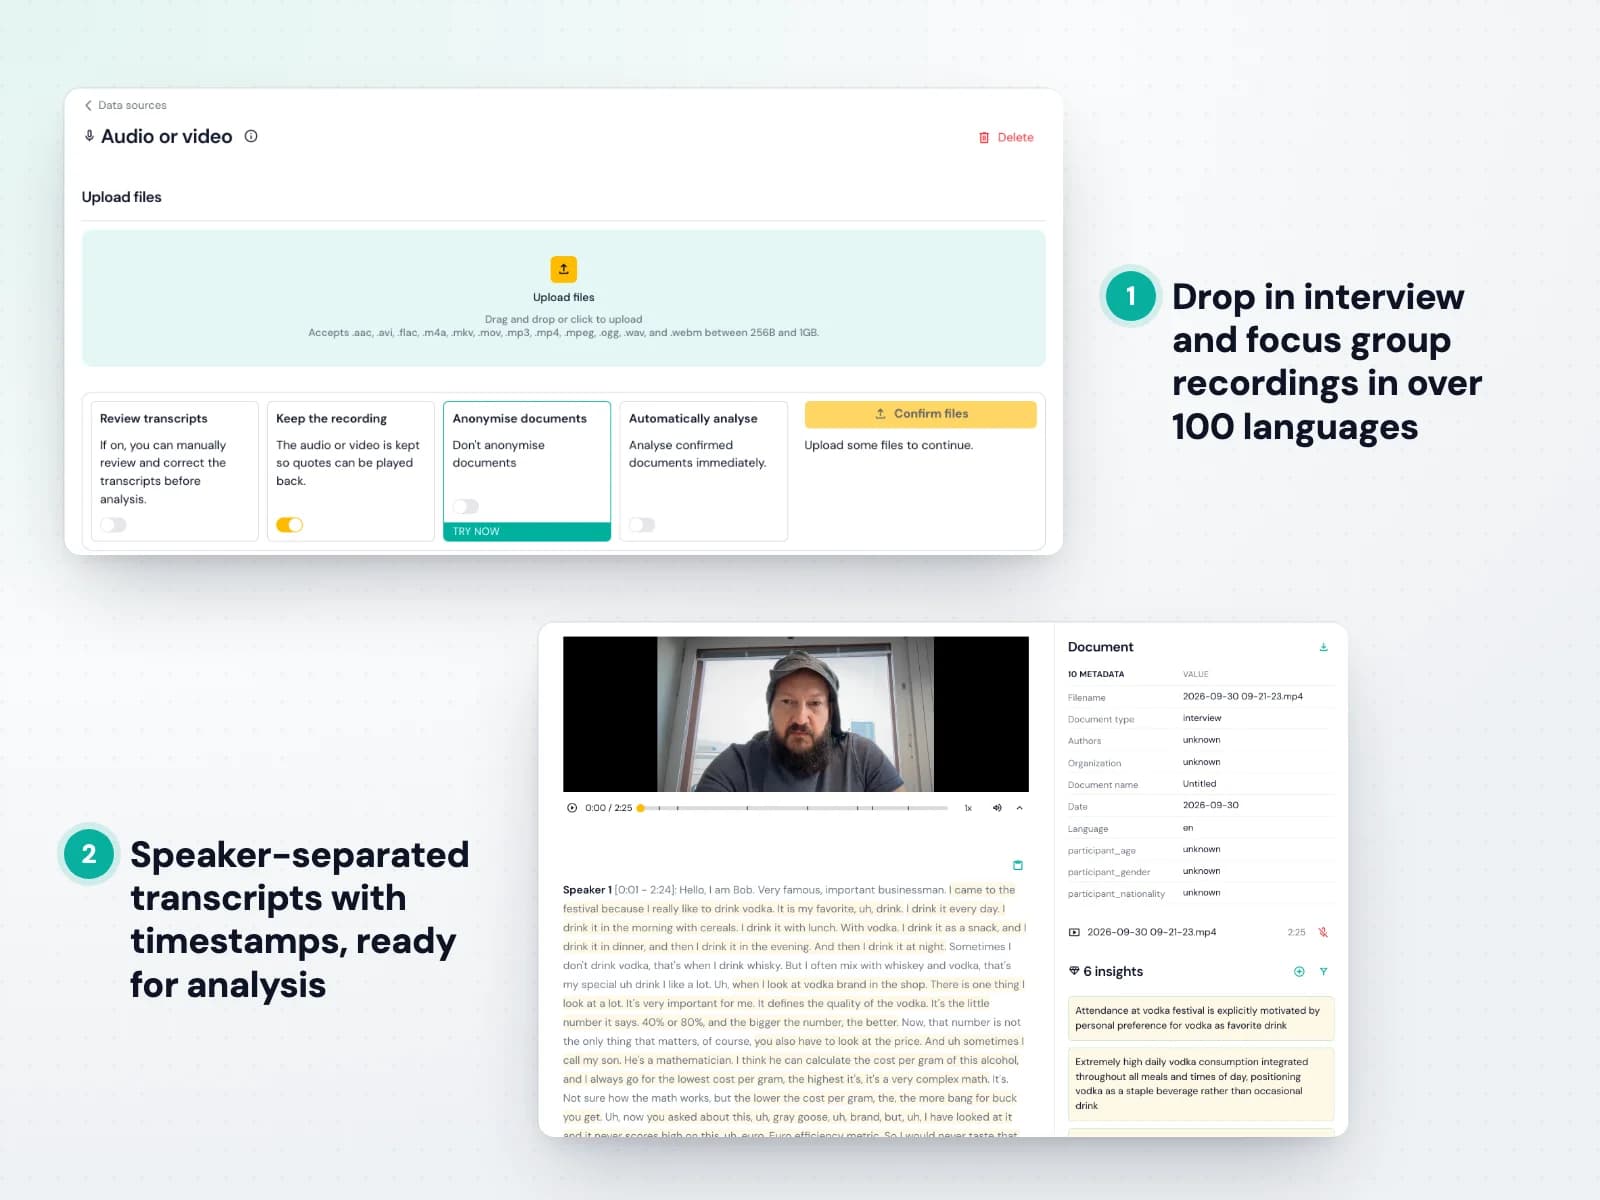
Upload transcripten of opnamen uit Zoom, Teams, Otter of Fireflies. Skimle transcribeert audio en video rechtstreeks, zodat elke sessie één document wordt dat klaar is voor analyse.
- 2. Voer de analyse uit over alle sessies
Skimle leest elk transcript en bouwt thema's op uit de inhoud van alle sessies. Het ontdekt wat er werkelijk besproken is, in plaats van een vooraf vastgesteld categoriesysteem op te leggen.
- 3. Zie wat consistent was en wat varieerde
Elk thema laat zien welke groepen eraan bijdroegen en hoe vaak, waardoor het universele signaal wordt gescheiden van één sessie of één markt.
- 4. Beoordeel hoe het bewijs verdeeld is
Klik op een thema om de onderbouwende citaten te lezen en te zien uit welke sessies ze komen. Beoordeel het effect van dominante stemmen rechtstreeks in plaats van uit het geheugen.
- 5. Exporteer voor de klant
Genereer het synthesedocument met representatieve citaten per groep, klaar voor de presentatie of het volledige rapport.
Codeer open enquêtevragen en vergelijk tussen segmenten
Eén algemene themalijst beantwoordt nooit de vraag die de organisatie eigenlijk stelde: wie denkt er zo over, en hoe verschilt dat per segment? Met duizenden open antwoorden lezen de meeste teams een steekproef en verliezen ze de minderheidsstandpunten die het scherpste signaal geven. Skimle codeert elk antwoord en laat u dezelfde themastructuur opdelen naar elke metadatavariabele, of dat nu een NPS-categorie, een productniveau, een markt of een demografisch kenmerk is, zodat de open vragen van een tracker een mixed-methods-overzicht worden waarop u kunt handelen.
Hoe het werkt
- 1. Upload antwoorden met metadata
Importeer open antwoorden als CSV uit SurveyMonkey, Typeform of Qualtrics, met de metadatakolommen van respondenten erbij, zodat elk antwoord zijn segment meedraagt.
- 2. Bouw de volledige themastructuur
Skimle codeert elk antwoord in een hiërarchie van thema's, niet alleen de veelvoorkomende, zodat minderheidsstandpunten zichtbaar blijven.
- 3. Segmenteer op elke variabele
Filter en vergelijk thema's per NPS-categorie, productniveau, regio of demografie om te zien welke kwesties voor welke klanten het zwaarst wegen.
- 4. Controleer het bewijs
Elk patroon is herleidbaar tot letterlijke citaten, zodat een verschil tussen twee segmenten wordt onderbouwd door precies de antwoorden waaruit het voortkomt.
- 5. Exporteer output die klaar is voor de klant
Genereer een rapport per thema met letterlijke citaten en kruistabellen, in minuten in plaats van dagen.

Breng elk feedbackkanaal samen in één beeld van inzichten
Interviews, NPS-toelichtingen, supporttickets, recensies, opnamen van verkoopgesprekken, win-lossevaluaties, communitydiscussies, analisten- en concurrentierapporten. Elk kanaal krijgt meestal een eigen analyse, een eigen presentatie en een eigen vocabulaire, zodat niets op elkaar aansluit en hetzelfde klantprobleem drie keer onder drie namen wordt gerapporteerd. Skimle codeert elke bron tegen één categoriestructuur in één project en laat daarna zien hoe zwaar elk kanaal hetzelfde thema laat wegen. Bureaus gebruiken het om deskresearch en secundair materiaal in een primaire studie op te nemen. Interne teams gebruiken het voor een doorlopend beeld van de klant.
Hoe het werkt
- 1. Breng de kanalen samen in één project
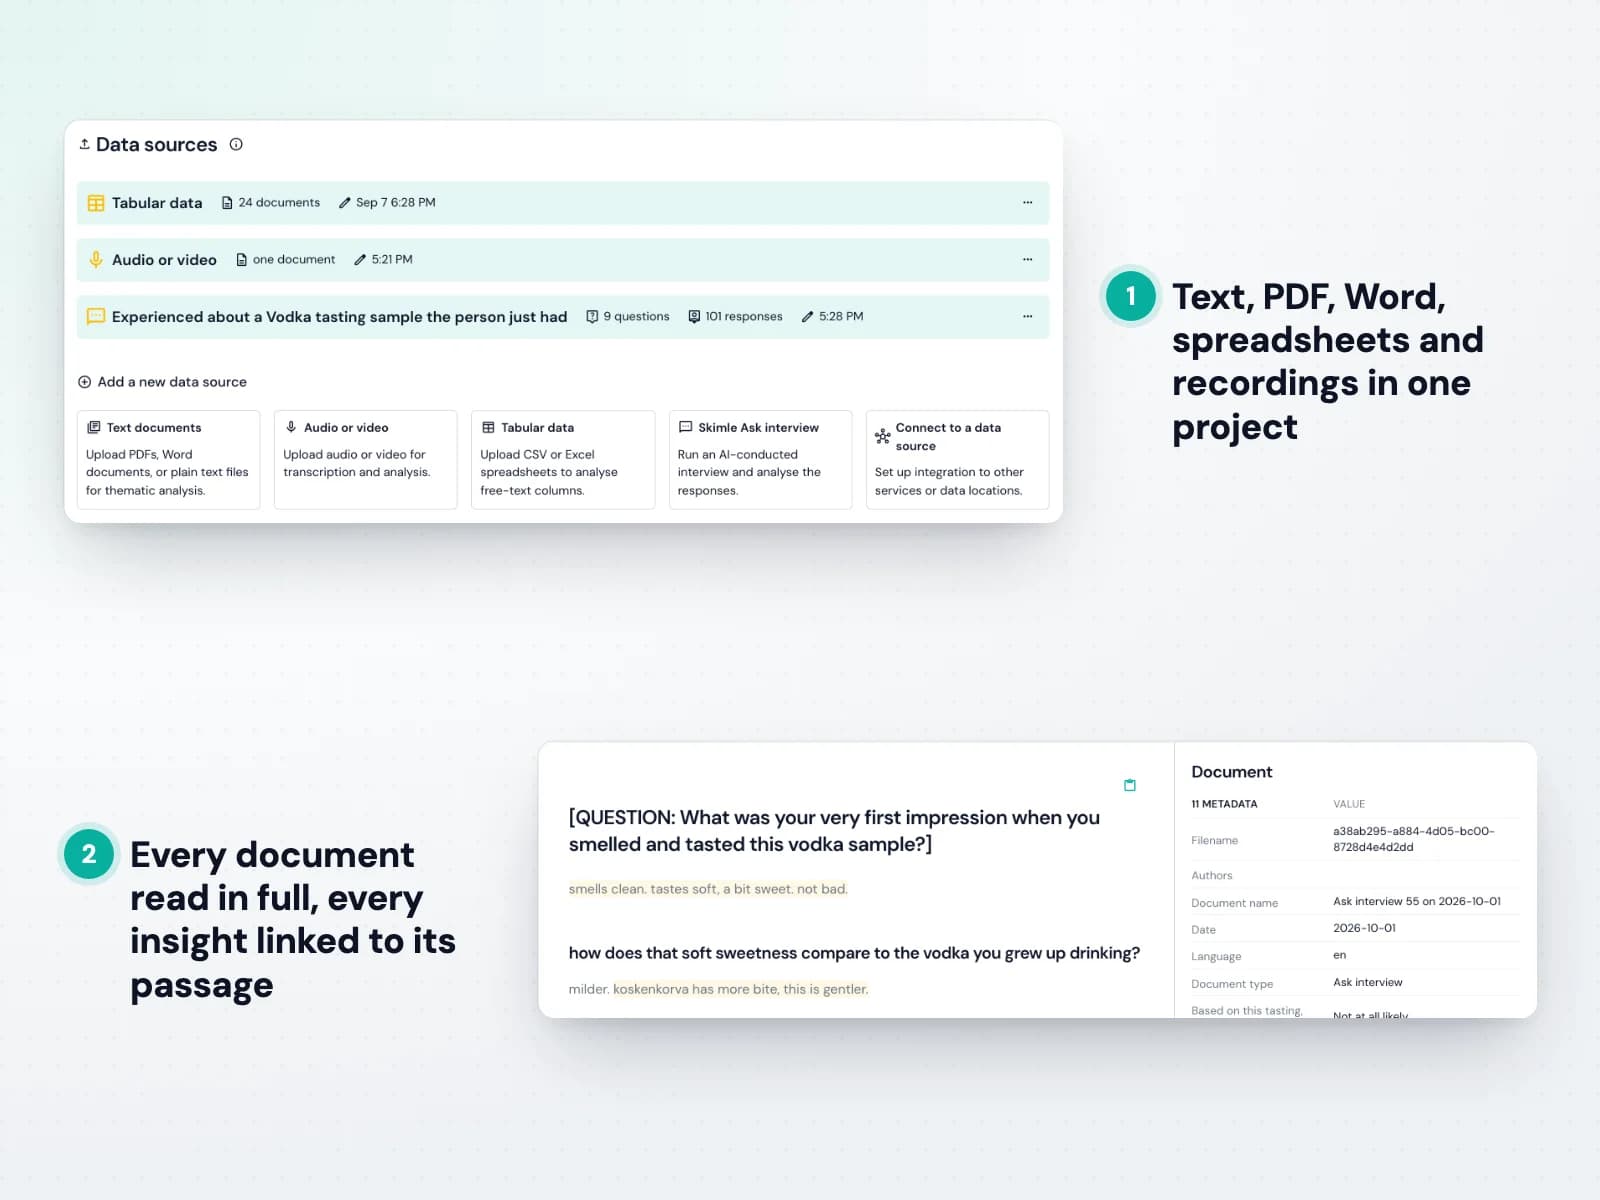
Upload transcripten, CSV-exports, pdf's en opnamen naast elkaar. Ticketexports, verzamelde recensies, analistenrapporten en interviewaudio worden allemaal documenten in hetzelfde project.
- 2. Label elk document met zijn kanaal
Kanaal, segment, markt en datum gaan erin als metadata, zodat elke latere vergelijking van bronnen een filter is in plaats van een nieuwe analyse.
- 3. Codeer alles tegen één structuur
Skimle bouwt één themastructuur over alle bronnen, of past het kader toe waarop u al rapporteert, zodat een bevinding in elk kanaal hetzelfde betekent.
- 4. Vergelijk wat elk kanaal u vertelt
Zie waar bronnen overeenkomen en waar ze elkaar tegenspreken. Een thema dat luid klinkt in tickets en ontbreekt in interviews is een bevinding, geen verschil om weg te redeneren.
- 5. Voeg de volgende meting toe zonder opnieuw te beginnen
De data van volgend kwartaal worden in dezelfde structuur gecodeerd, zodat de tracker vergelijkbaar blijft en het bijgewerkte rapport een nieuwe export is in plaats van een herbouw.
Veelgestelde vragen
Dit zijn de vragen die teams voor klantinzichten en onderzoeksleiders van bureaus ons het vaakst stellen, inclusief de vragen die rechtstreeks uit een inkoopproces komen. Onze leveranciersneutrale RFP-checklist zet dezelfde vragen op een rij die u elke leverancier die u beoordeelt kunt stellen, ons inbegrepen.
- Hoe helpt dit ons te concurreren met goedkope, oppervlakkige alternatieven?
- Goedkope aanbieders en dunne AI-schillen concurreren op prijs met woordwolken en een platte themalijst. Skimle geeft u diepgang in hun tempo, zodat een bureau zich onderscheidt met de kwaliteit van het ‘so what’ in plaats van met het uurtarief, en een intern team meer studies uit een gelijkblijvend budget haalt. Analistenuren verschuiven van mechanisch coderen naar interpretatie, en daar betaalt men eigenlijk voor. Zie waar het geld in een kwalitatieve studie echt naartoe gaat →
- Wat zeggen we als een klant of stakeholder analyse met AI-ondersteuning ter discussie stelt?
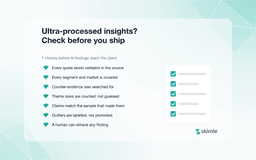
- Beschrijf het nauwkeurig: de AI doet de mechanische indeling in categorieën, een met naam genoemde onderzoeker beoordeelt elk thema en schrijft de interpretatie. Laat daarna het bewijs zien. Elke bewering in een Skimle-rapport opent het letterlijke citaat en het document waaruit het komt. Dat is een sterker antwoord dan een handmatige synthese kan geven, want daar bestond de codeerlogica alleen in iemands hoofd. 7 regels voor verantwoord gebruik van AI in kwalitatief marktonderzoek →
- Analyseert Skimle de volledige dataset of een steekproef?
- De volledige dataset. Het loont om dit elke leverancier te vragen, want verschillende tools halen via een embeddingzoekopdracht een deel van uw documenten op, analyseren dat en melden nooit welke documenten buiten de boot vielen. De output leest alsof hij al het materiaal dekt, en dat doet hij niet. Skimle codeert elk document, en u kunt elk document openen om precies te zien welke passages zijn gecodeerd en welke niet.
- Kunnen we ons eigen categoriesysteem toepassen, of alleen accepteren wat de AI maakt?
- Allebei, en beide op hetzelfde materiaal. Breng een bestaand categoriesysteem mee en Skimle codeert er deductief tegen, of laat het de structuur inductief uit de data opbouwen. Categorieën kunnen achteraf worden samengevoegd, gesplitst, hernoemd, herordend en verwijderd, en de analyse volgt uw aanpassingen. Bureaus die jaar na jaar een tracker of een standaardkader van een klant draaien, werken meestal deductief; verkennende studies beginnen meestal andersom.
- Wat voorkomt dat een verzonnen citaat in ons rapport belandt?
- Elk citaat wordt mechanisch gecontroleerd tegen het brondocument. Als het model tekst produceert die niet letterlijk in uw data voorkomt, markeert Skimle die en verwerkt het opnieuw in plaats van de tekst te tonen, zodat een verzonnen citaat nooit in een klantpresentatie terechtkomt. U kunt ook elk document openen en zien welke passages zijn gecodeerd en welke niet. Zo ontdekt u de omgekeerde fout, dat er iets gemist is. Zo werkt transparantie in twee richtingen →
- Hoe beoordelen we Skimle ten opzichte van de andere tools op onze lijst?
- Draai een pilot in plaats van naar demo's te kijken. Neem materiaal dat u al hebt geanalyseerd, zodat u weet wat het antwoord moet zijn, schrijf vooraf drie taken uit (één codeertaak, één segmentvergelijking, één zoektocht naar bewijs), meet de tijd van elke taak inclusief het correctiewerk en ga bewust tegen de tool in om te zien hoe snel u de output kunt herstructureren. We draaien graag één live project parallel aan uw huidige leverancier, en met de gratis versie kan één onderzoeker zich daarvoor al in een middag een oordeel vormen. De RFP-checklist met 7 domeinen en een scoringssjabloon →
- Hoeveel data kan Skimle aan, en in hoeveel talen?
- Tot 1000 documenten per project, wat alles dekt van een studie met 20 interviews tot een wereldwijde tracker met duizenden enquêteantwoorden, en meer dan 100 talen die rechtstreeks worden geanalyseerd zonder vertaalstap. Eén project kan Engels, Spaans, Mandarijn, Duits en Arabisch combineren, één themastructuur over alles bouwen en elk citaat in de oorspronkelijke taal bewaren. Werkt u regelmatig aan de bovenkant van dat bereik, neem dan contact met ons op over volumeafspraken.
- Zijn klantdata veilig en vertrouwelijk?
- Alle data worden binnen de EU opgeslagen en verwerkt op AWS, in een omgeving die is ingericht door een gecertificeerde derde partij, en klantdata worden nooit gebruikt om modellen te trainen. Verwerkersovereenkomsten zijn beschikbaar, we werken onder geheimhoudingsovereenkomsten van klanten, pseudonimisering is ingebouwd in de workflow, en een single-tenant- of private-cloudimplementatie is beschikbaar waar datasoevereiniteit dat vereist.
- Wat gebeurt er met onze analyse als we stoppen met Skimle?
- U neemt hem mee, in elk abonnement. Exporteer gecodeerde data in het open REFI-QDA-formaat (.qdpx) en ga verder in NVivo, ATLAS.ti of MAXQDA, of neem Word-, PowerPoint- en Excel-output mee met citaten geordend per thema. We implementeren de interoperabiliteitsstandaard juist zodat blijven een keuze is en geen gevolg.
- Hoe werkt de prijs als ons onderzoeksvolume schommelt?
- Skimle is een licht abonnement per gebruiker met een inbegrepen creditbudget, plus creditpakketten die u koopt voor de maanden waarin een grote studie loopt. Het abonnement houdt het hele team tussen projecten in de tool; de pakketten koppelen de kosten aan het project dat ze veroorzaakte, wat belangrijk is voor bureaus die doorbelasten aan klanten. Stakeholders die alleen bevindingen hoeven te lezen, hebben geen licentie nodig, want exports en afdrukbare onderzoeksrapporten dekken dat af.
- Kunnen meerdere onderzoekers aan hetzelfde project werken?
- Ja, tegelijkertijd, waarbij de bewerkingen en aantekeningen van ieder bewaard blijven. Dat past bij peerreview en kwaliteitscontrole, en bij het verdelen van een grote studie tussen junior en senior onderzoekers, met één senior die de categoriestructuur stuurt.
Gebouwd voor professionals, door professionals
Skimle heeft meer dan 1.500 tevreden gebruikers bij meer dan 50 universiteiten, overheidsinstanties, bureaus en bedrijven. Alle data wordt binnen de EU opgeslagen en verwerkt volgens ons strikte AVG-beleid en onze servicevoorwaarden.
Meer weten? Bekijk onze blog Signal & Noise, onze veelgestelde vragen en toepassingen per sector. We geven ook graag een demo van het product of verkennen samen hoe Skimle bij uw behoeften past. Lees meer over het bedrijf achter Skimle