Overzicht van de functies van Skimle
Skimle is AI-native software voor kwalitatieve data-analyse voor marktonderzoekers, klantinzichtexperts, academische onderzoekers, consultants en andere nieuwsgierige professionals die dieper in hun data willen duiken.
Upload interviewtranscripten, opnamen van focusgroepen, tabellen met duizenden open antwoorden, documenten of andere kwalitatieve data in meer dan 100 ondersteunde talen. De grondige bottom-up werkwijze van Skimle identificeert inzichten en bouwt een transparante categoriestructuur op die u vrij kunt bewerken. U kunt de data visualiseren met mixed methods, patronen ontdekken met metadata, uw AI-agent via MCP met uw data verbinden, overtuigende presentaties maken en meer.
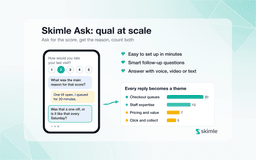
Ons platform bevat ook Skimle Ask, een krachtige AI-ondersteunde enquête-engine voor het verzamelen van rijke kwalitatieve inzichten op schaal. Stel uw interviewleidraad op, deel de link met respondenten en verzamel data via antwoorden in tekst, spraak of video, met slimme vervolgvragen.
Skimle combineert academische grondigheid met zakelijke praktijk. Veel AI-tools slaan de eigenlijke analyse over en leveren alleen een aannemelijke maar onverdedigbare samenvatting op, vatbaar voor bias en hallucinaties. Traditionele tools zoals NVivo, MAXQDA of ATLAS.ti dwingen u het grootste deel van uw tijd aan handmatig coderen te besteden in plaats van aan analyseren. Skimle is anders gebouwd: u krijgt een grondige, geautomatiseerde AI-werkwijze voor analyse met volledige tweerichtingstransparantie en controle voor de gebruiker.
Skimle is een compleet platform voor kwalitatieve analyse
Skimle is een veelzijdige tool waarmee u…
Een geanimeerd schema van hoe Skimle werkt. Data komt binnen via vier invoerbuizen: transcriptie, documentupload, import van datasets en Skimle Ask-interviews. Ze passeert een anonimiseringsklep en komt de machine in, waar inzichten in thema's worden gesorteerd, met visualisaties worden verkend, op metadata worden vergeleken en met een AI-onderzoeksassistent worden besproken. Resultaten verlaten de machine via drie exportbuizen: presentaties, API- en MCP-koppelingen, en data-exports.
Academisch onderzoek
Literatuuronderzoek
Importeer artikelen en secundaire bronnen, codeer automatisch thema's in honderden documenten en vind lacunes en patronen in de literatuur in uren in plaats van weken.
Lees meer →Thematische analyse
De AI van Skimle identificeert terugkerende thema's in interviewtranscripten en bouwt een categorieboom op die u kunt beoordelen, bewerken en valideren, waarbij elk thema herleidbaar is tot specifieke citaten.
Lees meer →Grounded theory
Bouw inductief theorie op vanuit ruwe data. Skimle codeert uw transcripten, brengt opkomende concepten aan het licht en laat u uw categoriesysteem stap voor stap verfijnen naarmate patronen zich ontwikkelen.
Lees meer →Inductief coderen
Begin met open coderen en laat Skimle categorieën rechtstreeks uit uw data voorstellen. Beoordeel, voeg samen en hernoem codes zodat ze passen bij uw analytische invalshoek, met de volledige regie in eigen hand.
Lees meer →Deductief coderen
Pas een vooraf gedefinieerd categoriesysteem toe op uw materiaal. Skimle koppelt uw categorieën aan nieuwe data, met volledig inzicht in welke citaten elke code hebben opgeleverd.
Lees meer →Mixed methods
Combineer kwantitatieve metadata met kwalitatieve thema's. Maak kruistabellen van codeercategorieën en demografische kenmerken van respondenten om statistisch betekenisvolle patronen te vinden.
Lees meer →
Marktonderzoek en klantinzichten
Kwalitatief marktonderzoek
Voer diepte-interviews, focusgroepen en open antwoorden uit en analyseer ze op één plek: de volledige werkwijze voor kwalitatief marktonderzoek, van transcript tot thema's onderbouwd met citaten.
Lees meer →Focusgroeponderzoek
Transcribeer en analyseer focusgroepgesprekken, met zicht op wie wat zei en hoe thema's verschillen tussen deelnemersgroepen, moderatoren en sessies.
Lees meer →Klantinterviews
Codeer diepte-interviews systematisch, stel vast wanneer uw programma verzadiging bereikt en exporteer heldere, met citaten onderbouwde rapporten voor klantpresentaties.
Lees meer →Voice of the market
Bundel en codeer open enquêteantwoorden van grote steekproeven om marktpercepties, onvervulde behoeften en opkomende trends per segment te begrijpen.
Lees meer →Focusinterviews
Voer gestructureerde diepte-interviews uit met Skimle Ask, codeer de antwoorden automatisch en vergelijk de bevindingen direct tussen respondentsegmenten.
Lees meer →
Consultancy en due diligence
Synthese van expertgesprekken
Transcribeer en codeer gesprekken met experts uit expertnetwerken binnen een project. Bouw in een fractie van de tijd een gestructureerd overzicht op van de visies van experts op marktdynamiek, risico's en kansen.
Lees meer →Analyse van stakeholderinput
Analyseer stakeholderinterviews en workshopresultaten systematisch, zodat alle stemmen vertegenwoordigd en herleidbaar zijn in uw uiteindelijke aanbevelingen.
Lees meer →Documenten samenvatten
Haal in een fractie van de tijd de kernthema's en standpunten uit grote documentensets, zoals regelgevende stukken, jaarverslagen en onderzoeksrapporten.
Lees meer →AI-data-analyse
Gebruik de AI van Skimle om kwalitatieve data uit interviews, enquêtes en documenten snel te coderen en te categoriseren, zodat consultants zich kunnen richten op synthese en het ontwikkelen van inzichten.
Lees meer →Deskresearch
Orden en analyseer secundaire onderzoeksbronnen, codeer thema's automatisch en zie precies waar elk inzicht in uw documentenset vandaan komt.
Lees meer →
Nieuwsgierige professionals
Bedrijfsgeheugen
Bouw een doorzoekbare, gecodeerde verzameling bedrijfskennis op: vergadernotities, strategiedocumenten en onderzoek die uw team kan raadplegen, analyseren en in de loop van de tijd kan uitbreiden.
Lees meer →AI-data-analyse
Upload ongestructureerde data (e-mails, rapporten, notities) en laat Skimle die structureren en coderen, zodat verspreid ruw materiaal geordende, doorzoekbare kennis wordt.
Lees meer →Documentanalyse
Analyseer contracten, beleidsdocumenten of onderzoeksartikelen om kernthema's en inzichten te extraheren zonder elk woord te lezen, met citaten die herleidbaar zijn tot de oorspronkelijke bron.
Lees meer →Eenmalige analyse
Voer snel een gestructureerde analyse uit op elke dataset (interviewnotities, klantmails, feedback) zonder vast te zitten aan een lang onderzoeksprogramma of een complexe tool te moeten leren.
Lees meer →Synthese van datasets
Combineer inzichten uit meerdere databronnen in één categoriesysteem en vind gemeenschappelijke thema's en verschillen tussen datasets uit verschillende contexten.
Lees meer →
Productmanagement
Analyse van klantfeedback
Bundel appreviews, supporttickets en enquêteantwoorden in gestructureerde thema's. Zie direct de grootste pijnpunten en functieverzoeken, bij elke hoeveelheid data.
Lees meer →Continuous discovery
Voer lichte interviewcycli uit en codeer de bevindingen in een blijvende inzichtenbank. Volg hoe thema's zich ontwikkelen over productiteraties en kwartalen heen.
Lees meer →Gebruikersonderzoek
Transcribeer en analyseer usabilitysessies, diepte-interviews en dagboekstudies. Kom sneller tot inzichten zonder de rijke kwalitatieve details te verliezen die uw team nodig heeft.
Lees meer →Analyse van gespreksverslagen
Upload opnamen van verkoop- of supportgesprekken, transcribeer ze automatisch en codeer op schaal om terugkerende bezwaren, functieverzoeken en sentimentpatronen te vinden.
Lees meer →
HR, mensen en cultuur
Analyse van exitinterviews
Codeer antwoorden uit exitinterviews op schaal om behoudsrisico's, patronen in leiderschap en systemische problemen te vinden voordat ze zich in uw organisatie opstapelen.
Lees meer →Medewerkersbetrokkenheidsonderzoek
Zet open enquêteantwoorden om in gestructureerde thema's. Begrijp wat betrokkenheid en ontevredenheid drijft per team, locatie en dienstjarengroep.
Lees meer →Pulsonderzoeken
Voer regelmatig korte interviews uit met Skimle Ask en volg hoe thema's in het sentiment van medewerkers zich in de tijd ontwikkelen, zodat HR een actueel beeld heeft van de gezondheid van de organisatie.
Lees meer →Cultuuronderzoek
Analyseer kwalitatieve data uit cultuurmetingen om verschillen tussen beleden en geleefde waarden te vinden, volledig herleidbaar tot specifieke citaten van respondenten voor rapportage aan het management.
Lees meer →
Publieke sector en beleidsanalyse
Analyse van publieke consultaties
Analyseer reacties op publieke consultaties op schaal, codeer de inzendingen en vind de meest voorkomende standpunten, zorgen en aanbevelingen in duizenden bijdragen.
Lees meer →Beoordeling van beleidsdocumenten
Haal kernthema's en standpunten uit beleidsdocumenten, regelgevende stukken en wetteksten, waarbij elke bevinding herleidbaar is tot de bronpassage.
Lees meer →Feedback van stakeholders
Codeer en analyseer gestructureerde feedback van burgers, gebruikers van diensten of partners systematisch, zodat alle stemmen worden vastgelegd en in de rapportage vertegenwoordigd zijn.
Lees meer →Programma-evaluatie
Analyseer interview- en enquêtedata van programmadeelnemers om de impact te beoordelen, terugkerende thema's te vinden en met bewijs onderbouwde evaluatierapporten te maken.
Lees meer →
Verbinden via MCP
Skimle gebruiken vanuit Claude
Verbind Skimle via MCP met Claude en bevraag uw onderzoeksdata, categorieën en inzichten in gewone taal, zonder van context te wisselen.
Lees meer →AI-werkwijzen bouwen
Gebruik de MCP-server van Skimle om uw kwalitatieve onderzoeksdata te integreren in elke MCP-compatibele AI-tool, zodat u analysestappen automatiseert en resultaten doorgeeft aan bredere werkwijzen.
Lees meer →Onderzoek bevragen via API
Benader Skimle-data programmatisch via de API. Haal projecten, documenten, categorieën en inzichten op voor eigen dashboards of externe rapportagetools.
Lees meer →
Thema's komen voort uit de data
Elke wijziging wordt vastgelegd en kan ongedaan worden gemaakt.
Stap 1
Data uploaden en verzamelen
Breng opnamen, documenten en datasets in, of verzamel nieuwe data met AI-ondersteunde interviews, en anonimiseer die vóór de analyse.
Audio en video transcriberen
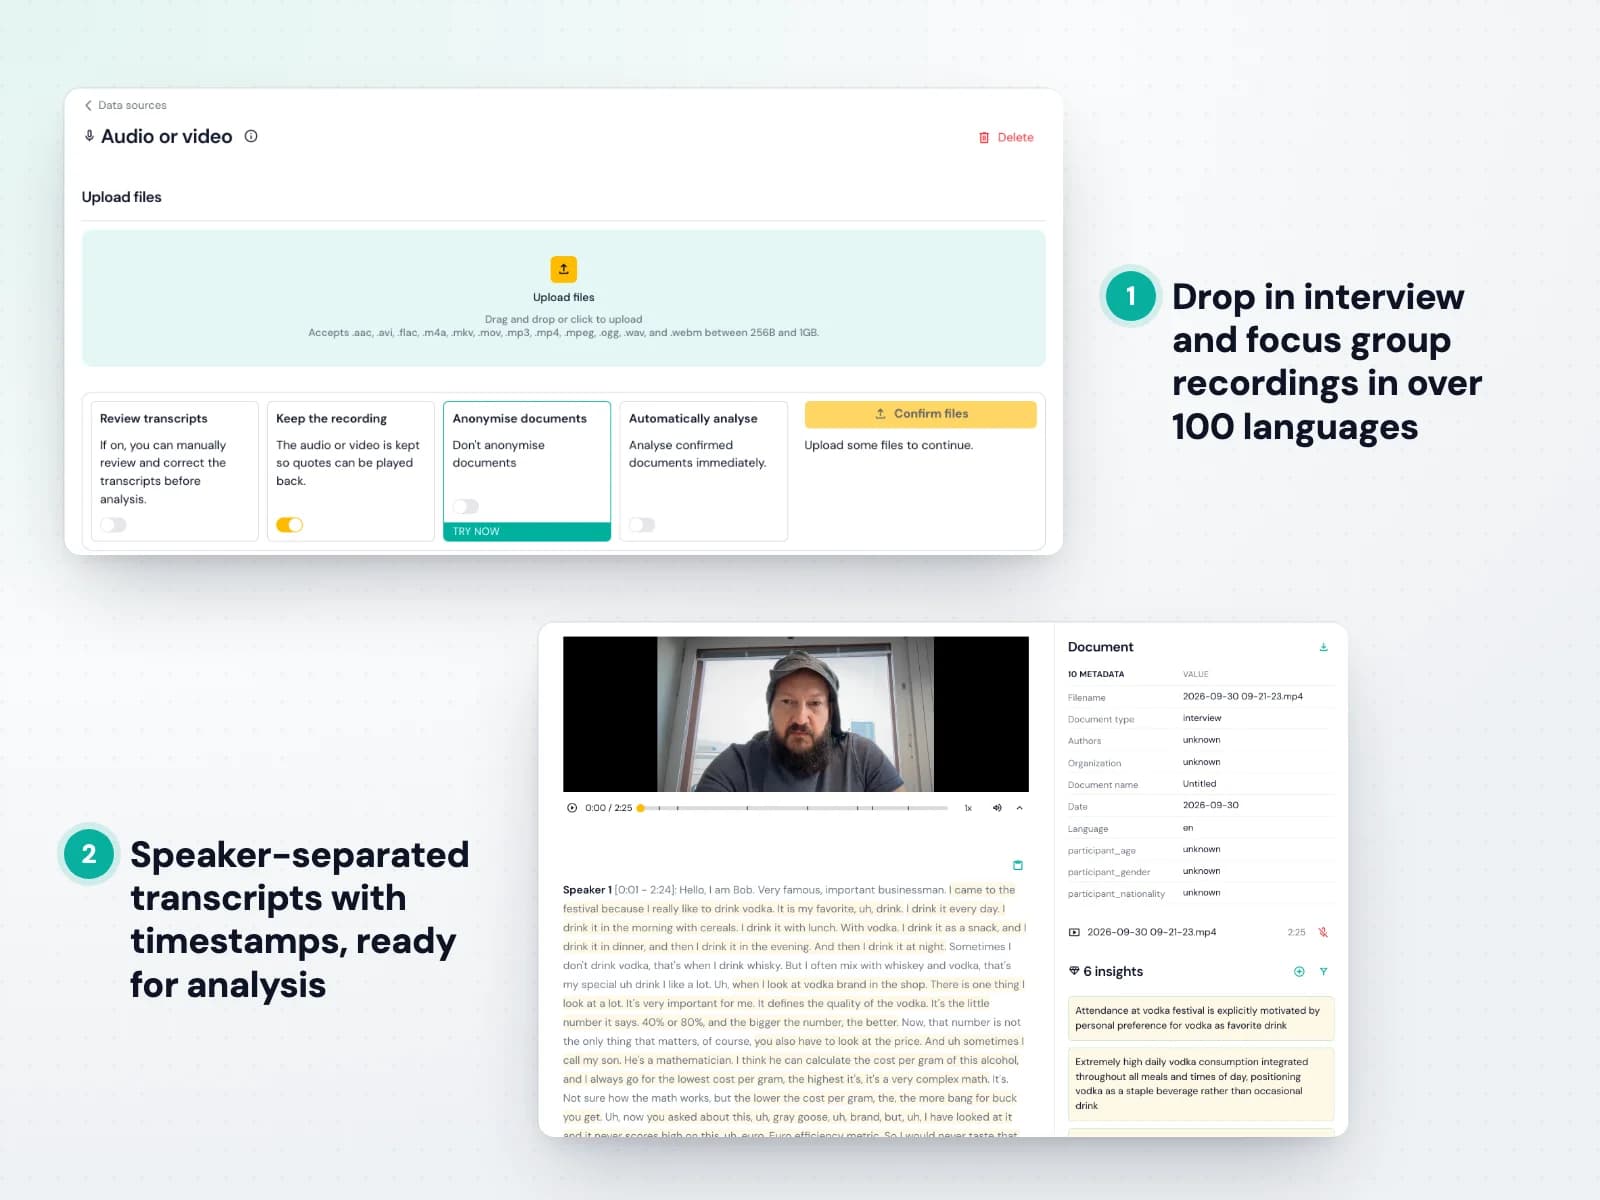
Upload audio of video en Skimle zet het om in nauwkeurige transcripten met meerdere sprekers in meer dan 100 talen. Er is geen aparte transcriptietool om voor te betalen en u hoeft geen bestanden tussen systemen heen en weer te schuiven: de tekst komt rechtstreeks in uw project terecht. Lees hoe u opnamen uploadt.
Per databron kiest u of u transcripten vóór de analyse wilt controleren, of elke opname bewaard blijft om af te spelen of wordt verwijderd zodra het transcript klaar is, en of de tekst eerst wordt geanonimiseerd voordat er iets anders gebeurt.
- MP3, M4A, WAV, MP4, MOV en andere gangbare formaten
- Sprekerscheiding en tijdcodes
- Optionele handmatige controle vóór de analyse
Documenten uploaden
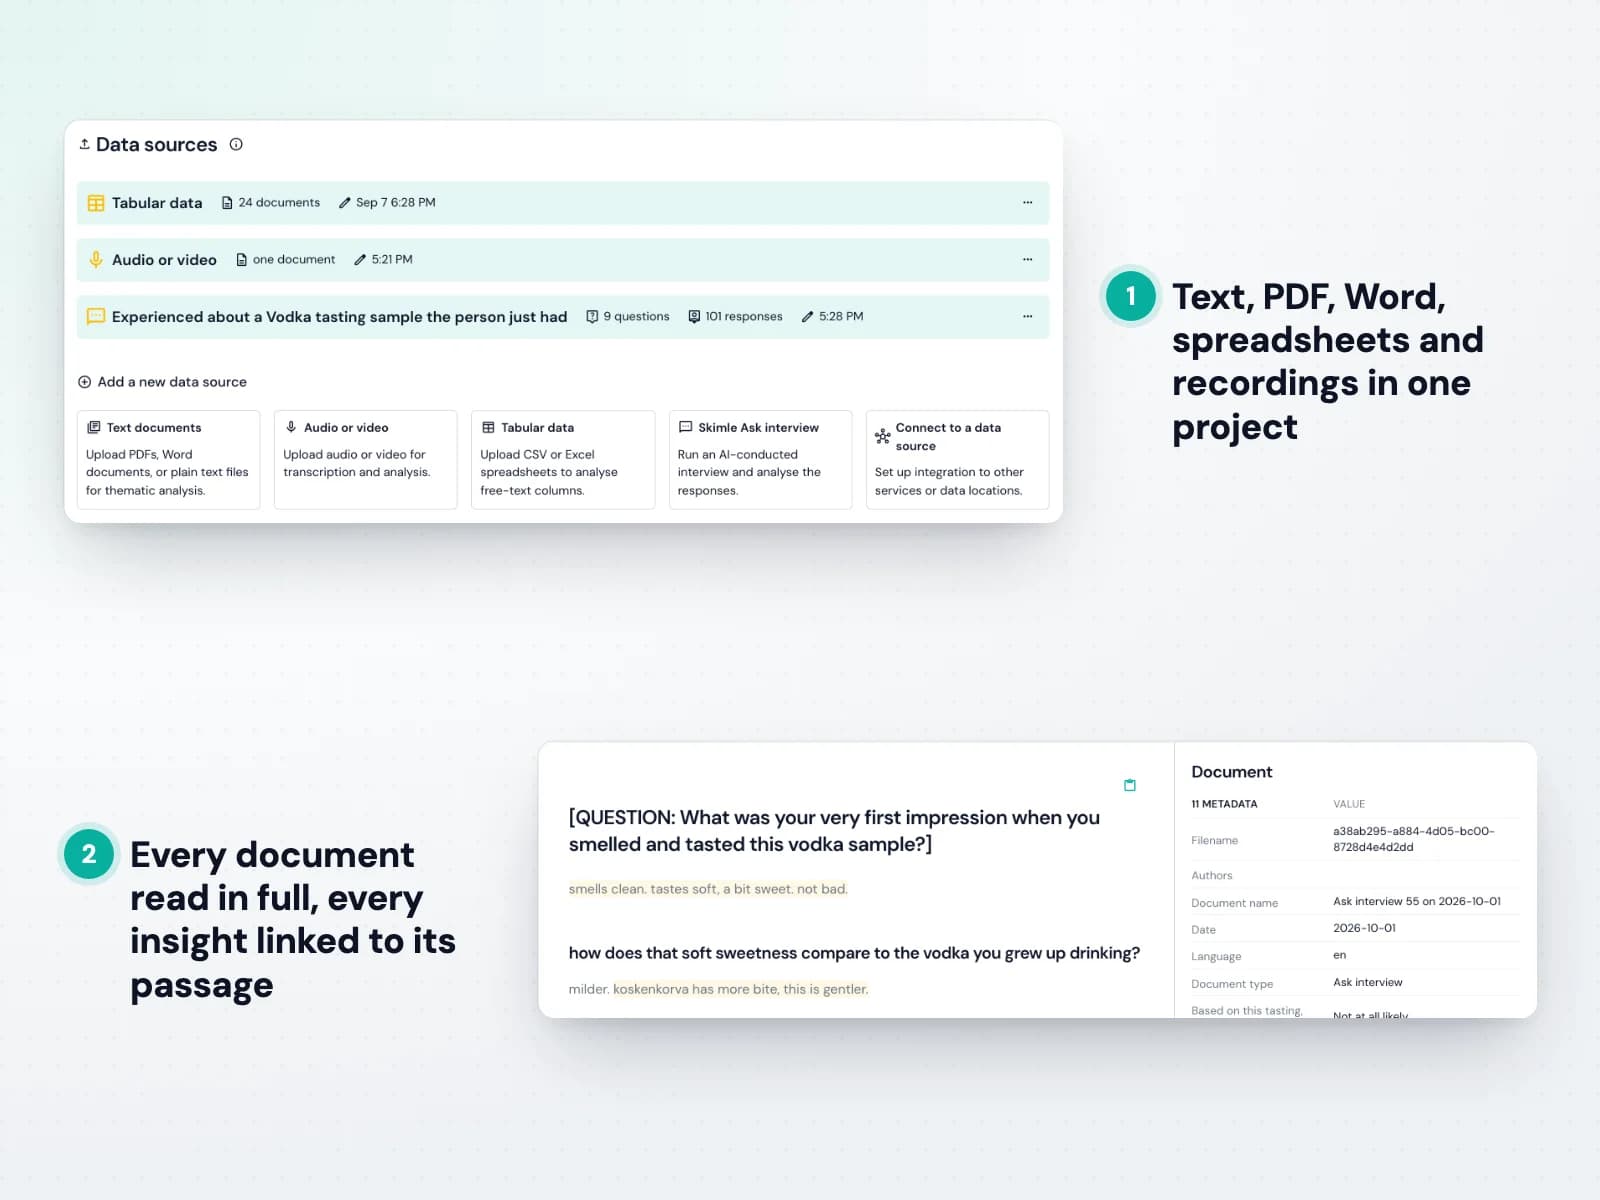
Breng interviewtranscripten, rapporten, artikelen, notities en open antwoorden in de formaten die u al gebruikt, en combineer vrij verschillende talen in één project. Bekijk de ondersteunde formaten.
Skimle leest elk document volledig en bewaart bij elk inzicht een link naar de exacte passage waar het vandaan komt, zodat er niets verloren gaat en alles te controleren is.
- PDF, Word (DOCX), RTF en TXT
- Meer dan 100 talen, gecombineerd in één project
- Elk inzicht gekoppeld aan de bronpassage
Datasets importeren
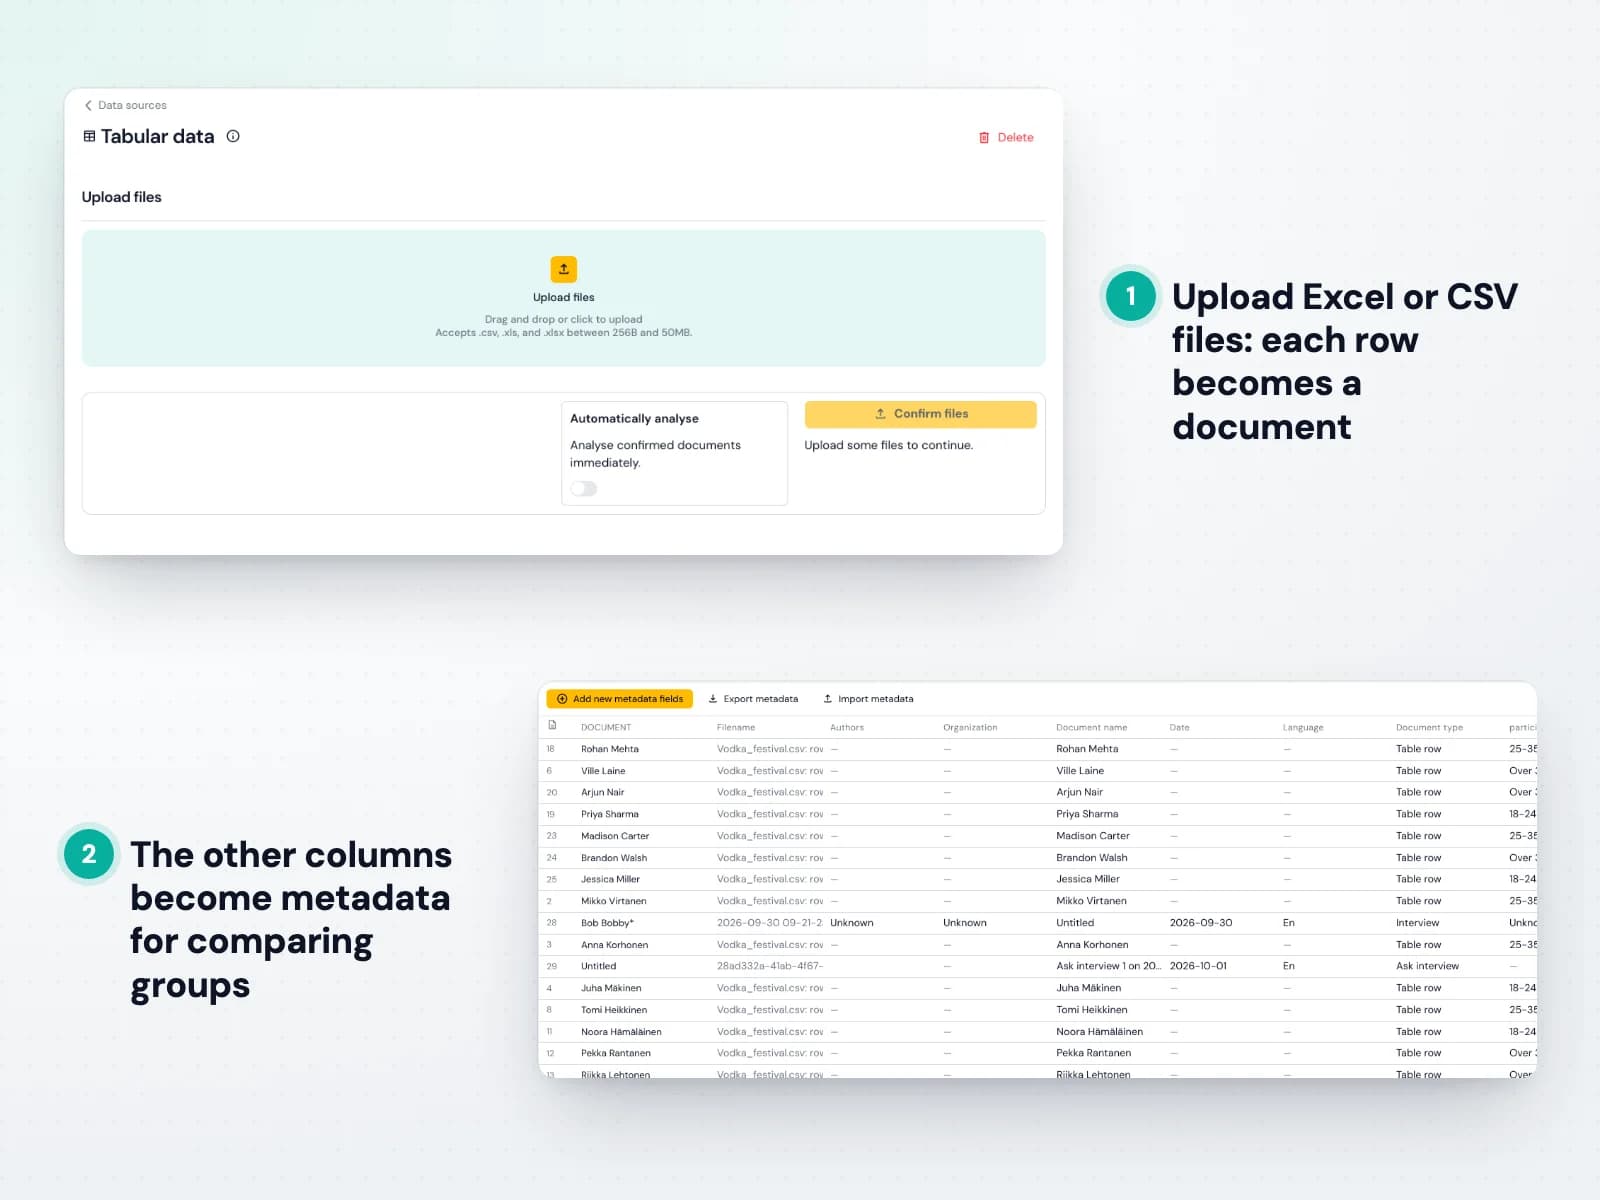
Importeer spreadsheets en enquête-exports in één keer. Elke rij wordt een document en per kolom bepaalt u of het inhoud, metadata of te negeren is. Lees hoe u importeert en metadata toevoegt.
Omdat de metadata bij elk antwoord meegaat, kunt u later vergelijken wat verschillende groepen respondenten zeiden, bijvoorbeeld nieuwe tegenover trouwe klanten, of de ene regio tegenover de andere.
- Import van Excel en CSV
- Kies inhouds- en metadatakolommen
- Duizenden antwoorden per project
Interviewen met Skimle Ask
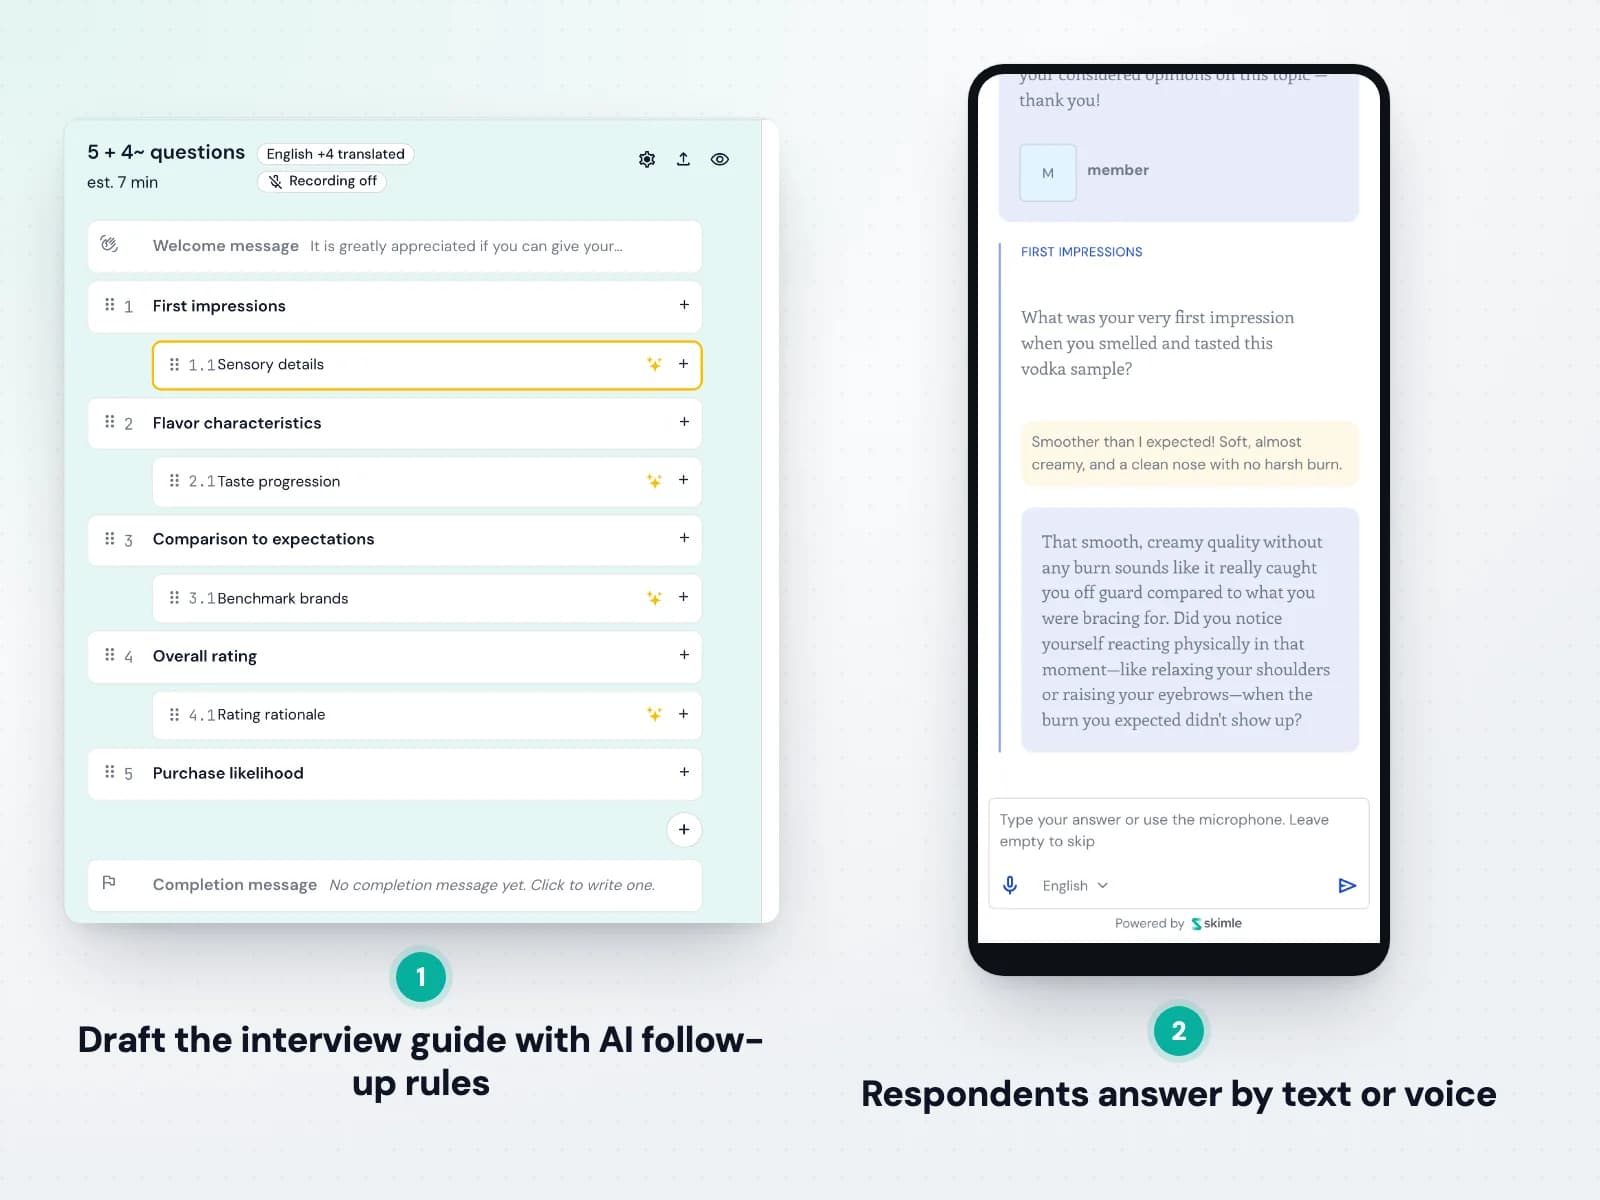
Skimle Ask voert kwalitatieve interviews af op de schaal van een enquête. Beschrijf wat u wilt weten, laat AI een opzet voor de interviewleidraad maken en verfijn elke vraag en de bijbehorende instructies voor vervolgvragen. Lees hoe u een Ask-interview maakt.
Respondenten openen een link, antwoorden met tekst of spraak, en de AI-interviewer vraagt door zoals een ervaren onderzoeker. Afgeronde interviews gaan rechtstreeks naar de analyse, naast uw andere data.
- Open vragen en meerkeuzevragen
- AI-vervolgvragen met een diepgang die u zelf bepaalt
- Interviews in meerdere talen

Anonimiseren
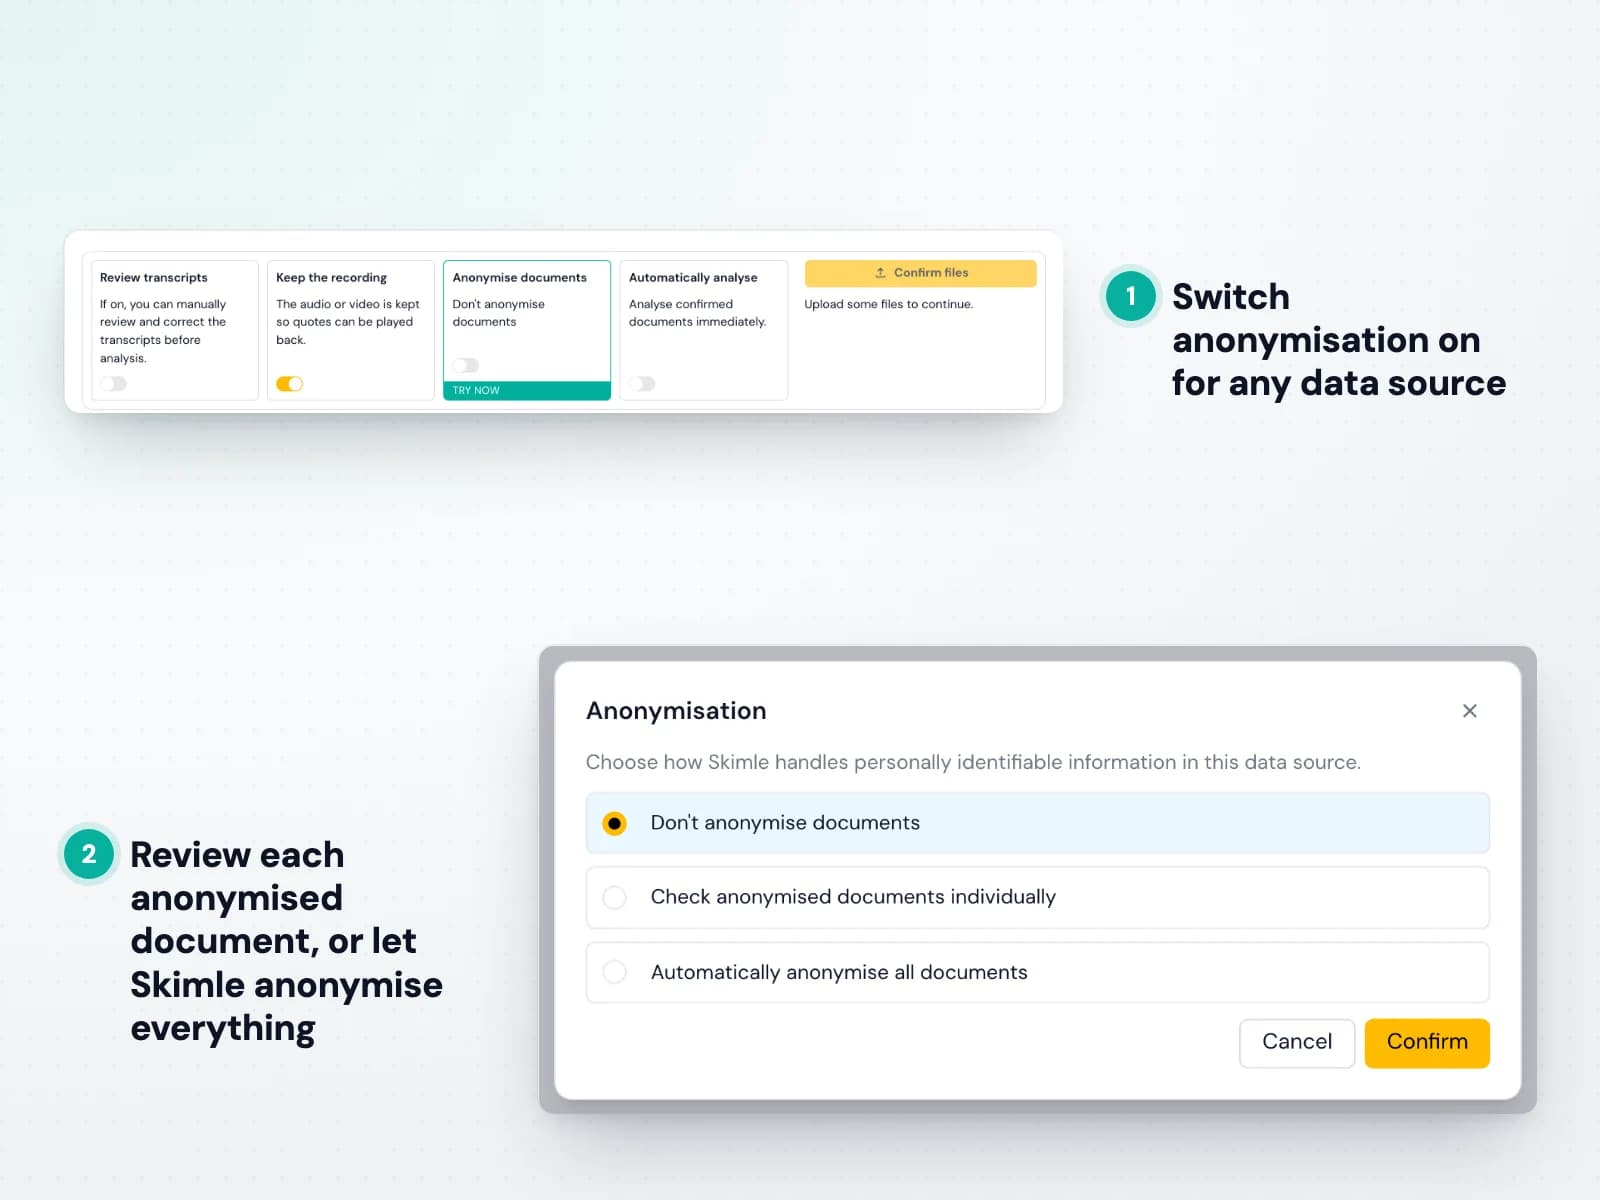
Skimle Anonymise herkent persoonsgegevens in zes categorieën en vervangt ze voordat uw data wordt geanalyseerd. Schakel het per databron in en kies of u elk document wilt controleren of alles automatisch wilt anonimiseren. Lees hoe anonimisering werkt.
Dezelfde persoon krijgt in al uw documenten hetzelfde pseudoniem, zodat de analyse samenhangend blijft, en respondenten kunnen vrijuit spreken in de wetenschap dat ze niet te identificeren zijn.
- Namen, functies, locaties, organisaties, datums en andere identificerende gegevens
- Consistente pseudoniemen in alle documenten
- Auditrapport en vertaaltabel voor ethische commissies
Maak kennis met Skimle Anonymise: grondige pseudonimisering van kwalitatieve data
Anonimiseringstools voor kwalitatief onderzoek in 2026: De-ID, Textwash, Presidio, MAXQDA en Skimle vergeleken
Kwalitatieve onderzoeksdata anonimiseren en pseudonimiseren: IRB-conforme de-identificatie van interviewtranscripten
Stap 2
Uw data analyseren en verkennen
Een grondige analysemachine met volledige transparantie en controle, mixed-methods-weergaven, vergelijkingen op metadata en een AI-onderzoeksassistent.
Grondige analyse als kern
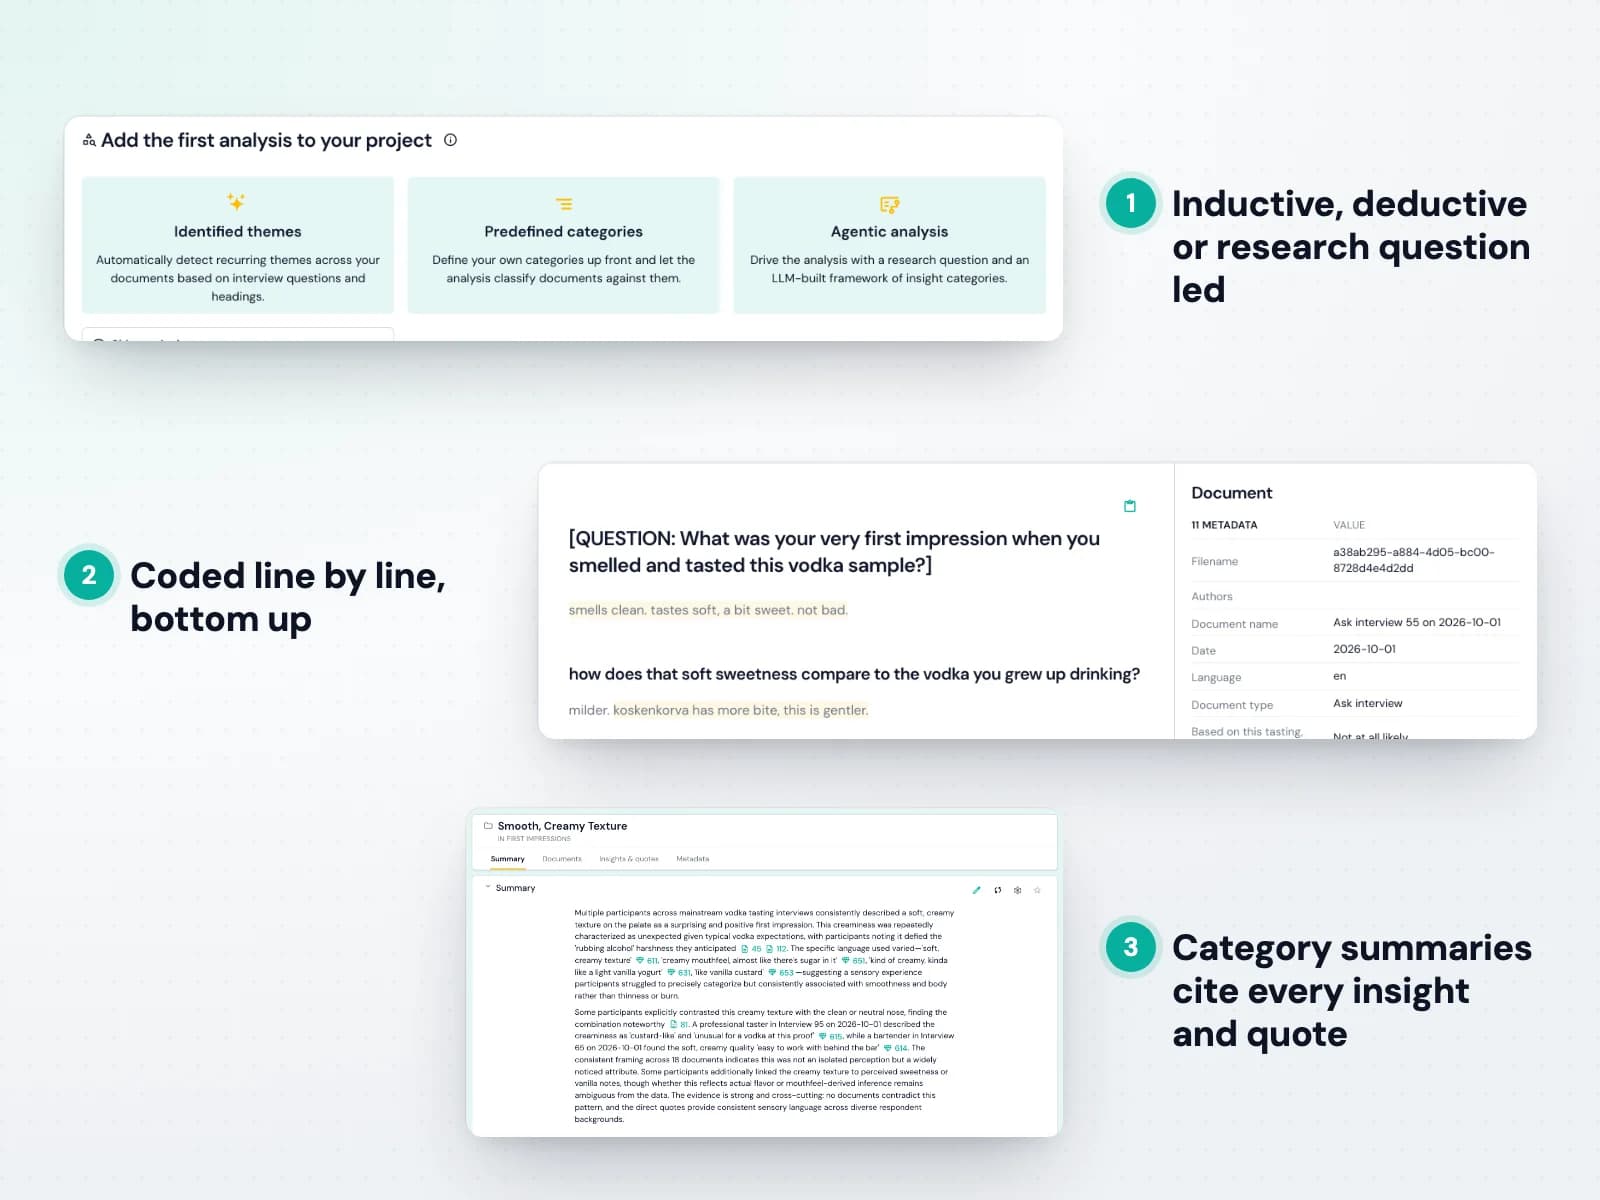
Skimle volgt gevestigde kwalitatieve methoden in plaats van samen te vatten. Het leest elk document volledig, identificeert inzichten van onderaf en ordent ze in categorieën, elk gekoppeld aan het broncitaat. Lees hoe de analyse werkt.
Kies voor geïdentificeerde thema's om de structuur uit de data te laten ontstaan, voor vooraf gedefinieerde categorieën om te coderen volgens uw eigen categoriesysteem, of voor een agentische analyse die wordt gestuurd door uw onderzoeksvraag. Samenvattingen per categorie verwijzen vervolgens naar elk inzicht en elk citaat waarop ze rusten.
- Inductieve, deductieve en door de onderzoeksvraag gestuurde analyse
- Elk inzicht gekoppeld aan een letterlijk citaat
- Samenvattingen die hun bewijs citeren
Volledige controle en transparantie
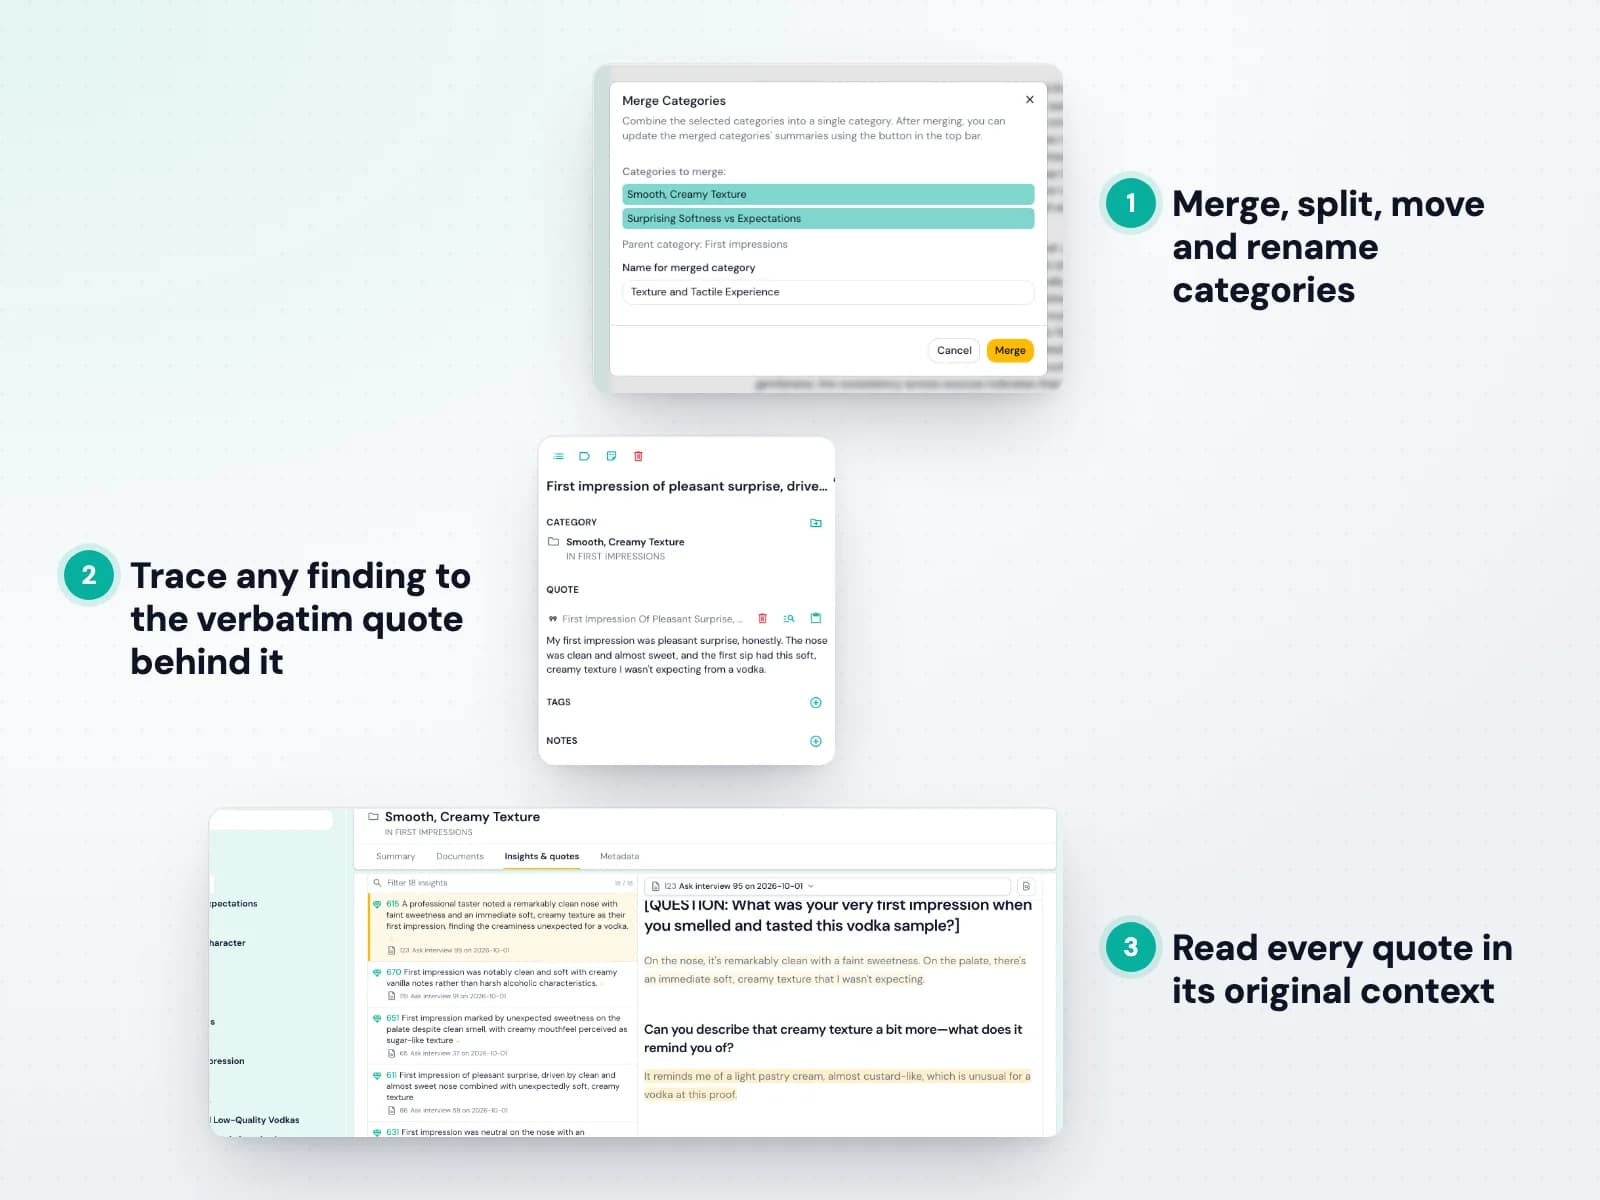
Dankzij de tweerichtingstransparantie van Skimle kunt u het werk altijd controleren. Klik op een verwijzing in een samenvatting om het inzicht en het letterlijke citaat erachter te zien, en open het document om precies te zien wat wel en niet gecodeerd is. Lees hoe u categorieën beheert.
Past de structuur niet bij uw denkwijze, verander haar dan: voeg overlappende categorieën samen, splits te brede categorieën, geef ze een naam in uw eigen woorden en verplaats inzichten tussen categorieën. Elke wijziging kan ongedaan worden gemaakt.
- Categorieën samenvoegen, splitsen, verplaatsen en hernoemen
- Bevindingen herleiden tot de bron, en bronnen tot de bevindingen
- Elke wijziging ongedaan maken
Mixed methods gebruiken en data visualiseren
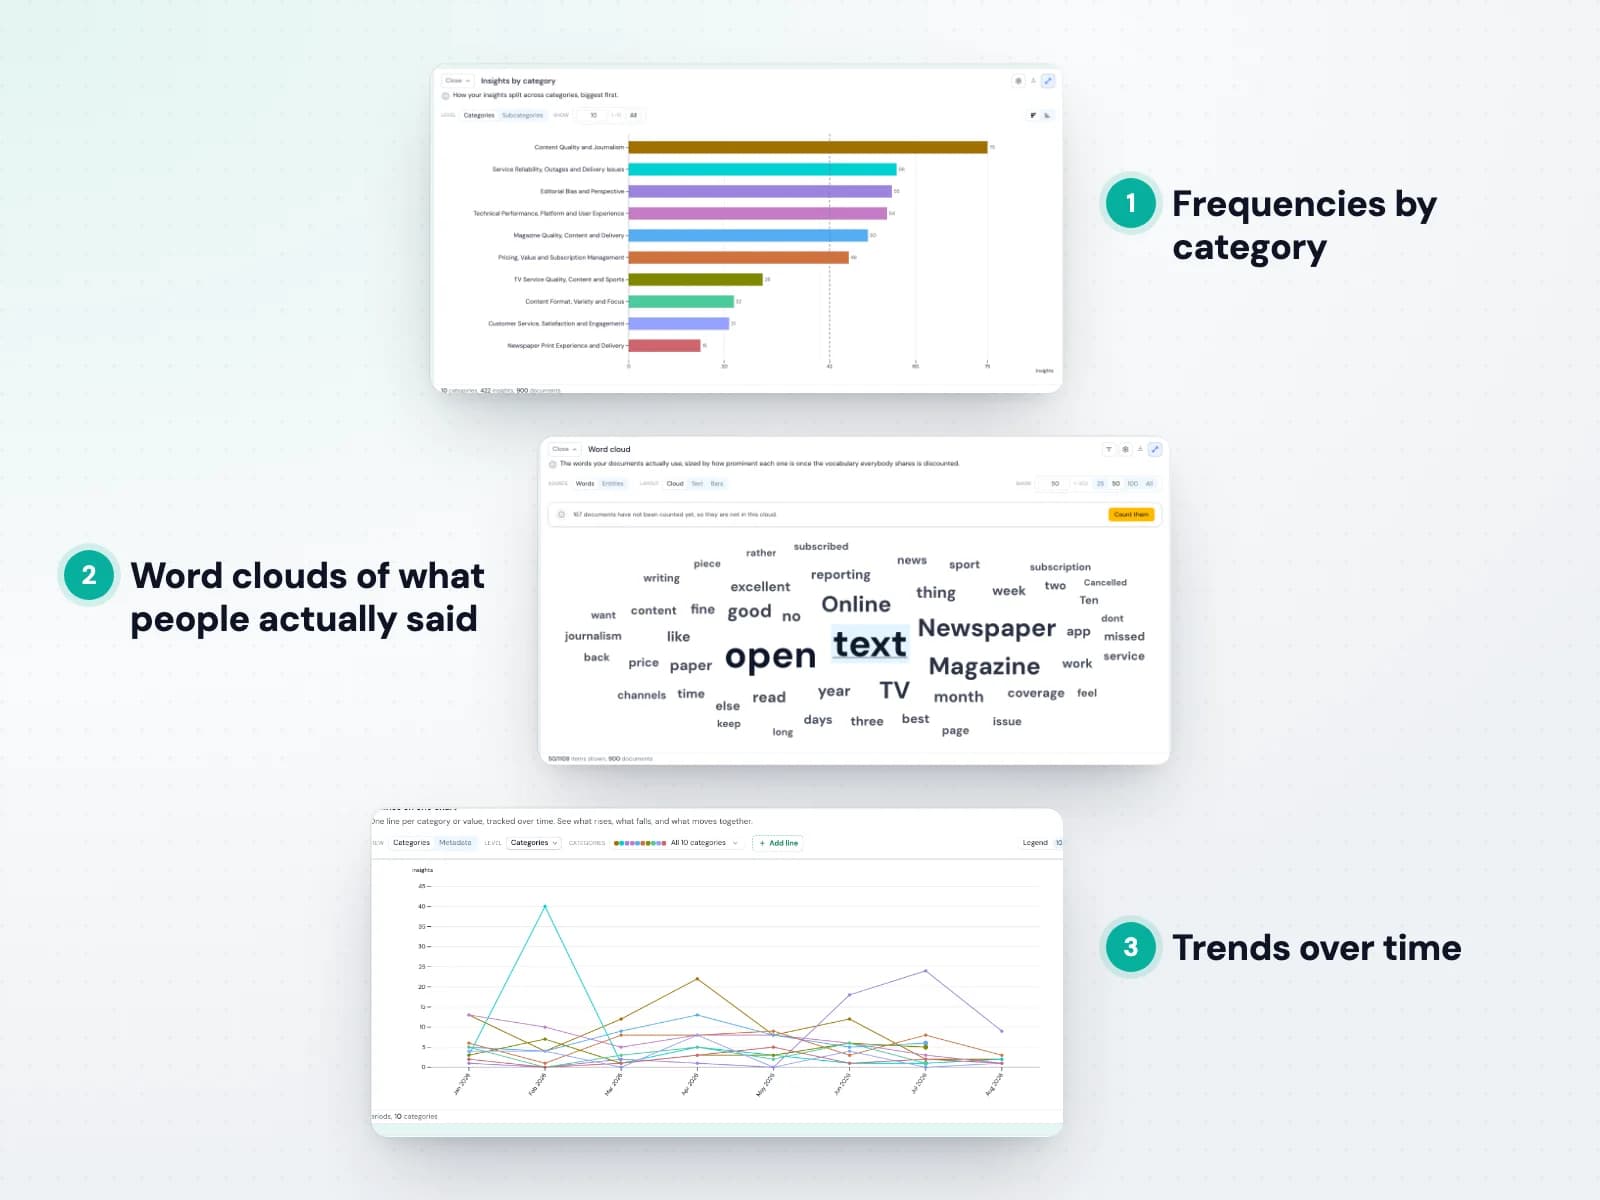
Uw gecodeerde data wordt cijfers die u kunt vertrouwen, omdat elke telling rust op geverifieerde inzichten. Verken frequenties per categorie, woordwolken, heatmaps over documenten en trends in de tijd. Bekijk de statistiekweergave.
De weergaven worden bijgewerkt terwijl u de structuur verfijnt, en elke balk of elk punt leidt terug naar de inzichten en citaten erachter, zodat de cijfers en de verhalen altijd overeenkomen.
- Frequenties, woordwolken en heatmaps
- Trends in de tijd
- Elk getal herleidbaar tot de citaten
Patronen ontdekken met metadata

Vergelijk twee willekeurige groepen documenten op hun metadata en Skimle laat zien welke categorieën de ene groep vaker aankaart dan de andere. Vervolgens beschrijft het, met verwijzingen, wat de groepen onderscheidt en wat ze gemeen hebben. Lees hoe u metadata analyseert.
Weet u niet welke indeling ertoe doet? Skimle rangschikt elke indeling op metadata naar hoe ver ze de groepen uit elkaar trekt, zodat u de verschillen vindt die het rapporteren waard zijn in plaats van ze één voor één te testen.
- Groepsvergelijkingen met geschreven samenvattingen
- Elke indeling gerangschikt naar effectgrootte
- Metadata uit uw data of afgeleid door AI
Agentische chat als uw onderzoeksassistent
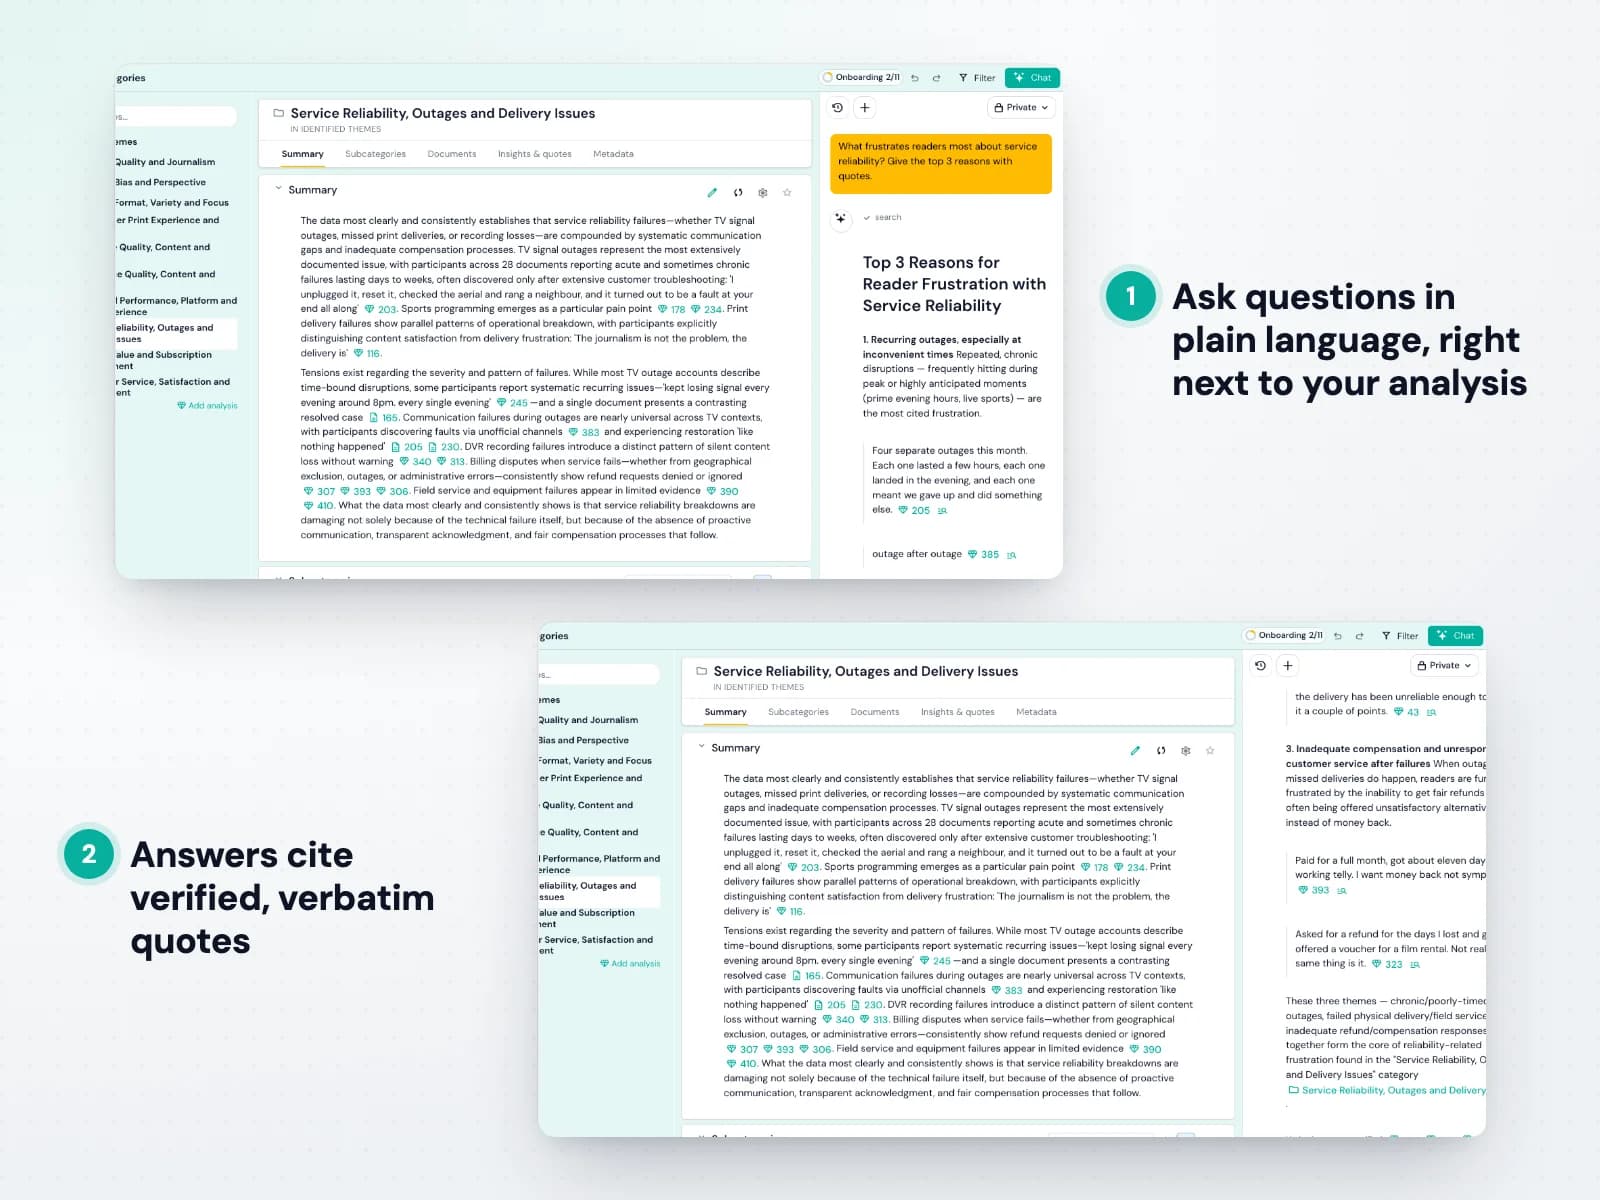
De onderzoeksassistent werkt op uw gestructureerde analyse in plaats van op ruwe documenten. Stel vragen in gewone taal en hij doorzoekt uw gecodeerde inzichten, redeneert in stappen die u kunt volgen en antwoordt met geverifieerde, letterlijke citaten. Lees hoe u de AI-chat gebruikt.
Hij kan ook handelen op basis van de analyse: inzichten aanmaken, categorieën herordenen en notities toevoegen, allemaal via dezelfde opdrachten die u zelf gebruikt, zodat elke wijziging zichtbaar en omkeerbaar blijft.
- Antwoorden onderbouwd met geverifieerde citaten
- Doorzoekt elk gecodeerd inzicht
- Kan de analyse herordenen en annoteren
Stap 3
Exporteren en integreren
Deel bevindingen als presentaties en rapporten, exporteer naar de tools die u gebruikt en koppel uw eigen systemen en AI-agents.
Overtuigende presentaties
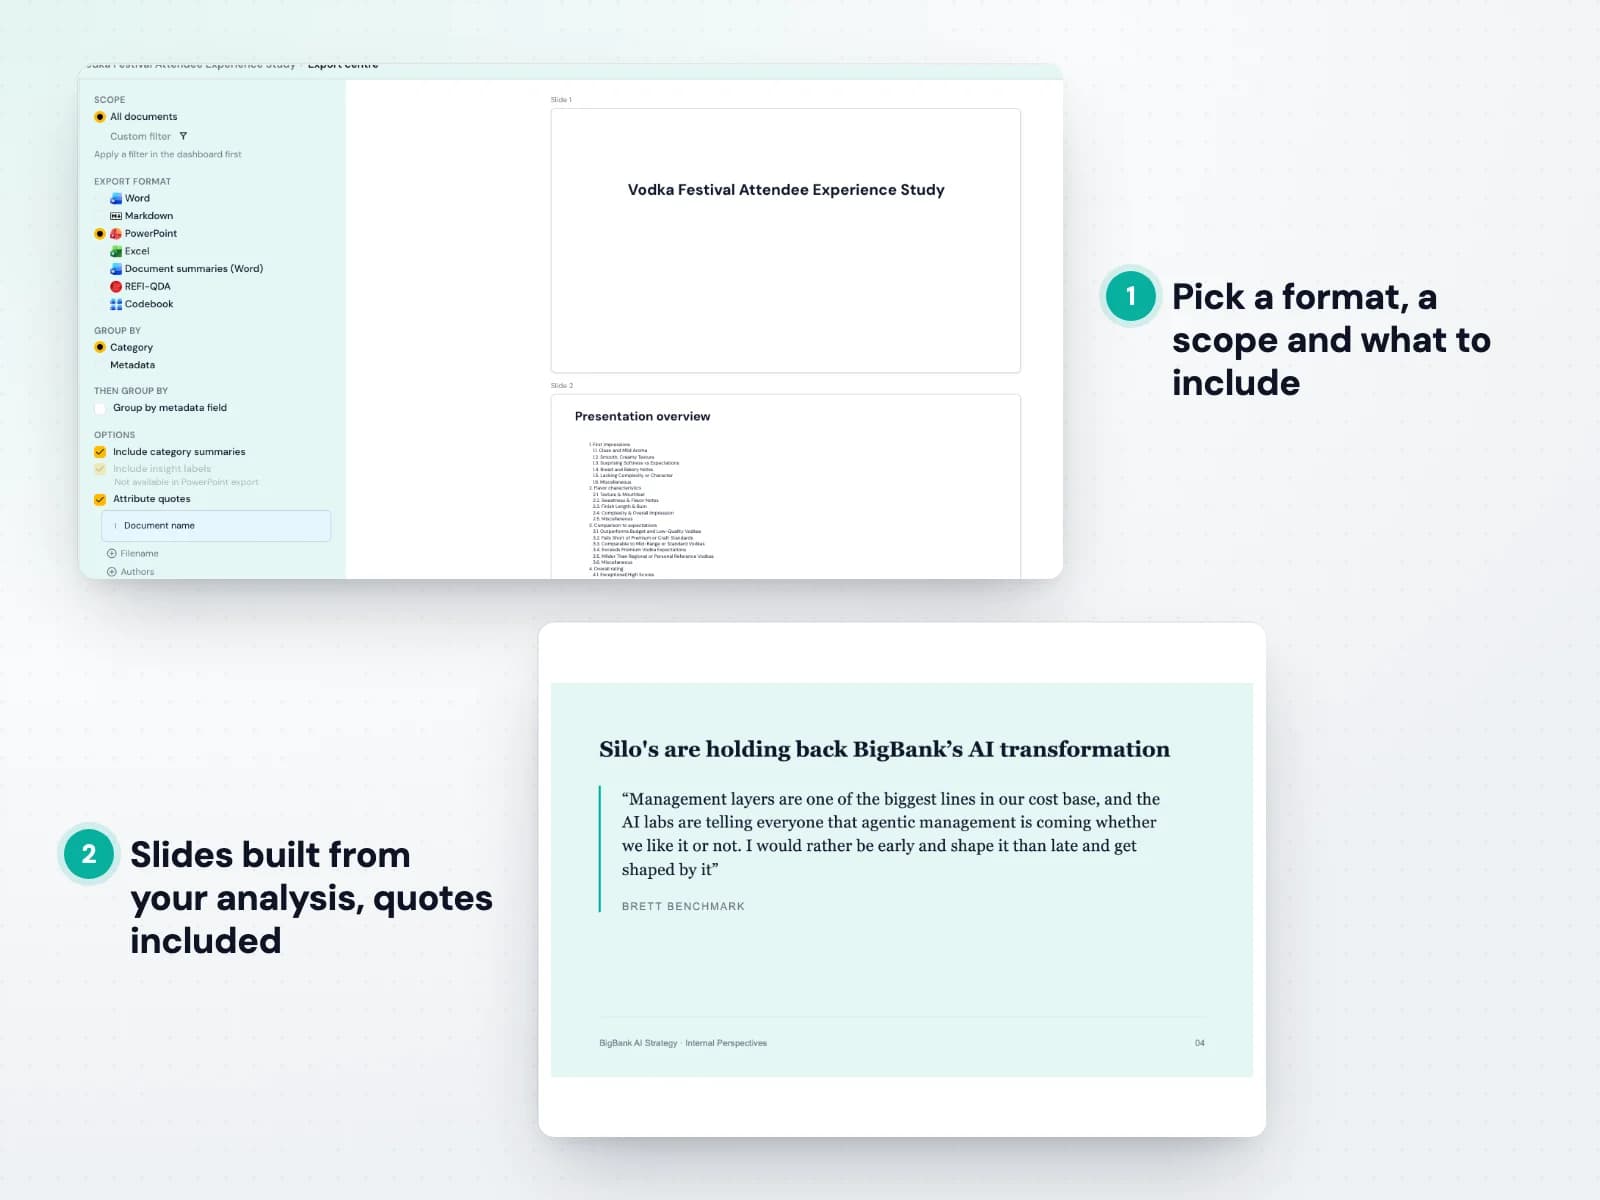
Exporteer uw analyse als PowerPoint-presentatie of Word-rapport. Kies de reikwijdte, groepeer de bevindingen per categorie of metadata en bepaal of u samenvattingen, verwijzingen en toegeschreven citaten wilt opnemen. Lees hoe u naar Office exporteert.
Het resultaat is een kant-en-klaar startpunt voor uw rapport of presentatie: thema's, bewijs en citaten staan al op hun plaats, elk herleidbaar tot de analyse.
- PowerPoint-presentaties en Word-rapporten
- Samenvattingen, verwijzingen en toegeschreven citaten
- Reikwijdte en groepering naar keuze
API- en MCP-koppelingen
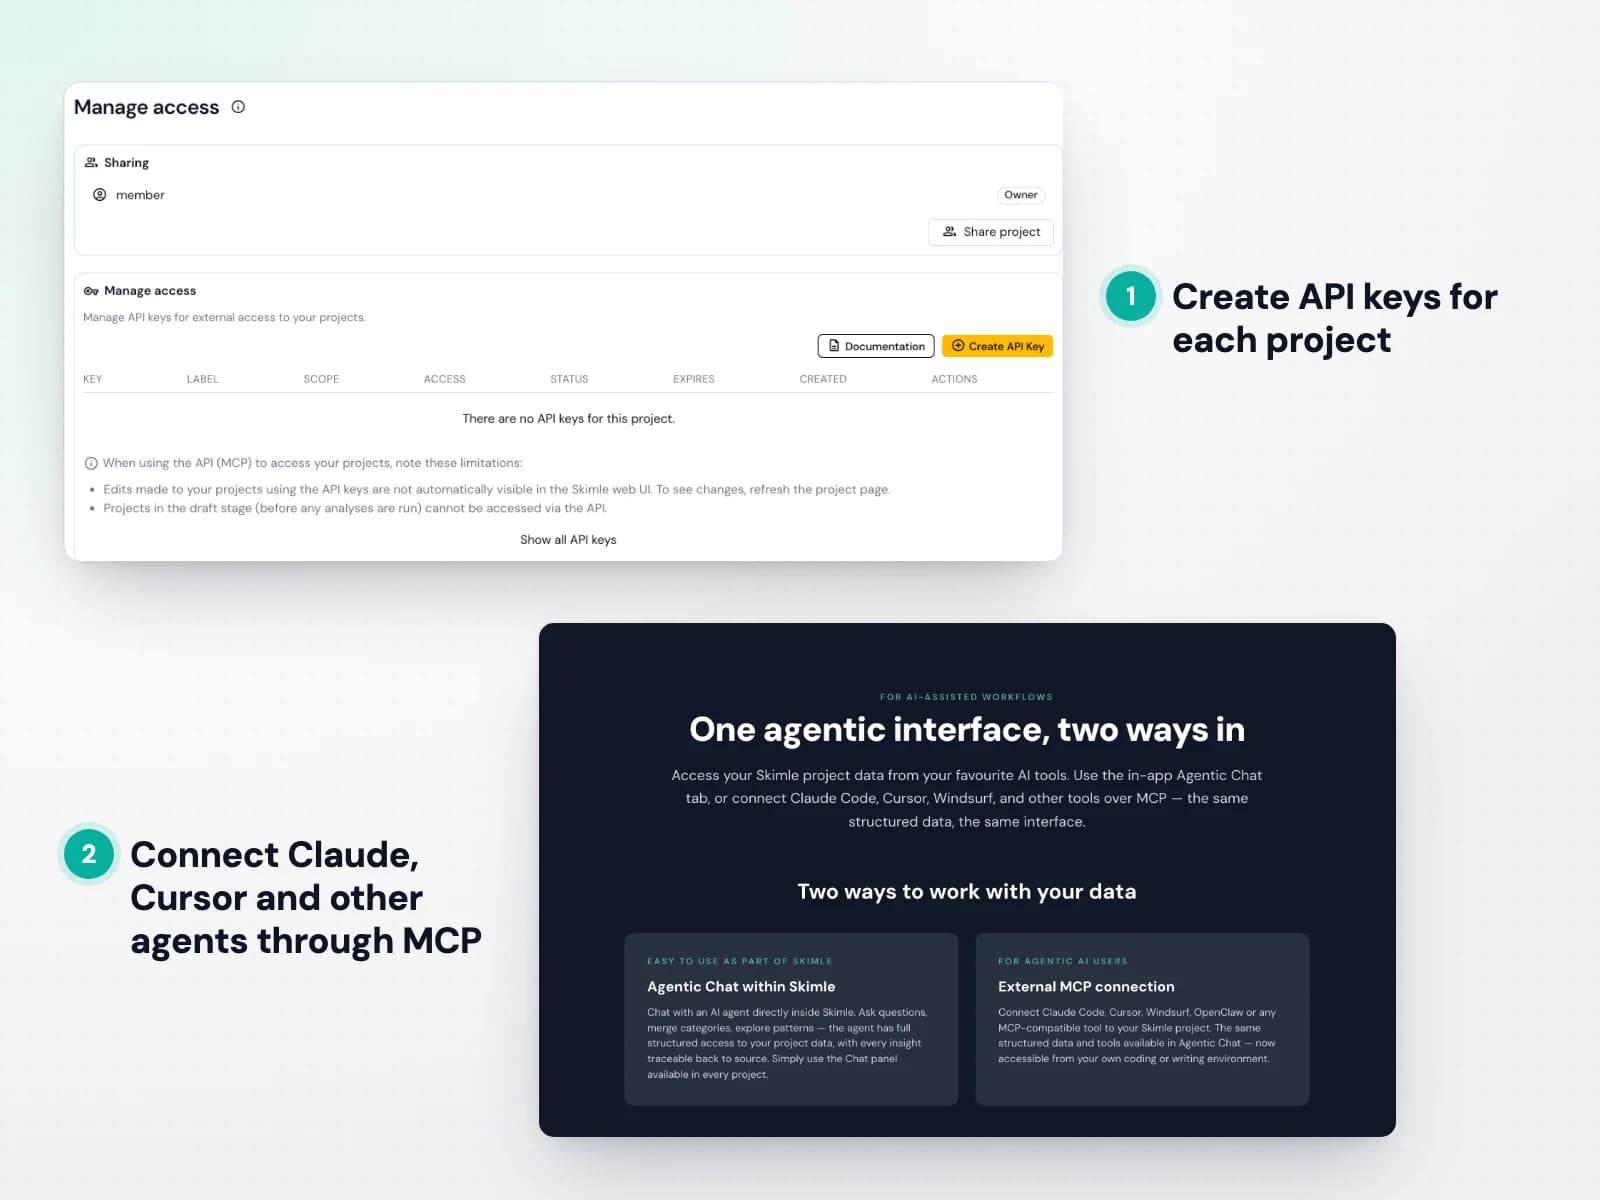
Met de MCP-server van Skimle kunnen Claude, Cursor, Windsurf en andere compatibele agents met uw gestructureerde projectdata werken, met dezelfde tools die de ingebouwde agent gebruikt. Lees meer over verbinden via MCP.
Met de REST API kunnen uw eigen systemen projectdata lezen en schrijven of een project van begin tot eind uitvoeren. Maak API-sleutels per project aan, met lees- of bewerkrechten, via de toegangsinstellingen van het project.
- MCP voor Claude, Cursor en andere agents
- REST API om projectdata te lezen en te schrijven
- API-sleutels per project
Data-exports
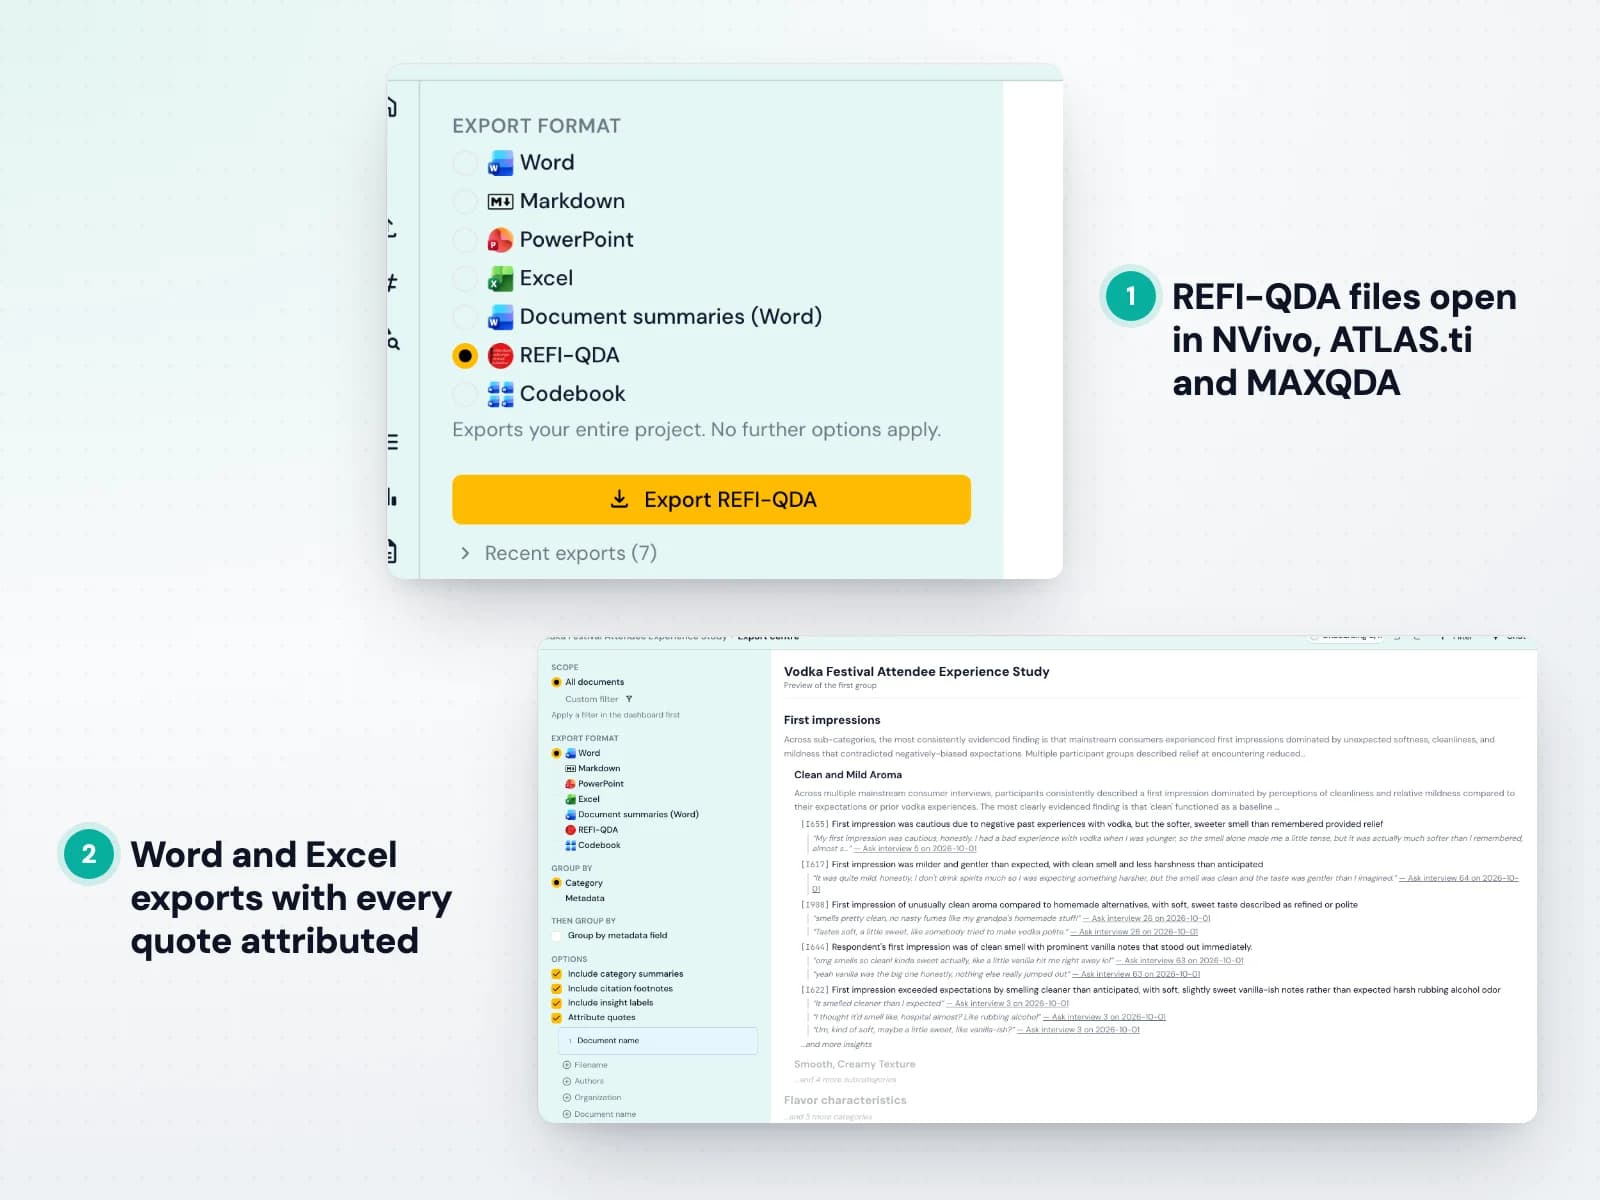
Neem uw analyse mee waar u maar wilt: Excel voor de volledige Skimle-tabel, Word met codering als opmerkingen en het open REFI-QDA-formaat voor NVivo, ATLAS.ti en MAXQDA. Lees hoe u naar REFI-QDA exporteert.
Exporteer het categoriesysteem, bewaar een kopie van de volledige analyse bij uw onderzoeksdata of ga verder met handmatig coderen in een traditionele tool.
- Excel, Word en REFI-QDA (.qdpx)
- Export van het categoriesysteem
- Werkt met NVivo, ATLAS.ti en MAXQDA
Platform
Veilig platform om samen te werken
Gegevensbescherming op enterpriseniveau, terwijl uw team samenwerkt aan één gedeelde analyse.
Veilig platform
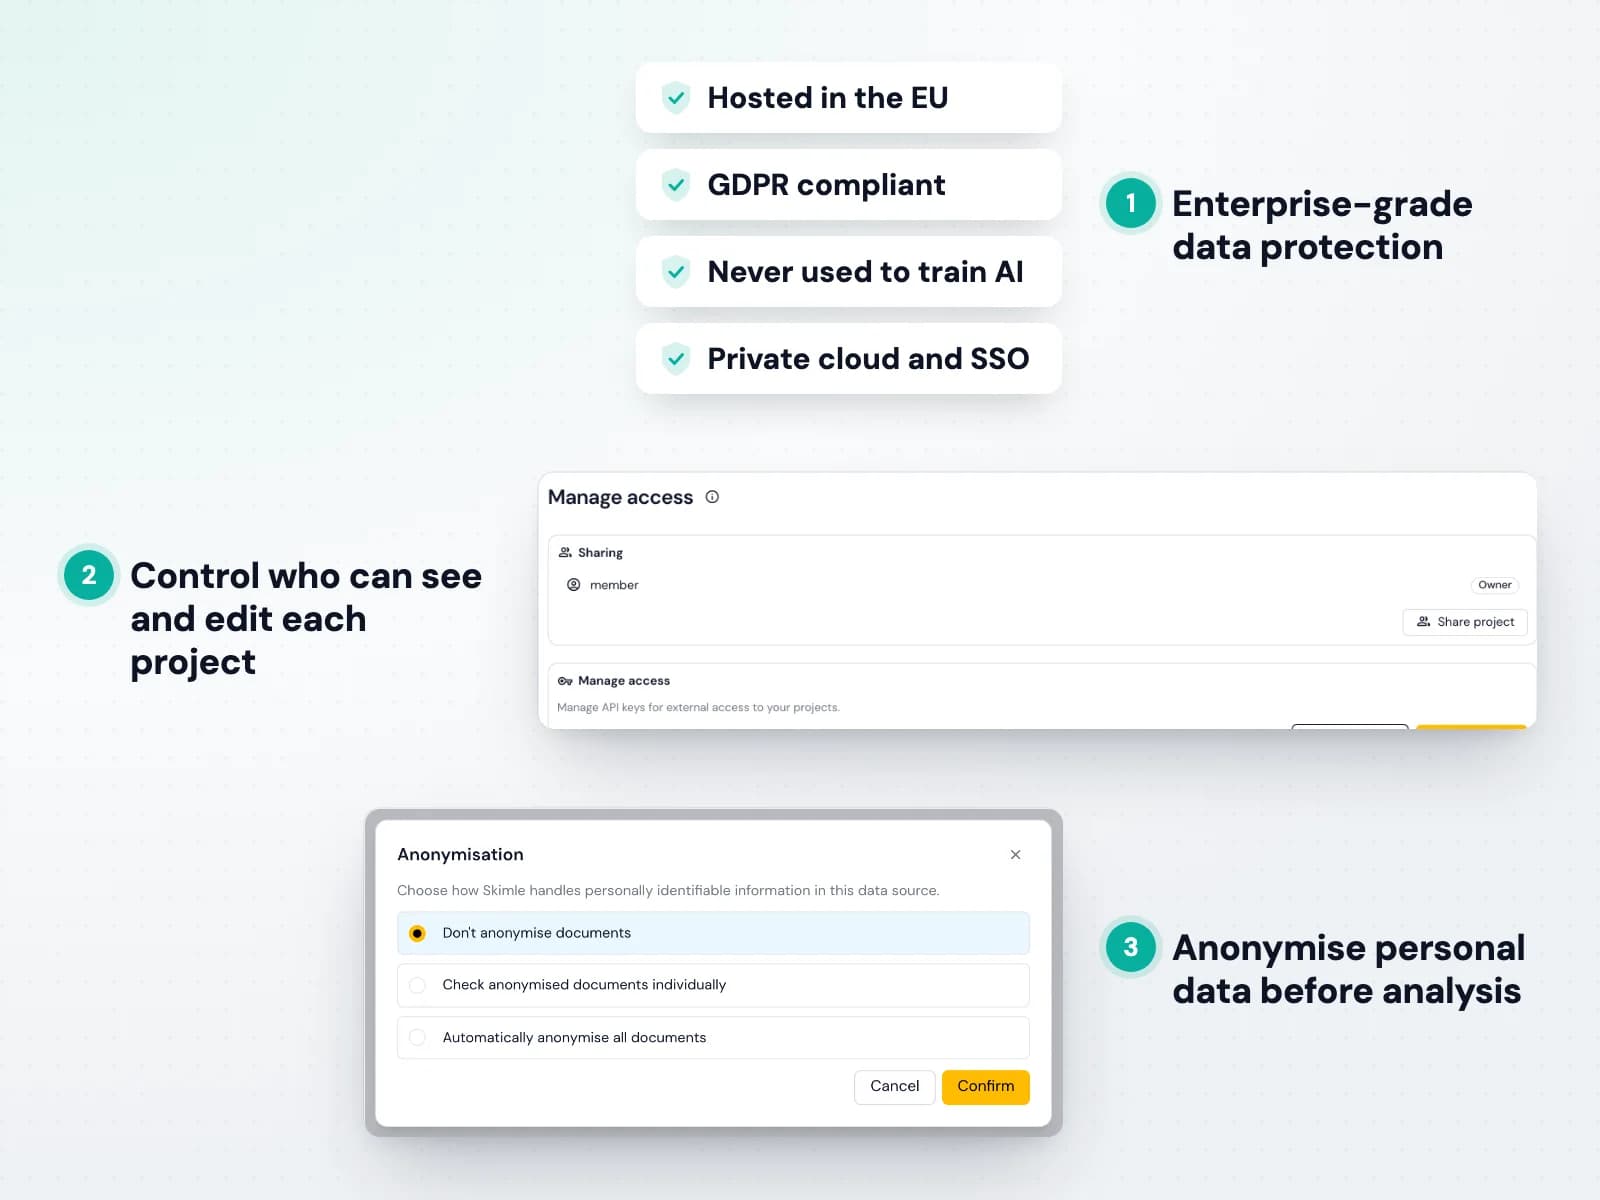
Skimle is gebouwd voor gevoelig onderzoek. Alle data wordt gehost in de EU, versleuteld tijdens transport en in opslag, en nooit gebruikt om AI-modellen te trainen. Lees ons privacybeleid.
U bepaalt wie elk project kan bekijken en bewerken, persoonsgegevens kunnen vóór de analyse worden geanonimiseerd en er is een verwerkersovereenkomst beschikbaar. Enterpriseklanten kunnen kiezen voor een private cloud en single sign-on.
- Hosting in de EU en naleving van de AVG
- Nooit gebruikt om AI-modellen te trainen
- Private cloud en SSO voor grote organisaties
Samenwerken
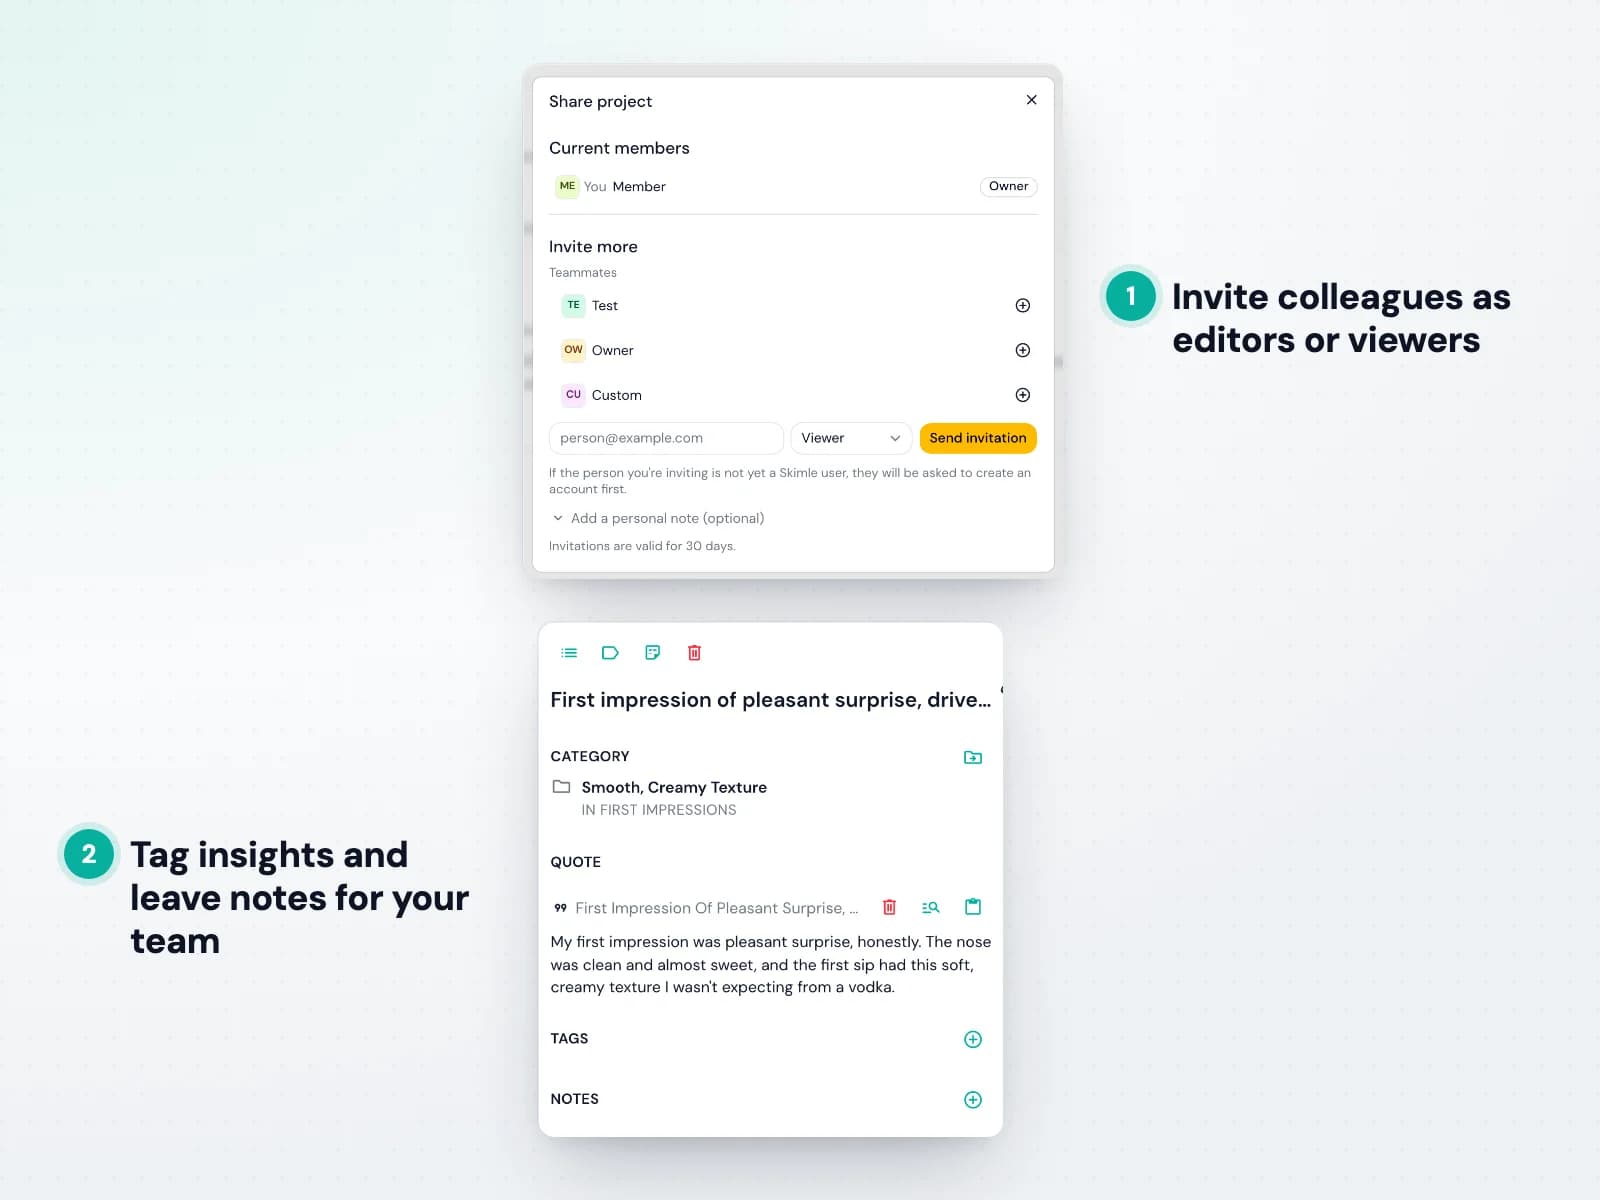
Een Skimle-project is een gedeelde werkomgeving. Nodig collega's uit als bewerkers die kunnen uploaden en bewerken, of als kijkers die alles kunnen verkennen zonder iets te wijzigen. Lees hoe delen werkt.
Codeerbeslissingen, tags en notities staan op één plek, zodat een onderzoeksteam, een klant of een begeleider altijd naar dezelfde, actuele analyse kijkt.
- Rollen voor bewerkers en kijkers
- Tags en notities bij inzichten
- Eén gedeelde, actuele analyse
Hoe verhoudt Skimle zich tot andere tools
Handmatige tools zijn grondig maar traag, generieke AI is snel maar niet te controleren, en verticale tools zijn gebouwd voor één taak tegen een premiumprijs. Alleen Skimle combineert een grondige analysemachine, volledige transparantie en veelzijdigheid, vanaf € 20 per gebruiker per maand.
| Handmatige tools NVivo, MAXQDA, ATLAS.ti… | Generieke AI-tools ChatGPT, Claude… | Verticale tools CoLoop, Listen Labs… | Skimle | |
|---|---|---|---|---|
| Grondige analysemachine |  | | | |
| Tweerichtingstransparantie, van samenvatting tot bron | | | | |
| Veelzijdig voor alle soorten data en toepassingen | | | | |
| Snel | | | | |
| Makkelijk te leren | | | | |
| Prijs | ~€ 80 per gebruiker per maand | ~€ 20 per gebruiker per maand | € 400+ per maand | Vanaf € 20 per maand, gratis proefperiode |
| Schaal | Beperkt door de inspanning van handmatig coderen | Beperkte context, dekking niet te verifiëren | Verschilt per tool | Duizenden documenten per project |
| AVG en gegevensbeveiliging | Afhankelijk van de implementatie | Afhankelijk van abonnement en instellingen | Verschilt per leverancier | Ingebouwd · servers in de EU · verwerkersovereenkomst beschikbaar |
| Oordeel | Grondigheid van publicatiekwaliteit, maar weken handmatig coderen per project. | Snel, maar antwoorden verschillen per prompt en zijn niet te herleiden of te verdedigen. | Gebouwd voor één werkwijze, vaak tegen enterpriseprijzen. | Grondigheid van academisch niveau met de snelheid van AI, volledig transparant, voor alle kwalitatieve data. |
Veelgestelde vragen
Veelgestelde vragen
- Wat is Skimle?
- Skimle is een AI-platform voor kwalitatieve data-analyse dat ongestructureerde documenten (interviews, rapporten, consultaties, klantfeedback) systematisch omzet in geordende, analyseerbare datasets die volledig herleidbaar zijn. Anders dan chatbots verwerkt Skimle uw hele documentenset vooraf: het haalt inzichten eruit en ordent die in hiërarchische thema's, waarbij elke bevinding gekoppeld is aan een geverifieerd letterlijk citaat.
- Waarin verschilt Skimle van ChatGPT of RAG-tools?
- RAG-tools zoeken relevante passages op op het moment dat u een vraag stelt, waardoor u bij dezelfde vraag telkens een ander antwoord krijgt. Skimle analyseert uw volledige dataset vooraf en systematisch, en bouwt zo een stabiele structuur waarin elk thema gekoppeld is aan geverifieerde citaten. U krijgt volledige dekking, consistente resultaten en volledige herleidbaarheid in plaats van antwoorden uit een black box.
- Waarin verschilt Skimle van NVivo, MAXQDA of ATLAS.ti?
- Traditionele tools vereisen dat u elke passage handmatig codeert: systematisch, maar tijdrovend, met weken tot maanden werk. Skimle automatiseert het coderen met AI en behoudt daarbij dezelfde systematische, transparante methodiek. U krijgt grondigheid van NVivo-niveau in een fractie van de tijd, met een intuïtievere cloud-native interface waarvoor u geen weken training nodig heeft.
- Kan ik Skimle gebruiken voor academisch onderzoek?
- Ja. Skimle is gebouwd door academici en geïnspireerd op gevestigde methodieken: thematische analyse (Braun & Clarke), grounded theory (Glaser & Strauss; Strauss & Corbin) en de Gioia-methode (Gioia, Corley & Hamilton). Dankzij de volledige audit trail van Skimle kunt u precies documenteren hoe thema's tot stand zijn gekomen, wat voldoet aan de eisen van peer review. Onderzoekers aan meer dan 30 universiteiten gebruiken Skimle, en op verzoek leveren wij een voorgestelde verwijzingstekst.
- Welke talen en bestandsformaten ondersteunt Skimle?
- Skimle ondersteunt meer dan 100 talen en accepteert PDF, Word (.docx), RTF, TXT, CSV, audio (MP3, M4A, WAV) en video (MP4, MOV). U kunt formaten en talen in één project combineren: upload Engelse interviews, Duitse rapporten en Spaanse enquêteantwoorden tegelijk. Audio en video worden automatisch getranscribeerd.
- Is Skimle AVG-conform en veilig?
- Ja. Alle data wordt opgeslagen in de Europese Unie en verlaat nooit servers in de EU. Skimle voldoet volledig aan de AVG en biedt verwerkersovereenkomsten voor institutionele klanten. Uw documenten worden nooit gebruikt om AI-modellen te trainen. Voor enterpriseklanten met strengere eisen aan datasoevereiniteit zijn single-tenant cloudimplementaties beschikbaar.
- Hoe voorkomt Skimle hallucinaties van AI?
- Elk inzicht dat Skimle genereert, wordt gecontroleerd aan de hand van de brondocumenten: als de AI tekst produceert die niet letterlijk in uw data voorkomt, markeert het systeem dit en verwerkt het de passage opnieuw. Dankzij tweerichtingstransparantie kunt u op elk thema klikken om de exacte onderbouwende citaten te zien, en elk document openen om te zien welke tekst gecodeerd is en welke niet. Zo kan er niets worden verzonnen of gemist.
- Hoe snel heb ik mijn eerste resultaten?
- De meeste projecten zijn binnen enkele minuten verwerkt. Grotere datasets met meer dan 1000 documenten kunnen meer tijd kosten. Een gangbare set van 10 tot 20 interviewtranscripten is meestal binnen een uur verwerkt. U kunt dezelfde dag uploaden, een analyse starten en gestructureerde thema's met onderbouwende citaten verkennen, zonder installatie of training.
- Heb ik technische kennis nodig om Skimle te gebruiken?
- Nee. Skimle is ontworpen voor kwalitatieve onderzoekers, analisten en consultants, niet voor engineers. U uploadt uw documenten, beschrijft uw onderzoeksvraag en Skimle doet de rest. Categorieën bewerken, thema's verkennen en rapporten exporteren gaat allemaal met een paar klikken. Geen programmeren, scripts of AI-expertise nodig.
- Hoe werken de prijzen? Is er echt een gratis proefperiode?
- Ja. Skimle biedt een gratis proefperiode met 200 credits (genoeg voor ongeveer 200 tot 300 pagina's aan documenten), zonder creditcard. Betaalde abonnementen beginnen bij € 20 per maand voor individuen bij jaarlijkse facturering (€ 25 bij maandelijkse betaling), met grotere abonnementen voor intensieve gebruikers. Organisatie- en enterpriseplannen met volumes op maat, SSO en single-tenant implementaties zijn op aanvraag beschikbaar.
- Hoeveel documenten kan ik maximaal analyseren?
- Skimle ondersteunt duizenden documenten per project. Dat is veel meer dan een handmatige aanpak aankan en dekt de meeste professionele toepassingen, van 10 diepte-interviews tot meer dan 1000 open enquêteantwoorden. Heeft u een bijzonder grote dataset of doorlopende analysebehoeften, neem dan contact met ons op om de mogelijkheden te bespreken.
Gebouwd voor professionals, door professionals
Skimle heeft meer dan 1.500 tevreden gebruikers bij meer dan 50 universiteiten, overheidsinstanties, bureaus en bedrijven. Alle data wordt binnen de EU opgeslagen en verwerkt volgens ons strikte AVG-beleid en onze servicevoorwaarden.
Meer weten? Bekijk onze blog Signal & Noise, onze veelgestelde vragen en toepassingen per sector. We geven ook graag een demo van het product of verkennen samen hoe Skimle bij uw behoeften past. Lees meer over het bedrijf achter Skimle