ความรัดกุมระดับวิชาการด้วยความเร็วของ AI
Skimle สร้างโดยนักวิชาการเพื่อนักวิชาการ ศาสตราจารย์ Henri Schildt ผู้ร่วมก่อตั้ง มีประสบการณ์หลายทศวรรษในการวิจัยเชิงคุณภาพ และมีบทความตีพิมพ์ในวารสารการจัดการชั้นนำ รวมถึง Academy of Management Journal และ Organization Science เขาเบื่อเวิร์กโฟลว์ที่ช้าและเทอะทะของ NVivo และ MAXQDA และกังวลกับการใช้ ChatGPT ในการวิเคราะห์ที่ขาดความโปร่งใสและความครอบคลุม จึงสร้าง Skimle เป็นแพลตฟอร์มที่จำลองระเบียบวิธีเชิงคุณภาพที่รัดกุมและโปร่งใส โดยมี AI เป็นแกนหลัก
การลงรหัสบทสัมภาษณ์เบื้องต้นอาจใช้เวลาหลายสัปดาห์เมื่อทำด้วยมือ Skimle จัดการได้โดยไม่ลดความรัดกุมเชิงระเบียบวิธี และมักพบคำพูดอ้างอิงที่มนุษย์อาจพลาด ทุกประเด็นเชื่อมโยงกับคำพูดอ้างอิงคำต่อคำที่ผ่านการยืนยัน บันทึกการตรวจสอบฉบับสมบูรณ์ผ่านเกณฑ์ผู้ประเมินบทความ
สื่อการสอน →การวิเคราะห์ที่รัดกุมซึ่งช่วยให้คุณโฟกัสกับการสร้างองค์ความรู้เชิงทฤษฎี
แนวทางของ Skimle ได้แรงบันดาลใจจากทฤษฎีฐานราก (Glaser & Strauss; Strauss & Corbin) และวิธีของ Gioia ให้การวิเคราะห์ที่เป็นระบบและโปร่งใสตามที่การประเมินบทความต้องการ โดยไม่ต้องลงรหัสเชิงกลไกหลายสัปดาห์ซึ่งกินเวลาที่ควรใช้กับทฤษฎี ใช้ได้กว่า 100 ภาษาและรองรับสูงสุด 1,000 เอกสารต่อโครงการ
- การลงรหัสเบื้องต้นอัตโนมัติ ทุกคำพูดอ้างอิงเชื่อมโยงกับหมวดหมู่
- บันทึกการตรวจสอบสองทางฉบับสมบูรณ์สำหรับการประเมินบทความและความโปร่งใสของระเบียบวิธี
- ระบบหมวดหมู่ที่คุณควบคุม รวม แยก เปลี่ยนชื่อ และจัดระเบียบหมวดหมู่ใหม่ได้อย่างอิสระ
- ใช้ได้กว่า 100 ภาษาโดยไม่ต้องแปล
- รองรับบทสัมภาษณ์ เสียง/วิดีโอ หนังสือ เอกสาร และเอกสารจดหมายเหตุ
- มีแผน Skimle Academic ราคาพิเศษ
ถอดความและทำให้บทสัมภาษณ์เป็นนิรนาม
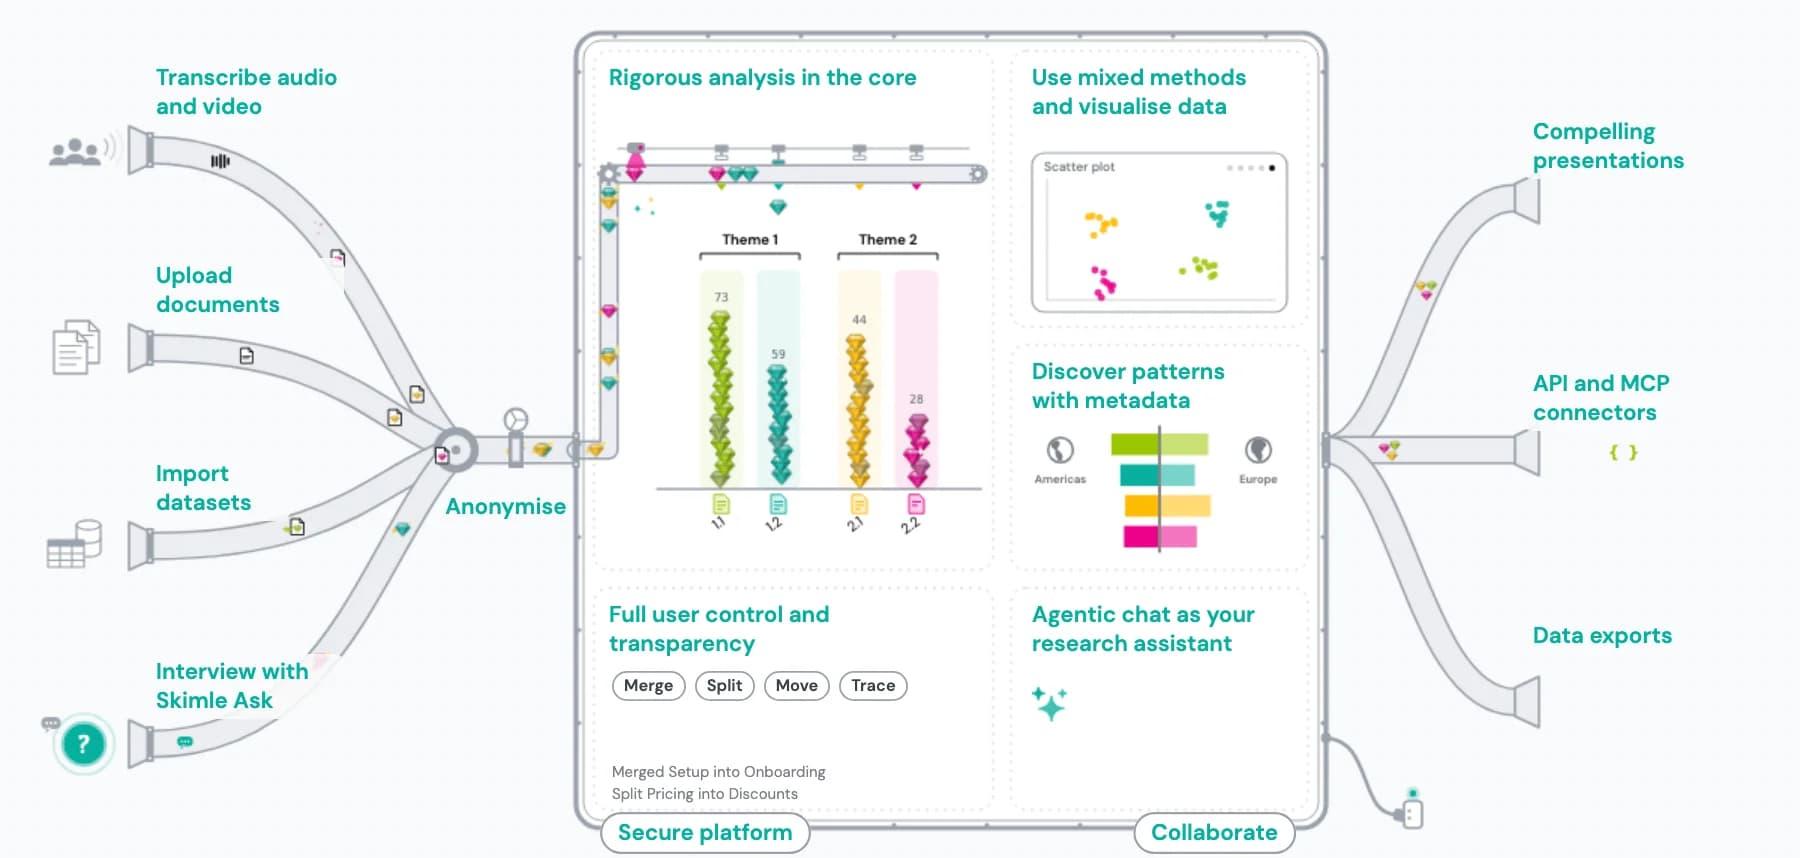
การเปลี่ยนไฟล์บันทึกภาคสนามให้เป็นข้อมูลที่ใช้ได้ผ่านบริการภายนอกนั้นช้าและแพง และบทถอดความที่ได้มีชื่อ สังกัด และสถานที่ ซึ่งสร้างภาระด้าน GDPR และจริยธรรมก่อนที่คุณจะแชร์ เก็บถาวร หรืออ้างอิงได้ Skimle ถอดความเสียงและวิดีโอภายในสภาพแวดล้อมที่ปลอดภัยซึ่งโฮสต์ใน EU แล้วทำให้เป็นนิรนามด้วยการแฝงชื่อระดับงานวิจัย คุณจึงได้บทถอดความที่สอดคล้องกับข้อกำหนดและพร้อมลงรหัสภายในวันเดียว โดยข้อมูลไม่เคยออกจากโครงสร้างพื้นฐานที่สอดคล้องกับ GDPR
วิธีการทำงาน
- 1. อัปโหลดเสียง วิดีโอ หรือข้อความ
อัปโหลดไฟล์ MP3, M4A, WAV, MP4, MOV, PDF หรือ Word ได้โดยตรง ไม่ต้องใช้บริการถอดความภายนอก และรองรับกว่า 100 ภาษาในตัว
- 2. ถอดความพร้อมป้ายระบุผู้พูด
Skimle ถอดความไฟล์บันทึก ระบุการเปลี่ยนผู้พูด และรับมือกับสำเนียงและคุณภาพเสียงที่หลากหลาย ทบทวนและแก้ไขผลลัพธ์ก่อนเริ่มการวิเคราะห์
- 3. ตรวจจับตัวระบุโดยอัตโนมัติ
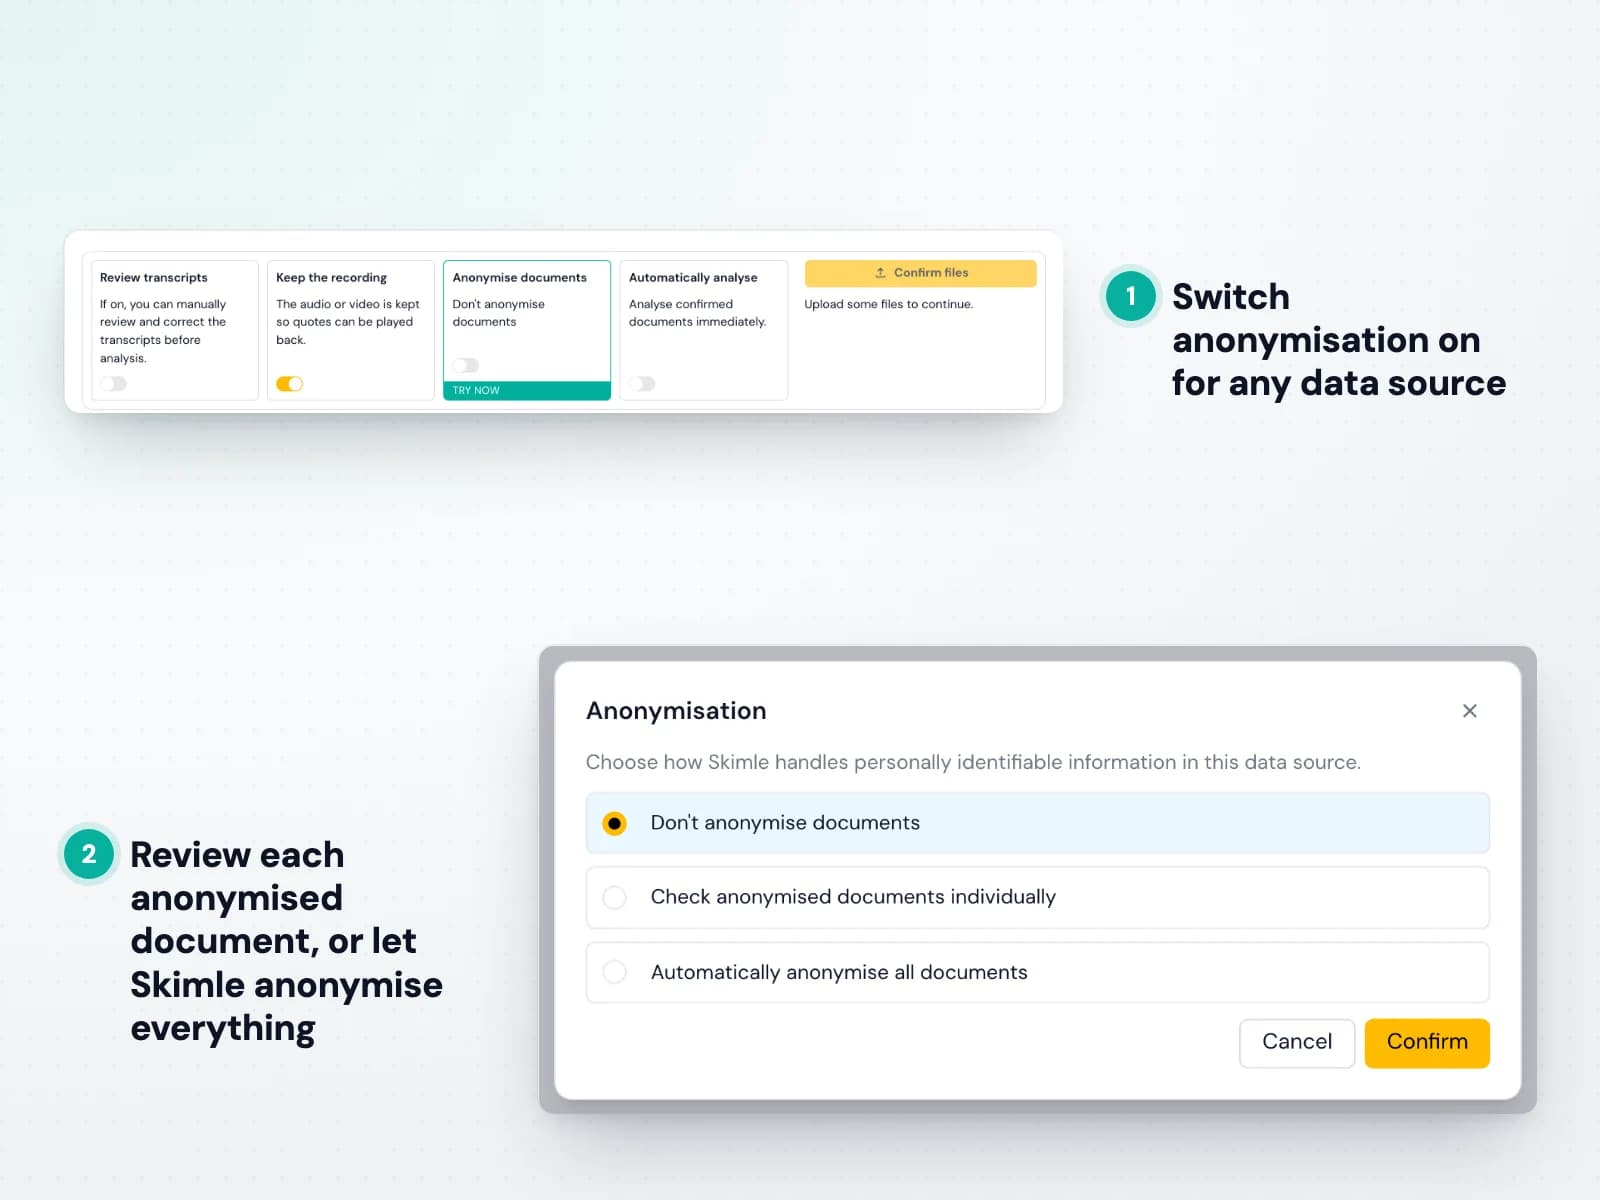
Skimle Anonymise ตั้งค่าสถานะตัวระบุในหกหมวดหมู่ ได้แก่ ชื่อ ตำแหน่งและบทบาท สถานที่ องค์กร วันที่ และอื่น ๆ ในทุกเอกสาร พร้อมความสอดคล้องข้ามไฟล์ บุคคลเดียวกันจึงได้นามแฝงเดียวกัน
- 4. เลือกระดับการทำให้เป็นนิรนาม
เลือกการแฝงชื่อแบบเบา การแฝงชื่อแบบเข้ม หรือการทำให้เป็นนิรนามระดับ HIPAA ที่ทำลายคีย์ทิ้ง ปรับแต่ละหมวดหมู่แยกกันและเพิ่มกฎแบบกำหนดเองด้วยภาษาธรรมดา
- 5. ส่งออกพร้อมเอกสารการตรวจสอบ
ส่งออกรายงานการตรวจสอบ PDF และตารางแปลง Excel สำหรับคณะกรรมการจริยธรรม แล้วส่งบทถอดความที่สะอาดเข้าสู่เวิร์กโฟลว์การวิเคราะห์ของ Skimleโดยตรง ไฟล์เสียงต้นฉบับจะถูกลบอย่างปลอดภัยหลังจากนั้น

ทำการวิเคราะห์บทสัมภาษณ์เชิงคุณภาพโดยมี AI ช่วย
งานวิจัยที่อิงบทสัมภาษณ์กว่า 40 ชิ้นควรสร้างองค์ความรู้เชิงทฤษฎีที่ลึกซึ้ง (เช่น สำหรับวิทยานิพนธ์ปริญญาเอก) แต่การลงรหัสด้วยมือ ทั้งการไฮไลต์ จัดระเบียบ ลงรหัสใหม่ และสร้างตารางติดตาม กินเวลาส่วนใหญ่และอาจยังพลาดรูปแบบสำคัญ Skimle อ่านทุกบทสัมภาษณ์อย่างเป็นระบบและให้ลำดับชั้นประเด็นที่มีโครงสร้างพร้อมคำพูดอ้างอิงคำต่อคำ คุณจึงใช้เวลากับการตีความเชิงทฤษฎีที่มีเพียงคุณทำได้
วิธีการทำงาน
- 1. อัปโหลดบทถอดความของคุณ
ลากบทถอดความสัมภาษณ์เข้ามาเป็นไฟล์ PDF, Word หรือข้อความธรรมดา Skimle รับเอกสารได้ทุกรูปแบบและรองรับกว่า 100 ภาษาในตัว
- 2. อธิบายคำถามวิจัยของคุณ
กำหนดจุดโฟกัสการวิเคราะห์แบบกว้างหรือเจาะจงก็ได้ Skimle จัดโครงสร้างการลงรหัสเบื้องต้นรอบสิ่งที่คุณพยายามทำความเข้าใจเชิงทฤษฎี
- 3. ทบทวนโครงสร้างรหัสเบื้องต้น
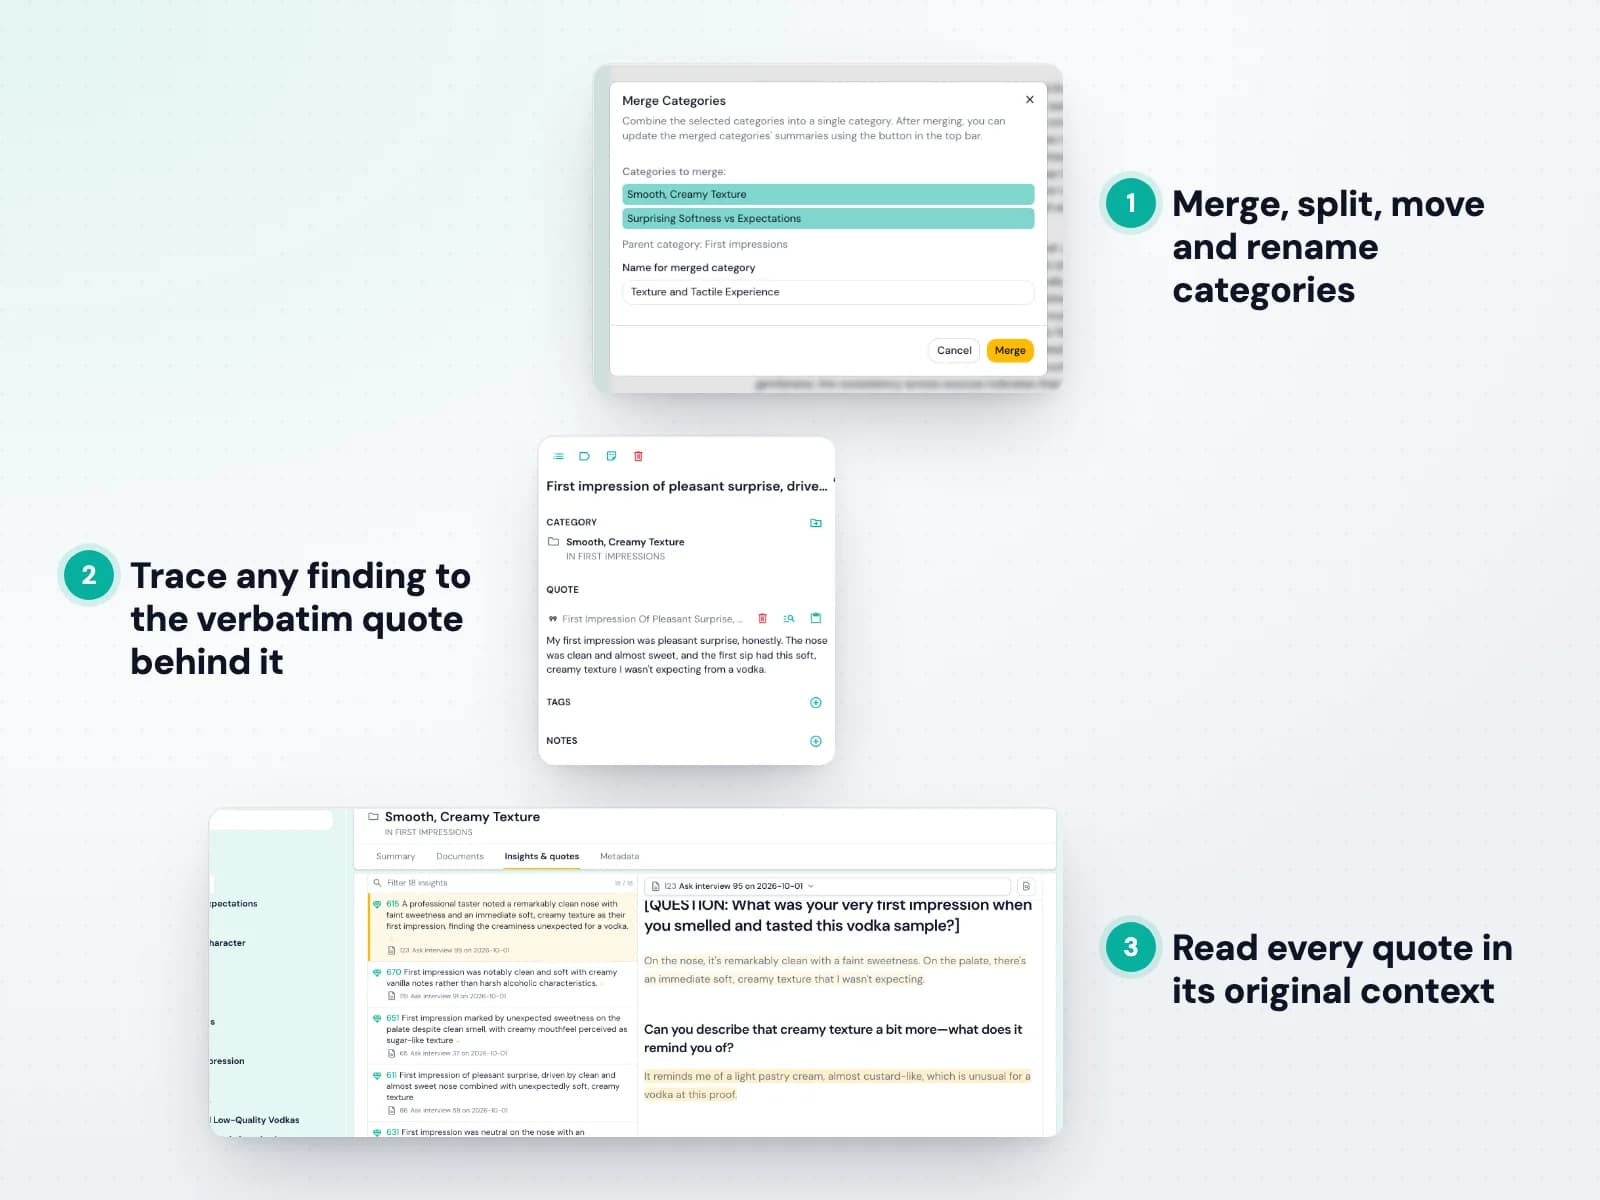
Skimle สร้างลำดับชั้นของประเด็น แต่ละประเด็นเชื่อมโยงกับคำพูดอ้างอิงคำต่อคำจากบทถอดความต้นฉบับ ไม่มีสิ่งใดถูกแต่งขึ้น ทุกรหัสย้อนกลับไปยังข้อความได้
- 4. ปรับให้เข้ากับกรอบทฤษฎีของคุณ
รวม แยก เปลี่ยนชื่อ และจัดระเบียบหมวดหมู่ใหม่ให้ตรงกับแบบจำลองเชิงทฤษฎีที่กำลังพัฒนา ความโปร่งใสสองทางช่วยให้คุณตรวจสอบได้ทุกเมื่อว่าคำพูดอ้างอิงใดสนับสนุนรหัสใด
- 5. ส่งออกสำหรับภาคผนวกระเบียบวิธี
ส่งออกระบบหมวดหมู่และคำพูดอ้างอิงสนับสนุนเป็นข้อความ หรือเป็นรูปแบบโอเพนซอร์ส REFI-QDA (.qdpx) ที่โปรแกรม CAQDAS แบบเดิมอย่าง NVivo, ATLAS.ti หรือ MAXQDA รองรับ
ทำการวิเคราะห์แบบผสมผสานวิธีข้ามกลุ่มตัวอย่างของคุณ
ข้อค้นพบเชิงคุณภาพมีน้ำหนักมากขึ้นเมื่อคุณแสดงได้ว่ามันแตกต่างกันอย่างไรในกลุ่มตัวอย่าง ทั้งตามรุ่น บทบาท เพศ พื้นที่ หรือเงื่อนไข การไขว้ตารางประเด็นกับคุณลักษณะผู้เข้าร่วมด้วยมือนั้นน่าเบื่อและผิดพลาดง่าย Skimle แนบข้อมูลเมตากับทุกเอกสารและให้คุณแบ่งโครงสร้างประเด็นเดียวกันตามตัวแปรใดก็ได้ คุณจึงสลับระหว่างคำพูดอ้างอิงคำต่อคำที่ลึกซึ้งกับรูปแบบเชิงปริมาณได้โดยไม่ทิ้งระเบียบวิธีใดไว้ข้างหลัง
วิธีการทำงาน
- 1. แนบข้อมูลเมตากับเอกสาร
ติดแท็กแต่ละบทถอดความด้วยตัวแปรที่สำคัญต่อการออกแบบของคุณ เช่น รุ่น บทบาท เพศ พื้นที่ รอบการเก็บข้อมูล หรือเงื่อนไขการทดลอง ด้วยตนเองหรือจากคอลัมน์ CSV
- 2. เรียกใช้การวิเคราะห์เชิงคุณภาพ
Skimle สร้างลำดับชั้นประเด็นเดียวครอบคลุมเอกสารทั้งหมด ผู้เข้าร่วมทุกคนจึงถูกลงรหัสตามโครงสร้างเดียวกัน
- 3. แบ่งประเด็นตามตัวแปร
ดูว่าแต่ละประเด็นแตกต่างกันอย่างไรระหว่างกลุ่ม และสังเกตว่ารูปแบบใดเป็นสากลหรือเฉพาะกับรุ่นใดรุ่นหนึ่ง
- 4. วัดความแพร่หลาย
อ่านความถี่และการกระจายของประเด็นเพื่อรายงานว่ารหัสหนึ่งพบบ่อยเพียงใดในแต่ละกลุ่ม โดยทุกการนับตรวจสอบย้อนกลับไปยังคำพูดอ้างอิงที่ทำให้เกิดได้
- 5. ส่งออกตารางและคำพูดอ้างอิง
ส่งออกตารางไขว้และคำพูดอ้างอิงสนับสนุนเป็น Excel หรือ Word สำหรับส่วนผสมผสานวิธีของบทความ

คำถามที่พบบ่อย
- อ้างอิง Skimle ในงานวิจัยได้หรือไม่?
- ได้ อธิบายว่าเป็น “ซอฟต์แวร์ลงรหัสเชิงคุณภาพโดยมี AI ช่วย” ในส่วนระเบียบวิธี เช่นเดียวกับที่คุณอ้างอิง NVivo หรือ MAXQDA เรามีบทความระเบียบวิธีที่อยู่ระหว่างการประเมินซึ่งจะใช้อ้างอิงอย่างเป็นทางการได้ และระหว่างนี้เราเสนอข้อความอ้างอิงให้ได้เมื่อมีการร้องขอ
- ผู้ประเมินบทความจะยอมรับการวิเคราะห์โดยมี AI ช่วยหรือไม่?
- ได้รับการยอมรับมากขึ้นเรื่อย ๆ หากจัดทำเอกสารอย่างเหมาะสม บันทึกการตรวจสอบของ Skimle ให้สิ่งที่ผู้ประเมินคาดหวัง คือกระบวนการลงรหัสที่เป็นระบบและบันทึกไว้ โดยทุกประเด็นย้อนกลับไปยังคำพูดอ้างอิงที่เจาะจง ส่วนระเบียบวิธีจึงแทบเขียนตัวเองได้
- Skimle เทียบกับ NVivo หรือ MAXQDA เป็นอย่างไร?
- NVivo และ MAXQDA เหมาะกับนักวิจัยที่มีเวลาวิเคราะห์หลายสัปดาห์และมีสิทธิ์การใช้งานของสถาบัน Skimle ทำให้ขั้นตอนลงรหัสเชิงกลไกเป็นอัตโนมัติ จากหลายสัปดาห์เหลือไม่กี่ชั่วโมง โดยคงระเบียบวิธีที่เป็นระบบและโปร่งใสแบบเดิม และเรียนรู้ได้ในไม่กี่นาที นักวิจัยหลายคนใช้ทั้งสองอย่าง: Skimle สำหรับการลงรหัสรอบแรก และ NVivo สำหรับการผสานแบบผสมผสานวิธี
- Skimle ใช้กับทฤษฎีฐานรากได้หรือไม่?
- ได้ Skimle รองรับการลงรหัสแบบอุปนัยที่ประเด็นเกิดขึ้นจากข้อมูลแทนการกำหนดไว้ล่วงหน้า เริ่มจากจุดโฟกัสกว้าง ๆ และให้โครงสร้างหมวดหมู่พัฒนาไปแบบวนซ้ำ ซึ่งใกล้เคียงกับการลงรหัสแบบเปิดในทฤษฎีฐานราก
- วิเคราะห์แบบผสมผสานวิธีได้หรือไม่?
- ได้ แนบตัวแปรข้อมูลเมตากับแต่ละเอกสาร เช่น รุ่น บทบาท เพศ พื้นที่ เงื่อนไข และแบ่งโครงสร้างประเด็นตามตัวแปรใดก็ได้ คุณได้ความถี่และการกระจายของประเด็นตามกลุ่ม แต่ละรายการตรวจสอบย้อนกลับไปยังคำพูดอ้างอิงคำต่อคำได้ พร้อมสำหรับส่วนผสมผสานวิธีของบทความ
- ข้อมูลวิจัยของฉันปลอดภัยหรือไม่?
- บทถอดความของคุณถูกประมวลผลบนโครงสร้างพื้นฐานที่โฮสต์ใน EU และไม่เคยถูกนำไปฝึกโมเดล AI เรามีข้อตกลงการประมวลผลข้อมูลสำหรับข้อกำหนดด้านจริยธรรมของสถาบัน และรองรับความต้องการด้านความปลอดภัยไอทีได้เกือบทั้งหมด ติดต่อเราพร้อมข้อกำหนดเฉพาะ
- ขอส่วนลดสำหรับนักวิชาการได้หรือไม่?
- ได้ นักวิชาการที่มีอีเมลสถาบันและหน้าแสดงสังกัดที่ยืนยันได้ซื้อแพ็กเกจ Skimle Academic ราคาพิเศษได้ ติดต่อเราเรื่องสิทธิ์การใช้งานของสถาบันหากต้องการการเข้าถึงแบบทีมสำหรับกลุ่มวิจัยหรือห้องปฏิบัติการ
สร้างเพื่อมืออาชีพ โดยมืออาชีพ
Skimle มีผู้ใช้ที่พึงพอใจกว่า 1,500 คนในมหาวิทยาลัย หน่วยงานรัฐ เอเจนซี และองค์กรกว่า 50 แห่ง ข้อมูลทั้งหมดจัดเก็บภายใน EU และประมวลผลตาม นโยบาย GDPR ที่เข้มงวดของเรา และ ข้อกำหนดการให้บริการ.
อยากรู้เพิ่มเติม? สำรวจ บล็อก Signal & Noise รวมถึง คำถามที่พบบ่อย ตลอดจนกรณีการใช้งานตามภาคส่วน เรายังยินดีสาธิตผลิตภัณฑ์หรือสำรวจว่า Skimle จะตอบโจทย์ความต้องการของคุณได้อย่างไร อ่านเพิ่มเติมเกี่ยวกับบริษัทเบื้องหลัง Skimle