Mọi người trả lời đều được lắng nghe. Mọi phát hiện đều truy nguồn được. Mọi thời hạn đều được đáp ứng.
Được xây dựng cho các công ty nghiên cứu thị trường phục vụ khách hàng và cho các nhóm thấu hiểu khách hàng nội bộ phục vụ doanh nghiệp. Cả hai đều chịu cùng một sức ép: dữ liệu định tính là tín hiệu phong phú nhất bạn có, nhưng lại quá nhiều để đọc kỹ thủ công. Các công ty nghiên cứu bị yêu cầu đưa ra phát hiện sâu hơn trong thời gian ngắn hơn với chi phí thấp hơn. Các nhóm nội bộ phải theo kịp những quyết định sản phẩm và kinh doanh không chờ đợi hai tuần.
Skimle đảm nhận phần mã hóa máy móc vốn chiếm phần lớn tuần làm việc của chuyên viên phân tích. Bạn lo phần diễn giải, câu hỏi "vậy thì sao" và khuyến nghị. Hai tuần mã hóa rút còn hai ngày, và các sắc thái vẫn được giữ nguyên.
Phân tích chuẩn chuyên nghiệp mở rộng theo khối lượng nghiên cứu của bạn
60 cuộc phỏng vấn sâu, 8 nhóm tập trung ở bốn thị trường hoặc 5.000 câu trả lời NPS nguyên văn: khối lượng này vượt quá khả năng đọc kỹ thủ công, còn các công cụ hời hợt làm mất những sắc thái mà khách hàng hay giám đốc kinh doanh sẽ hỏi tới. Skimle mở rộng quy mô mà không đánh đổi chiều sâu.
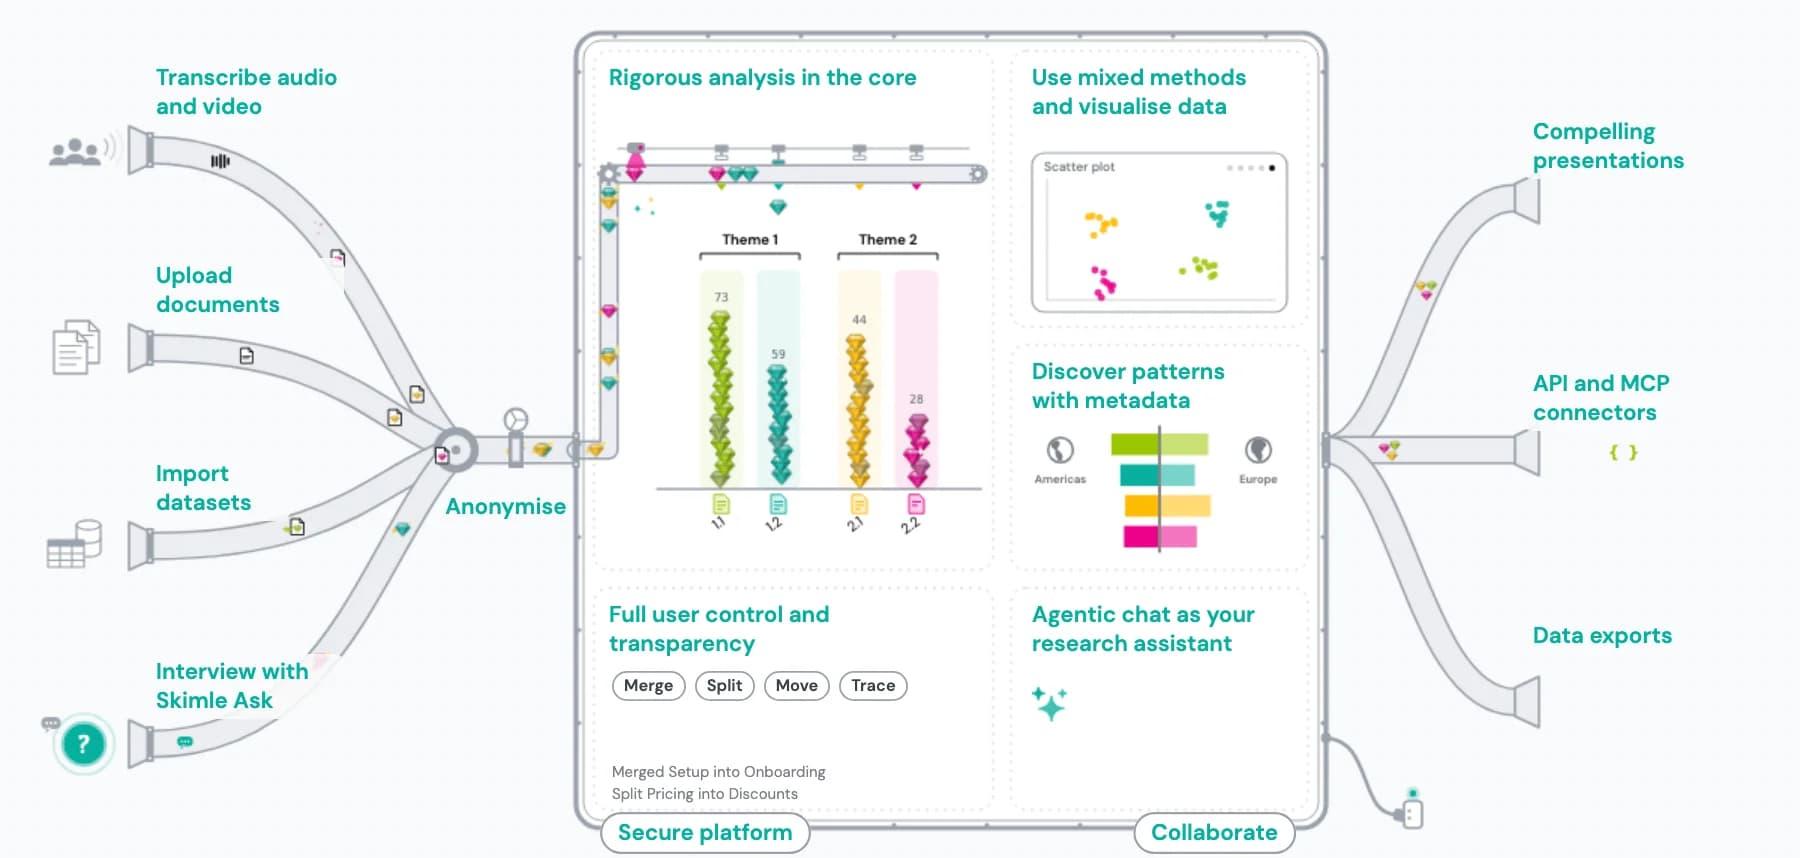
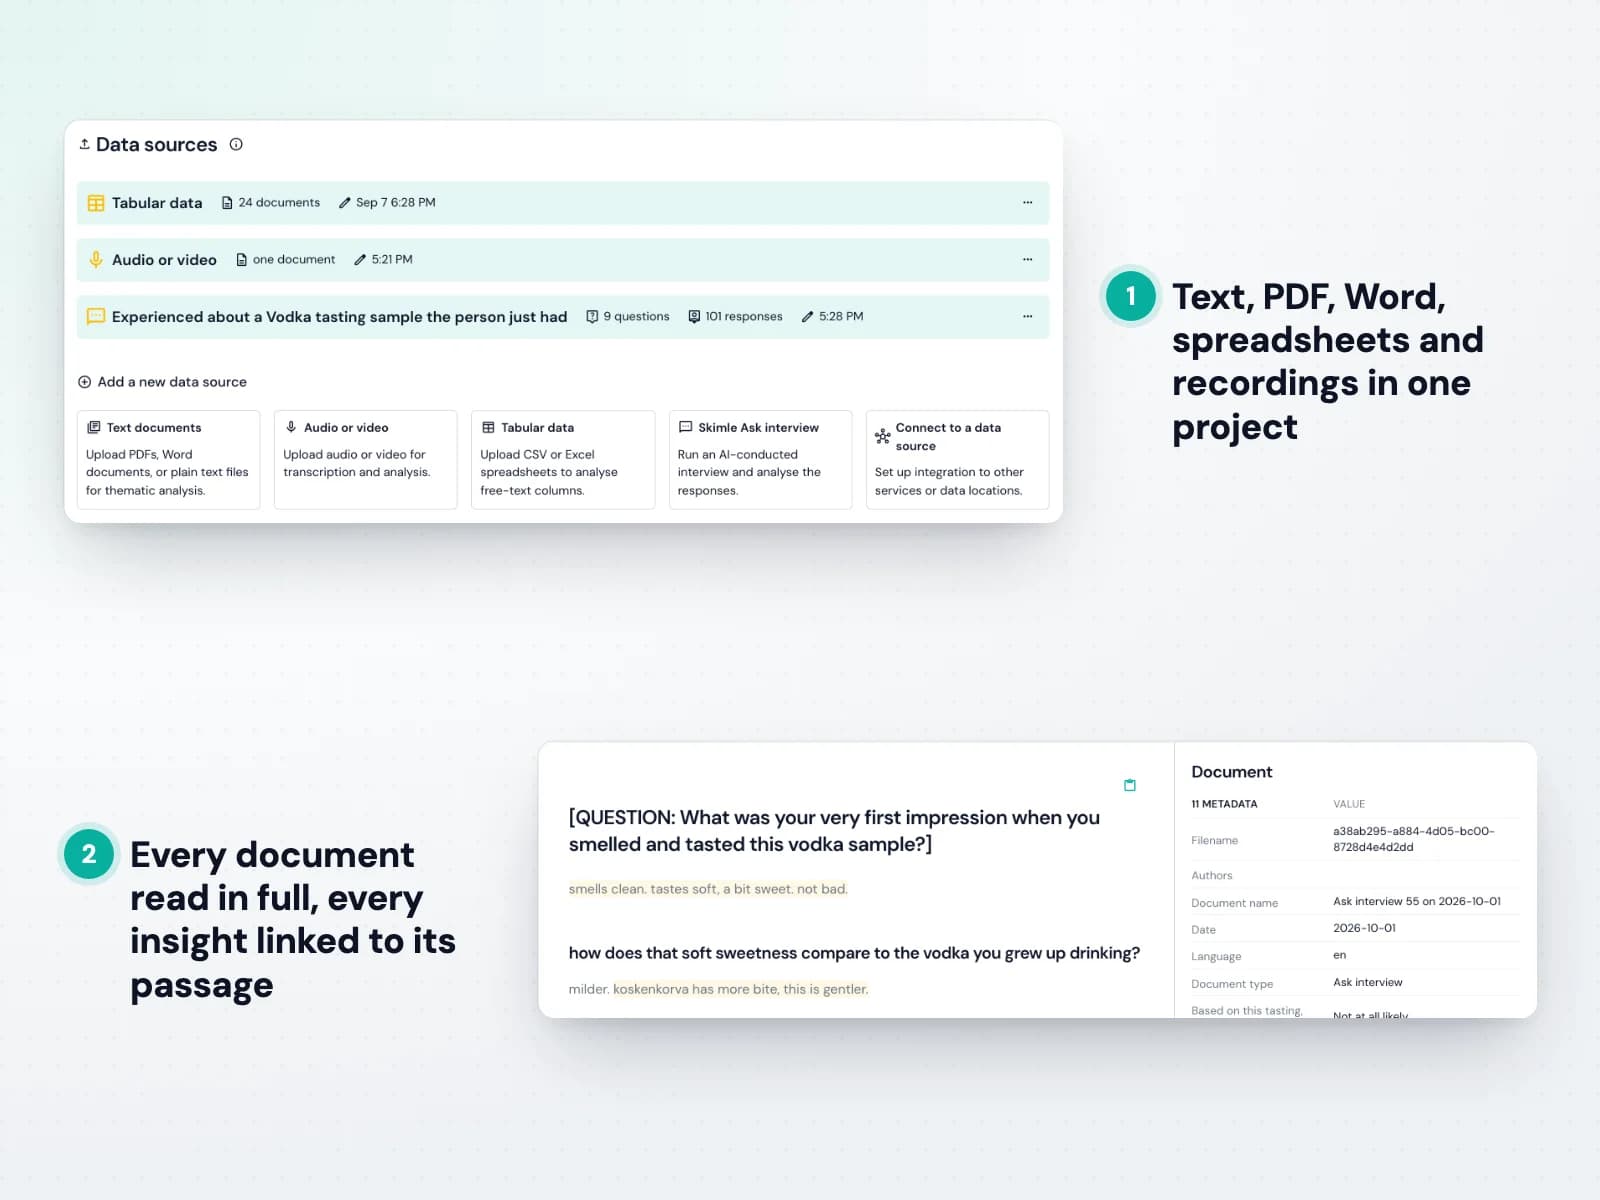
- Xử lý phỏng vấn, nhóm tập trung, khảo sát mở, đánh giá và phiếu hỗ trợ trong một dự án
- Mọi chủ đề đều liên kết với trích dẫn nguyên văn của khách hàng từ toàn bộ tập dữ liệu, không phải một mẫu
- Phân tích phân khúc tích hợp sẵn: so sánh theo nhân khẩu học, hạng sản phẩm, khu vực, nhóm NPS
- Hơn 100 ngôn ngữ trong một dự án, không cần bước dịch
- Xuất sang Word, PowerPoint và Excel sẵn sàng trình bày trong vài phút
Phân tích nhóm tập trung và phỏng vấn khách hàng ở quy mô lớn
Nhóm tập trung là loại dữ liệu định tính khó phân tích tốt nhất. Một người tham gia nói nhiều trông giống hệt bốn tiếng nói độc lập nếu bạn không theo dõi bằng chứng. Phỏng vấn sâu thất bại theo kiểu khác: với 20, 40 hay 60 bản ghi, việc mã hóa bản cuối cùng giống hệt bản đầu tiên trở thành điểm nghẽn. Skimle xây dựng một cấu trúc chủ đề chung cho mọi buổi và cho thấy điều gì nhất quán, điều gì khác nhau theo phân khúc và điều gì chỉ là ngoại lệ đơn lẻ, để kết quả đứng vững khi khách hàng hay các bên liên quan phản bác.
Cách hoạt động
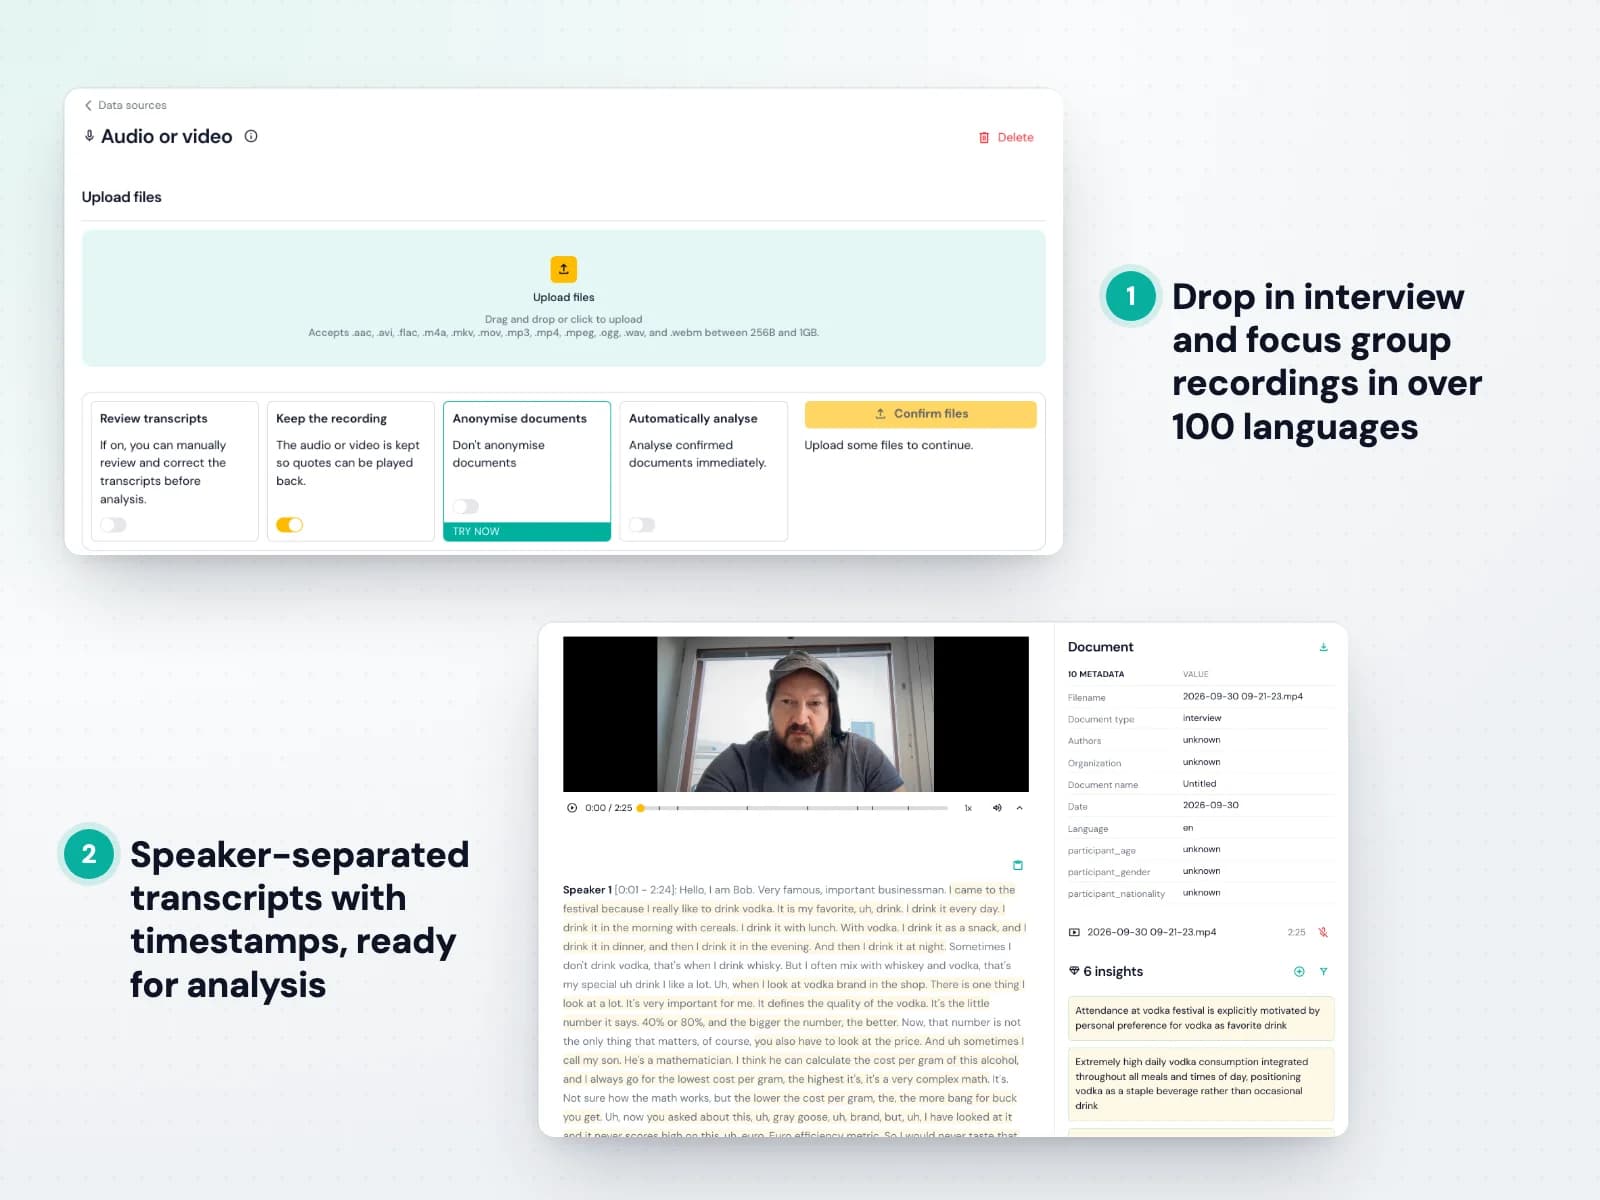
- 1. Nhập mỗi buổi thành một tài liệu
Tải lên bản ghi hoặc bản ghi âm từ Zoom, Teams, Otter hay Fireflies. Skimle chép lời trực tiếp âm thanh và video, nên mỗi buổi trở thành một tài liệu sẵn sàng phân tích.
- 2. Chạy phân tích trên mọi buổi
Skimle đọc mọi bản ghi và xây dựng chủ đề từ nội dung của mọi buổi. Nó khám phá những gì thực sự được thảo luận thay vì áp đặt một hệ thống danh mục định sẵn.
- 3. Xem điều gì nhất quán và điều gì khác biệt
Mỗi chủ đề cho thấy những nhóm nào đóng góp vào và với tần suất ra sao, tách tín hiệu phổ quát khỏi những gì chỉ đến từ một buổi hay một thị trường.
- 4. Đánh giá sự phân bố bằng chứng
Nhấp vào bất kỳ chủ đề nào để đọc trích dẫn minh chứng và xem chúng đến từ buổi nào. Đánh giá trực tiếp ảnh hưởng của tiếng nói át giọng thay vì dựa vào trí nhớ.
- 5. Xuất cho khách hàng
Tạo tài liệu tổng hợp với các trích dẫn tiêu biểu theo nhóm, sẵn sàng cho bộ trang chiếu hoặc báo cáo đầy đủ.
Mã hóa khảo sát mở và so sánh giữa các phân khúc
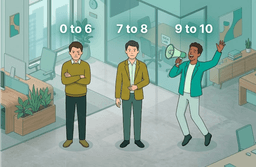
Một danh sách chủ đề tổng thể không bao giờ trả lời được câu hỏi mà doanh nghiệp thực sự đặt ra: ai cảm thấy như vậy, và điều đó khác nhau thế nào giữa các phân khúc? Trước hàng nghìn câu trả lời nguyên văn, hầu hết các nhóm chỉ đọc lướt một mẫu và bỏ sót những ý kiến thiểu số mang tín hiệu sắc nét nhất. Skimle mã hóa mọi câu trả lời và cho phép bạn chia cùng một cấu trúc chủ đề theo bất kỳ biến siêu dữ liệu nào, dù là nhóm NPS, hạng sản phẩm, thị trường hay nhân khẩu học, biến các câu trả lời mở của một khảo sát theo dõi thành góc nhìn phương pháp hỗn hợp có thể hành động được.
Cách hoạt động
- 1. Tải câu trả lời kèm siêu dữ liệu
Nhập câu trả lời mở dưới dạng CSV từ SurveyMonkey, Typeform hoặc Qualtrics, kèm các cột siêu dữ liệu của người trả lời, để mọi câu trả lời đều mang theo phân khúc của nó.
- 2. Xây dựng toàn bộ cấu trúc chủ đề
Skimle mã hóa mọi câu trả lời vào hệ thống chủ đề phân cấp, không chỉ những câu phổ biến, nên ý kiến thiểu số vẫn được nhìn thấy.
- 3. Phân đoạn theo bất kỳ biến nào
Lọc và so sánh chủ đề theo nhóm NPS, hạng sản phẩm, khu vực hay nhân khẩu học để thấy vấn đề nào quan trọng nhất với khách hàng nào.
- 4. Kiểm chứng bằng chứng
Mọi mô thức đều truy được về trích dẫn nguyên văn, nên khoảng cách giữa hai phân khúc được chứng minh bằng chính những câu trả lời đã tạo ra nó.
- 5. Xuất kết quả sẵn sàng gửi khách hàng
Tạo báo cáo theo chủ đề với trích dẫn nguyên văn và bảng chéo, chỉ trong vài phút thay vì vài ngày.

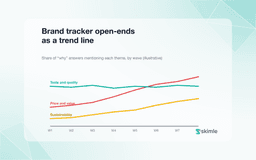
Gộp mọi kênh phản hồi vào một bức tranh phát hiện
Phỏng vấn, câu trả lời NPS nguyên văn, phiếu hỗ trợ, đánh giá, bản ghi cuộc gọi bán hàng, buổi rút kinh nghiệm thắng/thua, thảo luận cộng đồng, báo cáo của chuyên gia phân tích và đối thủ. Mỗi kênh thường có phân tích, bộ trang chiếu và thuật ngữ riêng, nên chẳng có gì khớp với nhau và cùng một vấn đề của khách hàng bị báo cáo ba lần dưới ba cái tên. Skimle mã hóa mọi nguồn theo một cấu trúc danh mục duy nhất trong một dự án, rồi cho thấy mỗi kênh đặt nặng cùng một chủ đề đến đâu. Các công ty nghiên cứu dùng nó để lồng nghiên cứu tại bàn và tư liệu thứ cấp vào nghiên cứu sơ cấp. Các nhóm nội bộ dùng nó để luôn theo sát khách hàng.
Cách hoạt động
- 1. Gộp các kênh vào một dự án
Tải lên song song bản ghi, tệp xuất CSV, PDF và bản ghi âm. Tệp xuất phiếu hỗ trợ, dữ liệu đánh giá, báo cáo phân tích và âm thanh phỏng vấn đều trở thành tài liệu trong cùng một dự án.
- 2. Gắn thẻ kênh cho từng tài liệu
Kênh, phân khúc, thị trường và ngày tháng được nhập làm siêu dữ liệu, nên mọi phép so sánh nguồn về sau chỉ là một bộ lọc chứ không phải một lần phân tích mới.
- 3. Mã hóa mọi thứ theo một cấu trúc
Skimle xây dựng một cấu trúc chủ đề chung cho mọi nguồn, hoặc áp dụng khung bạn vẫn dùng để báo cáo, để một kết quả có cùng ý nghĩa ở mọi kênh.
- 4. So sánh điều mỗi kênh đang cho bạn biết
Thấy được chỗ các nguồn đồng thuận và chỗ chúng mâu thuẫn. Một chủ đề nổi bật trong phiếu hỗ trợ nhưng vắng mặt trong phỏng vấn là một phát hiện, không phải sự chênh lệch cần xóa đi.
- 5. Thêm đợt tiếp theo mà không phải làm lại từ đầu
Dữ liệu quý sau được mã hóa theo cùng cấu trúc, nên khảo sát theo dõi giữ được tính so sánh và báo cáo cập nhật chỉ là xuất lại chứ không phải làm lại.
Câu hỏi thường gặp
Đây là những câu hỏi mà các nhóm phát hiện khách hàng và trưởng nhóm nghiên cứu ở các công ty nghiên cứu hỏi chúng tôi nhiều nhất, kể cả những câu đến thẳng từ quy trình mua sắm. Danh sách kiểm tra RFP trung lập với nhà cung cấp của chúng tôi liệt kê đúng những câu hỏi nên đặt cho mọi nhà cung cấp bạn đang chấm điểm, kể cả chúng tôi.
- Điều này giúp chúng tôi cạnh tranh với các lựa chọn rẻ và hời hợt ra sao?
- Các nhà cung cấp giá rẻ và các lớp vỏ AI mỏng cạnh tranh bằng giá với đám mây từ và danh sách chủ đề phẳng. Skimle mang lại chiều sâu với cùng tốc độ, nên công ty nghiên cứu tạo khác biệt bằng chất lượng của câu "vậy thì sao" thay vì bảng giá, còn nhóm nội bộ làm được nhiều nghiên cứu hơn với cùng ngân sách. Giờ công chuyên viên chuyển từ mã hóa máy móc sang diễn giải, phần mà ai cũng thực sự trả tiền. Xem tiền của một nghiên cứu định tính thực sự đi đâu →
- Nên nói gì khi khách hàng hay các bên liên quan chất vấn phân tích có AI hỗ trợ?
- Hãy mô tả chính xác: AI thực hiện việc phân loại máy móc, một nhà nghiên cứu có tên tuổi rõ ràng xem xét mọi chủ đề và viết phần diễn giải. Rồi đưa ra bằng chứng. Mọi khẳng định trong báo cáo Skimle đều mở ra trích dẫn nguyên văn và tài liệu gốc của nó, một câu trả lời mạnh hơn mức tổng hợp thủ công có thể đưa ra, vì ở đó logic mã hóa chỉ tồn tại trong đầu một ai đó. 7 quy tắc dùng AI có trách nhiệm trong nghiên cứu thị trường định tính →
- Skimle phân tích toàn bộ tập dữ liệu hay chỉ một mẫu?
- Toàn bộ tập dữ liệu. Điều này đáng hỏi mọi nhà cung cấp, vì một số công cụ truy xuất một phần tài liệu của bạn qua tìm kiếm embedding, phân tích phần đó và không bao giờ báo tài liệu nào bị bỏ ra ngoài. Kết quả đọc như thể bao quát toàn bộ kho dữ liệu nhưng thực ra không phải vậy. Skimle mã hóa mọi tài liệu, và bạn có thể mở bất kỳ tài liệu nào để thấy chính xác đoạn nào đã được mã hóa và đoạn nào chưa.
- Chúng tôi có thể áp dụng hệ thống danh mục riêng, hay chỉ chấp nhận những gì AI tạo ra?
- Cả hai, và có thể dùng cả hai trên cùng một kho dữ liệu. Mang hệ thống danh mục sẵn có vào và Skimle mã hóa diễn dịch theo đó, hoặc để nó xây dựng cấu trúc quy nạp từ dữ liệu. Danh mục có thể được gộp, tách, đổi tên, sắp xếp lại và xóa sau đó, và phân tích đi theo những chỉnh sửa của bạn. Các công ty chạy khảo sát theo dõi hoặc khung chuẩn của khách hàng năm này qua năm khác thường làm theo lối diễn dịch; nghiên cứu khám phá thường bắt đầu theo hướng ngược lại.
- Điều gì ngăn trích dẫn bịa đặt lọt vào báo cáo của chúng tôi?
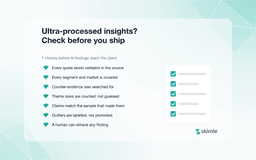
- Mọi trích dẫn đều được đối chiếu tự động với tài liệu nguồn. Nếu mô hình tạo ra văn bản không tồn tại nguyên văn trong dữ liệu của bạn, Skimle đánh dấu và xử lý lại thay vì hiển thị, nên trích dẫn bịa đặt không thể lọt vào bộ trang chiếu gửi khách hàng. Bạn cũng có thể mở bất kỳ tài liệu nào để xem đoạn nào đã được mã hóa và đoạn nào chưa, đó là cách bắt lỗi ngược lại khi có điều gì bị bỏ sót. Minh bạch hai chiều hoạt động thế nào →
- Chúng tôi nên đánh giá Skimle so với các công cụ khác trong danh sách ra sao?
- Hãy chạy thử nghiệm thay vì xem demo. Lấy một kho dữ liệu bạn đã phân tích, để biết câu trả lời đúng là gì, viết ra ba nhiệm vụ trước khi bắt đầu (một mã hóa, một so sánh phân khúc, một tìm bằng chứng), bấm giờ từng nhiệm vụ kể cả phần chỉnh sửa, và cố tình không đồng ý với công cụ để xem bạn có thể sắp xếp lại kết quả nhanh đến đâu. Chúng tôi sẵn lòng chạy song song một dự án thực tế với công cụ bạn đang dùng, và gói miễn phí giúp một nhà nghiên cứu hình thành nhận định trong một buổi chiều trước tất cả những điều đó. Danh sách kiểm tra RFP 7 lĩnh vực và mẫu chấm điểm →
- Skimle xử lý được bao nhiêu dữ liệu và bao nhiêu ngôn ngữ?
- Tối đa 1.000 tài liệu mỗi dự án, đủ cho mọi thứ từ một nghiên cứu 20 cuộc phỏng vấn đến một khảo sát theo dõi toàn cầu với hàng nghìn câu trả lời, và hơn 100 ngôn ngữ được phân tích trực tiếp mà không cần bước dịch. Một dự án có thể kết hợp tiếng Anh, Tây Ban Nha, Trung, Đức và Ả Rập, xây dựng một cấu trúc chủ đề chung cho tất cả và giữ mọi trích dẫn ở ngôn ngữ gốc. Nếu bạn thường xuyên làm việc ở mức trần của phạm vi này, hãy trao đổi với chúng tôi về các thỏa thuận theo khối lượng.
- Dữ liệu khách hàng có an toàn và được bảo mật không?
- Toàn bộ dữ liệu được lưu trữ và xử lý trong EU trên AWS, trong môi trường do một bên thứ ba được chứng nhận thiết lập, và dữ liệu khách hàng không bao giờ được dùng để huấn luyện mô hình. Có sẵn Thỏa thuận xử lý dữ liệu, chúng tôi làm việc theo thỏa thuận bảo mật của khách hàng, giả danh hóa được tích hợp vào quy trình, và có thể triển khai đơn thuê bao hoặc đám mây riêng khi chủ quyền dữ liệu đòi hỏi.
- Điều gì xảy ra với phân tích của chúng tôi nếu ngừng dùng Skimle?
- Bạn mang nó theo, ở bất kỳ gói nào. Xuất dữ liệu đã mã hóa dưới dạng REFI-QDA (.qdpx) theo chuẩn mở và tiếp tục trong NVivo, ATLAS.ti hoặc MAXQDA, hoặc mang theo các tệp Word, PowerPoint và Excel với trích dẫn sắp xếp theo chủ đề. Chúng tôi triển khai chuẩn liên thông chính là để việc ở lại là một lựa chọn chứ không phải điều bắt buộc.
- Giá cả tính thế nào khi khối lượng nghiên cứu của chúng tôi lên xuống?
- Skimle là gói đăng ký theo người dùng gọn nhẹ kèm hạn mức tín dụng, cộng với các gói tín dụng bạn mua cho những tháng có nghiên cứu lớn. Gói đăng ký giữ cả nhóm tiếp tục dùng công cụ giữa các dự án; các gói tín dụng gắn chi phí vào đúng dự án phát sinh, điều quan trọng với các công ty tính lại chi phí cho khách hàng. Các bên liên quan chỉ cần đọc kết quả thì không cần tài khoản, vì tệp xuất và báo cáo nghiên cứu có thể in đã đáp ứng việc đó.
- Nhiều nhà nghiên cứu có thể cùng làm một dự án không?
- Có, cùng lúc, và chỉnh sửa cũng như chú thích của từng người đều được giữ lại. Điều này phù hợp cho bình duyệt và kiểm soát chất lượng, cũng như để chia một nghiên cứu lớn giữa nhà nghiên cứu trẻ và giàu kinh nghiệm với một trưởng nhóm định hướng cấu trúc danh mục.
Do người làm chuyên môn xây dựng, cho người làm chuyên môn
Skimle có hơn 1.500 người dùng hài lòng tại hơn 50 trường đại học, cơ quan nhà nước, công ty dịch vụ và doanh nghiệp. Toàn bộ dữ liệu được lưu trữ trong EU và xử lý theo chính sách GDPR và điều khoản dịch vụ nghiêm ngặt của chúng tôi.
Bạn muốn tìm hiểu thêm? Hãy khám phá blog Signal & Noise, câu hỏi thường gặp và các trường hợp sử dụng theo ngành của chúng tôi. Chúng tôi cũng sẵn lòng giới thiệu sản phẩm hoặc cùng bạn tìm hiểu Skimle có thể đáp ứng nhu cầu của bạn ra sao. Đọc thêm về công ty đứng sau Skimle