隨研究量擴展的專業等級分析
60 場深度訪談、橫跨四個市場的 8 場焦點團體,或 5,000 則 NPS 原話:這樣的量已超出仔細人工閱讀的範圍,而表面化的工具會流失客戶或商務總監一定會追問的細節。Skimle 能擴大規模而不犧牲深度。
- 在同一個專案中處理訪談、焦點團體、開放式問卷、評論與客服單
- 每個主題都連結到來自完整資料集(而非樣本)的顧客逐字引文
- 內建區隔分析:依人口統計特徵、產品層級、地區與 NPS 分組比較
- 同一個專案支援 100 多種語言,無需翻譯步驟
- 幾分鐘內產出可直接簡報的 Word、PowerPoint 與 Excel 匯出
大規模分析焦點團體與顧客訪談
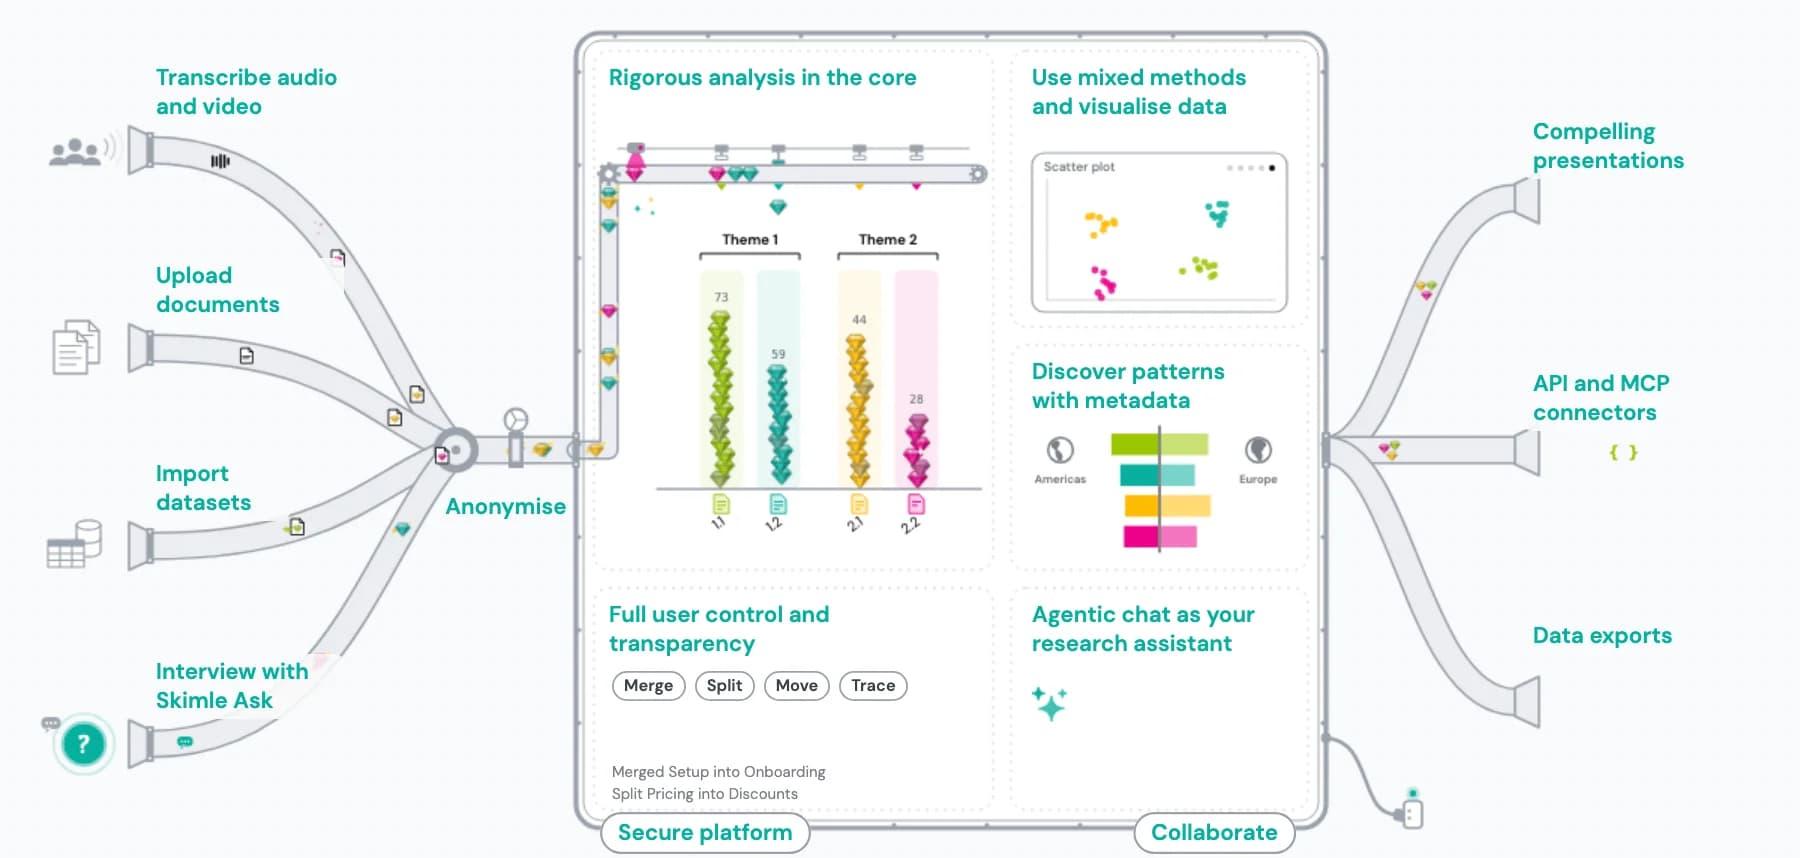
焦點團體是最難分析好的質性資料。除非追蹤證據,否則一位很敢講的參與者看起來就和四個獨立的聲音沒兩樣。深度訪談則以另一種方式失敗:當逐字稿有 20、40 或 60 份時,要用編第一份的方式去編最後一份,就成了瓶頸。Skimle 為所有場次建立同一套主題結構,呈現哪些內容一致、哪些因區隔而異、哪些只是單一的例外,讓發現在客戶或利害關係人提出質疑時依然站得住腳。
運作方式
- 1. 將每個場次匯入為一份文件
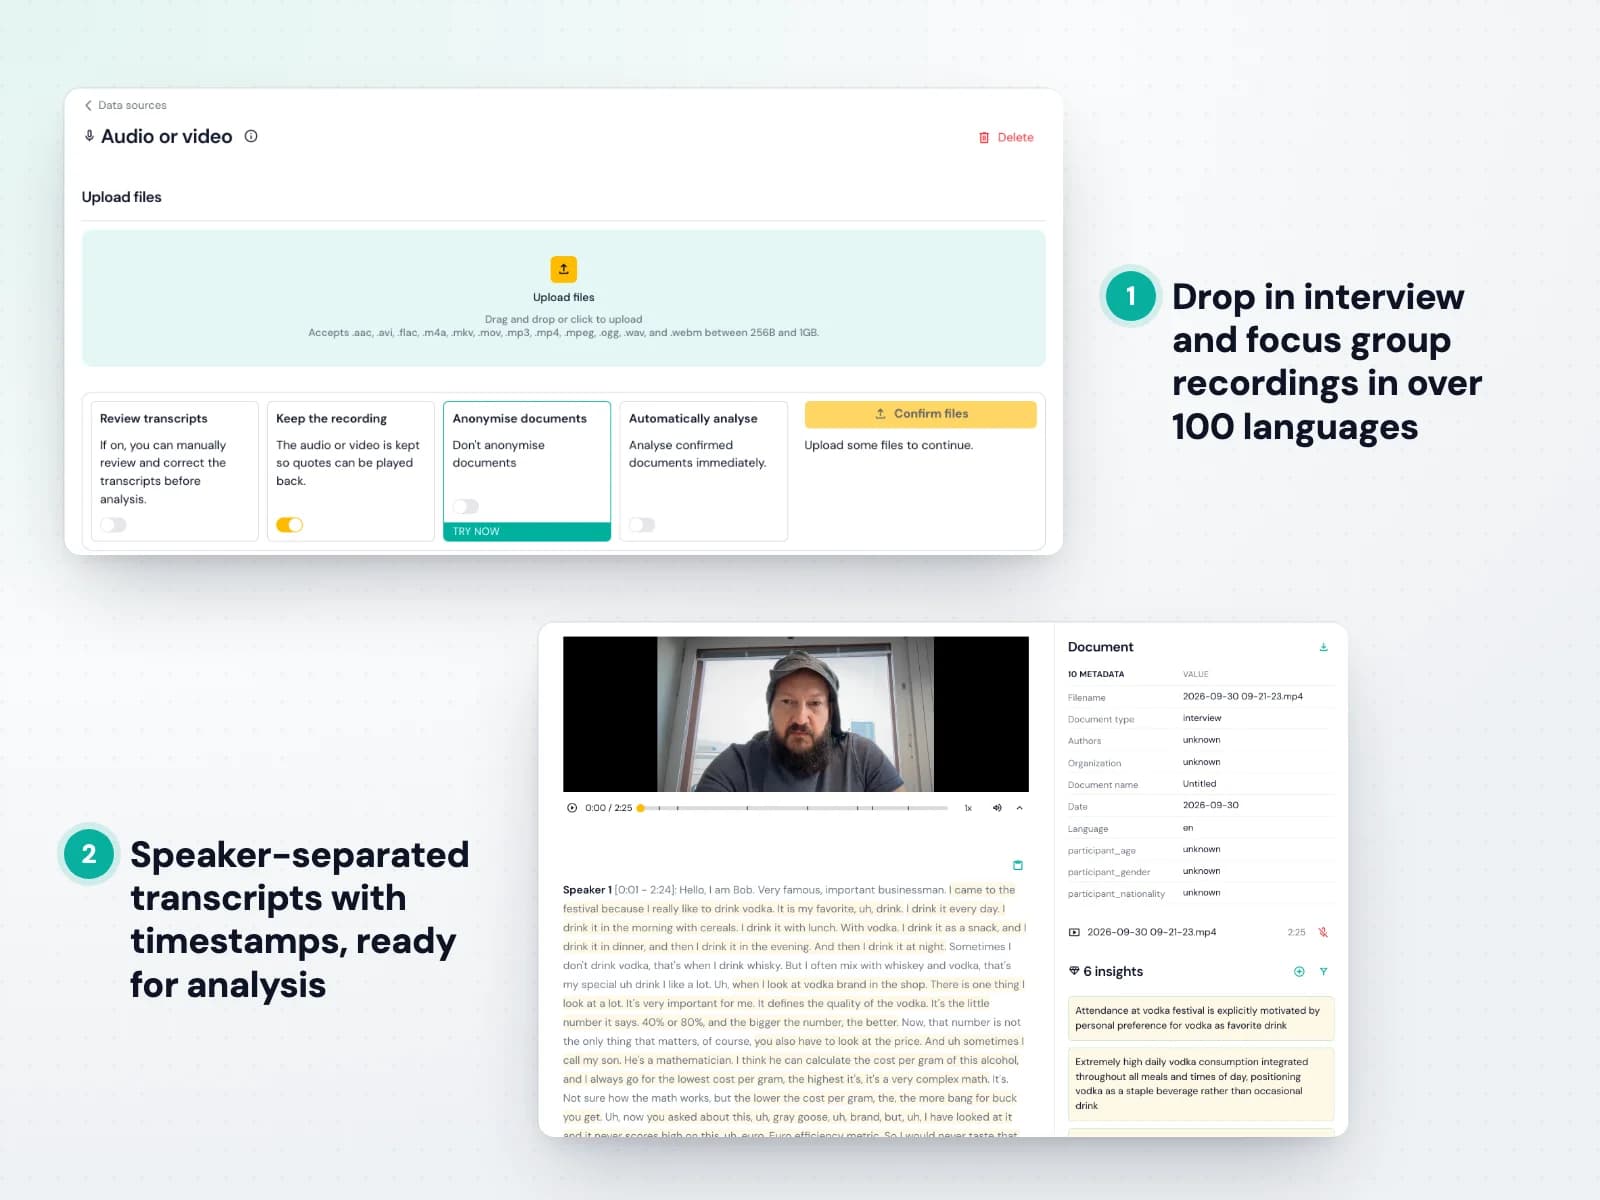
從 Zoom、Teams、Otter 或 Fireflies 上傳逐字稿或錄音。Skimle 會直接轉錄音訊與影片,讓每個場次都成為一份可分析的文件。
- 2. 對所有場次執行分析
Skimle 會閱讀每一份逐字稿,並根據所有場次的內容建立主題。它找出實際討論了什麼,而不是硬套預設的類別系統。
- 3. 看出哪些一致、哪些有差異
每個主題都會顯示有哪些群體貢獻其中以及頻率,將普遍的訊號與單一場次或單一市場區分開來。
- 4. 評估證據的分布
點選任何主題即可閱讀佐證引文,並看到它們來自哪些場次。直接判斷強勢發言的影響,而不是憑記憶。
- 5. 匯出給客戶
產出綜整文件,附各群體的代表性引文,可直接用於簡報或完整報告。
為開放式問卷編碼並比較各區隔
一份整體的主題清單,永遠回答不了企業真正想問的問題:誰有這種感受?在不同區隔之間又有什麼差別?面對成千上萬則原話,多數團隊只會略讀一部分樣本,因而錯失帶有最強訊號的少數意見。Skimle 會為每一則回答編碼,讓您依任何元資料變數切分同一套主題結構,無論是 NPS 分組、產品層級、市場或人口統計特徵,把追蹤調查中的開放式回答轉化為可據以行動的混合方法檢視。
運作方式
- 1. 上傳附元資料的回答
從 SurveyMonkey、Typeform 或 Qualtrics 以 CSV 匯入開放式回答,並附上受訪者的元資料欄位,讓每一則回答都帶著其區隔。
- 2. 建立完整的主題結構
Skimle 會將每一則回答編碼到主題階層中,不只常見的回答,讓少數觀點依然清晰可見。
- 3. 依任何變數區隔
依 NPS 分組、產品層級、地區或人口統計特徵篩選並比較主題,看出哪些問題對哪些顧客最重要。
- 4. 核實證據
每個模式都能追溯到逐字引文,因此兩個區隔之間的差距,都有產生它的確切回答作為佐證。
- 5. 匯出可直接交給客戶的成果
幾分鐘而非數天內,產出附逐字引文與交叉分析表的主題報告。

把所有回饋管道整合成一幅洞察全貌
訪談、NPS 原話、客服單、評論、銷售通話錄音、成交/流失檢討、社群討論串、分析師與競爭者報告。每個管道通常都有各自的分析、各自的簡報與各自的用語,結果什麼都兜不起來,同一個顧客問題以三個名稱被報告三次。Skimle 在同一個專案中,依同一套類別結構為每個來源編碼,再呈現各管道對同一主題的比重。研究公司用它把桌面研究與次級資料納入初級研究;內部團隊則用它持續掌握顧客全貌。
運作方式
- 1. 將各管道彙整到一個專案
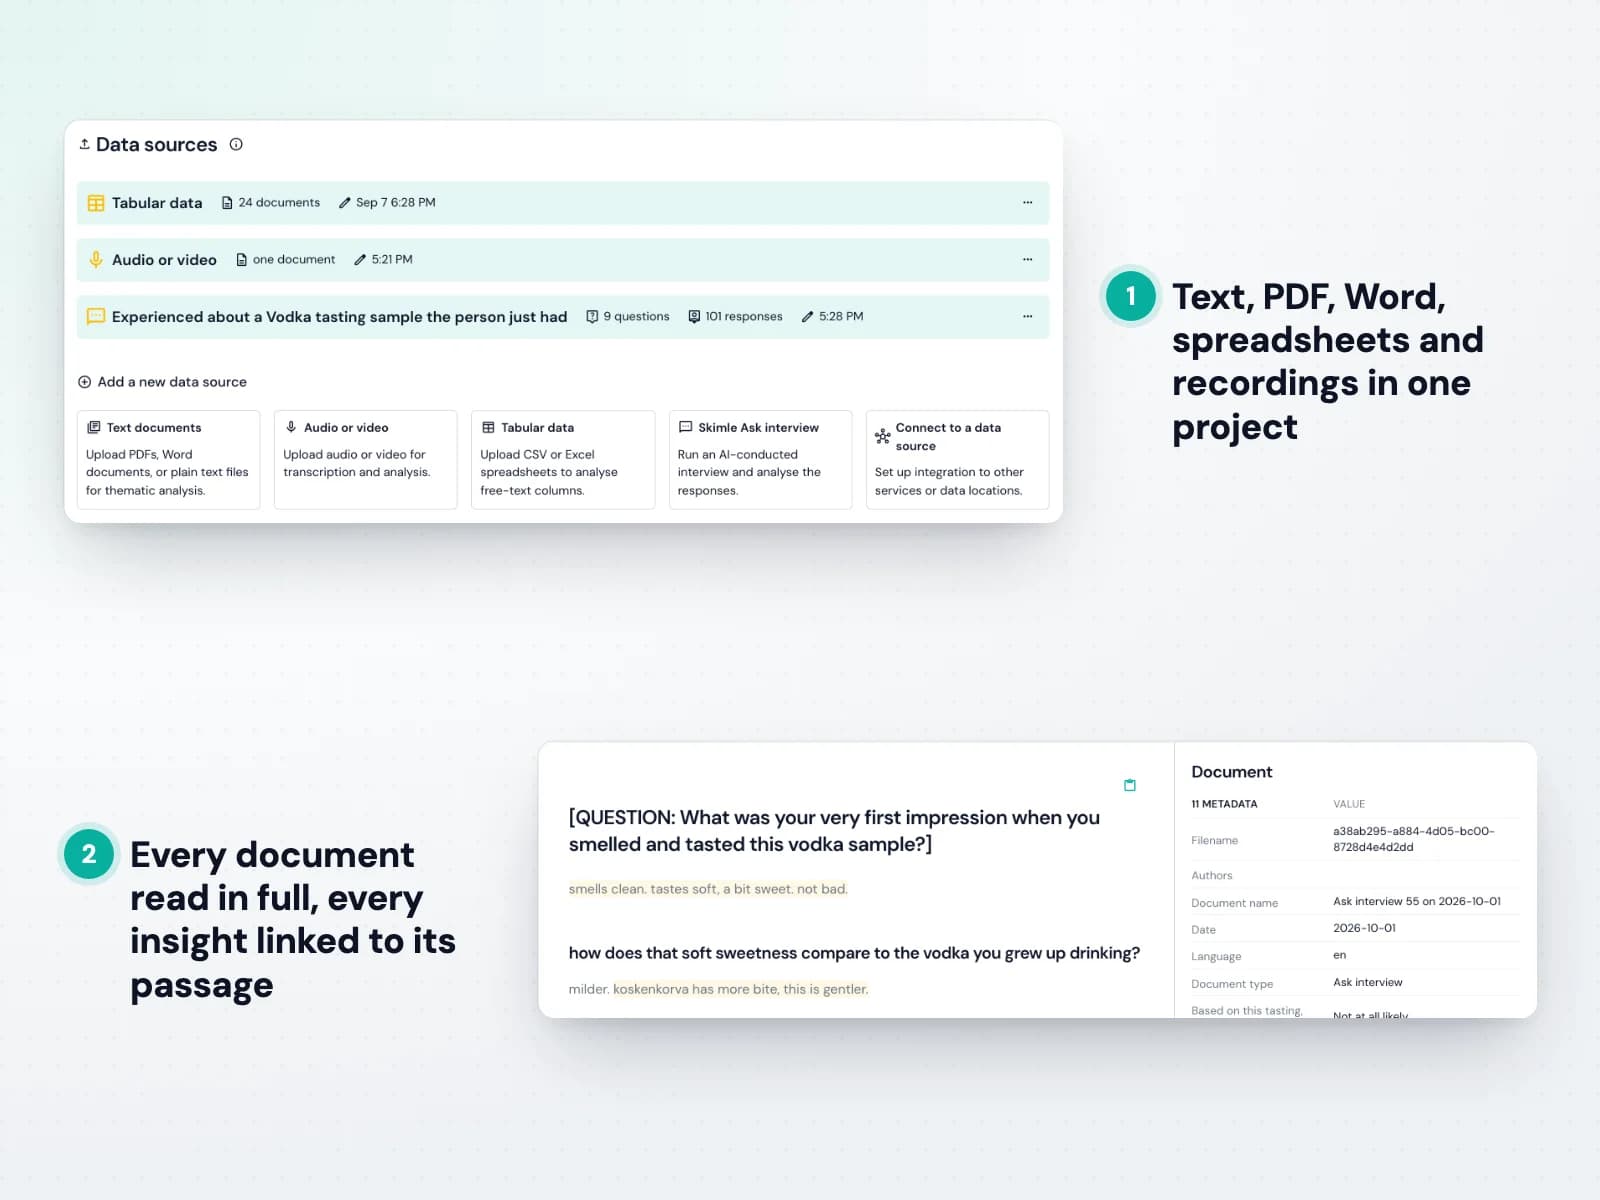
並排上傳逐字稿、CSV 匯出檔、PDF 與錄音。客服單匯出檔、評論資料、分析師報告與訪談音訊,都會成為同一個專案中的文件。
- 2. 為每份文件標上其管道
管道、區隔、市場與日期都以元資料輸入,之後每一次來源比較都只是篩選,而不是重新分析。
- 3. 依同一套結構為所有內容編碼
Skimle 會為所有來源建立同一套主題結構,或套用您已在報告的框架,讓同一項發現在每個管道中都代表同樣的意思。
- 4. 比較各管道告訴您什麼
看出各來源在哪裡一致、在哪裡矛盾。在客服單中很突出、在訪談中卻缺席的主題,是一項發現,而不是需要抹平的落差。
- 5. 加入下一波資料,不必從頭開始
下一季的資料會依同一套結構編碼,讓追蹤調查保有可比較性,更新後的報告只需重新匯出,不必重建。
常見問題
以下是洞察團隊與研究公司研究主管最常問我們的問題,包括直接來自採購流程的問題。我們的中立 RFP 檢核清單列出了您該問每一家受評廠商的同樣問題,我們也不例外。
- 這如何幫助我們與便宜、淺薄的替代方案競爭?
- 低價供應商與單薄的 AI 外殼,靠文字雲與扁平的主題清單在價格上競爭。Skimle 以它們的速度提供深度,讓研究公司以「所以呢」的品質而非報價脫穎而出,內部團隊也能在固定預算下完成更多研究。分析師的工時從機械性編碼轉向詮釋,而這才是大家真正願意付費的部分。 看看質性研究的錢實際上花在哪裡 →
- 當客戶或利害關係人質疑 AI 輔助分析時,我們該怎麼說?
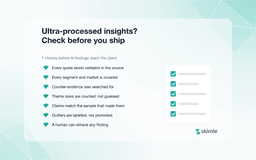
- 如實描述:AI 負責機械性的分類,由具名的研究人員檢視每個主題並撰寫詮釋。接著出示證據。Skimle 報告中的每一項主張都能展開到逐字引文與其來源文件,這比人工綜整能給的答案更有力,因為人工綜整的編碼邏輯只存在於某個人的腦中。 在質性市場研究中負責任地使用 AI 的 7 條準則 →
- Skimle 分析的是整個資料集,還是其中一部分樣本?
- 整個資料集。這一點值得問每一家廠商,因為有些工具會透過嵌入搜尋擷取部分文件、只分析這些文件,卻從不說明哪些文件沒有被納入。結果讀起來像是涵蓋了整個語料,其實並沒有。Skimle 會為每一份文件編碼,您也可以開啟任何一份,確切看到哪些段落被編碼、哪些沒有。
- 我們可以套用自己的類別系統嗎?還是只能接受 AI 產出的結果?
- 兩者皆可,也能在同一個語料上並用。帶入既有的類別系統,Skimle 會據此進行演繹式編碼;或讓它從資料中以歸納方式建立結構。之後類別可以合併、拆分、重新命名、重新排序與刪除,分析會跟著您的修改走。年復一年執行追蹤調查或客戶標準框架的研究公司,通常採演繹式;探索性研究則通常從另一個方向開始。
- 有什麼機制能防止捏造的引文出現在我們的報告中?
- 每一則引文都會以機器方式與來源文件比對。如果模型產出的文字在您的資料中並不逐字存在,Skimle 會標記並重新處理,而不是顯示出來,讓捏造的引文不會出現在給客戶的簡報中。您也可以開啟任何文件,看到哪些段落被編碼、哪些沒有,藉此抓出相反的失誤,也就是有東西被遺漏。 雙向透明如何運作 →
- 我們該如何將 Skimle 與名單上的其他工具比較評估?
- 與其看示範,不如做試點。選一份您已經分析過、知道答案應該是什麼的語料,開始前先寫下三項任務(一項編碼、一項區隔比較、一項找證據),計時每一項(包含修正的工作),並刻意與工具唱反調,看看您能多快重組它的輸出。我們很樂意與您現有的工具並行執行一個實際專案;在那之前,免費方案也能讓一位研究人員在一個下午內形成看法。 7 大面向 RFP 檢核清單與評分範本 →
- Skimle 能處理多少資料?支援多少種語言?
- 每個專案最多 1,000 份文件,足以涵蓋從 20 場訪談的研究到含數千筆問卷回答的全球追蹤調查;並能直接分析 100 多種語言,無需翻譯步驟。單一專案可以混合英文、西班牙文、中文、德文與阿拉伯文,為所有內容建立同一套主題結構,並保留每則引文的原文。如果您經常在這個範圍的上限作業,歡迎與我們討論量的安排。
- 客戶資料安全且保密嗎?
- 所有資料都在歐盟境內的 AWS 上儲存與處理,環境由經認證的第三方設定,客戶資料絕不用於訓練模型。我們提供資料處理協議、依客戶的保密協議工作,工作流程內建假名化,若資料主權有需要,也可採用單一租戶或私有雲部署。
- 如果我們停止使用 Skimle,我們的分析會怎麼樣?
- 無論哪種方案,您都能帶走。將編碼後的資料匯出為開放標準的 REFI-QDA(.qdpx),在 NVivo、ATLAS.ti 或 MAXQDA 中繼續作業,或帶走依主題整理引文的 Word、PowerPoint 與 Excel 成果。我們實作互通標準,正是為了讓留下來是一種選擇,而不是不得不然。
- 研究量起伏時,計價方式如何運作?
- Skimle 是輕量的按席位訂閱,內含積分額度,另可在大型研究進行的月份加購積分包。訂閱讓整個團隊在專案之間持續使用工具;積分包則讓成本歸屬到產生它的專案,這對需要向客戶轉嫁費用的研究公司很重要。只需要閱讀結論的利害關係人不需要席位,因為匯出檔與可列印的研究報告就足夠了。
- 多位研究人員可以同時處理同一個專案嗎?
- 可以,可以同時作業,且每個人的編輯與註記都會保留。這適合同儕審查與品質控管,也適合將大型研究分給初階與資深研究人員,由一位資深主導者掌握類別結構。
由專業人士打造,服務專業人士
Skimle 擁有超過 1,500 名滿意的使用者,遍及 50 多所大學、政府機關、代理商和企業。所有資料均儲存於歐盟境內,處理方式請參閱我們嚴格的 GDPR 政策 與 服務條款.
想了解更多?歡迎瀏覽我們的 Signal & Noise 部落格、我們的 常見問題,以及依產業劃分的應用情境。我們也很樂意為您示範產品,或一起探討 Skimle 如何契合您的需求。 了解 Skimle 背後的公司