Wortwolke
Die Wörter, die Ihre Dokumente verwenden, sowie die Personen, Orte, Organisationen und Themen, die sie benennen.
Die Wortwolke zeigt, worüber Ihre Dokumente sprechen - die Wörter selbst oder die Personen, Orte, Organisationen und Themen, die die Analyse gefunden hat. Je größer ein Element, desto höher steht es in der von Ihnen gewählten Messgröße. Sie befindet sich in der Ansicht Übersicht der Visualisierungen, und jedes Element ist anklickbar: Die Detailkarte zeigt genau, welche Dokumente dahinterstehen.
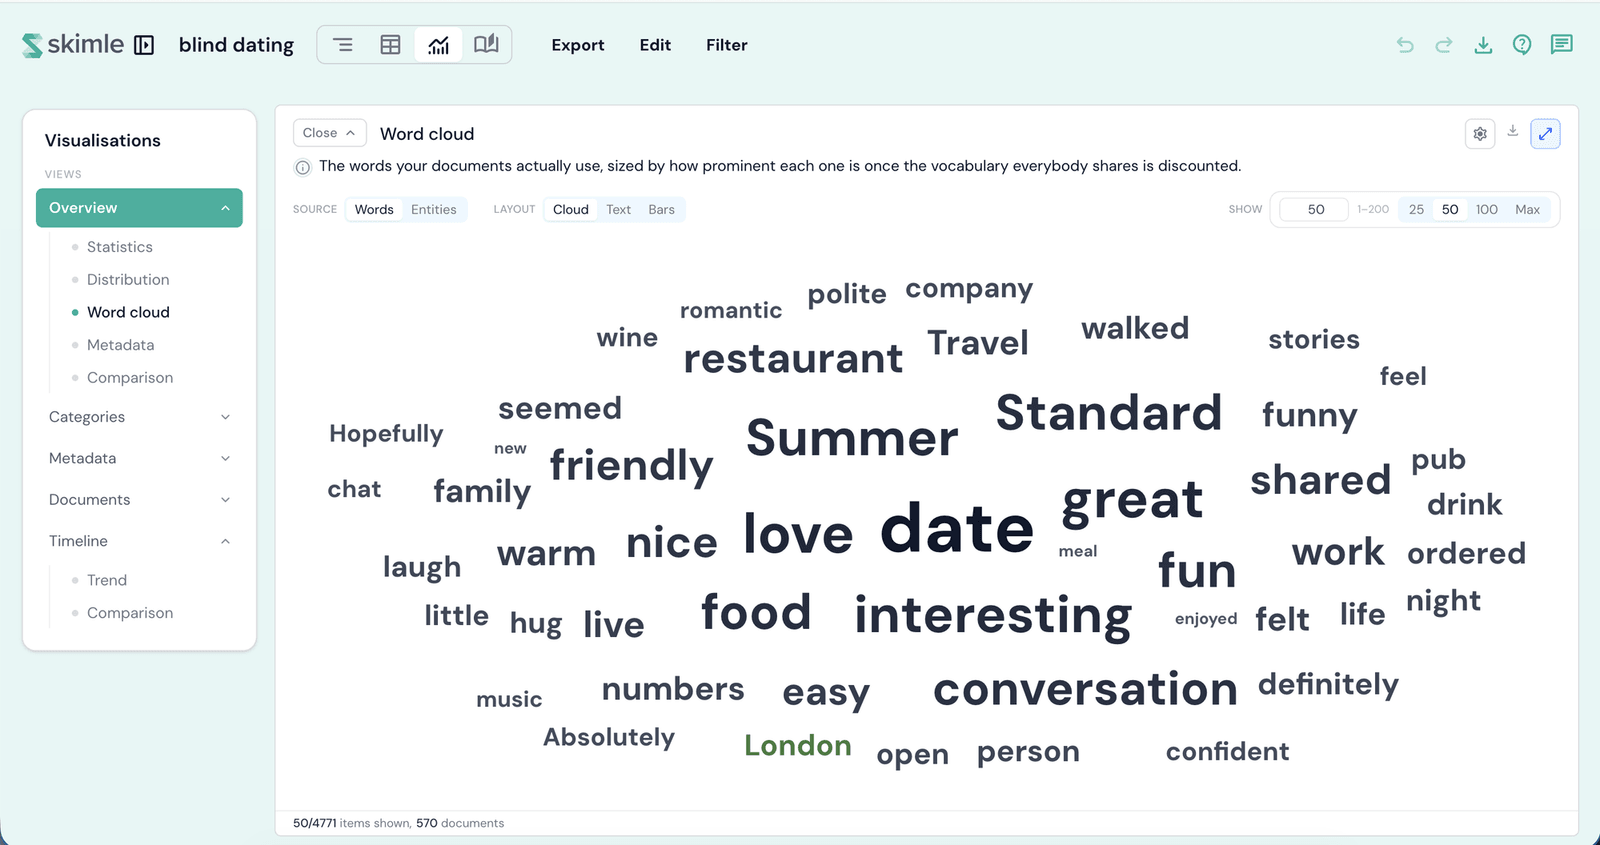
Wörter und Entitäten
Die Steuerung Quelle wechselt zwischen zwei sehr unterschiedlichen Pools:
- Wörter - das eigene Vokabular Ihrer Dokumente. Wörter werden auf ihren Wortstamm reduziert, sodass talk, talking und talked einmal gezählt werden.
- Entitäten - die Personen, Orte, Organisationen, Ereignisse und Themen, die die Analyse gefunden hat. Die Farbe zeigt den Entitätstyp, und die Chips unterhalb der Werkzeugleiste schalten Typen ein und aus.
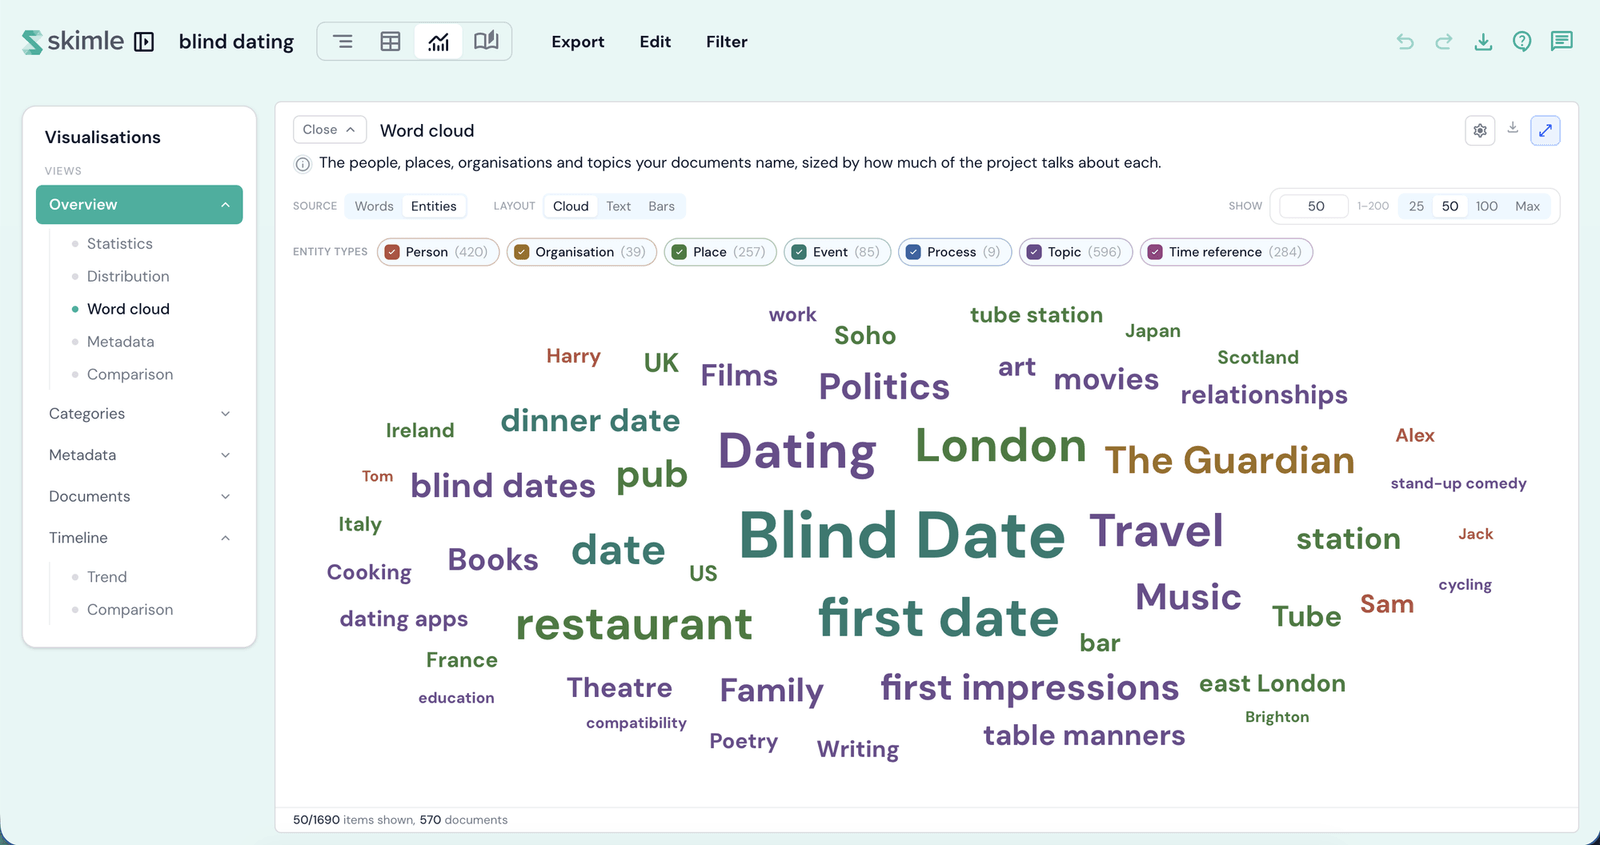
Ein ehrlicher Hinweis zu Entitäten: Sie werden von einem Sprachmodell gefunden, das den Sinn erfasst, nicht durch Textabgleich. Das bedeutet, dass ein Dokument zu einer Entität zählen kann, ohne dass deren Name je darin vorkommt - und es bedeutet, dass sich gelegentlich eine falsche Zuordnung einschleicht, etwa eine Berufsbezeichnung, die als Person gelesen wird, oder zwei Schreibweisen eines Namens, die getrennt bleiben. Klicken Sie auf eine Entität, um die dahinterstehenden Dokumente zu sehen und sich selbst ein Urteil zu bilden; die Detailkarte trennt sogar Dokumente, die den Namen schreiben, von solchen, die ihn erwähnen, ohne ihn zu nennen.
Layouts
- Wolke - die klassische Spirale. Alles, was nicht ohne Überlappung platziert werden kann, wird weggelassen, sodass die Fußzeile zählt, was tatsächlich gezeichnet wurde.
- Text - ein fließender Block, das Größte zuerst.
- Balken - dieselben Elemente wie in einem sortierten Balkendiagramm, mit genauen Zahlen.
Anzeigen legt fest, wie viele Elemente gezeichnet werden - geben Sie eine genaue Zahl ein oder wählen Sie eine Voreinstellung. Jedes Layout merkt sich seine eigene Einstellung.
Sortieren nach
Hinter dem Zahnrad legt Sortieren nach die Messgröße fest, die Größe und Reihenfolge bestimmt:
- Erwähnungen - die reine Gesamtzahl: wie oft es vorkommt. Am besten geeignet für die schiere Menge, wobei ein Dokument, das es wiederholt, diesen Wert aufblähen kann. Nur für Wörter.
- Dokumente - wie viele Dokumente es erreicht. Am besten geeignet, um ein gemeinsames Anliegen von einer einzelnen lauten Stimme zu unterscheiden.
- Sticht heraus - häufig genannt, aber nicht überall. Etwas, das jedes Dokument enthält - eine Interviewfrage, eine E-Mail-Kopfzeile - fällt nahezu auf null, sodass übrig bleibt, was hier tatsächlich heraussticht.
Wörter starten bei Erwähnungen; Entitäten starten bei Dokumenten.
Min. Erwähnungen
Ebenfalls hinter dem Zahnrad verbirgt eine Mindestschwelle den langen Ausläufer: Ziehen Sie den Schieberegler von Beliebig bis zum höchsten Wert im Pool, oder geben Sie eine genaue Zahl ein. Bei Wörtern heißt sie Min. Erwähnungen, bei Entitäten Min. Dokumente.
Füllwörter ausblenden
Bei Wörtern blendet der Schalter Füllwörter ausblenden alltägliche Füllwörter wie just, really und think aus, zusätzlich zu Kopfzeilenresten wie Fri oder GMT. In Projekten mit 10 oder mehr Dokumenten blendet er zudem jedes Wort aus, das in fast jedem Dokument vorkommt, da ein Wort, das überall vorkommt, nichts unterscheidet. Nichts wird gelöscht - schalten Sie ihn aus, und alle Wörter kehren zurück. Entitäten werden nie gefiltert.
Die Detailkarte
Klicken Sie auf ein beliebiges Element, um zu sehen, in welchen Dokumenten es vorkommt, mit Anzahl je Dokument, und öffnen Sie eines direkt. Ein guter erster Versuch: Setzen Sie bei Wörtern Sortieren nach auf Dokumente - was dann ganz oben steht, ist meist Ihr Fragebogen, nicht Ihre Teilnehmenden.