Akadeemiline põhjalikkus tehisintellekti kiirusega
Skimle on loodud teadlaste poolt teadlastele. Kaasasutaja professor Henri Schildtil on aastakümnete pikkune kogemus kvalitatiivses uurimistöös ja artiklid juhtivates juhtimisteaduse ajakirjades, sealhulgas Academy of Management Journalis ja Organization Science'is. Ta tüdines NVivo ja MAXQDA aeglastest, kohmakatest töövoogudest ning teda tegi murelikuks see, kuidas ChatGPT-d kasutatakse analüüsiks, millel puudub läbipaistvus ja terviklikkus. Seepärast ehitas ta Skimle platvormiks, mis kordab põhjalikku ja läbipaistvat kvalitatiivset metoodikat, kuid mille keskmes on tehisintellekt.
Intervjuude esmane kodeerimine võib käsitsi võtta nädalaid. Skimle teeb selle ära, loobumata metodoloogilisest põhjalikkusest, ja leiab sageli tsitaate, mis inimesel jääksid märkamata. Iga teema on seotud kontrollitud sõnasõnalise tsitaadiga. Täielik auditijälg rahuldab retsensente.
Õppematerjalid →Põhjalik analüüs, mis laseb teil keskenduda oma teoreetilisele panusele
Skimle lähenemine on inspireeritud põhistatud teooriast (Glaser & Strauss; Strauss & Corbin) ja Gioia meetodist. See annab süsteemse ja läbipaistva analüüsi, mida eelretsenseerimine nõuab, ilma nädalaid kestva mehaanilise kodeerimiseta, mis neelab teooria jaoks paremini kasutatavat aega. See töötab enam kui 100 keeles ja käsitleb kuni 1000 dokumenti projekti kohta.
- Automaatne esmane kodeerimine: iga tsitaat on seotud oma kategooriaga
- Täielik kahesuunaline auditijälg eelretsenseerimiseks ja metoodika läbipaistvuseks
- Kategooriasüsteem teie kontrolli all: ühendage, jagage, nimetage ümber ja korraldage kategooriaid vabalt ümber
- Töötab enam kui 100 keeles ilma tõlkimiseta
- Käsitleb intervjuusid, heli ja videot, raamatuid, dokumente ja arhiivimaterjale
- Saadaval on Skimle Academic, soodushinnaga pakett
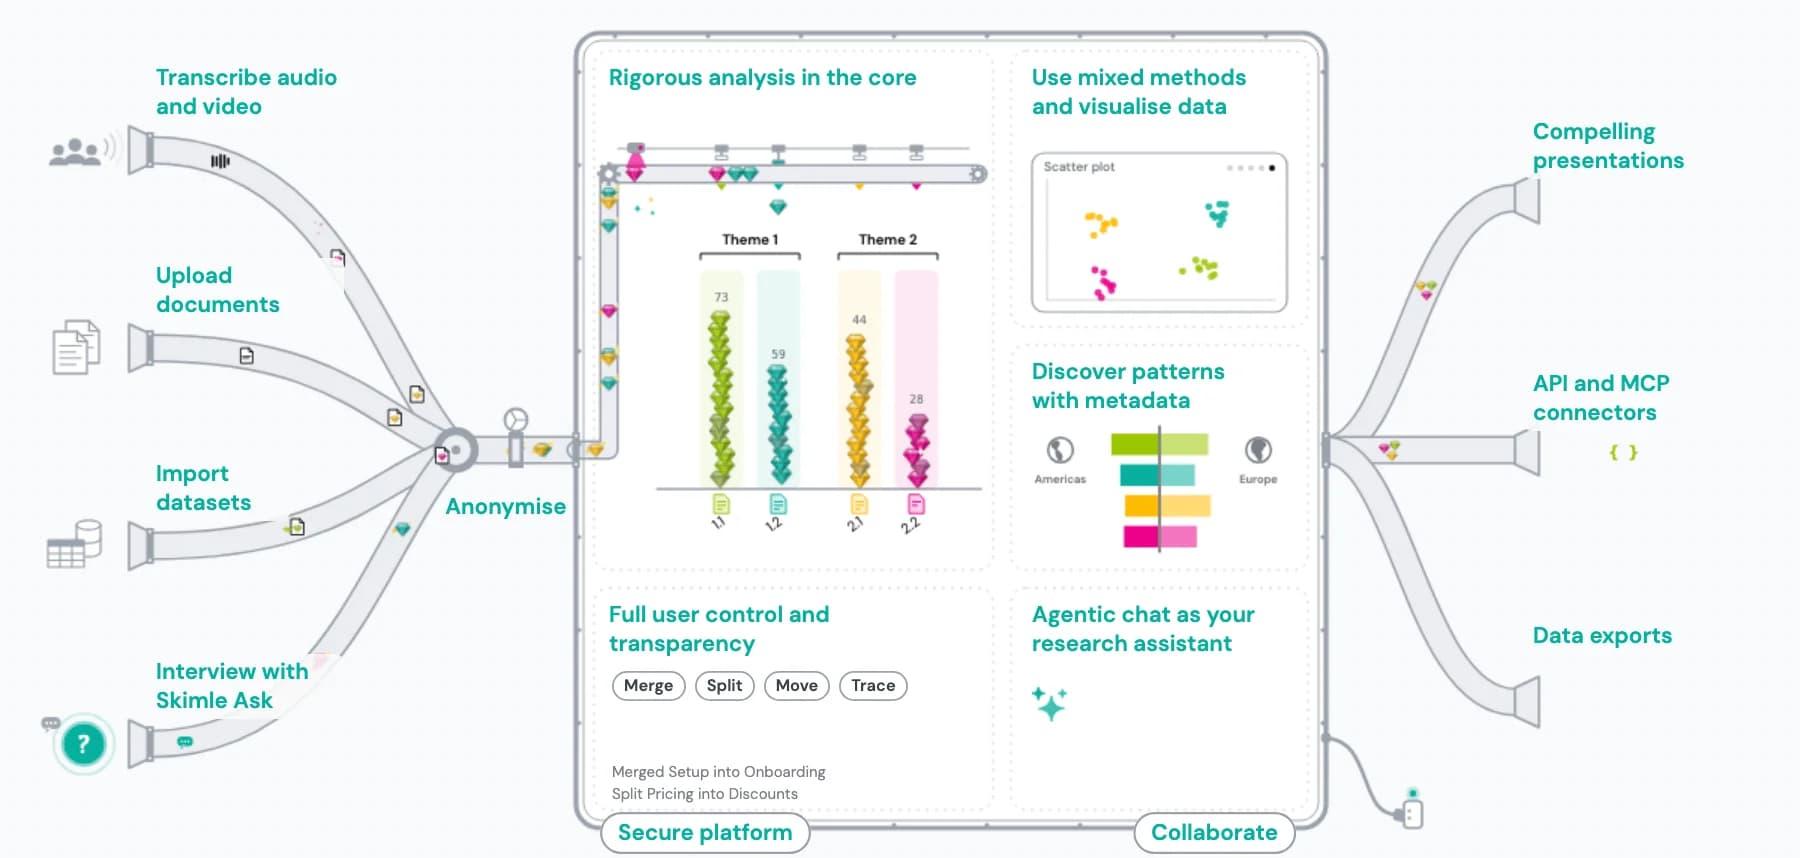
Transkribeerige ja anonüümige intervjuud
Välitöö salvestiste muutmine kasutatavateks andmeteks välise teenuse kaudu on aeglane ja kallis ning transkriptsioonides on nimed, kuuluvused ja asukohad, mis tekitavad GDPR- ja eetikakohustusi enne, kui saate neid jagada, arhiveerida või tsiteerida. Skimle transkribeerib heli ja video oma turvalises ELis majutatud keskkonnas ning anonüümib need seejärel uurimistöö tasemel pseudonüümimisega, nii et teil on samal päeval nõuetele vastav ja kodeerimiseks valmis transkriptsioon ning andmed ei lahku kunagi GDPR-ile vastavalt taristult.
Kuidas see töötab
- 1. Laadige üles heli, video või tekst
Laadige otse üles MP3-, M4A-, WAV-, MP4-, MOV-, PDF- või Wordi-faile. Välist transkribeerimisteenust pole vaja ja enam kui 100 keelt on loomulikult toetatud.
- 2. Transkribeerige koos kõnelejate märgistusega
Skimle transkribeerib salvestise, tuvastab kõnelejate vahetused ning saab hakkama aktsentide ja erineva helikvaliteediga. Vaadake tulemus enne analüüsi algust üle ja parandage see.
- 3. Tuvastage tunnused automaatselt
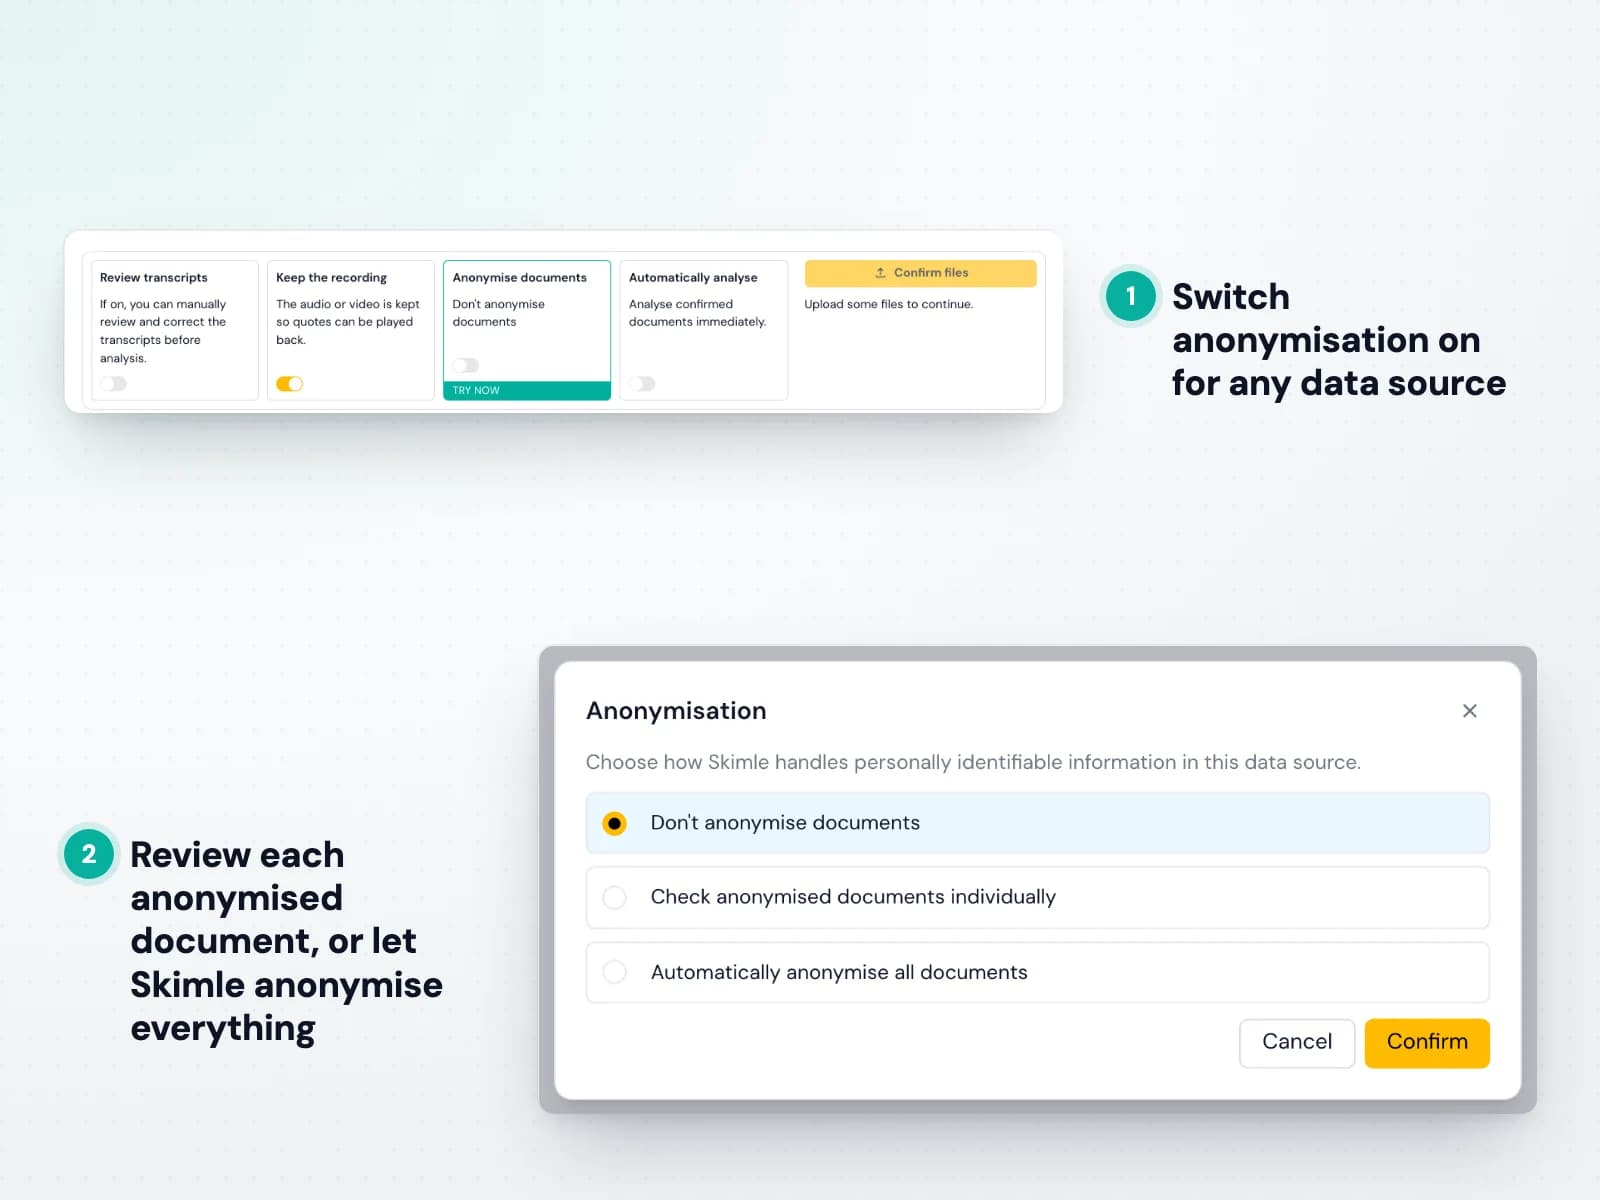
Skimle Anonymise märgib tunnused kuues kategoorias (nimed, ametinimetused ja rollid, asukohad, organisatsioonid, kuupäevad ja muu) igas dokumendis, failide lõikes järjepidevalt, nii et sama inimene saab alati sama pseudonüümi.
- 4. Valige anonüümimise tase
Valige kerge pseudonüümimine, tugev pseudonüümimine või HIPAA tasemel anonüümimine, mille puhul võti hävitatakse. Häälestage iga kategooriat eraldi ja lisage kohandatud reegleid lihtsas keeles.
- 5. Eksportige koos auditidokumentatsiooniga
Eksportige eetikakomitee jaoks PDF-auditiaruanne ja Exceli vastavustabel ning suunake puhastatud transkriptsioon otse Skimle analüüsi töövoogu. Lähteheli kustutatakse seejärel turvaliselt.

Tehke intervjuude kvalitatiivne analüüs tehisintellekti toel
Enam kui 40 intervjuul põhinev uurimistöö peaks andma rikkaliku teoreetilise panuse (näiteks teie doktoritöö jaoks), kuid käsitsi kodeerimine (esiletõstmine, korrastamine, ümberkodeerimine, jälgimistabelite koostamine) neelab suurema osa olemasolevast ajast ja võib ikkagi jätta olulised mustrid märkamata. Skimle loeb süsteemselt läbi iga intervjuu ja annab teile struktureeritud teemahierarhia koos sõnasõnaliste tsitaatidega, et saaksite kulutada aega teoreetilisele tõlgendamisele, mida saate teha ainult teie.
Kuidas see töötab
- 1. Laadige üles oma transkriptsioonid
Lohistage intervjuude transkriptsioonid sisse PDF-, Wordi- või lihttekstifailidena. Skimle võtab vastu dokumente igas vormingus ja toetab loomulikult enam kui 100 keelt.
- 2. Kirjeldage oma uurimisküsimust
Määrake oma analüütiline fookus, laiemalt või kitsamalt. Skimle korraldab esmase kodeerimise selle ümber, mida püüate teoreetiliselt mõista.
- 3. Vaadake üle esmane koodistruktuur
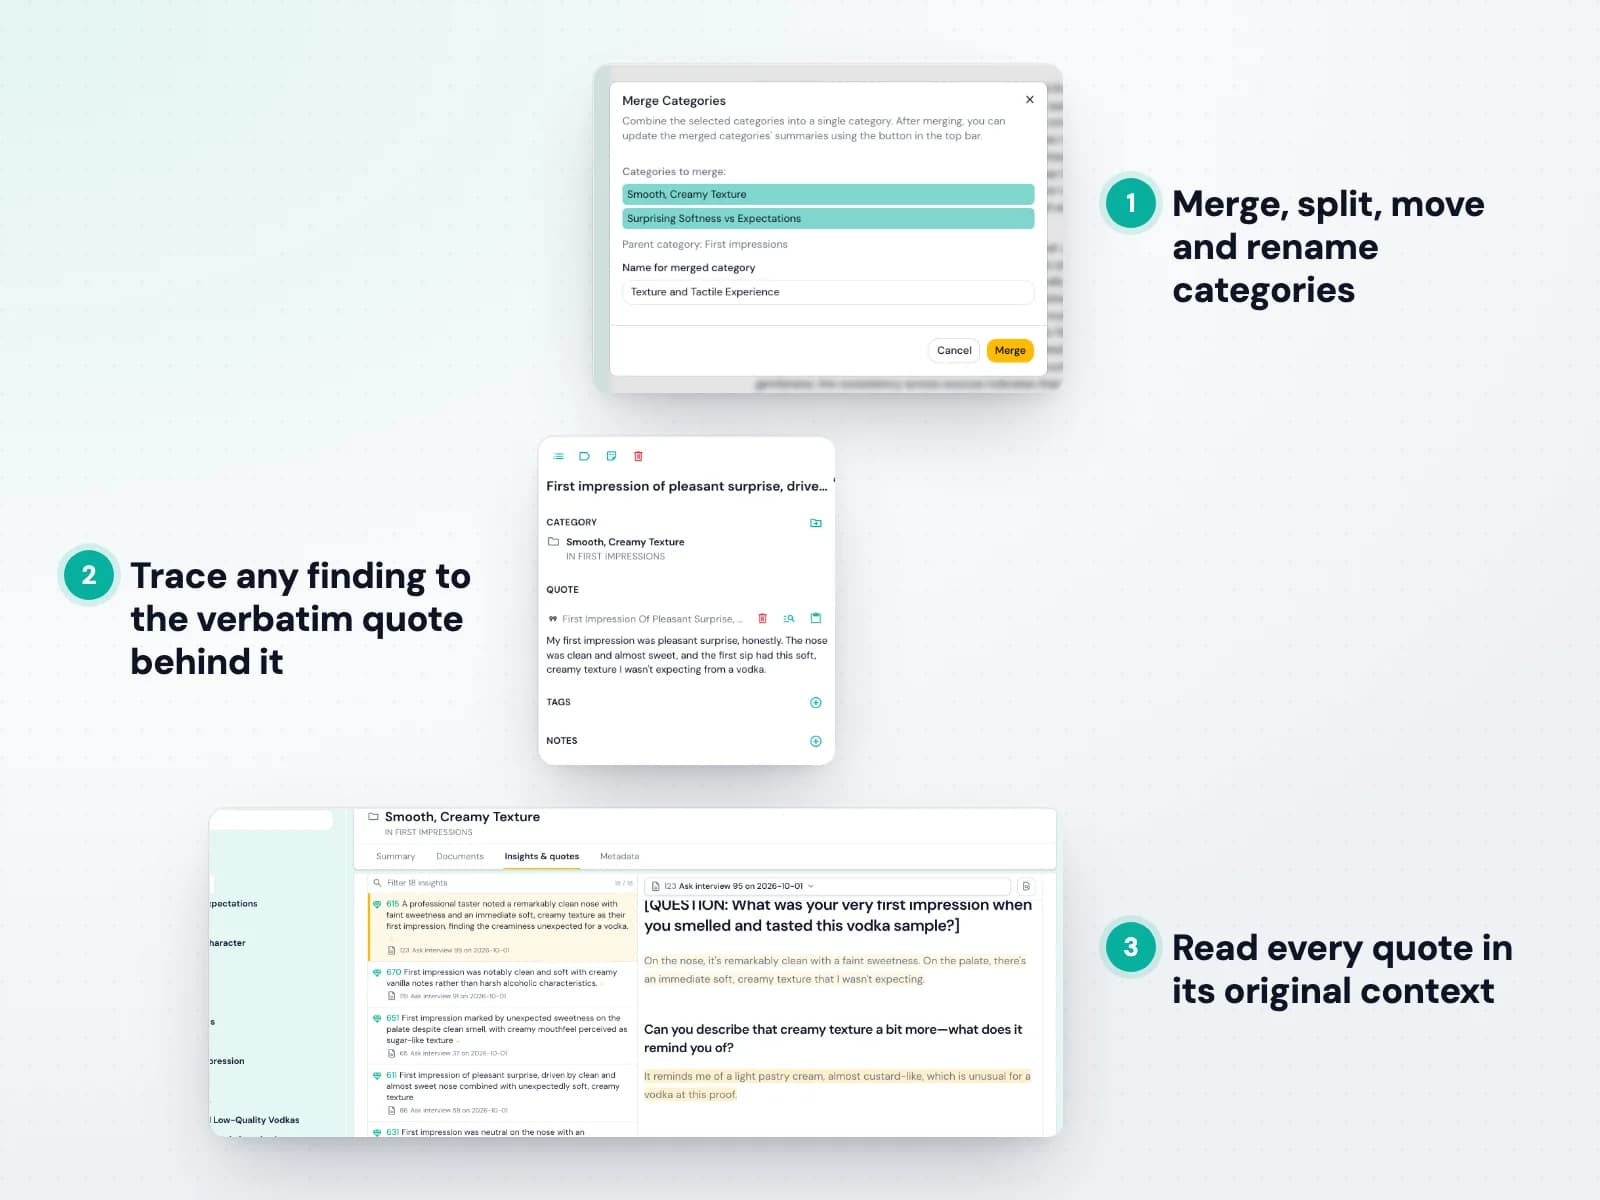
Skimle loob teemahierarhia, kus iga teema on seotud lähtetranskriptsioonide sõnasõnaliste tsitaatidega. Midagi ei mõelda välja. Iga kood viib tekstini.
- 4. Täpsustage see oma teoreetilise raamistiku järgi
Ühendage, jagage, nimetage ümber ja korraldage kategooriaid ümber, et need sobiksid teie kujuneva teoreetilise mudeliga. Kahesuunaline läbipaistvus võimaldab igal hetkel kontrollida, millised tsitaadid milliseid koode toetavad.
- 5. Eksportige metoodikalisa jaoks
Eksportige oma kategooriasüsteem ja seda toetavad tsitaadid tekstina või avatud REFI-QDA vormingus (.qdpx), mida toetavad traditsioonilised CAQDAS-programmid nagu NVivo, ATLAS.ti ja MAXQDA.
Tehke segameetodite analüüs kogu valimi ulatuses
Kvalitatiivsetel tulemustel on rohkem kaalu, kui saate näidata, kuidas need valimis erinevad: kohordi, rolli, soo, asukoha või tingimuse järgi. Teemade käsitsi ristitabeldamine osalejate tunnuste järgi on tüütu ja vigaderohke. Skimle lisab igale dokumendile metaandmed ja laseb sama teemastruktuuri segmentida mis tahes muutuja järgi, nii et saate liikuda rikkalike sõnasõnaliste tsitaatide ja kvantifitseeritud mustrite vahel, ilma et peaksite ühest metoodikast loobuma.
Kuidas see töötab
- 1. Lisage dokumentidele metaandmed
Märgistage iga transkriptsioon muutujatega, mis on teie uuringu ülesehituse jaoks olulised (kohort, roll, sugu, asukoht, uuringulaine või katsetingimus), käsitsi või CSV-veeru põhjal.
- 2. Käivitage kvalitatiivne analüüs
Skimle loob ühe teemahierarhia kõigi dokumentide ulatuses, nii et iga osalejat kodeeritakse sama struktuuri järgi.
- 3. Segmentige teemad muutuja järgi
Vaadake, kuidas iga teema rühmade lõikes erineb, ja märgake, kus muster on universaalne ja kus omane ühele kohordile.
- 4. Mõõtke levimust
Lugege teemade sagedusi ja jaotusi, et raporteerida, kui levinud on kood igas segmendis. Iga loenduse saab jälgida tagasi tsitaatideni, millest see tekkis.
- 5. Eksportige tabelid ja tsitaadid
Eksportige risttabelid ja toetavad tsitaadid Excelisse või Wordi oma artikli segameetodite osa jaoks.

Korduma kippuvad küsimused
- Kas võin oma uurimistöös Skimlele viidata?
- Jah. Kirjeldage seda metoodikaosas kui „tehisintellekti toega kvalitatiivse kodeerimise tarkvara“, nagu viitaksite NVivole või MAXQDA-le. Meil on eelretsenseerimisel metoodikaartikkel, mis annab ametliku viite, ja seni saame soovi korral pakkuda sobiva sõnastuse.
- Kas retsensendid aktsepteerivad tehisintellekti toel tehtud analüüsi?
- Üha sagedamini jah, kui dokumentatsioon on korralik. Skimle auditijälg annab retsensentidele selle, mida nad ootavad: dokumenteeritud, süsteemse kodeerimisprotsessi, kus iga teema viib konkreetsete tsitaatideni, nii et metoodikaosa kirjutab end suures osas ise.
- Kuidas Skimle võrdub NVivo või MAXQDA-ga?
- NVivo ja MAXQDA sobivad teadlastele, kellel on analüüsiks nädalaid ja asutuse litsents. Skimle automatiseerib mehaanilise kodeerimisetapi (nädalatest tundideni), säilitades sama süsteemse ja läbipaistva metoodika, ning õppimine võtab minuteid. Paljud teadlased kasutavad mõlemat: Skimlet esimeseks kodeerimisringiks ja NVivot segameetodite integreerimiseks.
- Kas Skimle sobib põhistatud teooria jaoks?
- Jah. Skimle toetab induktiivset kodeerimist, kus teemad tekivad andmetest, mitte ei ole ette määratud. Alustage laia fookusega ja laske kategooriastruktuuril iteratiivselt areneda, mis vastab hästi avatud kodeerimisele põhistatud teoorias.
- Kas saan teha segameetodite analüüsi?
- Jah. Lisage igale dokumendile metaandmete muutujad (kohort, roll, sugu, asukoht, tingimus) ja segmentige teemastruktuuri ükskõik millise järgi. Saate teemade sagedused ja jaotused rühmade kaupa, igaüks jälgitav sõnasõnaliste tsitaatideni ja valmis teie artikli segameetodite osa jaoks.
- Kas minu uurimisandmed on turvalised?
- Teie transkriptsioone töödeldakse ELis majutatud taristul ja neid ei kasutata kunagi tehisintellekti mudelite treenimiseks. Pakume asutuse eetikanõuete jaoks andmetöötluslepinguid ja suudame täita enamiku IT-turvanõuetest. Võtke meiega ühendust oma konkreetsete nõuetega.
- Kas saan akadeemilist soodustust?
- Jah. Kehtiva asutuse e-posti aadressi ja kuuluvust näitava lehega teadlased saavad osta soodushinnaga Skimle Academic paketi. Kui vajate uurimisrühmale või laborile meeskonnajuurdepääsu, võtke asutuse litsentsi asjus meiega ühendust.
Spetsialistidelt spetsialistidele
Skimlel on üle 1500 rahuloleva kasutaja enam kui 50 ülikoolis, riigiasutuses, agentuuris ja ettevõttes. Kõiki andmeid hoitakse ELis ja töödeldakse kooskõlas meie range GDPR-i poliitika ja kasutustingimustega.
Soovite rohkem teada? Tutvuge meie blogiga Signal & Noise, KKK-ga ja valdkondade kaupa kasutusjuhtudega. Näitame hea meelega ka toodet või uurime koos, kuidas Skimle teie vajadustele sobiks. Lugege lähemalt Skimle taga olevast ettevõttest