Skimle funktsioonide ülevaade
Skimle on tehisintellektil põhinev kvalitatiivsete andmete analüüsi tarkvara turu-uurijatele, klienditähelepanekute ekspertidele, akadeemilistele teadlastele, konsultantidele ja teistele uudishimulikele spetsialistidele, kes soovivad oma andmetesse süveneda.
Laadige üles intervjuude transkriptsioone, fookusrühmade salvestisi, tuhandete vabatekstiliste vastustega tabeleid, dokumente või muid kvalitatiivseid andmeid enam kui 100 toetatud keeles. Skimle põhjalik alt-üles töövoog tuvastab tähelepanekud ja loob läbipaistva kategooriastruktuuri, mida saate vabalt muuta. Saate andmeid visualiseerida segameetoditega, avastada mustreid metaandmete abil, ühendada oma tehisintellekti agendi MCP kaudu oma andmetega, luua veenvaid esitlusi ja palju muud.
Meie platvorm sisaldab ka Skimle Aski, võimsat tehisintellekti toel töötavat küsitlusmootorit rikkalike kvalitatiivsete tähelepanekute kogumiseks suures mahus. Koostage intervjuukava, jagage linki vastajatega ja koguge andmeid teksti-, hääle- või videovastustena koos nutikate täpsustavate küsimustega.
Skimle ühendab akadeemilise põhjalikkuse ja ärilise praktilisuse. Paljud tehisintellekti tööriistad jätavad tegeliku analüüsi vahele ja annavad vaid usutava, kuid mittekaitstava kokkuvõtte, mis on altis kallutatusele ja hallutsinatsioonidele. Traditsioonilised tööriistad nagu NVivo, MAXQDA või ATLAS.ti sunnivad teid kulutama suurema osa ajast käsitsi kodeerimisele, mitte tegelikule analüüsile. Skimle on ehitatud teisiti: saate põhjaliku automatiseeritud tehisintellekti analüüsi töövoo täieliku kahesuunalise läbipaistvuse ja kasutaja kontrolliga.
Skimle on täisteenusega kvalitatiivse analüüsi platvorm
Skimle on mitmekülgne tööriist, millega saate…
Animeeritud skeem sellest, kuidas Skimle töötab. Andmed sisenevad nelja sisendtoru kaudu: transkribeerimine, dokumentide üleslaadimine, andmestike import ja Skimle Aski intervjuud. Need läbivad anonüümimisventiili ja jõuavad masinasse, kus tähelepanekud sorteeritakse teemadeks, neid uuritakse visualiseeringutega, võrreldakse metaandmete lõikes ja arutatakse tehisintellekti uurimisassistendiga. Tulemused väljuvad kolme eksporditoru kaudu: esitlused, API- ja MCP-ühendused ning andmete eksport.
Akadeemiline uurimistöö
Kirjanduse ülevaade
Importige artikleid ja teiseseid allikaid, kodeerige automaatselt teemasid sadades dokumentides ning leidke kirjanduses lünki ja mustreid tundidega, mitte nädalatega.
Loe edasi →Temaatiline analüüs
Skimle tehisintellekt tuvastab intervjuude transkriptsioonides korduvad teemad ja loob kategooriapuu, mida saate üle vaadata, muuta ja valideerida, kusjuures iga teema on jälgitav konkreetsete tsitaatideni.
Loe edasi →Põhistatud teooria
Looge teooriat induktiivselt toorandmetest lähtudes. Skimle kodeerib teie transkriptsioonid, toob esile tekkivad mõisted ja võimaldab teil kategooriasüsteemi mustrite arenedes järk-järgult täpsustada.
Loe edasi →Induktiivne kodeerimine
Alustage avatud kodeerimisest ja laske Skimlel pakkuda kategooriaid otse teie andmetest. Vaadake koodid üle, ühendage ja nimetage neid ümber, et need sobiksid teie analüütilise vaatenurgaga, säilitades kogu aeg täieliku kontrolli.
Loe edasi →Deduktiivne kodeerimine
Rakendage oma materjalile eelmääratud kategooriasüsteemi. Skimle sobitab teie kategooriad uute andmetega, näidates täielikult, millised tsitaadid iga koodi käivitasid.
Loe edasi →Segameetodid
Ühendage kvantitatiivsed metaandmed kvalitatiivsete teemadega. Koostage kodeerimiskategooriatest ja vastajate demograafiast ristabeleid, et leida statistiliselt tähenduslikke mustreid.
Loe edasi →
Turu-uuringud ja klienditähelepanekud
Kvalitatiivsed turu-uuringud
Viige läbi ja analüüsige süvaintervjuusid, fookusrühmi ja avatud vastuseid ühes kohas: kogu kvalitatiivse turu-uuringu töövoog transkriptsioonist tsitaatidega toetatud teemadeni.
Loe edasi →Fookusrühmade uuringud
Transkribeerige ja analüüsige fookusrühmade arutelusid, jälgides, kes mida ütles ja kuidas teemad osalejarühmade, moderaatorite ja sessioonide vahel erinevad.
Loe edasi →Kliendiintervjuud
Kodeerige süvaintervjuusid süsteemselt, tuvastage küllastumine kogu uuringuprogrammis ja eksportige kliendiesitluste jaoks selged, tsitaatidega toetatud aruanded.
Loe edasi →Turu hääl
Koondage ja kodeerige suurte valimite avatud küsitlusvastuseid, et mõista turu arusaamu, rahuldamata vajadusi ja esilekerkivaid suundumusi segmentide lõikes.
Loe edasi →Fookusintervjuud
Viige Skimle Askiga läbi struktureeritud süvaintervjuusid, kodeerige vastused automaatselt ja võrrelge tulemusi vastajasegmentide vahel kohe.
Loe edasi →
Konsultatsioon ja due diligence
Ekspertvestluste süntees
Transkribeerige ja kodeerige projekti käigus peetud vestlusi ekspertvõrgustike ekspertidega. Looge murdosa ajaga struktureeritud ülevaade ekspertide vaadetest turudünaamikale, riskidele ja võimalustele.
Loe edasi →Huvirühmade sisendi analüüs
Analüüsige huvirühmade intervjuusid ja töötubade tulemusi süsteemselt, et kõik hääled oleksid teie lõplikes soovitustes esindatud ja jälgitavad.
Loe edasi →Dokumentide kokkuvõtted
Eraldage murdosa ajaga suurtest dokumendikogudest, nagu regulatiivsed dokumendid, ettevõtete aruanded ja teadusartiklid, peamised teemad ja seisukohad.
Loe edasi →Andmeanalüüs tehisintellektiga
Kasutage Skimle tehisintellekti, et kiiresti kodeerida ja kategoriseerida intervjuude, küsitluste ja dokumentide kvalitatiivseid andmeid, nii et konsultandid saavad keskenduda sünteesile ja tähelepanekutele.
Loe edasi →Lauauuringud
Korrastage ja analüüsige teiseseid uurimisallikaid, kodeerige teemasid automaatselt ja jälgige täpselt, kust teie dokumendikogus iga tähelepanek pärineb.
Loe edasi →
Uudishimulikud spetsialistid
Ettevõtte mälu
Looge otsitav, kodeeritud ettevõtte teadmiste hoidla: koosolekumärkmed, strateegiadokumendid ja uuringud, mida teie meeskond saab päringutega uurida, analüüsida ja aja jooksul täiendada.
Loe edasi →Andmeanalüüs tehisintellektiga
Laadige üles mis tahes struktureerimata andmed (e-kirjad, aruanded, märkmed) ja laske Skimlel neid struktureerida ja kodeerida, muutes laiali pillutud toormaterjali korrastatud ja otsitavaks teadmuseks.
Loe edasi →Dokumentide analüüs
Analüüsige lepinguid, poliitikadokumente või teadusartikleid, et eraldada peamised teemad ja tähelepanekud ilma iga sõna lugemata, tsitaatidega, mis on jälgitavad algallikani.
Loe edasi →Ühekordne analüüs
Tehke kiire struktureeritud analüüs mis tahes andmestikule (intervjuumärkmed, kliendikirjad, tagasiside), ilma et peaksite pühenduma pikale uuringuprogrammile või õppima keerulist tööriista.
Loe edasi →Andmestike süntees
Ühendage mitme andmeallika tähelepanekud ühtseks kategooriasüsteemiks, tuvastades ühised teemad ja erinevused eri kontekstidest pärit andmestike vahel.
Loe edasi →
Tootejuhtimine
Kliendi tagasiside analüüs
Koondage rakenduse arvustused, tugipöördumised ja küsitlusvastused struktureeritud teemadeks. Tuvastage kohe suurimad valupunktid ja funktsioonisoovid mis tahes andmemahu puhul.
Loe edasi →Pidev avastamine
Viige läbi kergeid intervjuutsükleid ja kodeerige tulemused püsivasse tähelepanekute hoidlasse. Jälgige, kuidas teemad toote versioonide ja kvartalite lõikes arenevad.
Loe edasi →Kasutajauuringud
Transkribeerige ja analüüsige kasutatavustestide sessioone, süvaintervjuusid ja päevikuuuringuid. Jõudke kiiremini tähelepanekuteni, kaotamata rikkalikke kvalitatiivseid detaile, mida teie meeskond vajab.
Loe edasi →Kõnelogide analüüs
Laadige üles müügi- või tugikõnede salvestised, transkribeerige need automaatselt ja kodeerige suures mahus, et tuvastada korduvad vastuväited, funktsioonisoovid ja meelestatuse mustrid.
Loe edasi →
Personal, inimesed ja kultuur
Lahkumisintervjuude analüüs
Kodeerige lahkumisintervjuude vastuseid suures mahus, et tuvastada töötajate hoidmise riske, juhtimismustreid ja süsteemseid probleeme enne, kui need organisatsioonis kuhjuvad.
Loe edasi →Töötajate pühendumuse uuringud
Muutke küsitluste avatud vastused struktureeritud teemadeks. Mõistke, mis mõjutab pühendumust ja rahulolematust meeskondade, asukohtade ja staažigruppide lõikes.
Loe edasi →Pulsiküsitlused
Viige Skimle Askiga regulaarselt läbi lühikesi intervjuusid ja jälgige, kuidas töötajate meelestatuse teemad ajas arenevad, andes personaliosakonnale reaalajas pildi organisatsiooni tervisest.
Loe edasi →Kultuuriuuringud
Analüüsige kultuurihindamiste kvalitatiivseid andmeid, et leida lõhesid deklareeritud ja tegelike väärtuste vahel, koos täieliku jälgitavusega konkreetsete vastajate tsitaatideni juhtkonna aruandluses.
Loe edasi →
Avalik sektor ja poliitikaanalüüs
Avalike konsultatsioonide analüüs
Analüüsige avalike konsultatsioonide vastuseid suures mahus, kodeerige pöördumised ja tuvastage tuhandete sisendite seast levinuimad seisukohad, mured ja soovitused.
Loe edasi →Poliitikadokumentide ülevaatus
Eraldage peamised teemad ja seisukohad poliitikadokumentidest, regulatiivsetest dokumentidest ja õigusaktide tekstidest, kusjuures iga leid on jälgitav lähtelõiguni.
Loe edasi →Huvirühmade tagasiside
Kodeerige ja analüüsige süsteemselt kodanike, teenuste kasutajate või partnerite struktureeritud tagasisidet, et kõik hääled oleksid talletatud ja aruandluses esindatud.
Loe edasi →Programmi hindamine
Analüüsige programmis osalejate intervjuu- ja küsitlusandmeid, et hinnata mõju, tuua esile korduvad teemad ja koostada tõenditega toetatud hindamisaruandeid.
Loe edasi →
Ühendamine MCP kaudu
Skimle kasutamine Claude'ist
Ühendage Skimle MCP kaudu Claude'iga ja esitage päringuid oma uurimisandmete, kategooriate ja tähelepanekute kohta loomulikus keeles, ilma konteksti vahetamata.
Loe edasi →Tehisintellekti töövoogude loomine
Kasutage Skimle MCP-serverit, et integreerida oma kvalitatiivse uurimistöö andmed mis tahes MCP-ga ühilduvasse tehisintellekti tööriista, automatiseerides analüüsisamme ja suunates tulemused laiematesse töövoogudesse.
Loe edasi →Uuringute päringud API kaudu
Pääsege Skimle andmetele programmiliselt ligi API kaudu. Hankige projekte, dokumente, kategooriaid ja tähelepanekuid kohandatud töölaudade või väliste aruandlustööriistade jaoks.
Loe edasi →
Teemad tekivad andmetest
Iga muudatus logitakse ja selle saab tagasi võtta.
1. samm
Laadige üles ja koguge andmeid
Tooge sisse salvestised, dokumendid ja andmestikud või koguge uusi andmeid tehisintellekti toel tehtavate intervjuudega ning anonüümige need enne analüüsi.
Heli ja video transkribeerimine
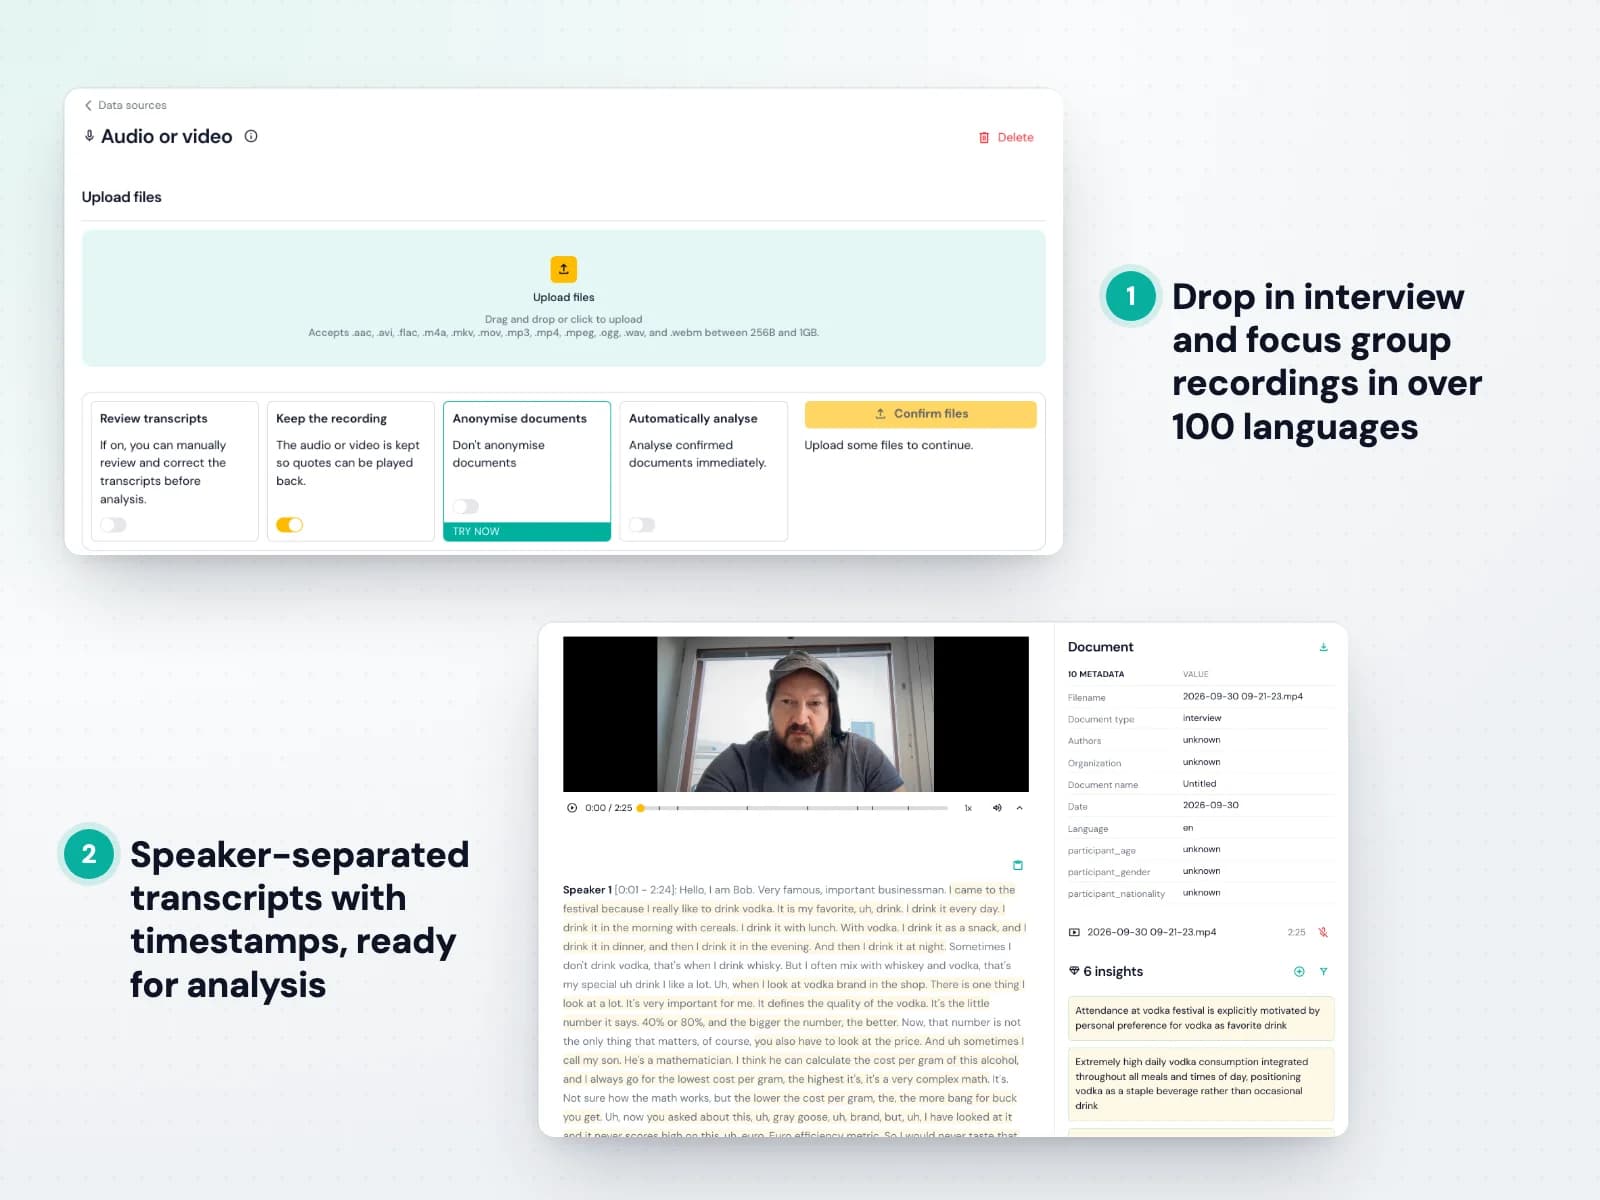
Laadige üles heli või video ja Skimle muudab selle täpseteks mitme kõnelejaga transkriptsioonideks enam kui 100 keeles. Eraldi transkribeerimistööriista eest ei pea maksma ega faile süsteemide vahel tõstma: tekst liigub otse teie projekti. Vaadake, kuidas salvestisi üles laadida.
Iga andmeallika puhul valite, kas soovite transkriptsioonid enne analüüsi üle vaadata, kas iga salvestis jäetakse taasesituseks alles või kustutatakse transkriptsiooni valmimisel ning kas tekst anonüümitakse enne kõike muud.
- MP3, M4A, WAV, MP4, MOV ja muud levinud vormingud
- Kõnelejate eristamine ja ajatemplid
- Valikuline käsitsi ülevaatus enne analüüsi
Dokumentide üleslaadimine
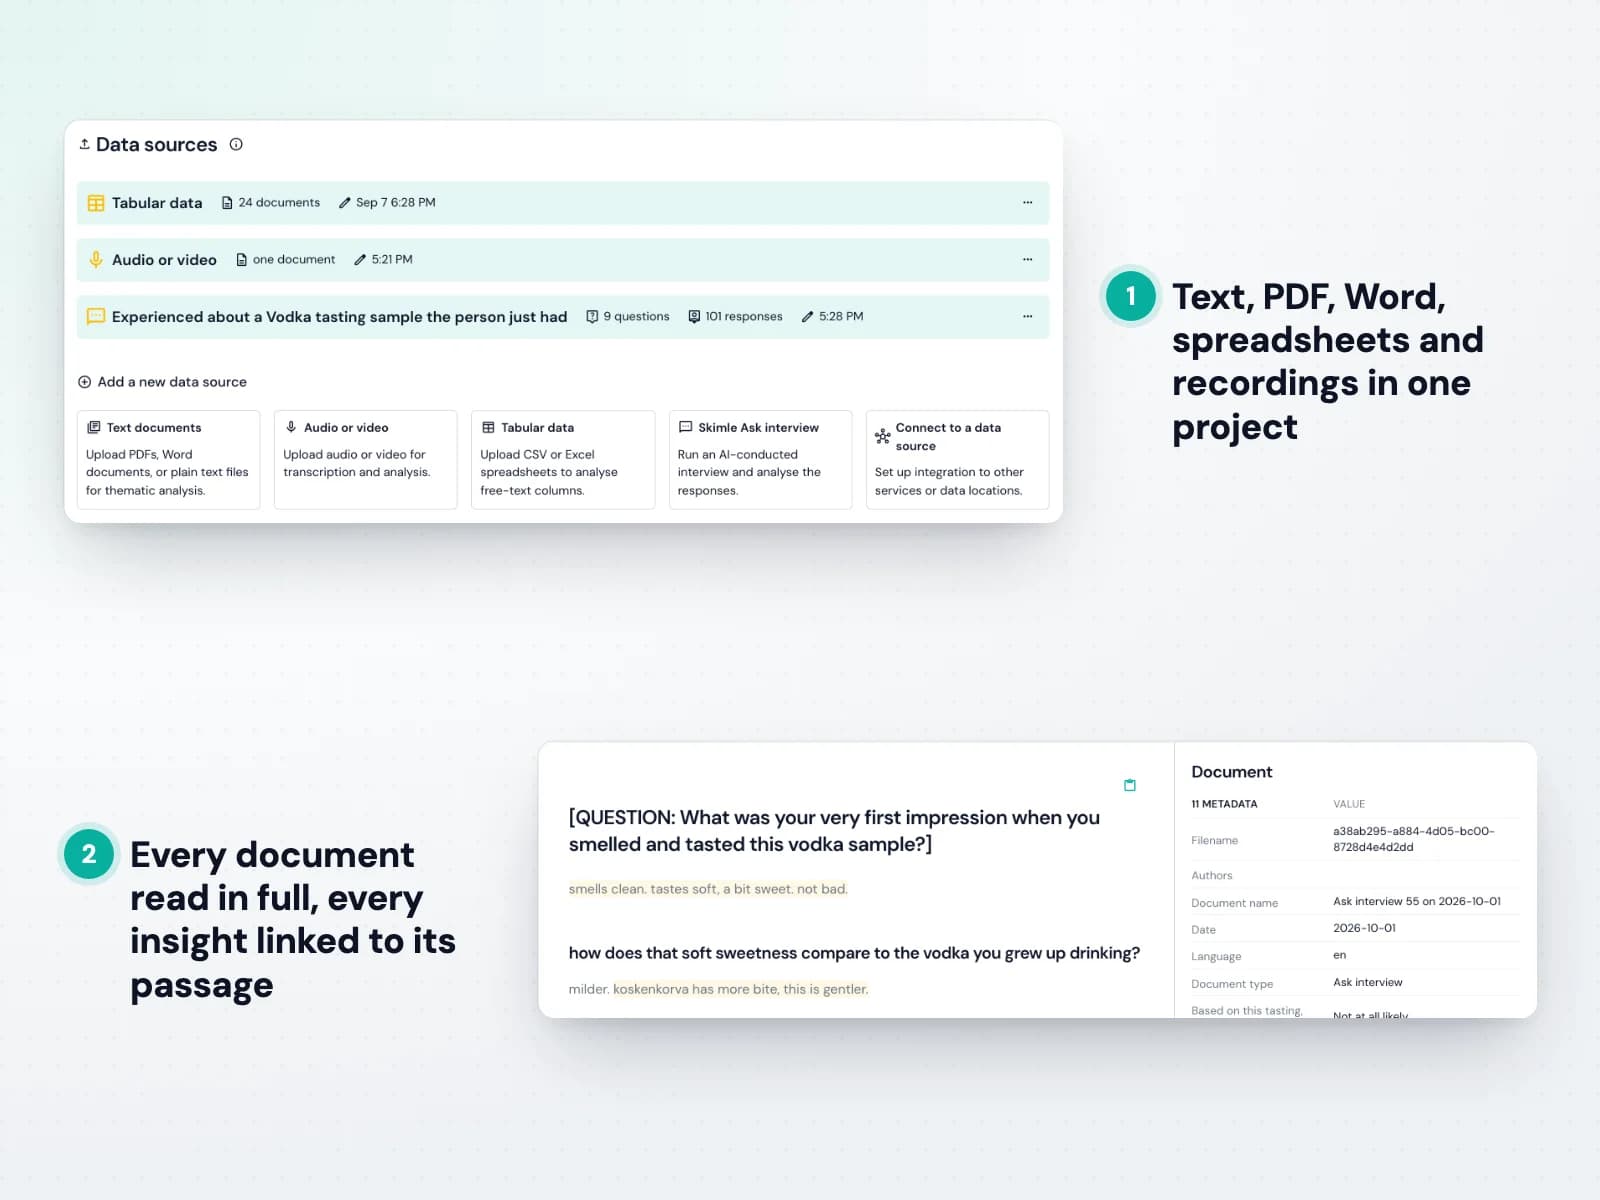
Tooge sisse intervjuude transkriptsioonid, aruanded, artiklid, märkmed ja avatud vastused vormingutes, mida juba kasutate, ning segage ühes projektis vabalt eri keeli. Vaadake toetatud vorminguid.
Skimle loeb iga dokumendi täielikult läbi ja säilitab iga tähelepaneku juures lingi täpse lõiguni, kust see pärineb, nii et midagi ei lähe kaotsi ja kõike saab kontrollida.
- PDF, Word (DOCX), RTF ja TXT
- Enam kui 100 keelt ühes projektis
- Iga tähelepanek on seotud lähtelõiguga
Andmestike import
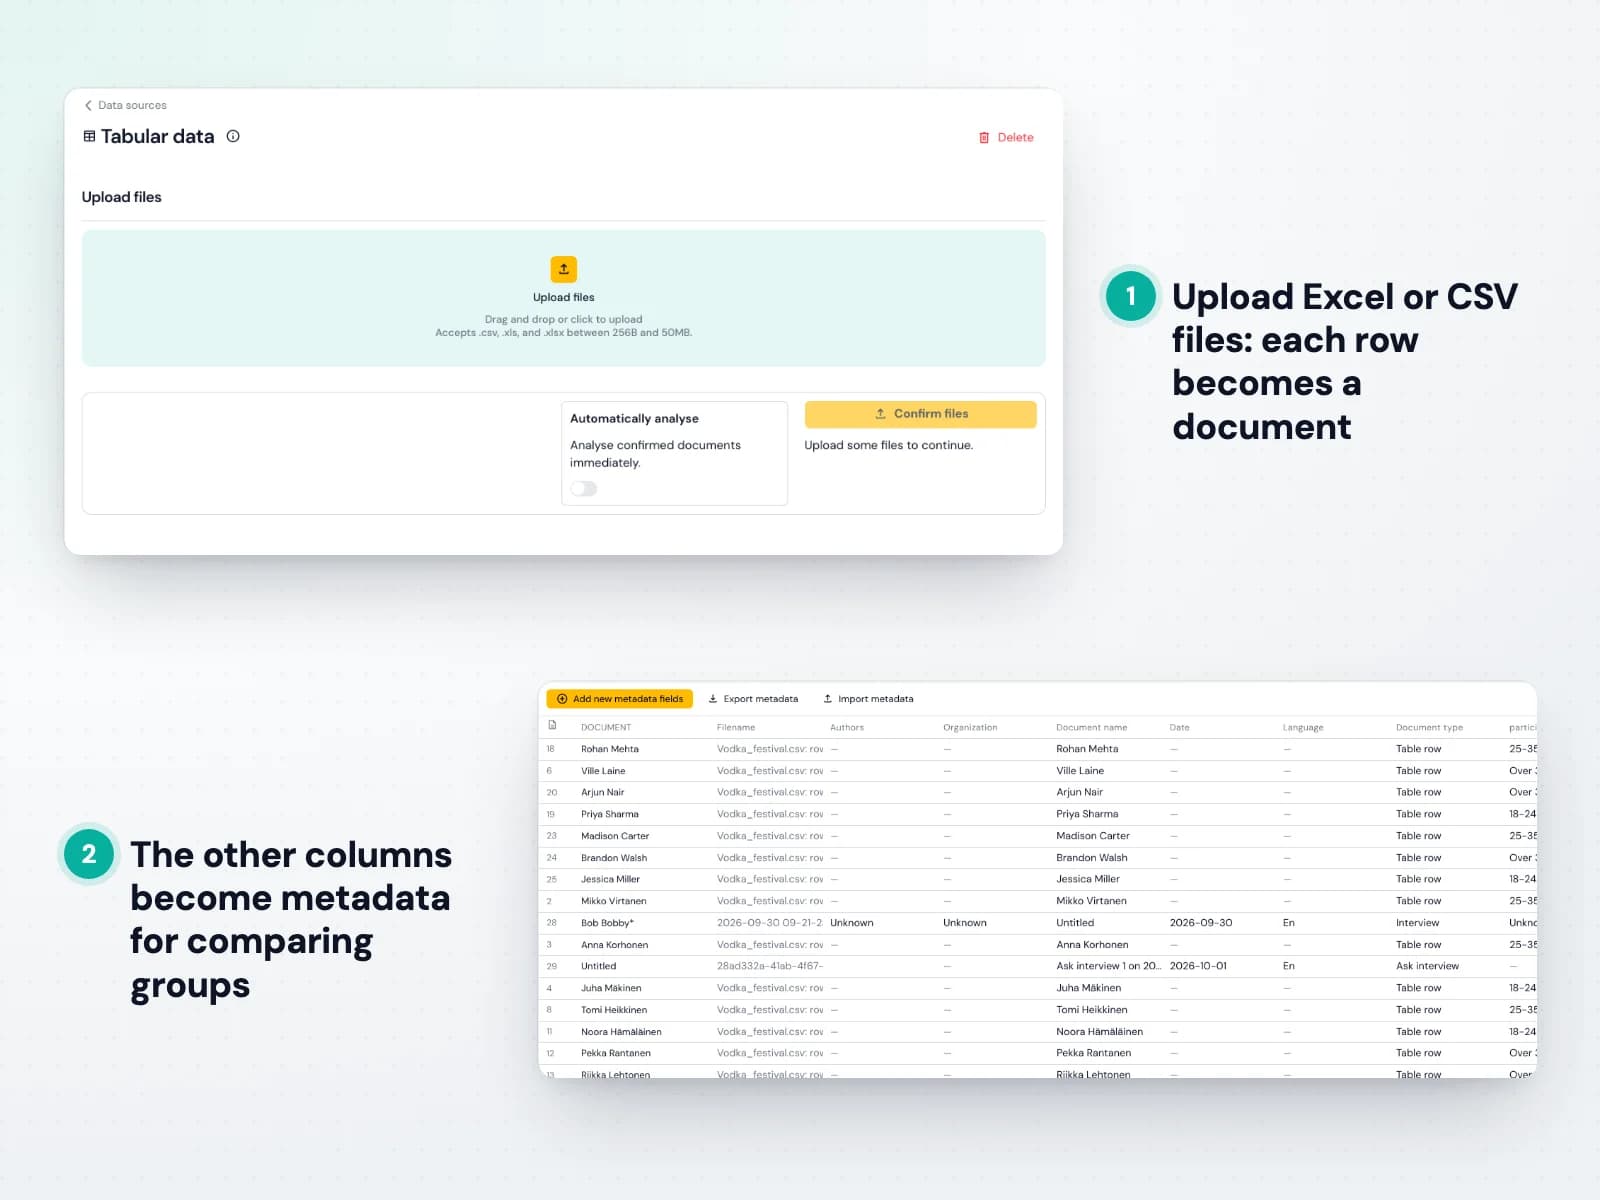
Importige tabelarvutusfailid ja küsitluste ekspordid korraga. Igast reast saab dokument ja iga veeru puhul otsustate, kas see on sisu, metaandmed või jäetakse kõrvale. Vaadake, kuidas importida ja metaandmeid lisada.
Kuna metaandmed liiguvad koos iga vastusega, saate hiljem võrrelda, mida ütlesid eri vastajarühmad, näiteks uued ja lojaalsed kliendid või üks piirkond teisega.
- Exceli ja CSV import
- Valige sisu- ja metaandmeveerud
- Tuhandeid vastuseid projekti kohta
Intervjuud Skimle Askiga
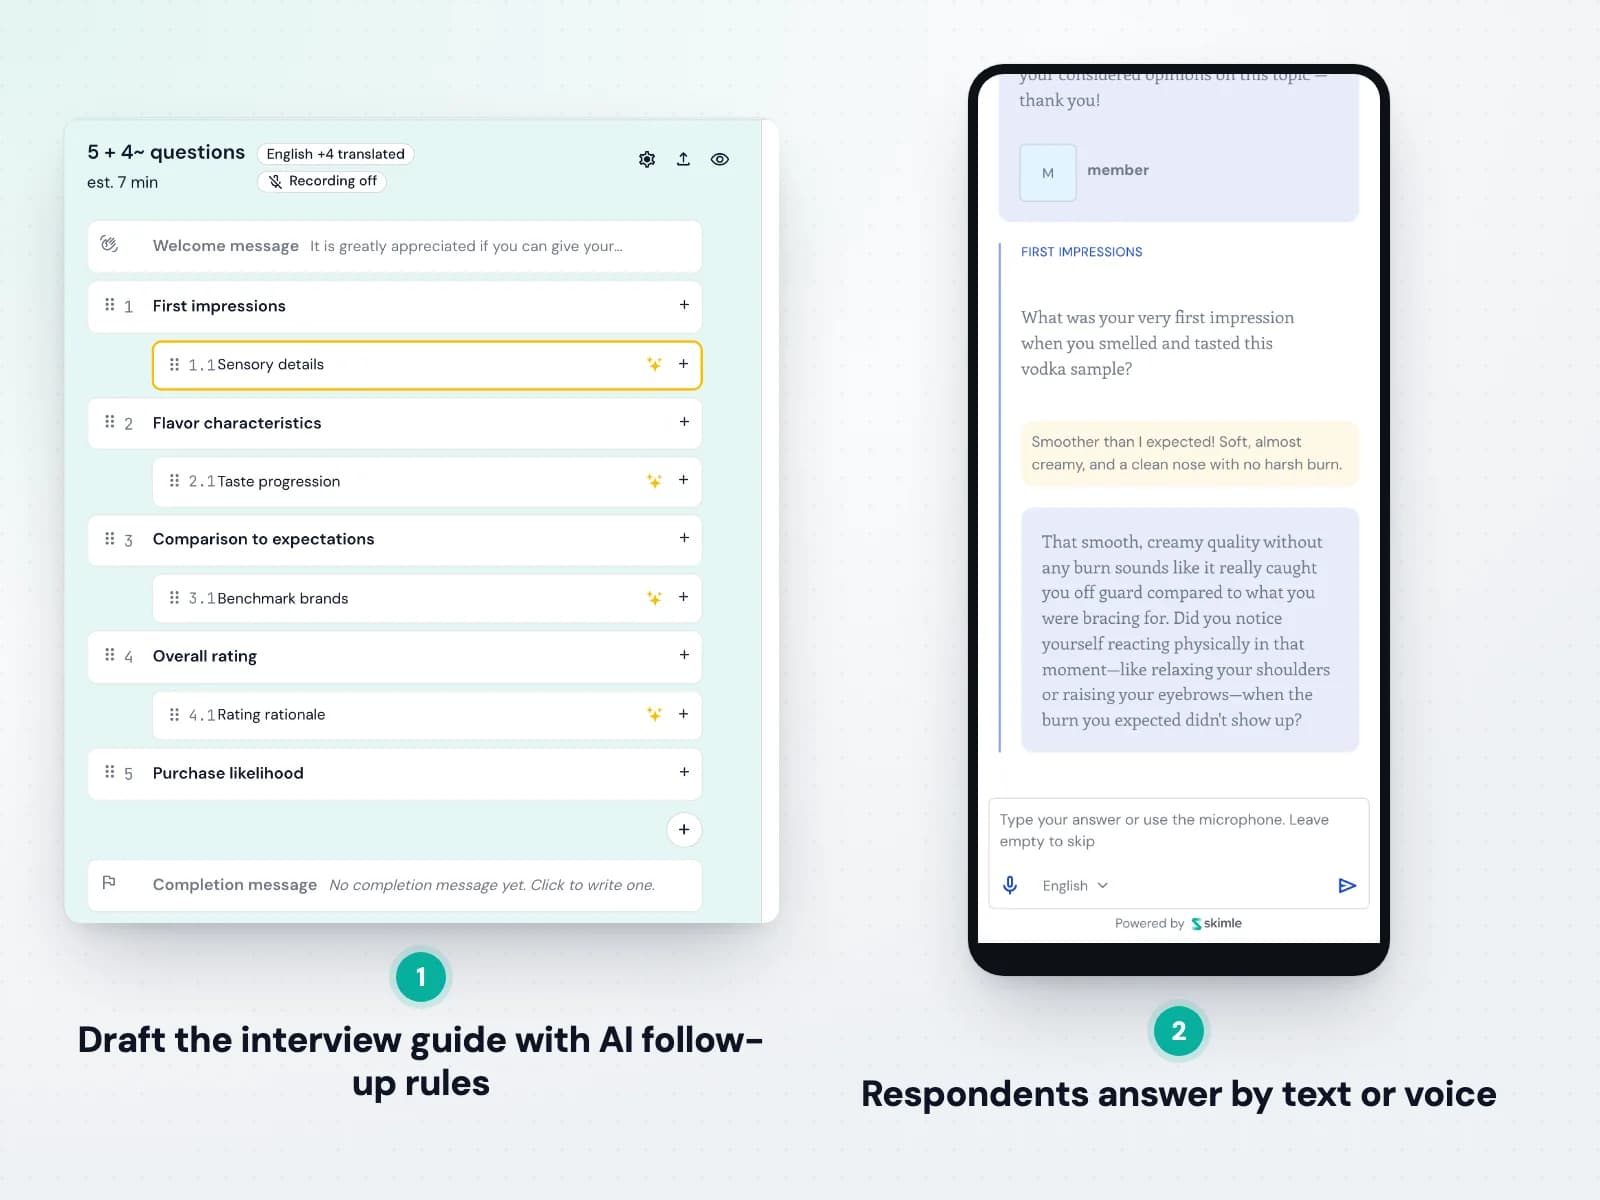
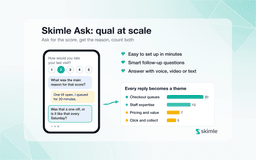
Skimle Ask viib läbi kvalitatiivseid intervjuusid küsitluse mahus. Kirjeldage, mida soovite teada saada, laske tehisintellektil koostada intervjuukava mustand ning täpsustage iga küsimust ja selle täpsustavate küsimuste juhiseid. Vaadake, kuidas Aski intervjuud luua.
Vastajad avavad lingi, vastavad teksti või häälega ning tehisintellektist intervjueerija uurib üksikasju nagu kogenud uurija. Lõpetatud intervjuud liiguvad otse analüüsi koos teie muude andmetega.
- Avatud ja valikvastustega küsimused
- Tehisintellekti täpsustavad küsimused teie määratud sügavusega
- Intervjuud mitmes keeles

Anonüümimine
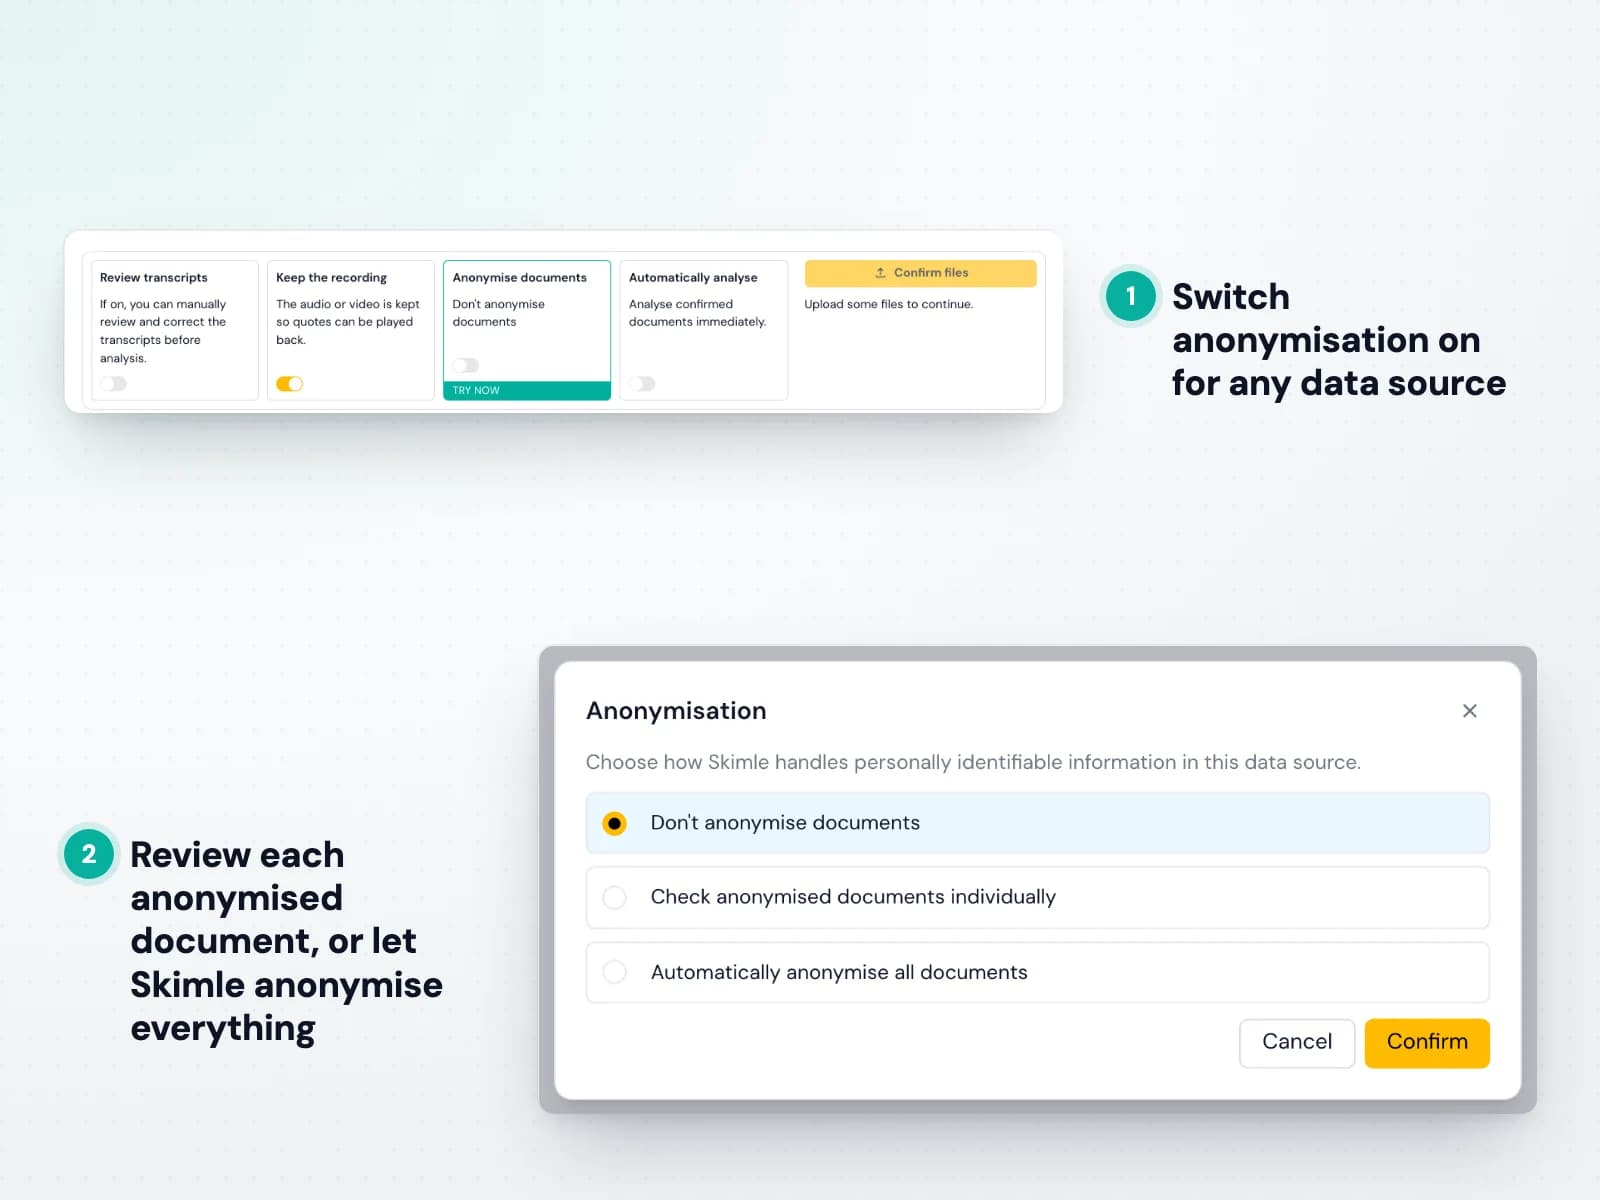
Skimle Anonymise tuvastab isikut tuvastavad andmed kuues kategoorias ja asendab need enne andmete analüüsimist. Lülitage see sisse iga andmeallika jaoks eraldi ja valige, kas soovite iga dokumenti kontrollida või kõik automaatselt anonüümida. Vaadake, kuidas anonüümimine toimib.
Sama inimene saab kõigis teie dokumentides sama pseudonüümi, nii et analüüs jääb terviklikuks, ning vastajad saavad vabalt rääkida, teades, et neid ei saa tuvastada.
- Nimed, ametid, asukohad, organisatsioonid, kuupäevad ja muud tunnused
- Järjepidevad pseudonüümid kõigis dokumentides
- Auditiaruanne ja vastavustabel eetikakomiteedele
Tutvustame Skimle Anonymise'i: kvalitatiivsete andmete põhjalik pseudonüümimine
Anonüümimistööriistad kvalitatiivse uurimistöö jaoks 2026. aastal: De-ID, Textwash, Presidio, MAXQDA ja Skimle võrdluses
Kuidas anonüümida ja pseudonüümida kvalitatiivse uurimistöö andmeid: intervjuude transkriptsioonide IRB-nõuetele vastav isikustamisest vabastamine
2. samm
Analüüsige ja uurige oma andmeid
Põhjalik analüüsimootor täieliku läbipaistvuse ja kontrolliga, segameetodite vaated, metaandmete võrdlused ja tehisintellekti uurimisassistent.
Põhjalik analüüs keskmes
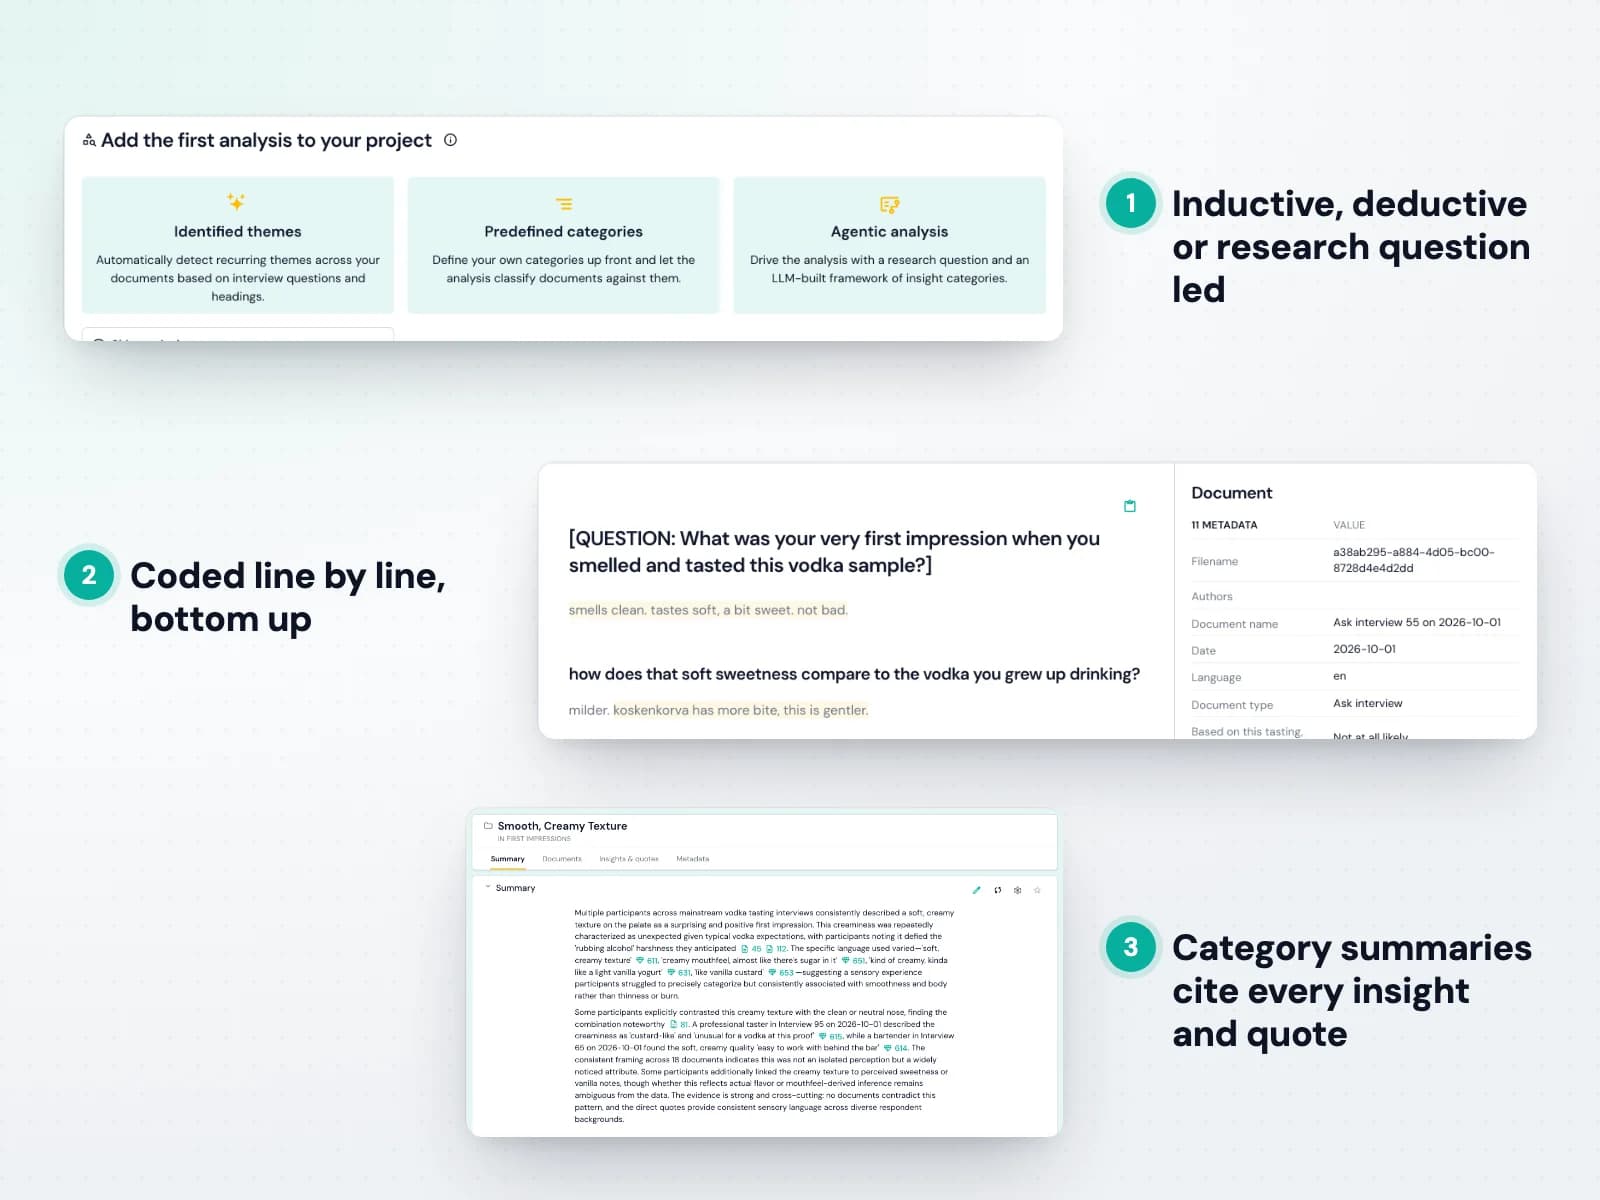
Skimle järgib tunnustatud kvalitatiivseid meetodeid, mitte ei tee lihtsalt kokkuvõtet. See loeb iga dokumendi täielikult läbi, tuvastab tähelepanekud alt üles ja korrastab need kategooriatesse, millest igaüks on seotud lähtetsitaadiga. Vaadake, kuidas analüüs toimib.
Valige tuvastatud teemad, et struktuur tekiks andmetest, eelmääratud kategooriad, et kodeerida oma kategooriasüsteemi järgi, või agentne analüüs, mida juhib teie uurimisküsimus. Kategooriate kokkuvõtted viitavad seejärel igale tähelepanekule ja tsitaadile, millele need tuginevad.
- Induktiivne, deduktiivne ja uurimisküsimusest lähtuv analüüs
- Iga tähelepanek on seotud sõnasõnalise tsitaadiga
- Kokkuvõtted, mis viitavad oma tõenditele
Täielik kontroll ja läbipaistvus
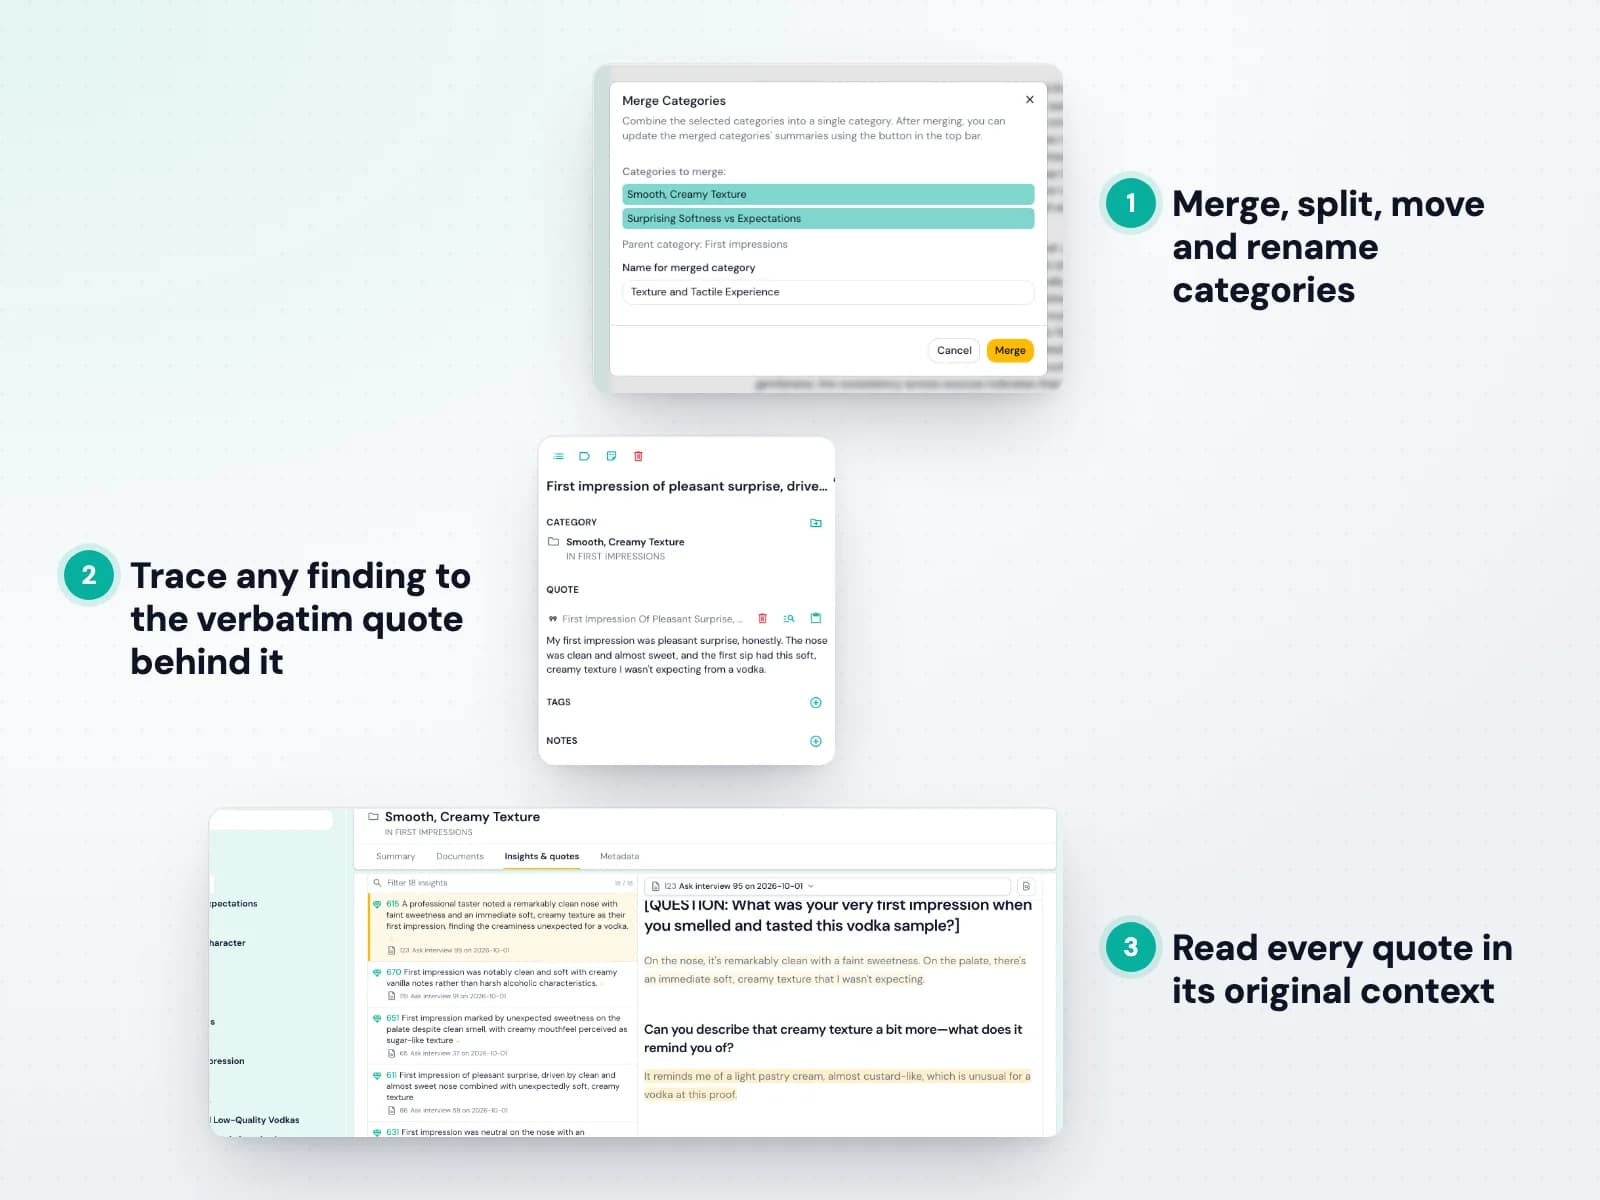
Skimle kahesuunaline läbipaistvus tähendab, et saate selle tööd alati kontrollida. Klõpsake kokkuvõttes mis tahes viitel, et näha selle taga olevat tähelepanekut ja sõnasõnalist tsitaati, ning avage dokument, et näha täpselt, mis on kodeeritud ja mis mitte. Vaadake, kuidas kategooriaid hallata.
Kui struktuur ei vasta teie mõttekäigule, muutke seda: ühendage kattuvad kategooriad, jagage liiga laiad osadeks, nimetage need oma sõnadega ümber ja tõstke tähelepanekuid nende vahel. Iga muudatuse saab tagasi võtta.
- Kategooriate ühendamine, jagamine, teisaldamine ja ümbernimetamine
- Tulemuste jälgimine allikani ja allikate jälgimine tulemusteni
- Iga muudatuse tagasivõtmine
Segameetodid ja andmete visualiseerimine
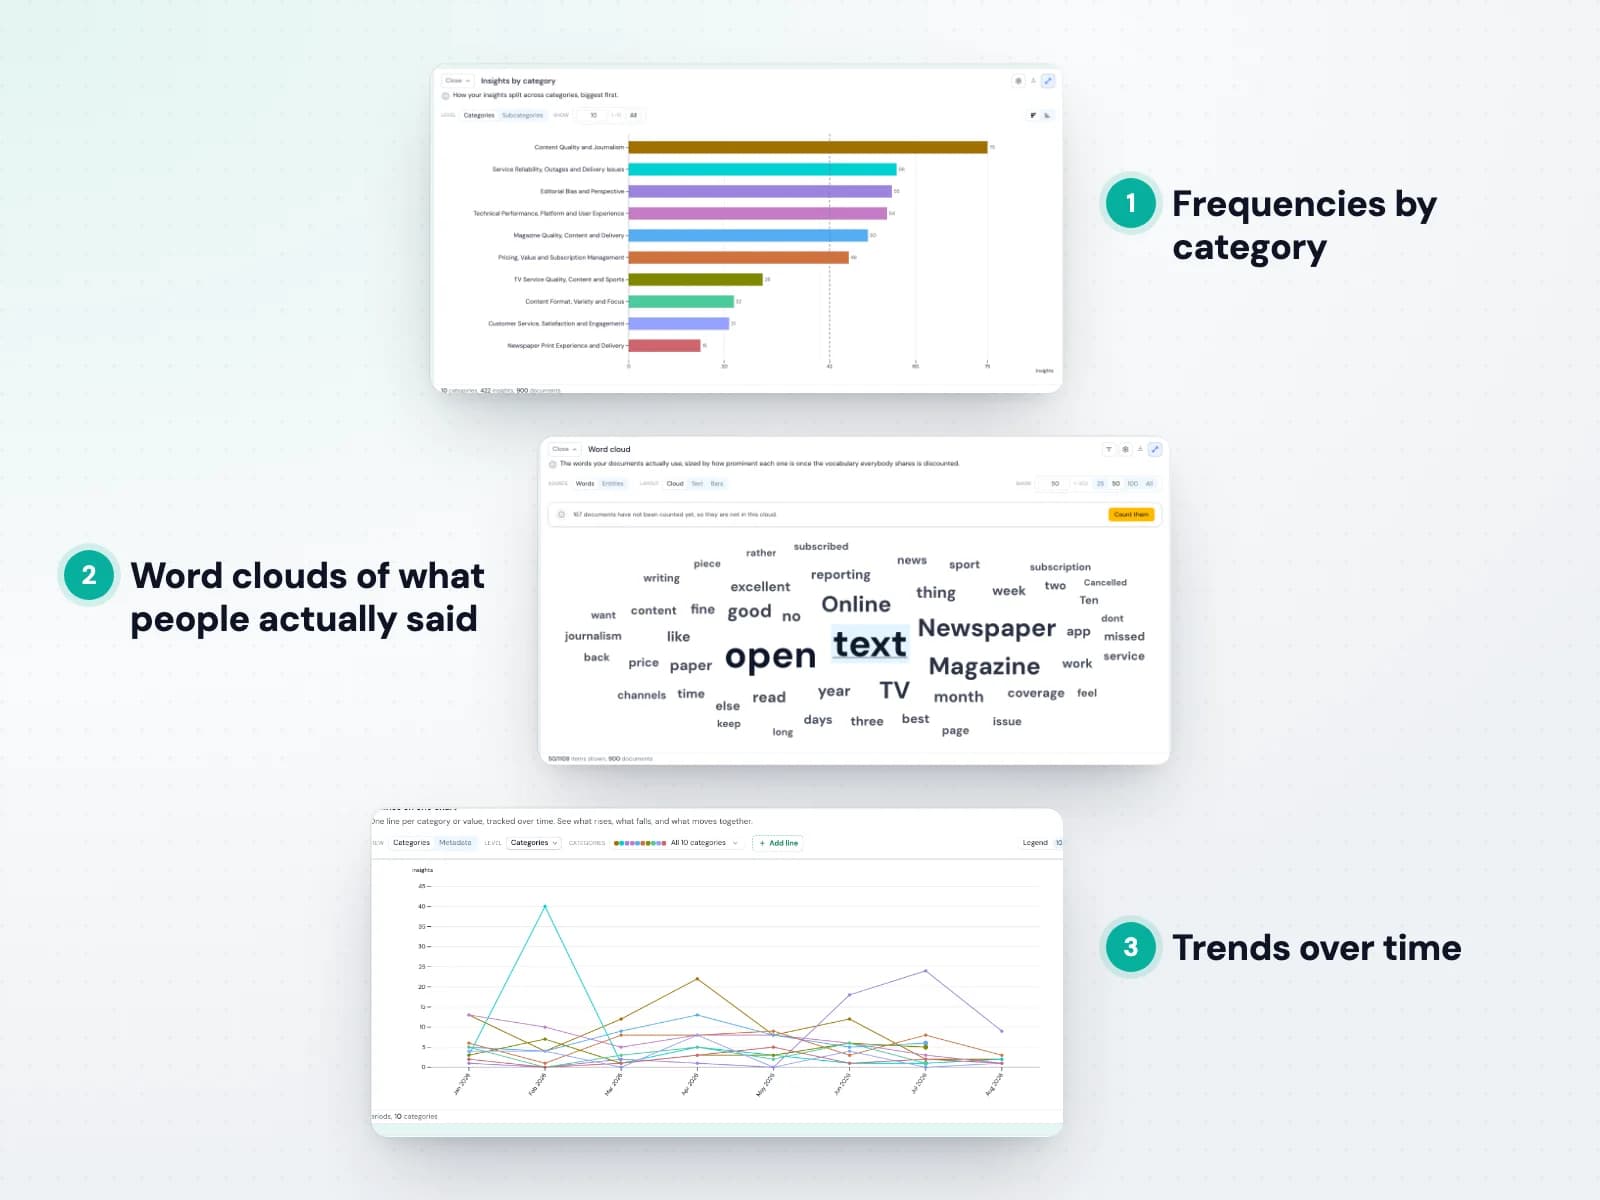
Teie kodeeritud andmetest saavad numbrid, mida võite usaldada, sest iga loendus tugineb kontrollitud tähelepanekutele. Uurige sagedusi kategooriate kaupa, sõnapilvi, dokumentideüleseid soojuskaarte ja suundumusi ajas. Vaadake statistikavaadet.
Vaated uuenevad struktuuri täpsustamise käigus ning iga tulp või punkt viib tagasi selle taga olevate tähelepanekute ja tsitaatideni, nii et numbrid ja lood on alati kooskõlas.
- Sagedused, sõnapilved ja soojuskaardid
- Suundumused ajas
- Iga number on jälgitav tsitaatideni
Mustrite avastamine metaandmetega

Võrrelge mis tahes kaht dokumendirühma nende metaandmete põhjal ja Skimle näitab, milliseid kategooriaid kumbki rühm teisest sagedamini tõstatab. Seejärel kirjutab see viidetega, mis rühmi eristab ja mis neid ühendab. Vaadake, kuidas metaandmeid analüüsida.
Pole kindel, milline jaotus on oluline? Skimle järjestab iga metaandmete jaotuse selle järgi, kui palju see rühmi teineteisest eristab, nii et leiate aruandmist väärivad erinevused, ilma et peaksite neid ükshaaval testima.
- Rühmavõrdlused koos kirjalike kokkuvõtetega
- Iga jaotus on järjestatud efekti suuruse järgi
- Metaandmed teie andmetest või tehisintellekti tuletatud
Agentne vestlus teie uurimisassistendina
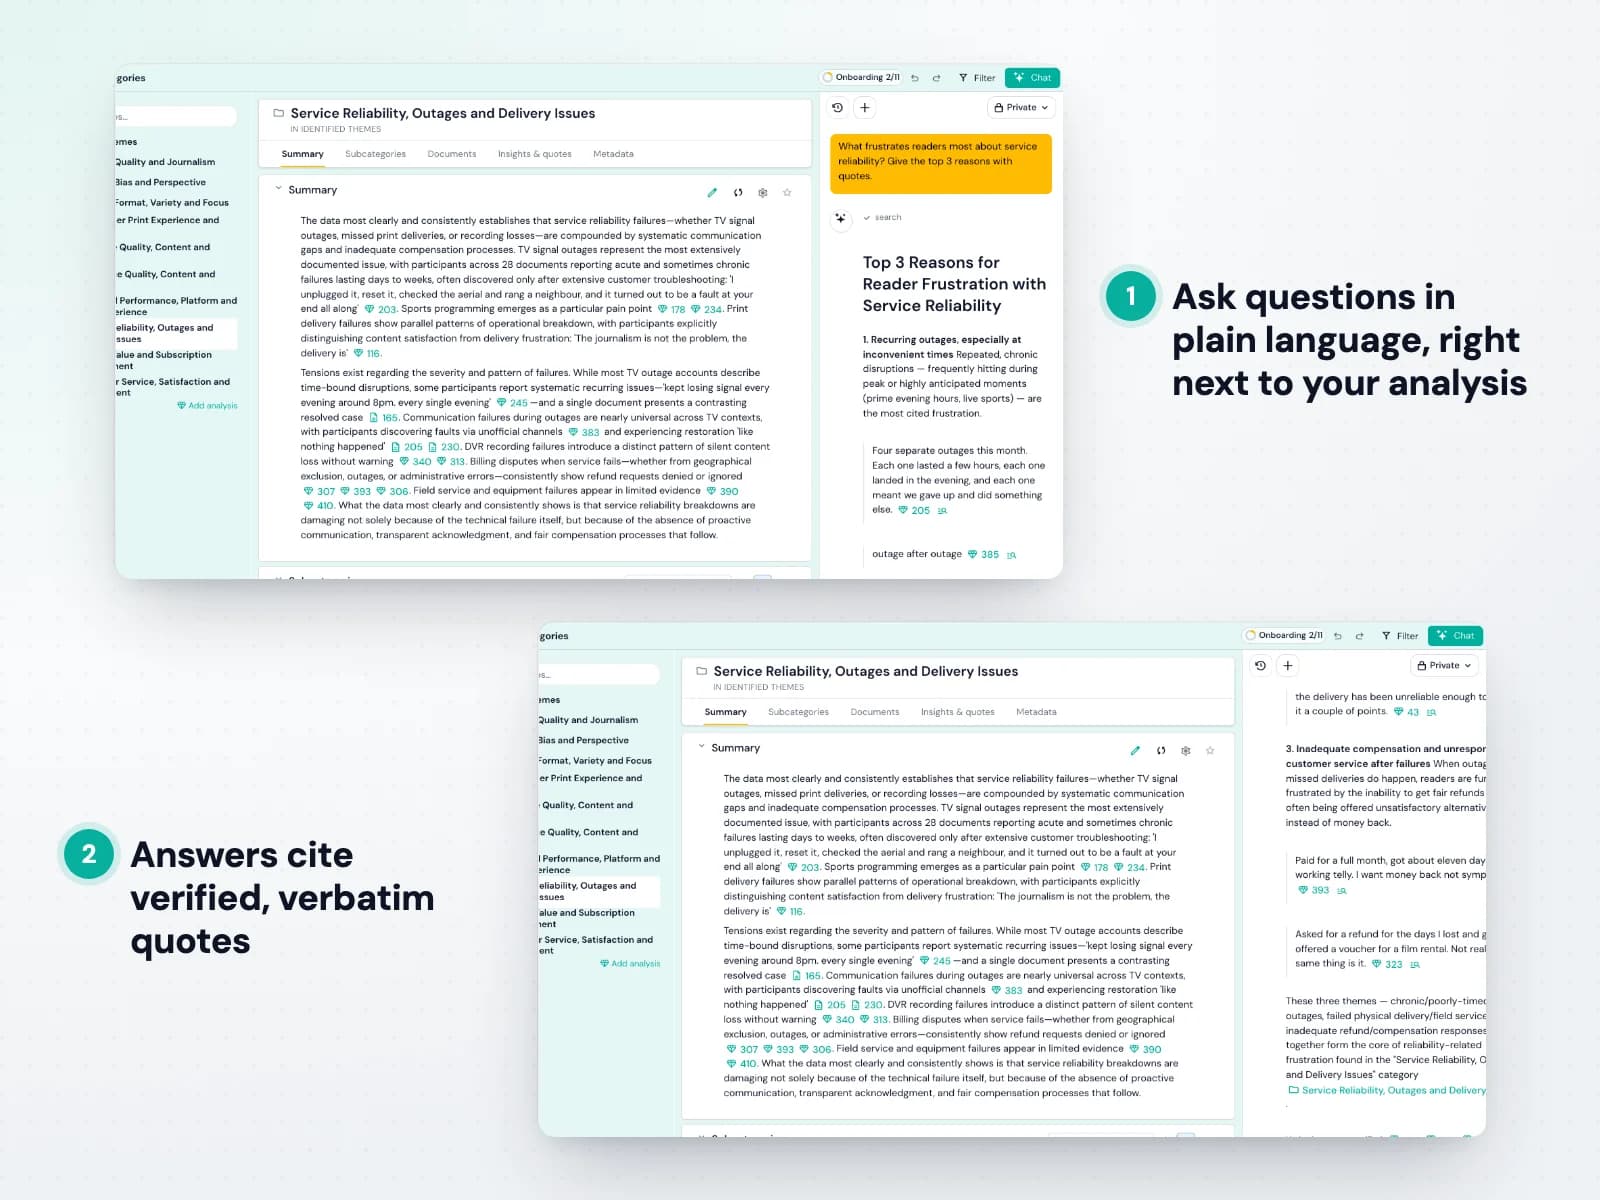
Uurimisassistent töötab teie struktureeritud analüüsi, mitte toorete dokumentide peal. Esitage küsimusi lihtsas keeles ja see otsib teie kodeeritud tähelepanekute hulgast, arutleb sammude kaupa, mida saate jälgida, ning vastab kontrollitud sõnasõnaliste tsitaatidega. Vaadake, kuidas tehisintellekti vestlust kasutada.
See saab analüüsis ka toiminguid teha: luua tähelepanekuid, korrastada kategooriaid ja lisada märkmeid, kõike samade käskudega, mida kasutate ise, nii et iga muudatus jääb nähtavaks ja tagasivõetavaks.
- Vastused tuginevad kontrollitud tsitaatidele
- Otsib kõigi kodeeritud tähelepanekute hulgast
- Saab analüüsi ümber korraldada ja märkmetega täiendada
3. samm
Eksportige ja integreerige
Jagage tulemusi esitluste ja aruannetena, eksportige neid kasutatavatesse tööriistadesse ning ühendage oma süsteemid ja tehisintellekti agendid.
Veenvad esitlused
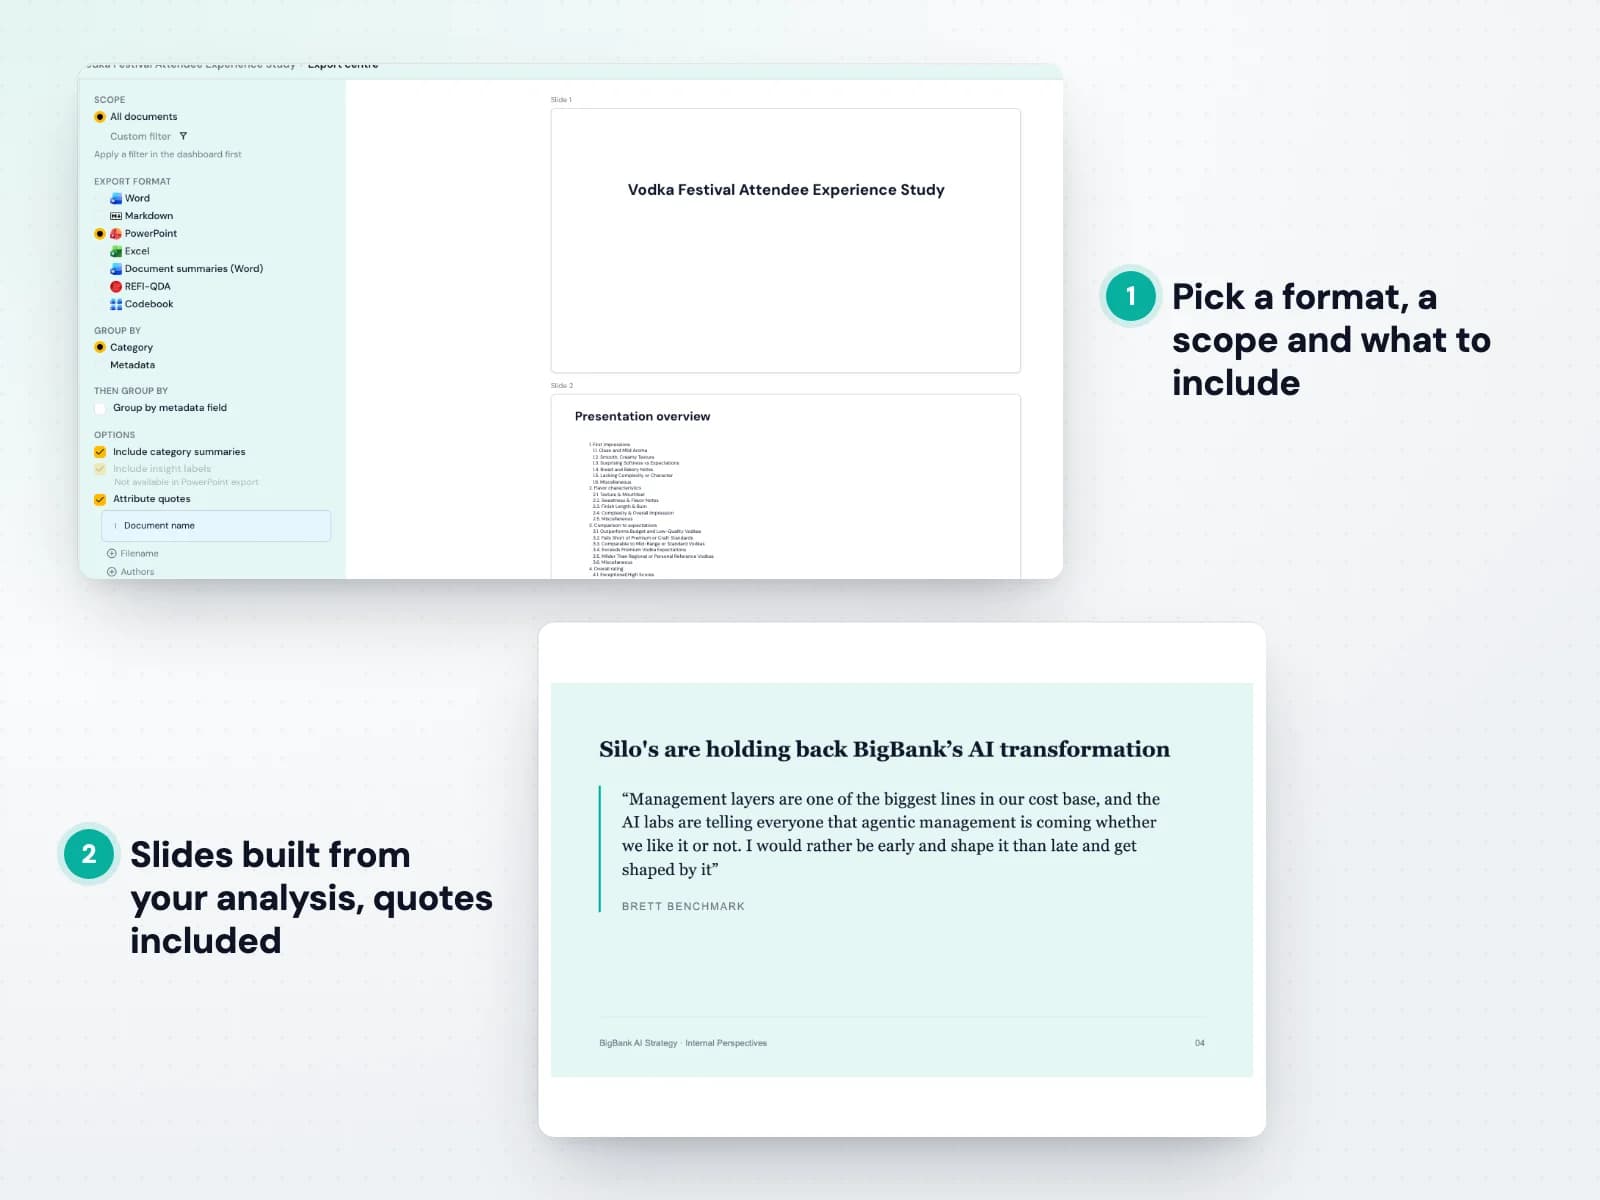
Eksportige oma analüüs PowerPointi esitluse või Wordi aruandena. Valige ulatus, rühmitage tulemused kategooriate või metaandmete järgi ning otsustage, kas lisada kokkuvõtted, viited ja autoriga tsitaadid. Vaadake, kuidas Office'isse eksportida.
Tulemus on valmis lähtepunkt teie aruandele või esitlusele: teemad, tõendid ja tsitaadid on juba paigas ning igaüks neist on jälgitav tagasi analüüsini.
- PowerPointi esitlused ja Wordi aruanded
- Kokkuvõtted, viited ja autoriga tsitaadid
- Teie valitud ulatus ja rühmitus
API- ja MCP-ühendused
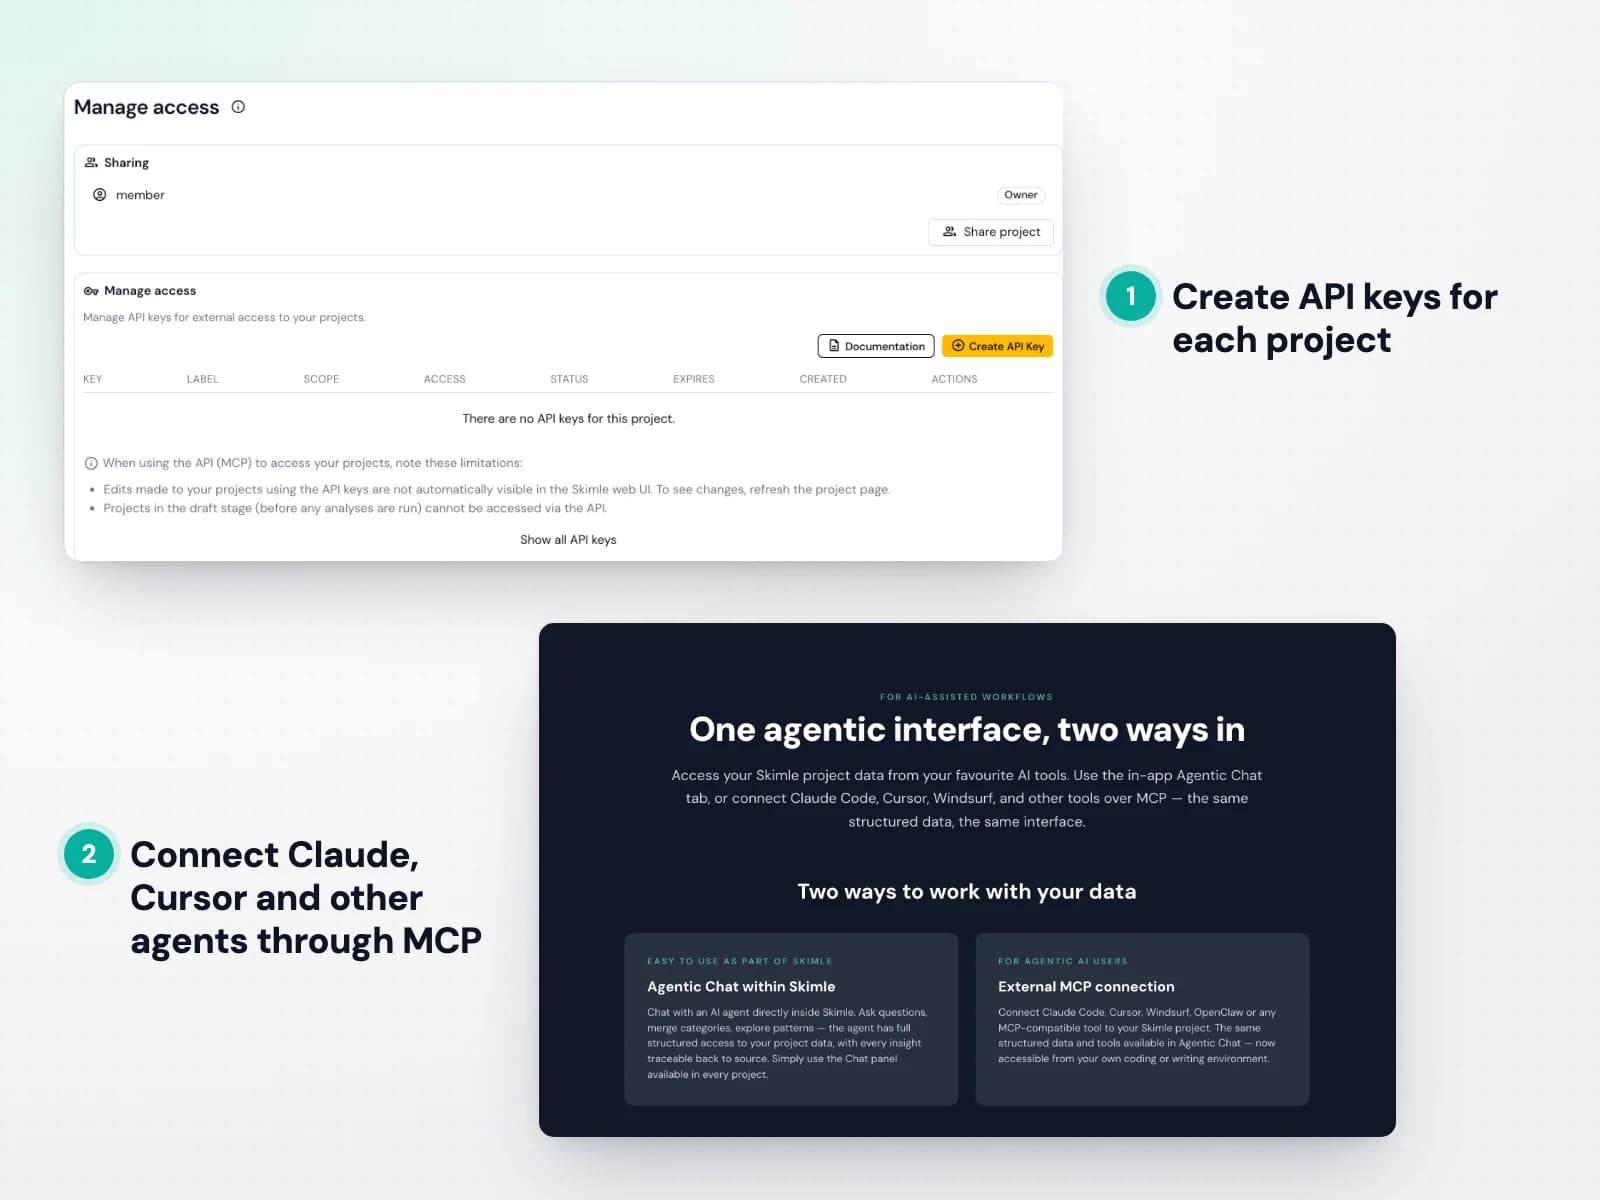
Skimle MCP-server võimaldab Claude'il, Cursoril, Windsurfil ja teistel ühilduvatel agentidel töötada teie struktureeritud projektiandmetega samade tööriistadega, mida kasutab rakendusesisene agent. Lugege lähemalt MCP kaudu ühendamisest.
REST API võimaldab teie enda süsteemidel projektiandmeid lugeda ja kirjutada või projekti algusest lõpuni läbi viia. Looge API-võtmed iga projekti jaoks eraldi, lugemis- või muutmisõigusega, projekti juurdepääsuseadetes.
- MCP Claude'i, Cursori ja teiste agentide jaoks
- REST API projektiandmete lugemiseks ja kirjutamiseks
- API-võtmed projekti kohta
Andmete eksport
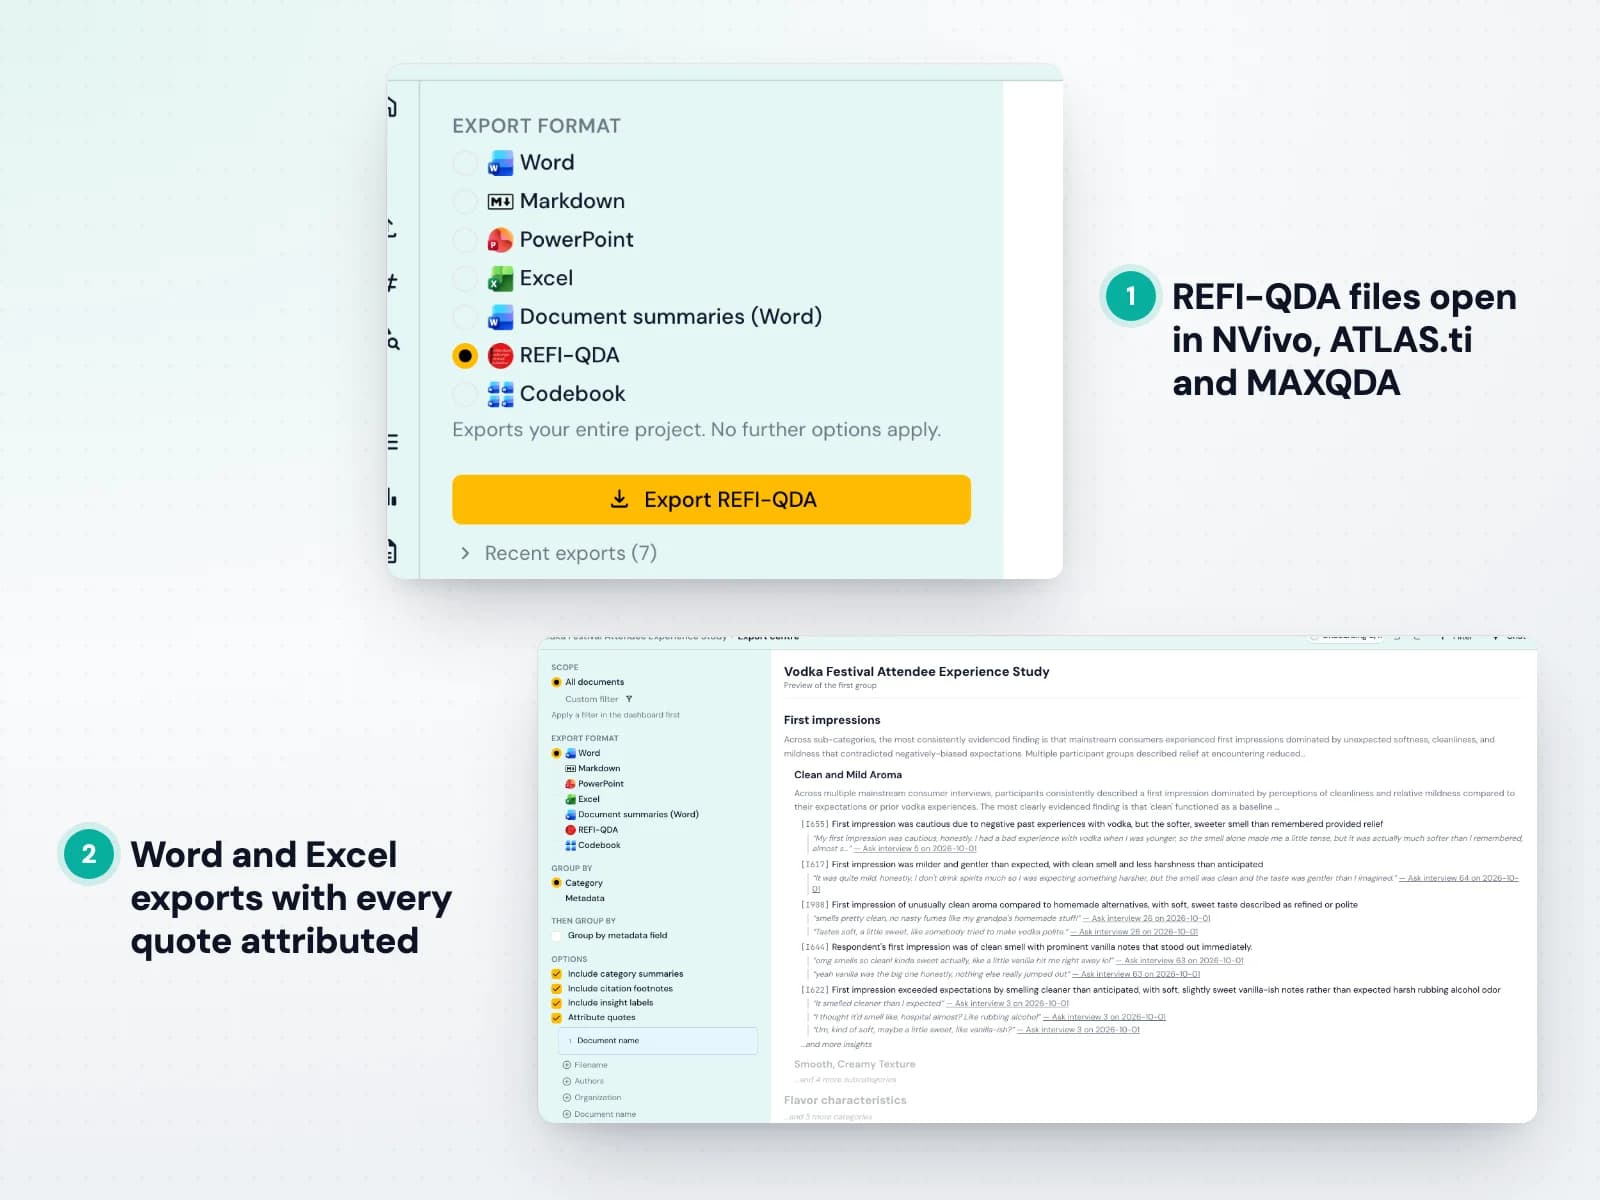
Viige oma analüüs sinna, kus seda vajate: Excelisse kogu Skimle tabeliga, Wordi kodeeringuga kommentaaridena ja avatud REFI-QDA vormingusse NVivo, ATLAS.ti ja MAXQDA jaoks. Vaadake, kuidas REFI-QDA vormingusse eksportida.
Eksportige kategooriasüsteem, hoidke kogu analüüsi koopiat koos oma uurimisandmetega või jätkake käsitsi kodeerimist traditsioonilises tööriistas.
- Excel, Word ja REFI-QDA (.qdpx)
- Kategooriasüsteemi eksport
- Töötab NVivo, ATLAS.ti ja MAXQDA-ga
Platvorm
Turvaline platvorm koostööks
Suurettevõtte tasemel andmekaitse ja teie meeskond, kes töötab koos ühe ühise analüüsi kallal.
Turvaline platvorm
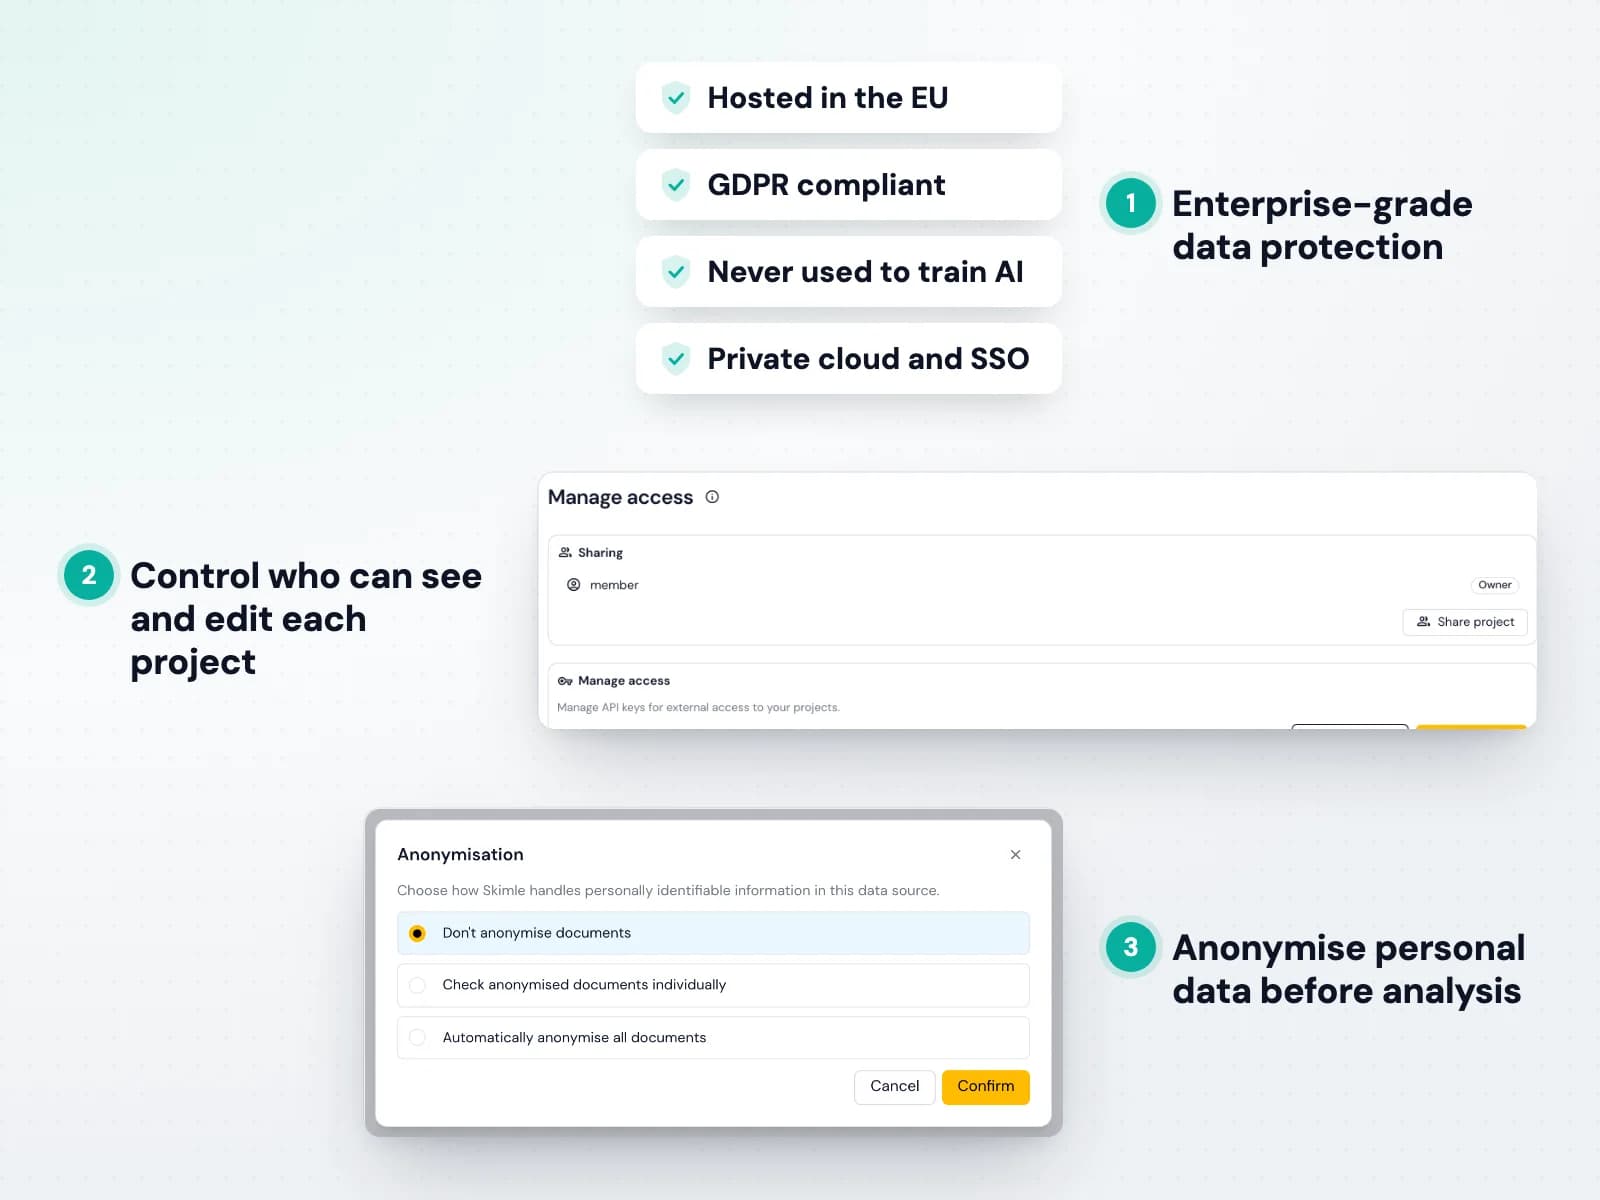
Skimle on loodud tundlike uuringute jaoks. Kõiki andmeid majutatakse ELis, krüpteeritakse edastamisel ja salvestamisel ning neid ei kasutata kunagi tehisintellekti mudelite treenimiseks. Lugege meie privaatsuspoliitikat.
Teie otsustate, kes saab iga projekti vaadata ja muuta, isikuandmed saab enne analüüsi anonüümida ja andmetöötlusleping on saadaval. Suurkliendid saavad valida privaatpilve ja ühekordse sisselogimise.
- Majutus ELis ja vastavus GDPR-ile
- Ei kasutata kunagi tehisintellekti mudelite treenimiseks
- Privaatpilv ja SSO suurettevõtetele
Kuidas kasutada tehisintellekti vastutustundlikult kvalitatiivsetes turu-uuringutes: 7 reeglit tähelepanekuid koguvatele meeskondadele
Kuidas anonüümida intervjuude transkriptsioone tundlike äriintervjuude puhul
9 disainikriteeriumi tehisintellekti toel töötavatele kvalitatiivse analüüsi tööriistadele
Koostöö
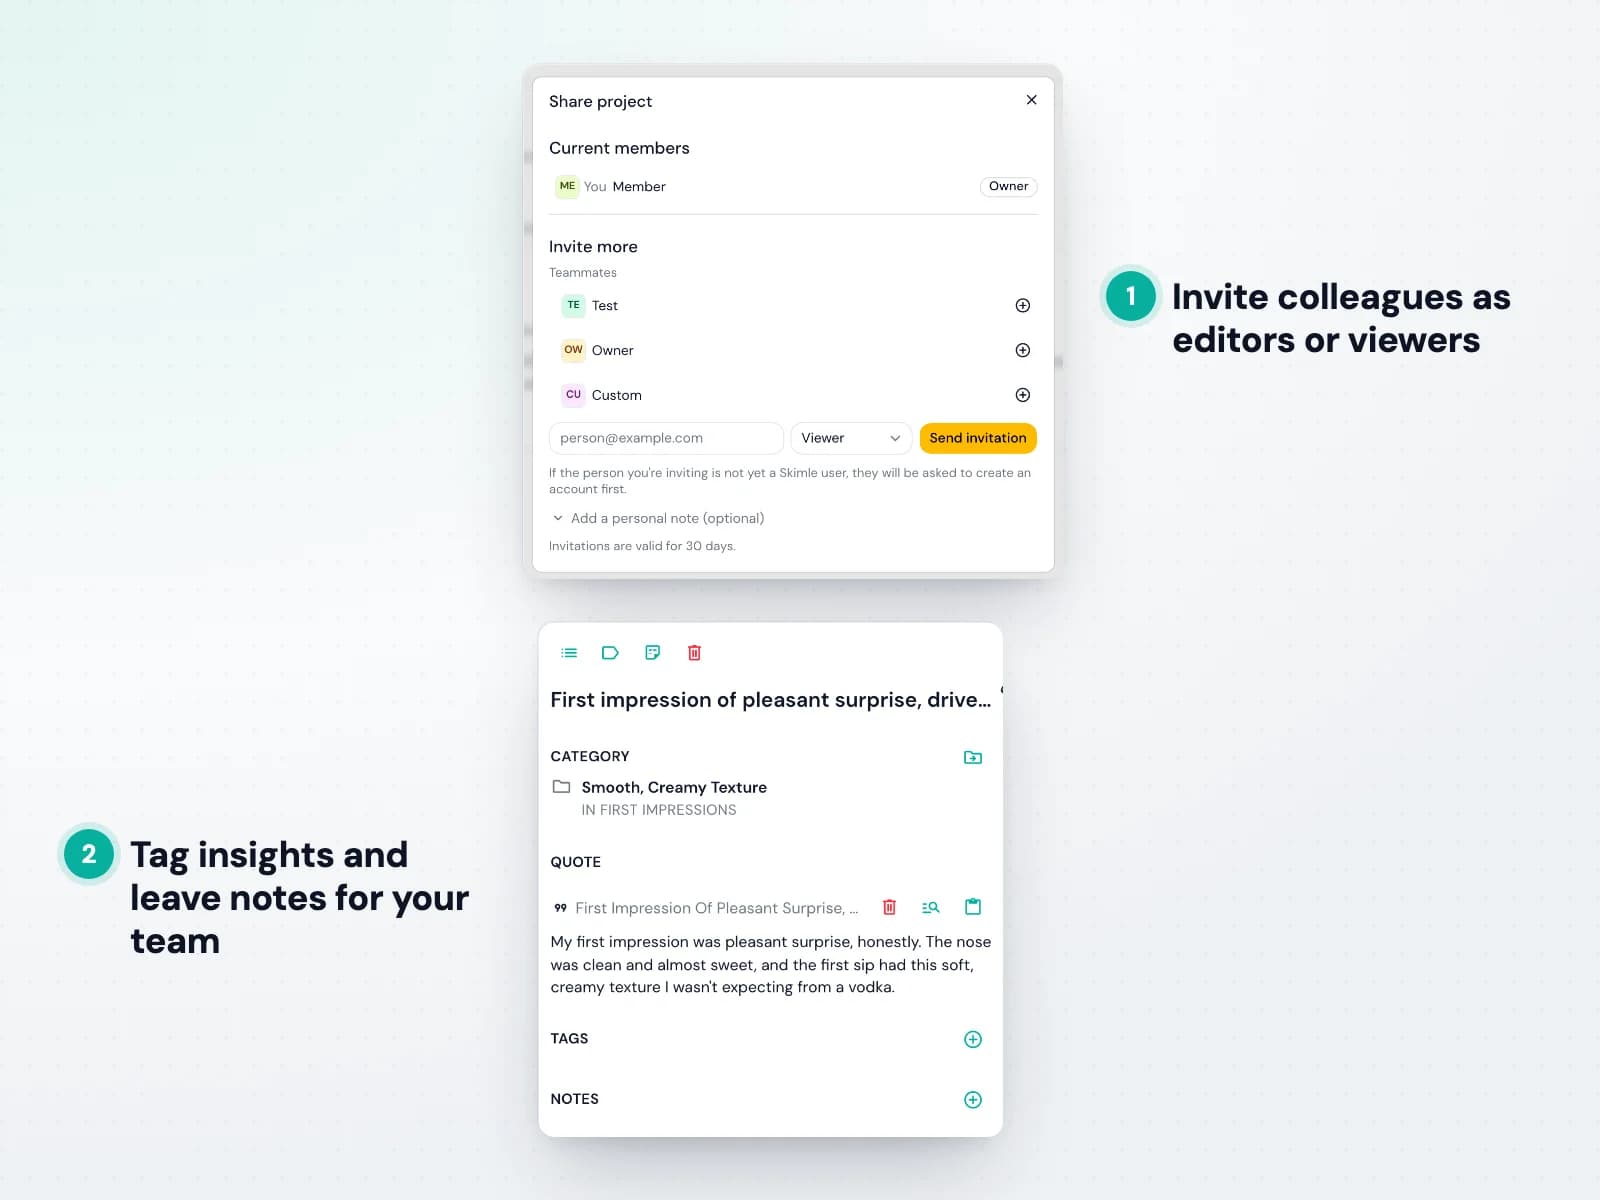
Skimle projekt on jagatud töökeskkond. Kutsuge kolleege toimetajateks, kes saavad üles laadida ja muuta, või vaatajateks, kes saavad kõike uurida ilma midagi muutmata. Vaadake, kuidas jagamine toimib.
Kodeerimisotsused, sildid ja märkmed on ühes kohas, nii et uurimisrühm, klient või juhendaja vaatab alati sama ja ajakohast analüüsi.
- Toimetaja ja vaataja rollid
- Sildid ja märkmed tähelepanekutel
- Üks jagatud, ajakohane analüüs
Kuidas Skimle teistega võrreldes välja paistab
Käsitsi töötavad tööriistad on põhjalikud, kuid aeglased, üldine tehisintellekt on kiire, kuid seda ei saa kontrollida, ja valdkonnapõhised tööriistad on loodud üheks ülesandeks kõrge hinnaga. Ainult Skimle ühendab põhjaliku analüüsimootori, täieliku läbipaistvuse ja mitmekülgsuse, alates 20 eurost kasutaja kohta kuus.
| Käsitsi töötavad tööriistad NVivo, MAXQDA, ATLAS.ti… | Üldised tehisintellekti tööriistad ChatGPT, Claude… | Valdkonnapõhised tööriistad CoLoop, Listen Labs… | Skimle | |
|---|---|---|---|---|
| Põhjalik analüüsimootor |  | | | |
| Kahesuunaline läbipaistvus kokkuvõttest allikani | | | | |
| Mitmekülgne eri andmetüüpide ja kasutusjuhtude puhul | | | | |
| Kiire | | | | |
| Lihtne õppida | | | | |
| Hind | ~80 € kasutaja kohta kuus | ~20 € kasutaja kohta kuus | 400+ € kuus | Alates 20 € kuus, tasuta prooviperiood |
| Maht | Piiratud käsitsi kodeerimise töömahuga | Piiratud kontekst, katvust ei saa kontrollida | Sõltub tööriistast | Tuhandeid dokumente projekti kohta |
| GDPR ja andmeturve | Sõltub paigaldusest | Sõltub paketist ja seadetest | Sõltub teenusepakkujast | Sisseehitatud · serverid ELis · andmetöötlusleping saadaval |
| Hinnang | Publikatsioonitasemel põhjalikkus, kuid iga projekti puhul nädalaid käsitsi kodeerimist. | Kiire, kuid vastused sõltuvad päringust ning neid ei saa jälgida ega kaitsta. | Loodud ühe töövoo jaoks, sageli suurettevõtete hindadega. | Akadeemilise tasemega põhjalikkus tehisintellekti kiirusega, täiesti läbipaistev, mis tahes kvalitatiivsete andmete jaoks. |
KKK
Korduma kippuvad küsimused
- Mis on Skimle?
- Skimle on tehisintellektil põhinev kvalitatiivsete andmete analüüsi platvorm, mis struktureerib süsteemselt struktureerimata dokumendid (intervjuud, aruanded, konsultatsioonid, kliendite tagasiside) korrastatud ja analüüsitavateks andmestikeks täieliku jälgitavusega. Erinevalt vestlusrobotitest töötleb Skimle kogu teie dokumendikogu eelnevalt, eraldab sellest tähelepanekud ja korrastab need hierarhilisteks teemadeks, kus iga leid on seotud kontrollitud sõnasõnalise tsitaadiga.
- Mille poolest erineb Skimle ChatGPT-st või RAG-põhistest tööriistadest?
- RAG-tööriistad otsivad asjakohased lõigud üles päringu ajal, nii et sama küsimuse korral saate iga kord erineva vastuse. Skimle analüüsib kogu teie andmestiku eelnevalt ja süsteemselt ning loob stabiilse struktuuri, kus iga teema on seotud kontrollitud tsitaatidega. Musta kasti vastuste asemel saate täieliku katvuse, järjepidevad tulemused ja täieliku jälgitavuse.
- Mille poolest erineb Skimle NVivost, MAXQDA-st või ATLAS.ti-st?
- Traditsioonilised tööriistad nõuavad iga lõigu käsitsi kodeerimist: see on süsteemne, kuid aeganõudev ja võtab nädalaid kuni kuid. Skimle automatiseerib kodeerimise tehisintellektiga, säilitades sama süsteemse ja läbipaistva metoodika. Saate NVivo tasemel põhjalikkuse murdosa ajaga ning intuitiivsema pilvepõhise kasutajaliidese, mis ei nõua nädalatepikkust koolitust.
- Kas saan kasutada Skimlet akadeemilises uurimistöös?
- Jah. Skimle on loodud akadeemikute poolt ja inspireeritud tunnustatud metoodikatest: temaatiline analüüs (Braun & Clarke), põhistatud teooria (Glaser & Strauss; Strauss & Corbin) ja Gioia meetod (Gioia, Corley & Hamilton). Skimle täielik auditijälg võimaldab täpselt dokumenteerida, kuidas teemad tuletati, mis vastab eelretsenseerimise nõuetele. Skimlet kasutavad praegu teadlased enam kui 30 ülikoolist ja soovi korral pakume viitamiseks soovituslikku sõnastust.
- Milliseid keeli ja failivorminguid Skimle toetab?
- Skimle toetab enam kui 100 keelt ning võtab vastu PDF-, Wordi (.docx), RTF-, TXT- ja CSV-faile, heli (MP3, M4A, WAV) ja videot (MP4, MOV). Ühes projektis saate kombineerida eri vorminguid ja keeli: laadige koos üles ingliskeelsed intervjuud, saksakeelsed aruanded ja hispaaniakeelsed küsitlusvastused. Heli ja video transkribeeritakse automaatselt.
- Kas Skimle vastab GDPR-ile ja on turvaline?
- Jah. Kõiki andmeid hoitakse Euroopa Liidus ja need ei lahku kunagi ELi serveritest. Skimle vastab täielikult GDPR-ile ja pakub institutsionaalsetele klientidele andmetöötluslepinguid. Teie dokumente ei kasutata kunagi tehisintellekti mudelite treenimiseks. Rangemate andmesuveräänsuse nõuetega suurklientidele on saadaval eraldatud pilvelahendused.
- Kuidas Skimle tehisintellekti hallutsinatsioone väldib?
- Iga Skimle loodud tähelepanekut kontrollitakse lähtedokumentide vastu: kui tehisintellekt loob teksti, mida teie andmetes sõnasõnaliselt ei ole, märgib süsteem selle ära ja töötleb lõigu uuesti. Kahesuunaline läbipaistvus võimaldab klõpsata mis tahes teemal, et näha seda toetavaid täpseid tsitaate, ning avada mis tahes dokumendi, et näha, milline tekst on kodeeritud ja milline mitte. Nii ei saa midagi välja mõelda ega kahe silma vahele jääda.
- Kui kiiresti saan esimesed tulemused?
- Enamiku projektide töötlemine võtab mõne minuti. Suuremad, üle 1000 dokumendiga andmestikud võivad võtta kauem. Tavapärane 10 kuni 20 intervjuu transkriptsiooni komplekt töödeldakse tavaliselt alla tunniga. Saate samal päeval andmed üles laadida, analüüsi käivitada ja uurida struktureeritud teemasid koos toetavate tsitaatidega, ilma seadistamise ja koolituseta.
- Kas Skimle kasutamiseks on vaja tehnilisi oskusi?
- Ei. Skimle on loodud kvalitatiivsetele uurijatele, analüütikutele ja konsultantidele, mitte inseneridele. Laadite üles oma dokumendid, kirjeldate uurimisküsimust ja Skimle teeb ülejäänu. Kategooriate muutmine, teemade uurimine ja aruannete eksportimine käib mõne klõpsuga. Programmeerimist, skripte ega tehisintellekti oskusteavet pole vaja.
- Kuidas hinnastamine toimib? Kas tasuta prooviperiood on tõesti olemas?
- Jah. Skimle pakub tasuta prooviperioodi 200 krediidiga (piisab umbes 200 kuni 300 lehekülje dokumentide jaoks) ja krediitkaarti pole vaja. Tasulised paketid algavad üksikkasutajatele 20 eurost kuus aastase arveldusega (kuupõhiselt 25 eurot), aktiivsetele kasutajatele on suuremad paketid. Organisatsiooni- ja ettevõttepaketid kohandatud mahtude, SSO ja eraldatud paigaldustega on saadaval nõudmisel.
- Kui palju dokumente saan kõige rohkem analüüsida?
- Skimle toetab tuhandeid dokumente projekti kohta. See on palju rohkem, kui ükski käsitsi lähenemine suudaks hallata, ja katab enamiku professionaalsetest kasutusjuhtudest, alates 10 süvaintervjuust kuni enam kui 1000 vabatekstilise küsitlusvastuseni. Kui teil on eriti suur andmestik või pidev analüüsivajadus, võtke meiega võimaluste arutamiseks ühendust.
Spetsialistidelt spetsialistidele
Skimlel on üle 1500 rahuloleva kasutaja enam kui 50 ülikoolis, riigiasutuses, agentuuris ja ettevõttes. Kõiki andmeid hoitakse ELis ja töödeldakse kooskõlas meie range GDPR-i poliitika ja kasutustingimustega.
Soovite rohkem teada? Tutvuge meie blogiga Signal & Noise, KKK-ga ja valdkondade kaupa kasutusjuhtudega. Näitame hea meelega ka toodet või uurime koos, kuidas Skimle teie vajadustele sobiks. Lugege lähemalt Skimle taga olevast ettevõttest