Iga vastaja ära kuulatud. Iga tähelepanek jälgitav. Iga tähtaeg täidetud.
Loodud turu-uuringute agentuuridele, kes teevad tööd klientidele, ja ettevõttesisestele klienditähelepanekute meeskondadele, kes teevad tööd oma organisatsioonile. Mõlemad on samas surves: kvalitatiivsed andmed on kõige rikkalikum signaal ja neid on liiga palju, et neid käsitsi hoolikalt lugeda. Agentuuridelt oodatakse sügavamaid tähelepanekuid lühema ajaga ja väiksema tasu eest. Sisemised meeskonnad peavad sammu pidama toote- ja äriotsustega, mis ei oota kaks nädalat.
Skimle teeb ära mehaanilise kodeerimise, mis neelab suurema osa analüütiku nädalast. Teie tegelete tõlgendamise, küsimusega „mis siis“ ja soovitusega. Kahe nädala kodeerimine muutub kaheks päevaks ja nüansid jäävad alles.
Professionaalse tasemega analüüs, mis kasvab koos teie uuringute mahuga
60 süvaintervjuud, 8 fookusgruppi neljal turul või 5000 NPS-kommentaari: sellist mahtu ei jõua käsitsi hoolikalt lugeda ja pinnapealsed tööriistad kaotavad nüansid, mille kohta klient või müügidirektor küsib. Skimle skaleerub sügavust ohverdamata.
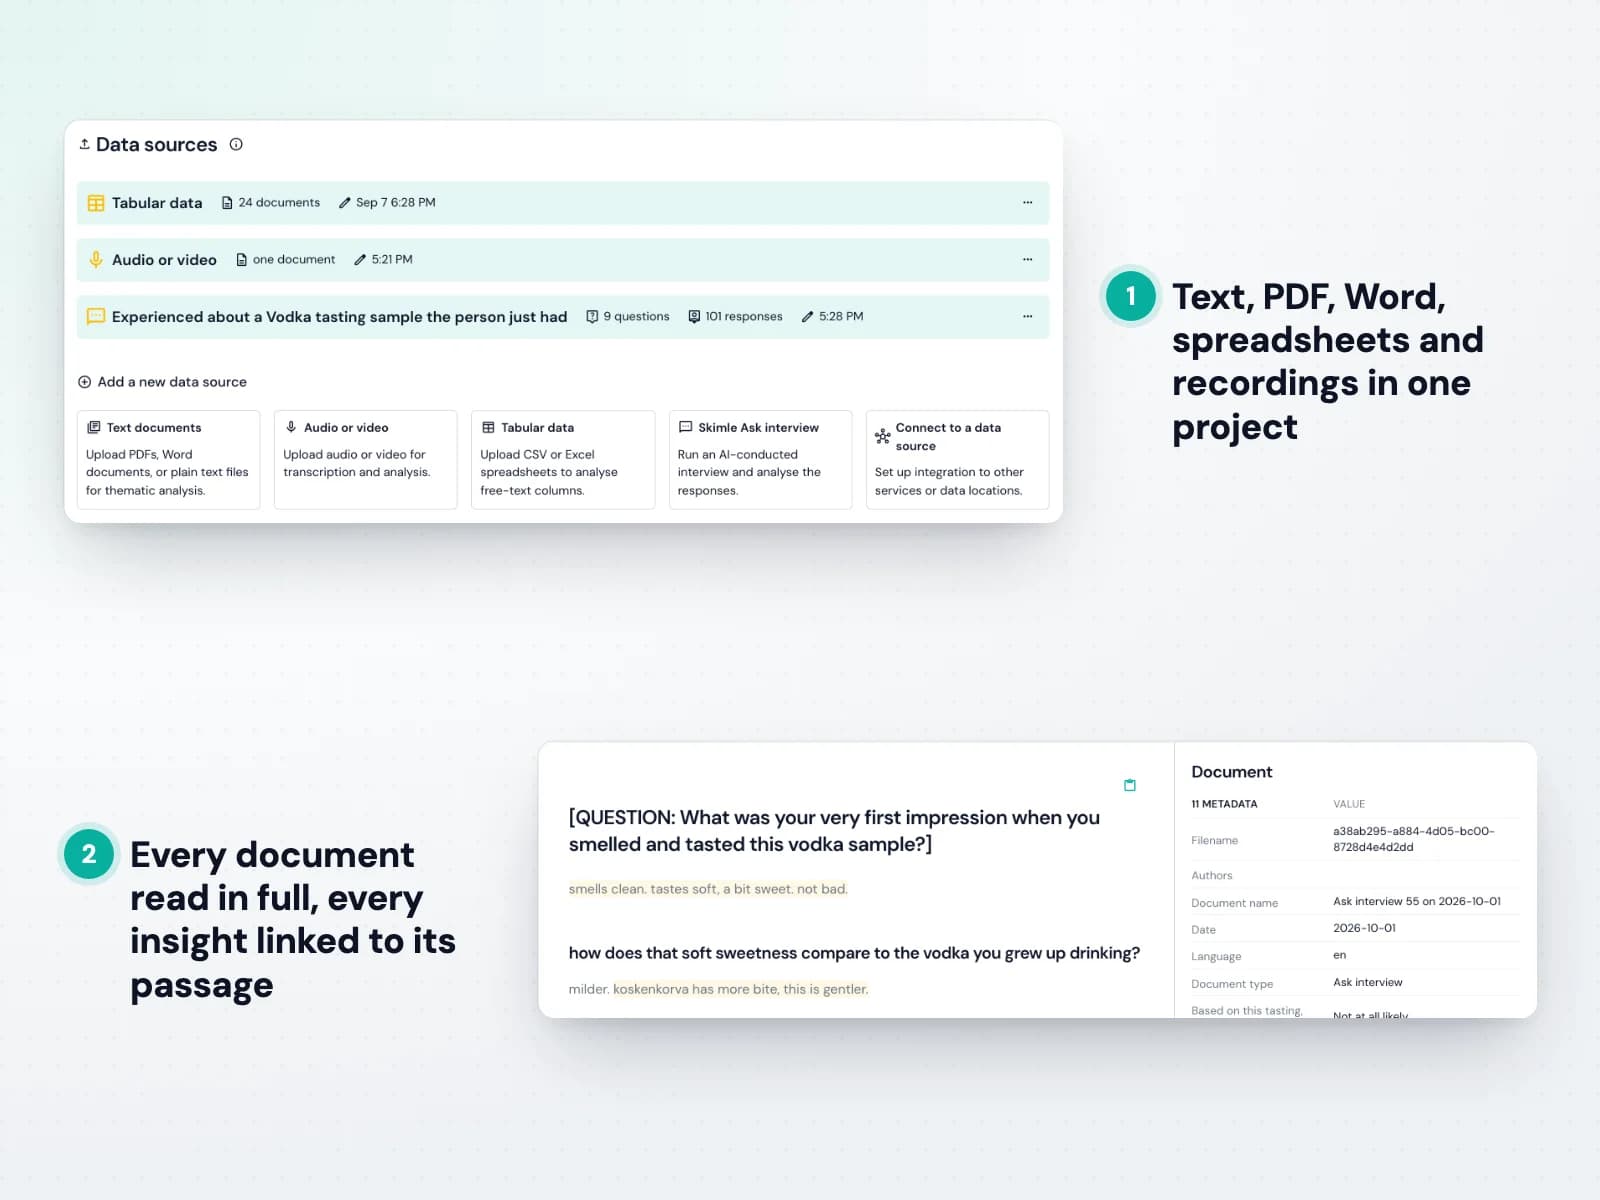
- Käsitleb ühes projektis intervjuusid, fookusgruppe, küsitluste avatud vastuseid, arvustusi ja tugipöördumisi
- Iga teema on seotud klientide sõnasõnaliste tsitaatidega kogu andmestikust, mitte valimist
- Sisseehitatud segmendianalüüs: võrrelge demograafia, tootetasemete, piirkondade ja NPS-rühmade lõikes
- Enam kui 100 keelt ühes projektis, tõlkimisetappi pole vaja
- Esitluseks valmis ekspordid Wordi, PowerPointi ja Excelisse minutitega
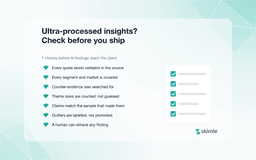
7 kontrolli enne, kui tehisintellekti loodud tähelepanekud kliendini jõuavad: kvaliteedikontroll turu-uuringutes
Kui palju kvalitatiivne uuring 2026. aastal tegelikult maksab: kulude täielik jaotus
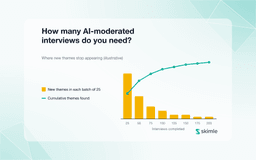
Kui palju tehisintellekti modereeritud intervjuusid on vaja? Valimi suurus, kui kvalitatiivne uuring jõuab n=200-ni
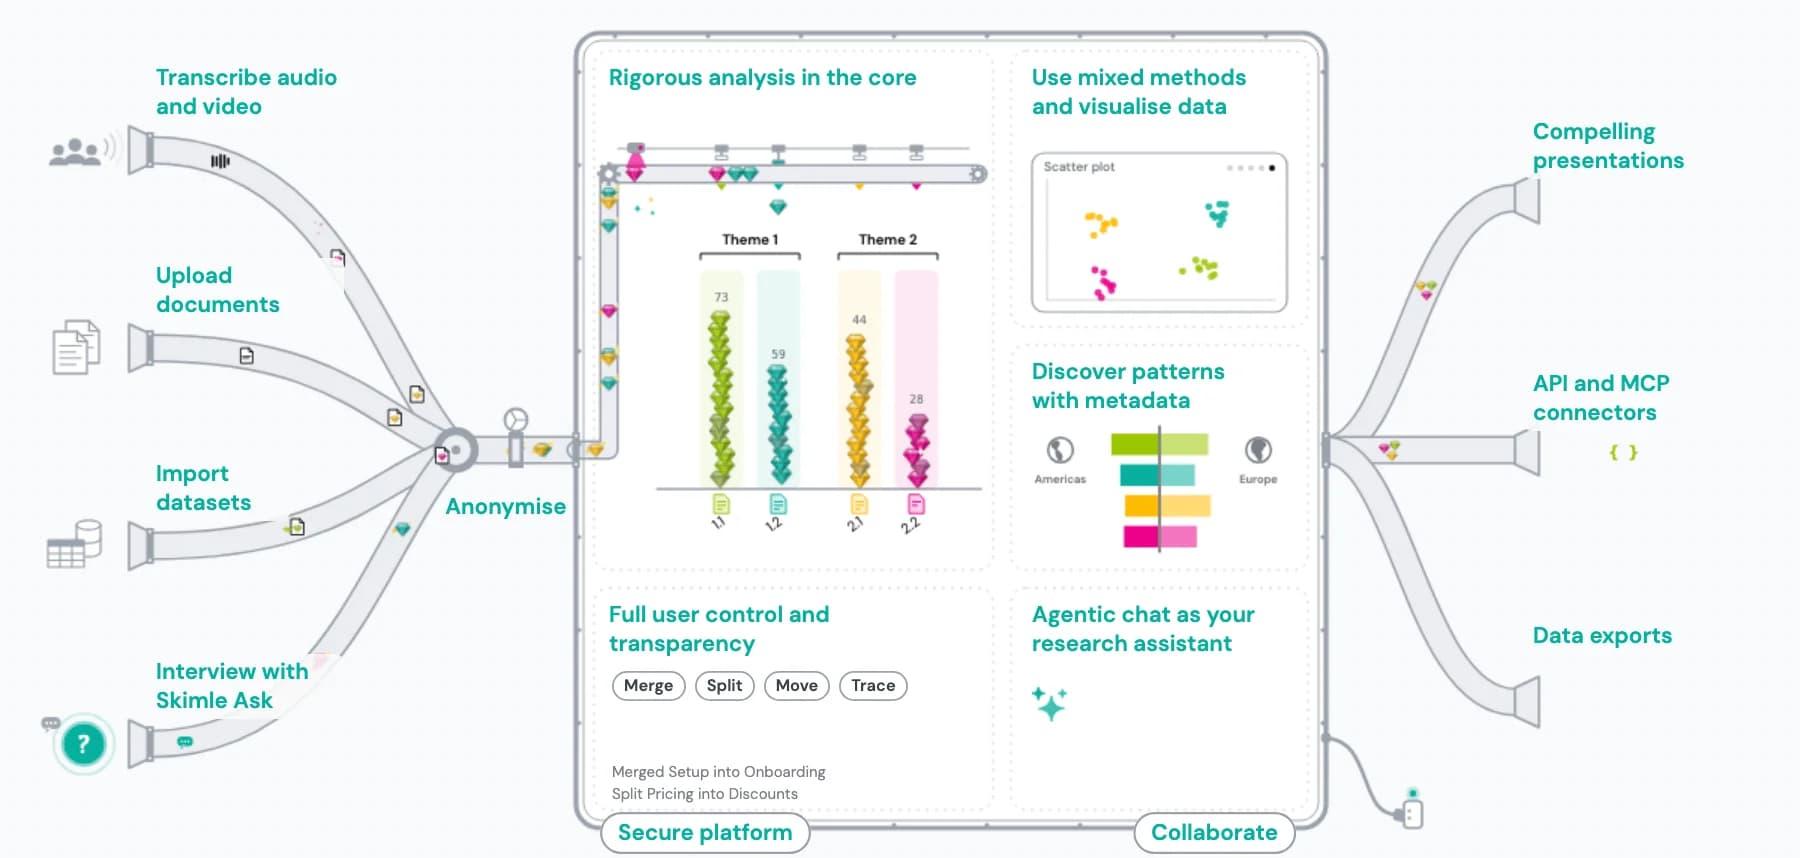
Analüüsige fookusgruppe ja kliendiintervjuusid suures mahus
Fookusgrupid on kvalitatiivsed andmed, mida on kõige raskem hästi analüüsida. Üks häälekas osaleja paistab nagu neli sõltumatut häält, kui te tõendeid ei jälgi. Süvaintervjuud ebaõnnestuvad teisiti: 20, 40 või 60 transkriptsiooni juures muutub kitsaskohaks viimase kodeerimine samamoodi nagu esimese. Skimle loob kõigi seansside ulatuses ühe teemastruktuuri ja näitab, mis oli järjepidev, mis segmenditi erines ja mis oli üksik erand, nii et leid peab vastu, kui klient või huvirühm vastu vaidleb.
Kuidas see töötab
- 1. Importige iga seanss dokumendina
Laadige üles transkriptsioonid või salvestised Zoomist, Teamsist, Otterist või Firefliesist. Skimle transkribeerib heli ja video otse, nii et igast seansist saab üks analüüsiks valmis dokument.
- 2. Analüüsige kõiki seansse korraga
Skimle loeb iga transkriptsiooni ja loob teemad kõigi seansside sisu põhjal. See avastab, mida tegelikult arutati, selle asemel et suruda peale eelnevalt määratud kategooriasüsteem.
- 3. Vaadake, mis oli järjepidev ja mis erines
Iga teema näitab, millised rühmad sellesse panustasid ja kui sageli, eraldades universaalse signaali ühest seansist või ühelt turult pärinevast.
- 4. Hinnake tõendite jaotust
Klõpsake teemal, et lugeda toetavaid tsitaate ja näha, millistest seanssidest need pärinevad. Hinnake domineerivate häälte mõju otse, mitte mälu järgi.
- 5. Eksportige kliendi jaoks
Looge sünteesidokument esinduslike tsitaatidega rühmade kaupa, valmis esitluseks või täielikuks aruandeks.
Kodeerige küsitluste avatud vastused ja võrrelge segmente
Üks üldine teemaloend ei vasta kunagi küsimusele, mida organisatsioon tegelikult küsis: kes nii arvab ja kuidas see segmenditi erineb? Tuhandete avatud vastuste puhul loeb enamik meeskondi valimi ja kaotab vähemuse seisukohad, mis kannavad kõige teravamat signaali. Skimle kodeerib iga vastuse ja laseb sama teemastruktuuri jaotada mis tahes metaandmete muutuja järgi, olgu see NPS-rühm, tootetase, turg või demograafiline tunnus, muutes jälgimisuuringu avatud vastused segameetodite ülevaateks, mille põhjal saab tegutseda.
Kuidas see töötab
- 1. Laadige vastused üles koos metaandmetega
Importige avatud vastused CSV-failina SurveyMonkeyst, Typeformist või Qualtricsist koos vastajate metaandmete veergudega, nii et iga vastus kannab oma segmenti.
- 2. Looge täielik teemastruktuur
Skimle kodeerib iga vastuse teemahierarhiasse, mitte ainult levinumad, nii et vähemuse seisukohad jäävad nähtavaks.
- 3. Segmentige mis tahes muutuja järgi
Filtreerige ja võrrelge teemasid NPS-rühma, tootetaseme, piirkonna või demograafia järgi, et näha, millised küsimused on millistele klientidele kõige olulisemad.
- 4. Kontrollige tõendeid
Iga muster viib sõnasõnaliste tsitaatideni, nii et kahe segmendi erinevust toetavad täpselt need vastused, millest see tekkis.
- 5. Eksportige kliendile valmis väljund
Looge teemapõhine aruanne sõnasõnaliste tsitaatide ja risttabelitega minutitega, mitte päevadega.

Koondage kõik tagasisidekanalid ühte tähelepanekute pilti
Intervjuud, NPS-kommentaarid, tugipöördumised, arvustused, müügikõnede salvestised, võidetud ja kaotatud tehingute analüüsid, kogukonna arutelud, analüütikute ja konkurentide aruanded. Igal kanalil on tavaliselt oma analüüs, oma esitlus ja oma sõnavara, nii et miski ei liitu kokku ning sama kliendiprobleemi raporteeritakse kolm korda kolme nime all. Skimle kodeerib kõik allikad ühes projektis ühe kategooriastruktuuri järgi ja näitab seejärel, kui suurt kaalu iga kanal samale teemale annab. Agentuurid kasutavad seda lauauuringute ja teisese materjali põimimiseks primaaruuringusse. Sisemised meeskonnad kasutavad seda kliendist pideva pildi saamiseks.
Kuidas see töötab
- 1. Koondage kanalid ühte projekti
Laadige transkriptsioonid, CSV-ekspordid, PDF-id ja salvestised üles kõrvuti. Tugipöördumiste ekspordid, arvustuste kogumid, analüütikute aruanded ja intervjuude heli muutuvad kõik sama projekti dokumentideks.
- 2. Märgistage iga dokument selle kanaliga
Kanal, segment, turg ja kuupäev lisatakse metaandmetena, nii et iga hilisem allikate võrdlus on filter, mitte uus analüüs.
- 3. Kodeerige kõik ühe struktuuri järgi
Skimle loob kõigi allikate ulatuses ühe teemastruktuuri või rakendab raamistikku, mille järgi juba raporteerite, nii et leid tähendab igas kanalis sama.
- 4. Võrrelge, mida iga kanal teile ütleb
Vaadake, kus allikad ühtivad ja kus nad üksteisele vastu räägivad. Teema, mis on tugipöördumistes vali ja intervjuudest puudub, on leid, mitte lahknevus, mis tuleks ära seletada.
- 5. Lisage järgmine laine ilma otsast alustamata
Järgmise kvartali andmed kodeeritakse samasse struktuuri, nii et jälgimisuuring säilitab võrreldavuse ja uuendatud aruanne on uus eksport, mitte ümberehitus.
Korduma kippuvad küsimused
Need on küsimused, mida klienditähelepanekute meeskonnad ja agentuuride uuringujuhid meilt kõige sagedamini küsivad, sealhulgas need, mis tulevad otse hankeprotsessist. Meie tarnijaneutraalne RFP kontrollnimekiri esitab samad küsimused, mida esitada igale hinnatavale tarnijale, ka meile.
- Kuidas aitab see meil konkureerida odavate ja pinnapealsete alternatiividega?
- Odavad pakkujad ja õhukesed tehisintellekti kestad konkureerivad hinnaga, pakkudes sõnapilvi ja lamedat teemaloendit. Skimle annab teile sügavuse nende kiirusega, nii et agentuur eristub küsimusele „mis siis“ antud vastuse kvaliteedi, mitte hinnakirja poolest, ja sisemine meeskond saab sama eelarvega teha rohkem uuringuid. Analüütikute tunnid liiguvad mehaaniliselt kodeerimiselt tõlgendamisele, mille eest keegi tegelikult maksab. Vaadake, kuhu kvalitatiivse uuringu raha tegelikult läheb →
- Mida öelda, kui klient või huvirühm seab tehisintellekti toel tehtud analüüsi kahtluse alla?
- Kirjeldage seda täpselt: tehisintellekt teeb mehaanilise kategoriseerimise, nimeliselt määratud uurija vaatab iga teema üle ja kirjutab tõlgenduse. Seejärel näidake tõendeid. Iga väide Skimle aruandes avab sõnasõnalise tsitaadi ja dokumendi, millest see pärineb, mis on tugevam vastus, kui käsitsi tehtud süntees anda saab, sest seal oli kodeerimise loogika olemas ainult kellegi peas. 7 reeglit tehisintellekti vastutustundlikuks kasutamiseks kvalitatiivsetes turu-uuringutes →
- Kas Skimle analüüsib kogu andmestikku või valimit?
- Kogu andmestikku. Seda tasub küsida igalt tarnijalt, sest mitu tööriista hangivad embeddingu-otsingu kaudu osa teie dokumentidest, analüüsivad seda ega teata kunagi, millised dokumendid välja jäid. Tulemus näib hõlmavat kogu materjali, kuid ei hõlma. Skimle kodeerib iga dokumendi ja saate avada ükskõik millise neist, et näha täpselt, millised lõigud on kodeeritud ja millised mitte.
- Kas saame rakendada oma kategooriasüsteemi või ainult aktsepteerida seda, mida tehisintellekt loob?
- Mõlemat, ja mõlemat samal materjalil. Tooge olemasolev kategooriasüsteem ja Skimle kodeerib selle järgi deduktiivselt, või laske tal luua struktuur andmetest induktiivselt. Kategooriaid saab hiljem ühendada, jagada, ümber nimetada, ümber järjestada ja kustutada ning analüüs järgib teie muudatusi. Agentuurid, kes teevad aastast aastasse jälgimisuuringut või kliendi standardraamistikku, töötavad tavaliselt deduktiivselt; uurivad uuringud algavad tavaliselt vastupidi.
- Mis takistab väljamõeldud tsitaadi jõudmist meie aruandesse?
- Iga tsitaati kontrollitakse masinlikult lähtedokumendi vastu. Kui mudel loob teksti, mida teie andmetes sõna-sõnalt ei ole, märgib Skimle selle ja töötleb uuesti, selle asemel et seda näidata, nii et väljamõeldud tsitaat ei jõua kliendiesitlusse. Samuti saate avada mis tahes dokumendi ja näha, millised lõigud on kodeeritud ja millised mitte, ning nii avastate vastupidise vea, et midagi on vahele jäänud. Kuidas toimib kahesuunaline läbipaistvus →
- Kuidas peaksime Skimlet võrdlema teiste meie nimekirjas olevate tööriistadega?
- Tehke demode vaatamise asemel pilootprojekt. Võtke materjal, mille olete juba analüüsinud, et teaksite, milline peaks vastus olema, kirjutage enne alustamist üles kolm ülesannet (üks kodeerimine, üks segmentide võrdlus, üks tõendite otsing), mõõtke iga ülesande aeg koos parandustööga ja olge tööriistaga teadlikult eriarvamusel, et näha, kui kiiresti saate selle väljundi ümber struktureerida. Teeme hea meelega ühe päris projekti paralleelselt teie praeguse tarnijaga ja tasuta pakett võimaldab ühel uurijal enne seda pärastlõunaga arvamus kujundada. 7 valdkonnaga RFP kontrollnimekiri ja hindamismall →
- Kui palju andmeid Skimle käsitleb ja mitmes keeles?
- Kuni 1000 dokumenti projekti kohta, mis katab kõike alates 20 intervjuuga uuringust kuni ülemaailmse jälgimisuuringuni tuhandete küsitlusvastustega, ning enam kui 100 keelt, mida analüüsitakse otse ilma tõlkimisetapita. Üks projekt võib segada inglise, hispaania, mandariini, saksa ja araabia keelt, luua kõigele ühe teemastruktuuri ja säilitada iga tsitaadi algkeeles. Kui töötate regulaarselt selle vahemiku ülemises otsas, rääkige meiega mahukokkulepetest.
- Kas kliendiandmed on turvalised ja konfidentsiaalsed?
- Kõiki andmeid hoitakse ja töödeldakse ELis AWS-is, sertifitseeritud kolmanda osapoole seadistatud keskkonnas, ning kliendiandmeid ei kasutata kunagi mudelite treenimiseks. Saadaval on andmetöötluslepingud, töötame klientide konfidentsiaalsuslepingute alusel, pseudonüümimine on töövoogu sisse ehitatud ning kui andmesuveräänsus seda nõuab, on saadaval eraldatud või privaatpilve lahendus.
- Mis juhtub meie analüüsiga, kui lõpetame Skimle kasutamise?
- Võtate selle kaasa, igas paketis. Eksportige kodeeritud andmed avatud REFI-QDA vormingus (.qdpx) ja jätkake NVivos, ATLAS.ti-s või MAXQDA-s või võtke kaasa Wordi, PowerPointi ja Exceli väljundid, kus tsitaadid on teemade kaupa korrastatud. Rakendame koostalitlusstandardit just selleks, et jäämine oleks valik, mitte paratamatus.
- Kuidas hinnastamine toimib, kui meie uuringute maht kõigub?
- Skimle on kerge kasutajapõhine tellimus koos sisalduva krediidimahuga, millele lisanduvad krediidipaketid, mida ostate suure uuringu kuudeks. Tellimus hoiab kogu meeskonna projektide vahel tööriistas; paketid seovad kulu projektiga, mis selle põhjustas, mis on oluline agentuuridele, kes esitavad kulud klientidele edasi. Huvirühmad, kes peavad ainult tulemusi lugema, ei vaja kasutajakohta, sest selleks piisab ekspordist ja prinditavatest uuringuaruannetest.
- Kas mitu uurijat saavad töötada samas projektis?
- Jah, samaaegselt, kusjuures iga inimese muudatused ja märkused säilivad. See sobib kolleegide ülevaatuseks ja kvaliteedikontrolliks ning suure uuringu jagamiseks noorem- ja vanemuurijate vahel, kusjuures üks vanemuurija juhib kategooriastruktuuri.
Spetsialistidelt spetsialistidele
Skimlel on üle 1500 rahuloleva kasutaja enam kui 50 ülikoolis, riigiasutuses, agentuuris ja ettevõttes. Kõiki andmeid hoitakse ELis ja töödeldakse kooskõlas meie range GDPR-i poliitika ja kasutustingimustega.
Soovite rohkem teada? Tutvuge meie blogiga Signal & Noise, KKK-ga ja valdkondade kaupa kasutusjuhtudega. Näitame hea meelega ka toodet või uurime koos, kuidas Skimle teie vajadustele sobiks. Lugege lähemalt Skimle taga olevast ettevõttest