AI のスピードで学術レベルの厳密さを
Skimle は研究者が研究者のために作りました。共同創業者の Henri Schildt 教授は質的研究に数十年携わり、Academy of Management Journal や Organization Science などの一流の経営学術誌に論文を発表しています。NVivo や MAXQDA の遅くて使いにくいワークフローにうんざりし、透明性も網羅性もない分析に ChatGPT が使われていることを懸念していました。そこで、厳密で透明な質的研究の方法論を再現しつつ、その中核に AI を据えたプラットフォームとして Skimle を作りました。
インタビューの初期コーディングは、手作業だと数週間かかることがあります。Skimle は方法論の厳密さを損なわずにこれを処理し、人が見落とす引用を見つけることも少なくありません。すべてのテーマは検証済みの逐語引用にリンクしています。完全な監査証跡で査読者も納得します。
教材 →理論的貢献に集中できる厳密な分析
Skimle のアプローチは、グラウンデッド・セオリー(Glaser & Strauss、Strauss & Corbin)と Gioia メソッドに着想を得ています。査読が求める体系的で透明な分析を、理論に使うべき時間を奪う数週間の機械的なコーディングなしで実現します。100以上の言語に対応し、1プロジェクトあたり最大1,000件の文書を扱えます。
- 自動の初期コーディング:すべての引用がカテゴリにリンク
- 査読と方法の透明性のための、完全な双方向の監査証跡
- 自分でコントロールできるカテゴリ体系:カテゴリを自由に統合、分割、名前変更、再編成
- 翻訳なしで100以上の言語に対応
- インタビュー、音声・動画、書籍、文書、アーカイブ資料に対応
- 割引プラン Skimle Academic あり
インタビューの文字起こしと匿名化
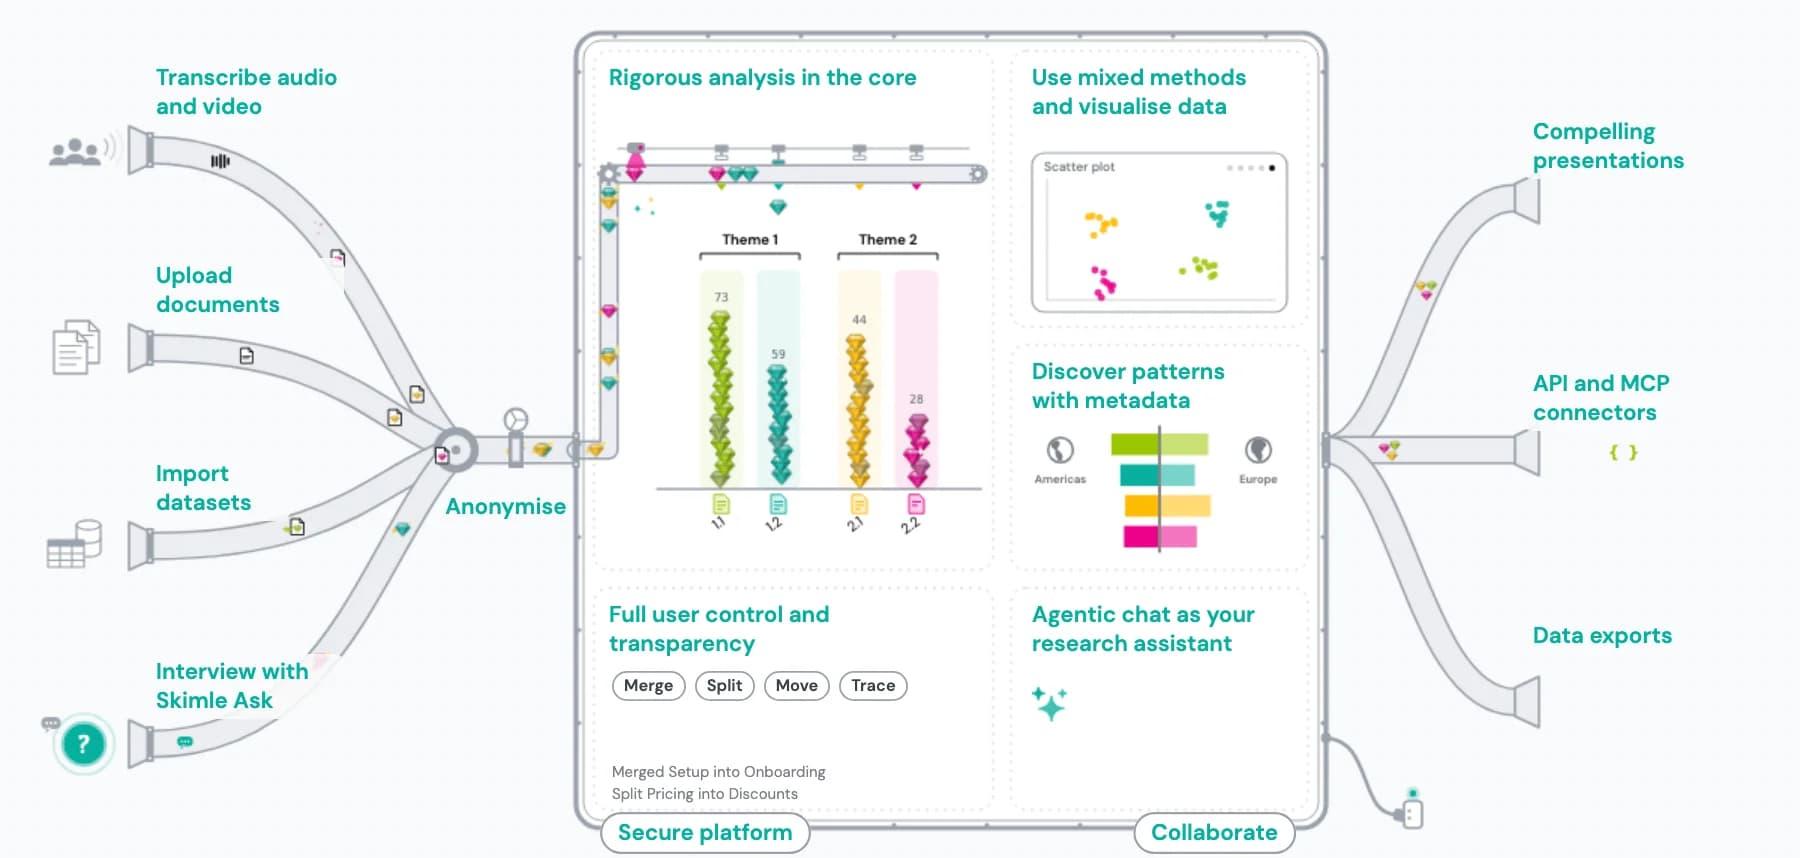
フィールド録音を外部サービスで使えるデータにするのは時間も費用もかかり、できあがった記録には氏名、所属、場所が含まれるため、共有、アーカイブ、引用の前に GDPR や倫理上の義務が生じます。Skimle は EU でホストされる安全な環境内で音声と動画を文字起こしし、研究レベルの仮名化で匿名化するので、データが GDPR 準拠のインフラから出ることなく、その日のうちにコンプライアンスに対応したコーディング可能な記録が手に入ります。
しくみ
- 1. 音声、動画、テキストをアップロード
MP3、M4A、WAV、MP4、MOV、PDF、Word のファイルを直接アップロードできます。外部の文字起こしサービスは不要で、100以上の言語にネイティブ対応しています。
- 2. 話者ラベル付きで文字起こし
Skimle は録音を文字起こしし、話者の切り替わりを識別し、なまりや音質のばらつきにも対応します。分析を始める前に結果を確認・修正してください。
- 3. 識別子を自動で検出
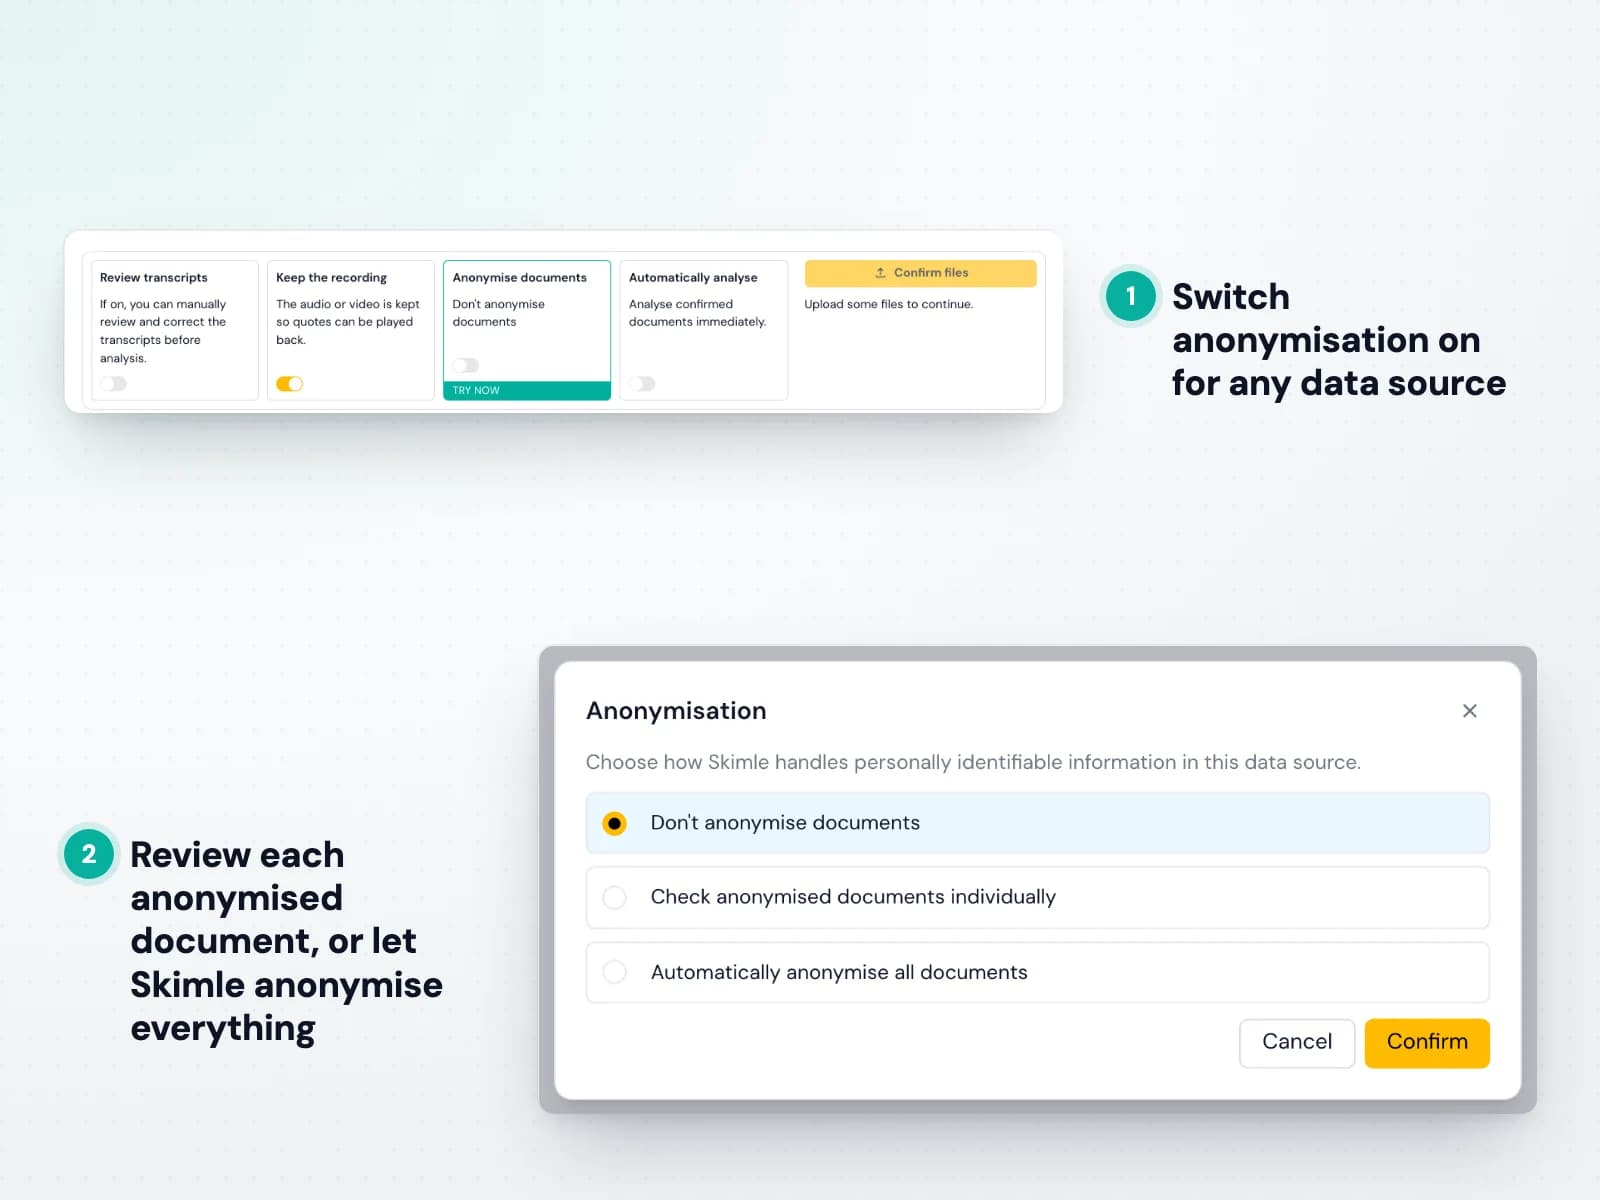
Skimle Anonymise は、6つのカテゴリ(氏名、肩書きと役割、場所、組織、日付、その他)の識別子をすべての文書で検出し、ファイル間の一貫性を保つので、同じ人物には常に同じ仮名が付きます。
- 4. 匿名化のレベルを選ぶ
軽度の仮名化、強度の仮名化、キーを破棄する HIPAA レベルの匿名化から選べます。カテゴリごとに個別に調整し、普段の言葉でカスタムルールを追加できます。
- 5. 監査用の文書付きで書き出す
倫理審査委員会向けに PDF の監査レポートと Excel の対応表を書き出し、整えた記録をそのまま Skimle の分析ワークフローに送ります。元の音声はその後安全に削除されます。

AI を活用したインタビューの質的分析
40件以上のインタビューに基づく研究は(たとえば博士論文として)豊かな理論的貢献を生むはずですが、手作業のコーディング(マーキング、整理、再コーディング、管理表の作成)が使える時間の大半を奪い、それでも重要なパターンを見落とすことがあります。Skimle はすべてのインタビューを体系的に読み、逐語の引用が付いた構造化されたテーマの階層を提供するので、あなたにしかできない理論的な解釈に時間を使えます。
しくみ
- 1. 記録をアップロード
PDF、Word、テキストのインタビュー記録をドラッグするだけです。Skimle はあらゆる形式の文書に対応し、100以上の言語にネイティブ対応しています。
- 2. リサーチクエスチョンを説明
分析の焦点を広く、または具体的に設定します。Skimle は、あなたが理論的に理解しようとしていることを軸に初期コーディングを構造化します。
- 3. 初期のコード構造を確認
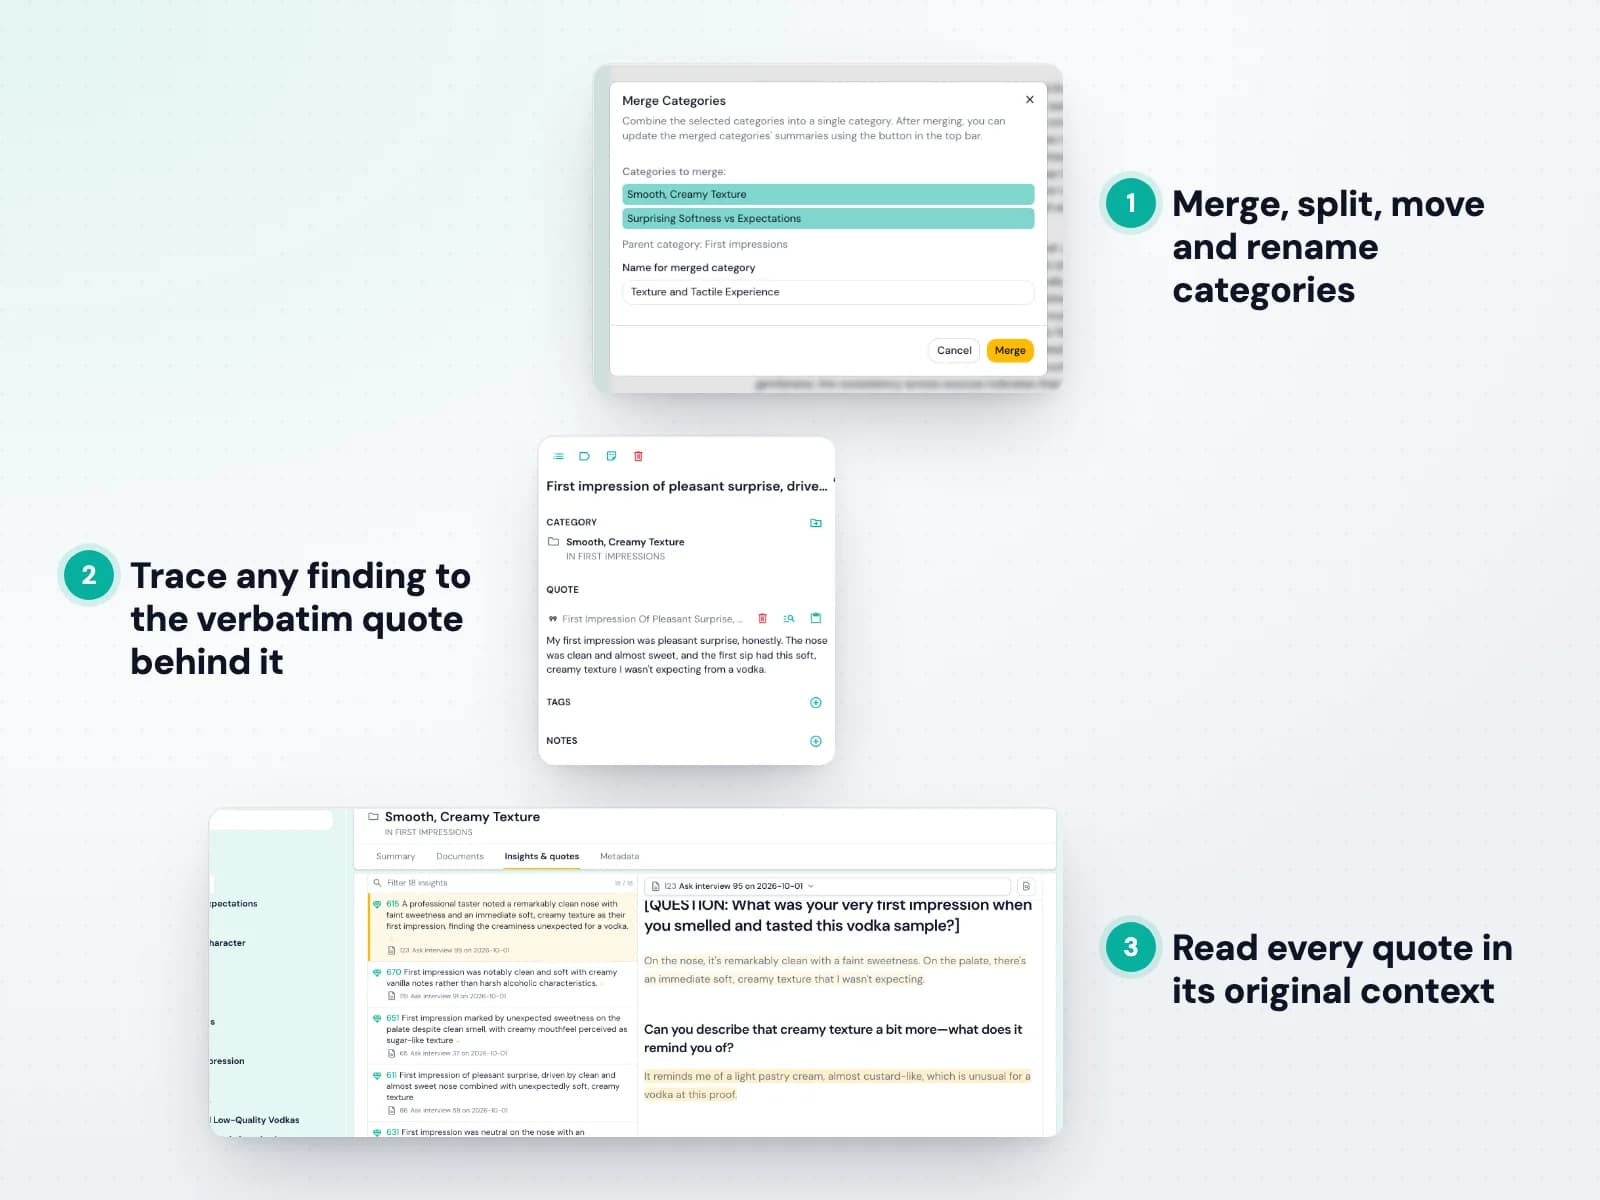
Skimle はテーマの階層を作成し、各テーマを元の記録の逐語引用にリンクします。作り出されたものは何もありません。すべてのコードはテキストまでたどれます。
- 4. 理論的枠組みに合わせて調整
形になりつつある理論モデルに合わせて、カテゴリを統合、分割、名前変更、再編成できます。双方向の透明性により、どの引用がどのコードを裏づけているかをいつでも確認できます。
- 5. 方法の付録用に書き出す
カテゴリ体系と根拠の引用をテキストとして、または NVivo、ATLAS.ti、MAXQDA などの従来の CAQDAS ソフトウェアが対応するオープンソースの REFI-QDA(.qdpx)形式で書き出せます。
サンプル全体で混合研究法による分析を行う
質的な結果は、それがサンプル全体でどう異なるか(コホート、役割、性別、拠点、条件別など)を示せると説得力が増します。テーマを参加者の属性と手作業でクロス集計するのは手間がかかり、間違いも起こりがちです。Skimle はすべての文書にメタデータを付け、同じテーマ構造を任意の変数で分けられるので、どちらの方法論も手放すことなく、豊かな逐語引用と数量化されたパターンを行き来できます。
しくみ
- 1. 文書にメタデータを付ける
各記録に、研究デザインにとって重要な変数(コホート、役割、性別、拠点、調査時期、実験条件など)を、手作業または CSV の列からタグ付けします。
- 2. 質的分析を実行
Skimle はコーパス全体で1つのテーマ階層を作るため、すべての参加者が同じ構造でコード化されます。
- 3. 変数ごとにテーマを分ける
各テーマがグループ間でどう異なるかを確認し、パターンが普遍的なのか、特定のコホートに固有なのかを見極められます。
- 4. 出現率を数量化
テーマの頻度と分布を確認し、セグメントごとにあるコードがどれくらい一般的かを報告できます。すべての数値は、その元になった引用までたどれます。
- 5. 表と引用を書き出す
論文の混合研究法のセクション用に、クロス集計と根拠の引用を Excel や Word に書き出せます。

よくある質問
- 研究で Skimle を引用できますか?
- はい。方法セクションで、NVivo や MAXQDA を引用するのと同じように「AI を活用した質的コーディングソフトウェア」と記述してください。現在査読中の方法論文が正式な引用先となる予定で、それまではご要望に応じて引用の文案をご提案します。
- AI 支援による分析は査読で受け入れられますか?
- 適切に記録すれば、認められるケースが増えています。Skimle の監査証跡は、査読者が求めるもの、つまりすべてのテーマが具体的な引用までたどれる、記録された体系的なコーディングプロセスを提供するので、方法セクションの大部分は自然に書けます。
- Skimle は NVivo や MAXQDA と比べてどうですか?
- NVivo と MAXQDA は、分析に数週間をかけられ、機関のライセンスを持つ研究者に向いています。Skimle は機械的なコーディングの段階を自動化し(数週間が数時間に)、同じ体系的で透明な方法論を保ちながら、数分で使い始められます。両方を使う研究者も多く、初期コーディングには Skimle、混合研究法の統合には NVivo を使っています。
- Skimle はグラウンデッド・セオリーに使えますか?
- はい。Skimle は、テーマをあらかじめ押しつけるのではなくデータから浮かび上がらせる帰納的コーディングに対応しています。広い焦点から始めて、カテゴリ構造を繰り返し発展させていけば、グラウンデッド・セオリーのオープンコーディングによく対応します。
- 混合研究法による分析はできますか?
- はい。各文書にメタデータの変数(コホート、役割、性別、拠点、条件)を付け、そのいずれかでテーマ構造を分けられます。グループ別のテーマの頻度と分布が得られ、それぞれ逐語引用までたどれるので、論文の混合研究法のセクションにそのまま使えます。
- 研究データは安全ですか?
- 記録は EU でホストされるインフラで処理され、AI モデルの学習には一切使われません。機関の倫理審査要件に対応するデータ処理契約をご提供しており、ほとんどの IT セキュリティ要件にも対応できます。個別の要件がある場合はご相談ください。
- アカデミック割引は受けられますか?
- はい。有効な機関のメールアドレスと所属ページをお持ちの研究者は、割引価格の Skimle Academic パッケージを購入できます。研究グループや研究室でチームとして利用する場合は、機関ライセンスについてご相談ください。
プロフェッショナルによる、プロフェッショナルのためのツール
Skimle は、50以上の大学、政府機関、エージェンシー、企業で1,500人を超えるユーザーに満足して使われています。すべてのデータは EU 域内に保存され、当社の厳格な規定に従って処理されます。詳しくは次をご覧ください: GDPR ポリシー および 利用規約.
さらに詳しく知りたい方は、 Signal & Noise ブログ、 よくある質問、業種別の活用例をご覧ください。製品のデモや、Skimle がお客様のニーズにどう合うかのご相談も喜んで承ります。 Skimle を運営する会社について詳しく読む