Academische grondigheid met de snelheid van AI
Skimle is gebouwd door academici voor academici. Medeoprichter professor Henri Schildt heeft tientallen jaren ervaring met kwalitatief onderzoek en publiceerde in toonaangevende managementtijdschriften, waaronder Academy of Management Journal en Organization Science. Hij was de trage, onhandige werkwijze van NVivo en MAXQDA beu en maakte zich zorgen over de manier waarop ChatGPT wordt gebruikt voor analyses zonder transparantie en volledigheid. Dus bouwde hij Skimle als het platform dat grondige, transparante kwalitatieve methodiek reproduceert, met AI als kern.
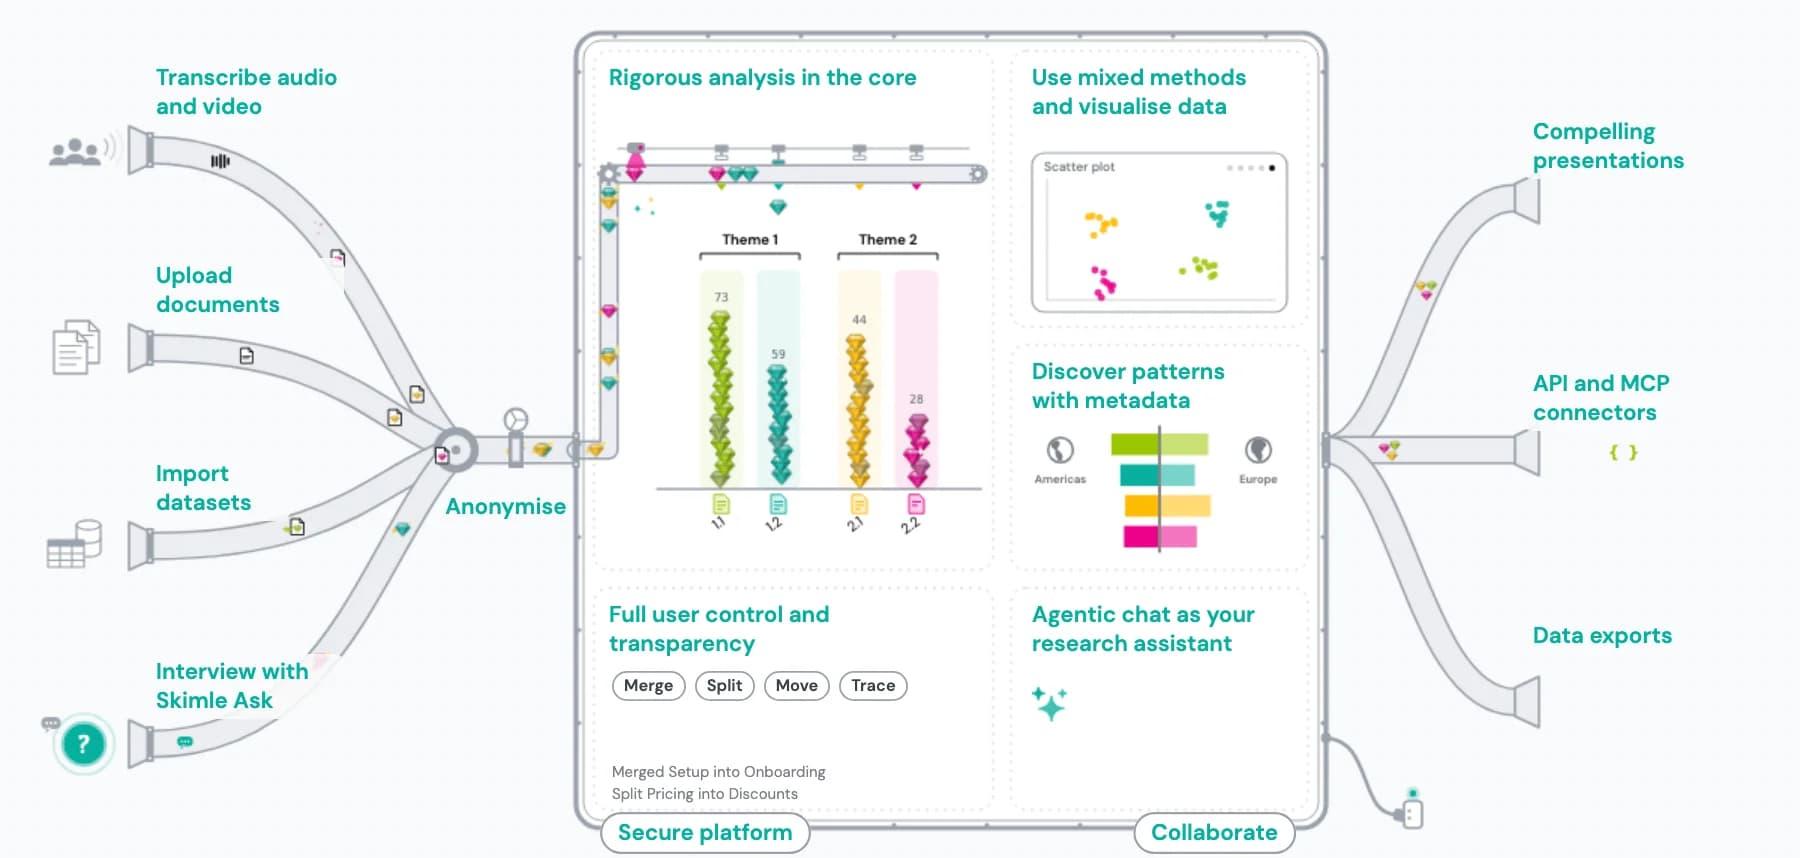
De eerste codering van interviews kan handmatig weken kosten. Skimle doet het zonder in te leveren op methodologische grondigheid en vindt vaak citaten die een mens zou missen. Elk thema is gekoppeld aan een geverifieerd letterlijk citaat. De volledige audit trail stelt peer reviewers tevreden.
Lesmateriaal →Grondige analyse waarmee u zich kunt richten op uw theoretische bijdrage
De aanpak van Skimle is geïnspireerd op grounded theory (Glaser & Strauss; Strauss & Corbin) en de Gioia-methode. Het levert de systematische, transparante analyse die peer review vraagt, zonder de weken mechanisch coderen die tijd opslokken die u beter aan theorie kunt besteden. Het werkt in meer dan 100 talen en verwerkt tot 1.000 documenten per project.
- Geautomatiseerde eerste codering: elk citaat gekoppeld aan zijn categorie
- Volledige audit trail in twee richtingen voor peerreview en transparante methoden
- Een categoriesysteem in uw regie: categorieën vrij samenvoegen, splitsen, hernoemen en herordenen
- Werkt in meer dan 100 talen zonder vertaling
- Verwerkt interviews, audio en video, boeken, documenten en archiefmateriaal
- Skimle Academic, een abonnement met korting, is beschikbaar
Interviews transcriberen en anonimiseren
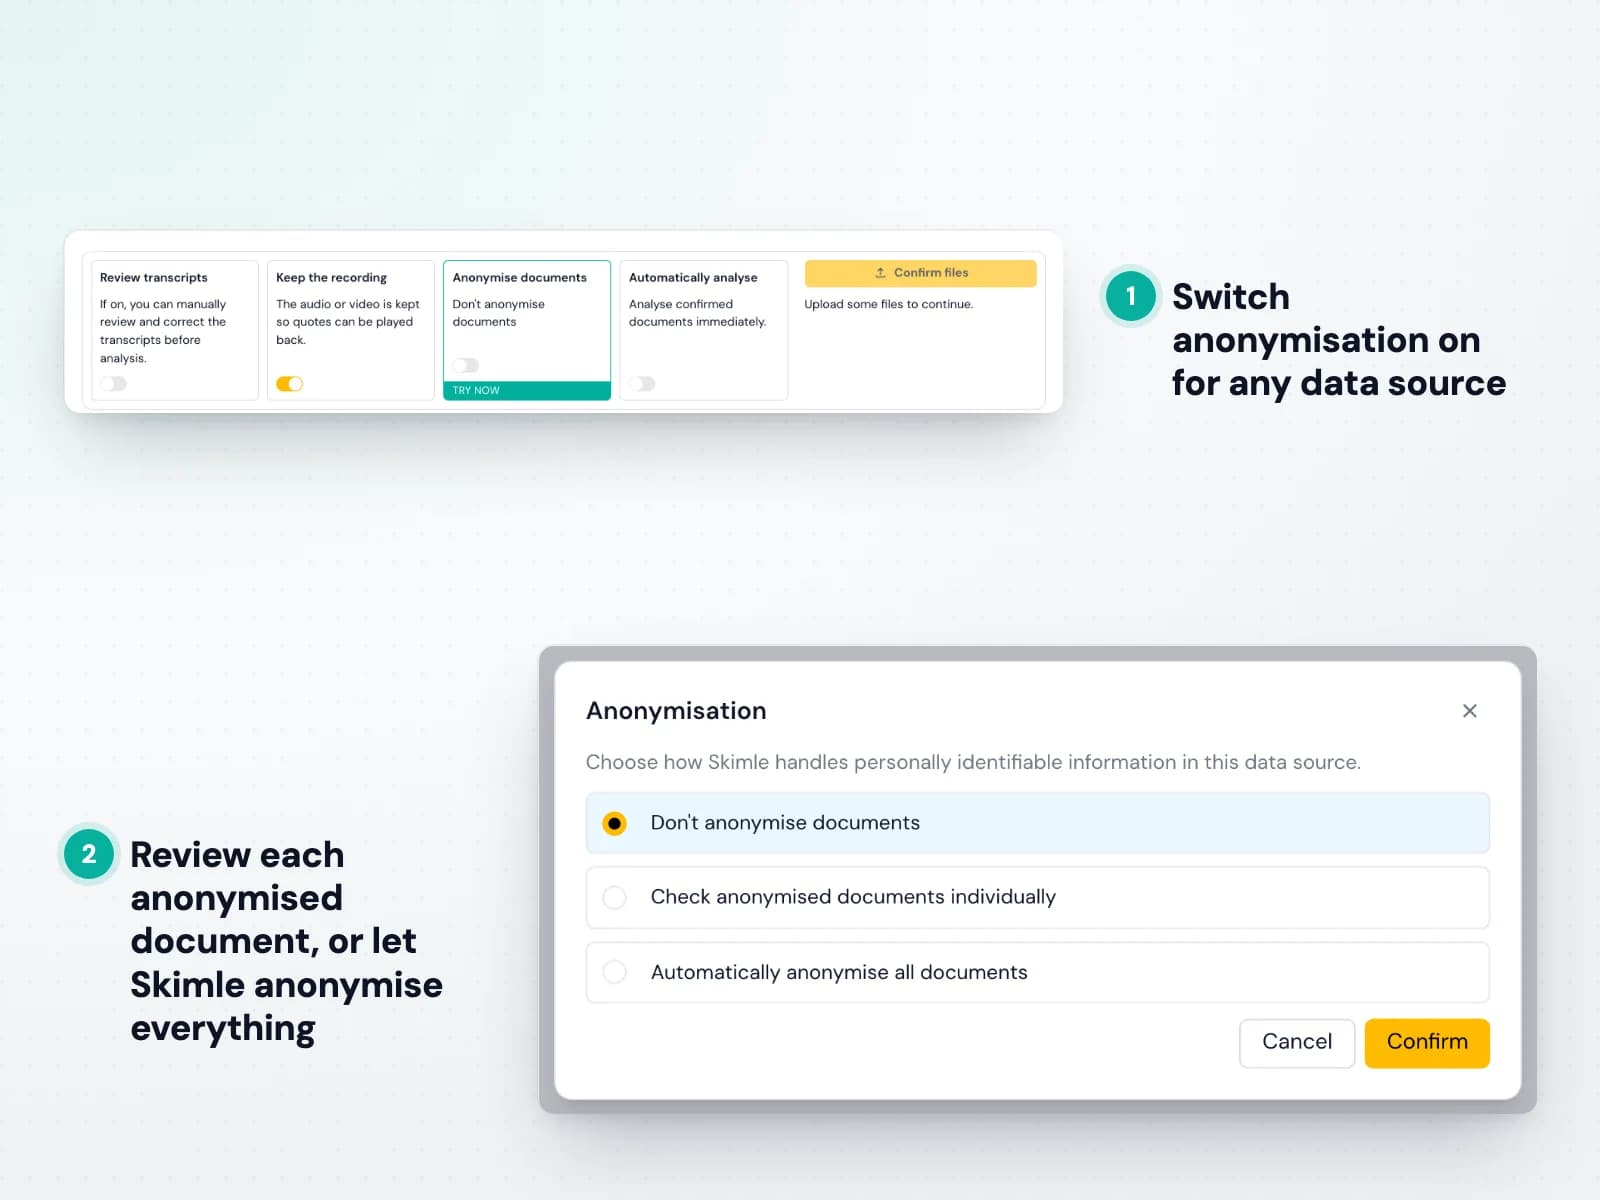
Veldopnamen omzetten in bruikbare data is via een externe dienst traag en duur, en de transcripten bevatten namen, affiliaties en locaties die AVG- en ethische verplichtingen meebrengen voordat u ze kunt delen, archiveren of citeren. Skimle transcribeert audio en video in zijn beveiligde, in de EU gehoste omgeving en anonimiseert daarna met pseudonimisering op onderzoeksniveau. Zo heeft u dezelfde dag een conform transcript dat klaar is om te coderen, zonder dat de data ooit AVG-conforme infrastructuur verlaat.
Hoe het werkt
- 1. Upload audio, video of tekst
Upload MP3-, M4A-, WAV-, MP4-, MOV-, PDF- of Word-bestanden rechtstreeks. Geen externe transcriptiedienst, en meer dan 100 talen standaard ondersteund.
- 2. Transcribeer met sprekerlabels
Skimle transcribeert de opname, herkent sprekerwisselingen en kan omgaan met accenten en wisselende geluidskwaliteit. Controleer en corrigeer het resultaat voordat de analyse begint.
- 3. Herken identificerende gegevens automatisch
Skimle Anonymise markeert identificerende gegevens in zes categorieën (namen, titels en functies, locaties, organisaties, datums en overige) in elk document, consistent over bestanden heen, zodat dezelfde persoon hetzelfde pseudoniem houdt.
- 4. Kies uw niveau van anonimisering
Kies lichte pseudonimisering, sterke pseudonimisering of anonimisering op HIPAA-niveau waarbij de sleutel wordt vernietigd. Stel elke categorie afzonderlijk in en voeg eigen regels toe in gewone taal.
- 5. Exporteer met auditdocumentatie
Exporteer een PDF-auditrapport en een Excel-vertaaltabel voor uw ethische commissie en voer het opgeschoonde transcript daarna direct in de analyseworkflow van Skimle. De oorspronkelijke audio wordt daarna veilig verwijderd.

Voer AI-ondersteunde kwalitatieve analyse van interviews uit
Onderzoek op basis van meer dan 40 interviews zou een rijke theoretische bijdrage moeten opleveren (bijvoorbeeld voor uw proefschrift), maar handmatig coderen (markeren, ordenen, hercoderen, overzichten bijhouden) slokt het grootste deel van de beschikbare tijd op en kan nog steeds belangrijke patronen missen. Skimle leest elk interview systematisch en geeft u een gestructureerde themahiërarchie met bijbehorende letterlijke citaten, zodat u uw tijd kunt besteden aan de theoretische interpretatie die alleen u kunt leveren.
Hoe het werkt
- 1. Upload uw transcripten
Sleep interviewtranscripten erin als PDF, Word-bestand of platte tekst. Skimle accepteert documenten in elk formaat en ondersteunt standaard meer dan 100 talen.
- 2. Beschrijf uw onderzoeksvraag
Bepaal uw analytische focus, breed of specifiek. Skimle structureert de eerste codering rond wat u theoretisch probeert te begrijpen.
- 3. Beoordeel de eerste codestructuur
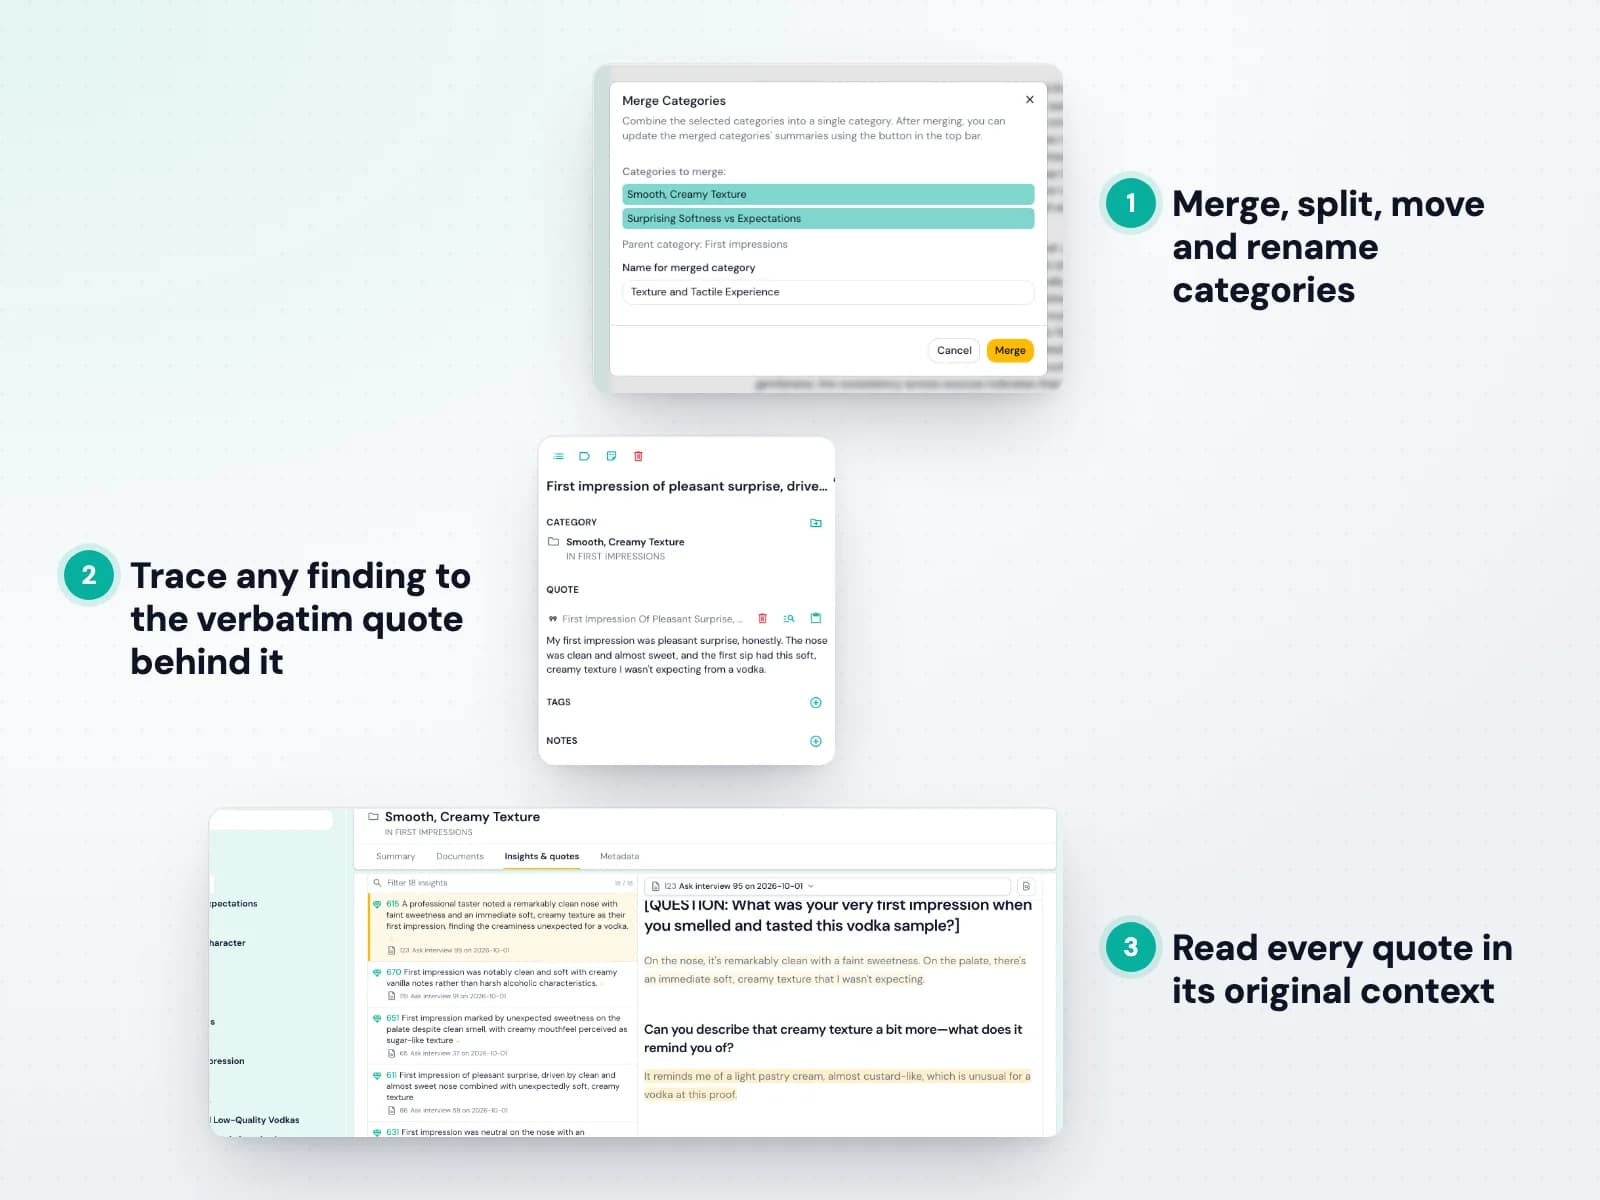
Skimle maakt een hiërarchie van thema's, elk gekoppeld aan letterlijke citaten uit de oorspronkelijke transcripten. Er wordt niets verzonnen. Elke code is herleidbaar tot tekst.
- 4. Verfijn naar uw theoretisch kader
Voeg categorieën samen, splits ze, hernoem en herorden ze zodat ze passen bij uw ontluikende theoretische model. Dankzij transparantie in twee richtingen controleert u op elk moment welke citaten welke codes onderbouwen.
- 5. Exporteer voor uw methodebijlage
Exporteer uw categoriesysteem en de onderbouwende citaten als tekst of in het open REFI-QDA-formaat (.qdpx), dat traditionele CAQDAS-programma's zoals NVivo, ATLAS.ti en MAXQDA ondersteunen.
Voer een mixed-methods-analyse uit over uw steekproef
Kwalitatieve bevindingen wegen zwaarder als u kunt laten zien hoe ze variëren binnen de steekproef: naar cohort, functie, geslacht, locatie of conditie. Thema's met de hand kruisen met kenmerken van deelnemers is tijdrovend en foutgevoelig. Skimle koppelt metadata aan elk document en laat u dezelfde themastructuur segmenteren op elke variabele, zodat u kunt schakelen tussen rijke letterlijke citaten en gekwantificeerde patronen zonder een van beide methodieken los te laten.
Hoe het werkt
- 1. Koppel metadata aan documenten
Label elk transcript met de variabelen die voor uw onderzoeksopzet tellen (cohort, functie, geslacht, locatie, meetmoment of experimentele conditie), handmatig of vanuit een CSV-kolom.
- 2. Voer de kwalitatieve analyse uit
Skimle bouwt één themahiërarchie over al uw documenten, zodat elke deelnemer tegen dezelfde structuur wordt gecodeerd.
- 3. Segmenteer thema's per variabele
Zie hoe elk thema varieert tussen groepen en ontdek waar een patroon universeel is of specifiek voor één cohort.
- 4. Kwantificeer de prevalentie
Lees themafrequenties en verdelingen af om te rapporteren hoe vaak een code per segment voorkomt, waarbij elke telling herleidbaar is tot de citaten waaruit ze voortkomt.
- 5. Exporteer tabellen en citaten
Exporteer kruistabellen en onderbouwende citaten naar Excel of Word voor het mixed-methods-deel van uw artikel.

Veelgestelde vragen
- Kan ik Skimle citeren in mijn onderzoek?
- Ja. Beschrijf het in uw methodesectie als ‘software voor kwalitatieve codering met AI-ondersteuning’, zoals u ook NVivo of MAXQDA zou vermelden. Er ligt een methodeartikel ter peerreview dat een formele bronvermelding zal opleveren, en tot die tijd kunnen we op verzoek een formulering voorstellen.
- Accepteren peer reviewers AI-ondersteunde analyse?
- Steeds vaker wel, met goede documentatie. De audit trail van Skimle geeft reviewers wat ze verwachten: een gedocumenteerd, systematisch codeerproces waarin elk thema herleidbaar is tot specifieke citaten, zodat de methodesectie grotendeels vanzelf ontstaat.
- Hoe verhoudt Skimle zich tot NVivo of MAXQDA?
- NVivo en MAXQDA passen bij onderzoekers met weken voor de analyse en een instellingslicentie. Skimle automatiseert de mechanische codeerfase (van weken naar uren) met behoud van dezelfde systematische, transparante methodiek, en de leercurve is een kwestie van minuten. Veel onderzoekers gebruiken beide: Skimle voor de eerste codeerronde, NVivo voor de integratie van mixed methods.
- Werkt Skimle voor grounded theory?
- Ja. Skimle ondersteunt inductief coderen, waarbij thema's uit de data voortkomen in plaats van vooraf te worden opgelegd. Begin met een brede focus en laat de categoriestructuur iteratief groeien, wat nauw aansluit bij open coderen in grounded theory.
- Kan ik een mixed-methods-analyse uitvoeren?
- Ja. Koppel metadatavariabelen aan elk document (cohort, functie, geslacht, locatie, conditie) en segmenteer de themastructuur op elk daarvan. U krijgt themafrequenties en verdelingen per groep, elk herleidbaar tot letterlijke citaten, klaar voor het mixed-methods-deel van uw artikel.
- Is mijn onderzoeksdata veilig?
- Uw transcripten worden verwerkt op infrastructuur die in de EU wordt gehost en worden nooit gebruikt om AI-modellen te trainen. We bieden verwerkersovereenkomsten voor de ethische eisen van instellingen en kunnen aan de meeste IT-beveiligingseisen tegemoetkomen. Neem contact met ons op met uw specifieke eisen.
- Kan ik academische korting krijgen?
- Ja. Academici met een geldig e-mailadres van hun instelling en een affiliatiepagina kunnen het Skimle Academic-pakket met korting aanschaffen. Neem contact met ons op voor een instellingslicentie als u teamtoegang nodig hebt voor een onderzoeksgroep of lab.
Gebouwd voor professionals, door professionals
Skimle heeft meer dan 1.500 tevreden gebruikers bij meer dan 50 universiteiten, overheidsinstanties, bureaus en bedrijven. Alle data wordt binnen de EU opgeslagen en verwerkt volgens ons strikte AVG-beleid en onze servicevoorwaarden.
Meer weten? Bekijk onze blog Signal & Noise, onze veelgestelde vragen en toepassingen per sector. We geven ook graag een demo van het product of verkennen samen hoe Skimle bij uw behoeften past. Lees meer over het bedrijf achter Skimle