Akademicka rzetelność w tempie AI
Skimle został stworzony przez naukowców dla naukowców. Współzałożyciel, profesor Henri Schildt, ma dziesięciolecia doświadczenia w badaniach jakościowych i publikacje w czołowych czasopismach z zarządzania, w tym Academy of Management Journal i Organization Science. Miał dość powolnych, niewygodnych procesów w NVivo i MAXQDA i niepokoił go sposób, w jaki ChatGPT jest używany do analiz pozbawionych przejrzystości i kompletności. Dlatego zbudował Skimle jako platformę, która odwzorowuje rzetelną, przejrzystą metodologię jakościową, ale z AI u podstaw.
Wstępne ręczne kodowanie wywiadów może trwać tygodniami. Skimle wykonuje je bez rezygnacji z rzetelności metodologicznej, często wychwytując cytaty, które człowiek by przeoczył. Każdy temat jest powiązany ze zweryfikowanym dosłownym cytatem. Pełna ścieżka audytu zadowala recenzentów.
Materiały dydaktyczne →Rzetelna analiza, dzięki której możesz skupić się na wkładzie teoretycznym
Podejście Skimle inspirowane jest teorią ugruntowaną (Glaser & Strauss; Strauss & Corbin) i metodą Gioi. Daje systematyczną, przejrzystą analizę, jakiej wymaga recenzja naukowa, bez tygodni mechanicznego kodowania, które pochłaniają czas lepiej poświęcony teorii. Działa w ponad 100 językach i obsługuje do 1000 dokumentów w projekcie.
- Automatyczne wstępne kodowanie: każdy cytat powiązany ze swoją kategorią
- Pełna dwukierunkowa ścieżka audytu na potrzeby recenzji i przejrzystości metod
- System kategorii pod twoją kontrolą: swobodnie scalaj, dziel, zmieniaj nazwy i reorganizuj kategorie
- Działa w ponad 100 językach bez tłumaczenia
- Obsługuje wywiady, audio i wideo, książki, dokumenty i materiały archiwalne
- Dostępny Skimle Academic, plan ze zniżką
Transkrybuj i anonimizuj wywiady
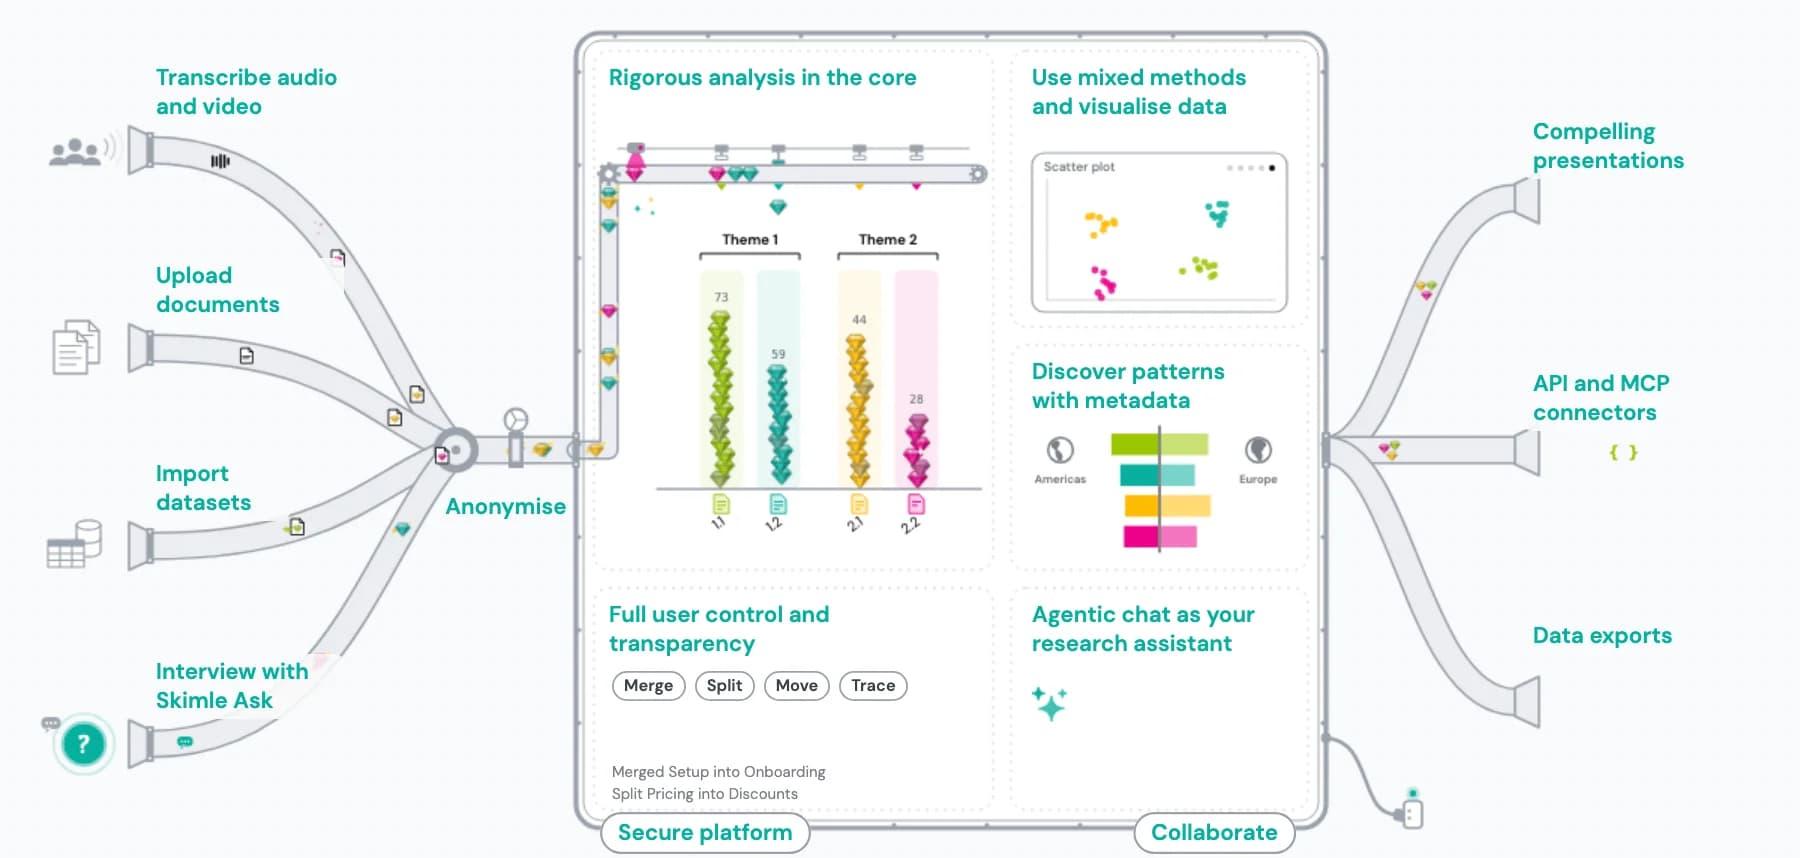
Zamiana nagrań terenowych w użyteczne dane przez zewnętrzną usługę jest powolna i kosztowna, a transkrypcje zawierają nazwiska, afiliacje i miejsca, które rodzą obowiązki wynikające z RODO i zasad etyki, zanim będzie można je udostępnić, zarchiwizować lub cytować. Skimle transkrybuje audio i wideo w swoim bezpiecznym środowisku hostowanym w UE, a następnie anonimizuje je pseudonimizacją na poziomie badawczym, dzięki czemu jeszcze tego samego dnia masz zgodną z przepisami transkrypcję gotową do kodowania, a dane nigdy nie opuszczają infrastruktury zgodnej z RODO.
Jak to działa
- 1. Prześlij audio, wideo lub tekst
Przesyłaj bezpośrednio pliki MP3, M4A, WAV, MP4, MOV, PDF lub Word. Bez zewnętrznej usługi transkrypcji, z natywną obsługą ponad 100 języków.
- 2. Transkrybuj z oznaczeniem mówców
Skimle transkrybuje nagranie, rozpoznaje zmiany mówców i radzi sobie z akcentami oraz różną jakością dźwięku. Przejrzyj i popraw wynik przed rozpoczęciem analizy.
- 3. Automatycznie wykryj identyfikatory
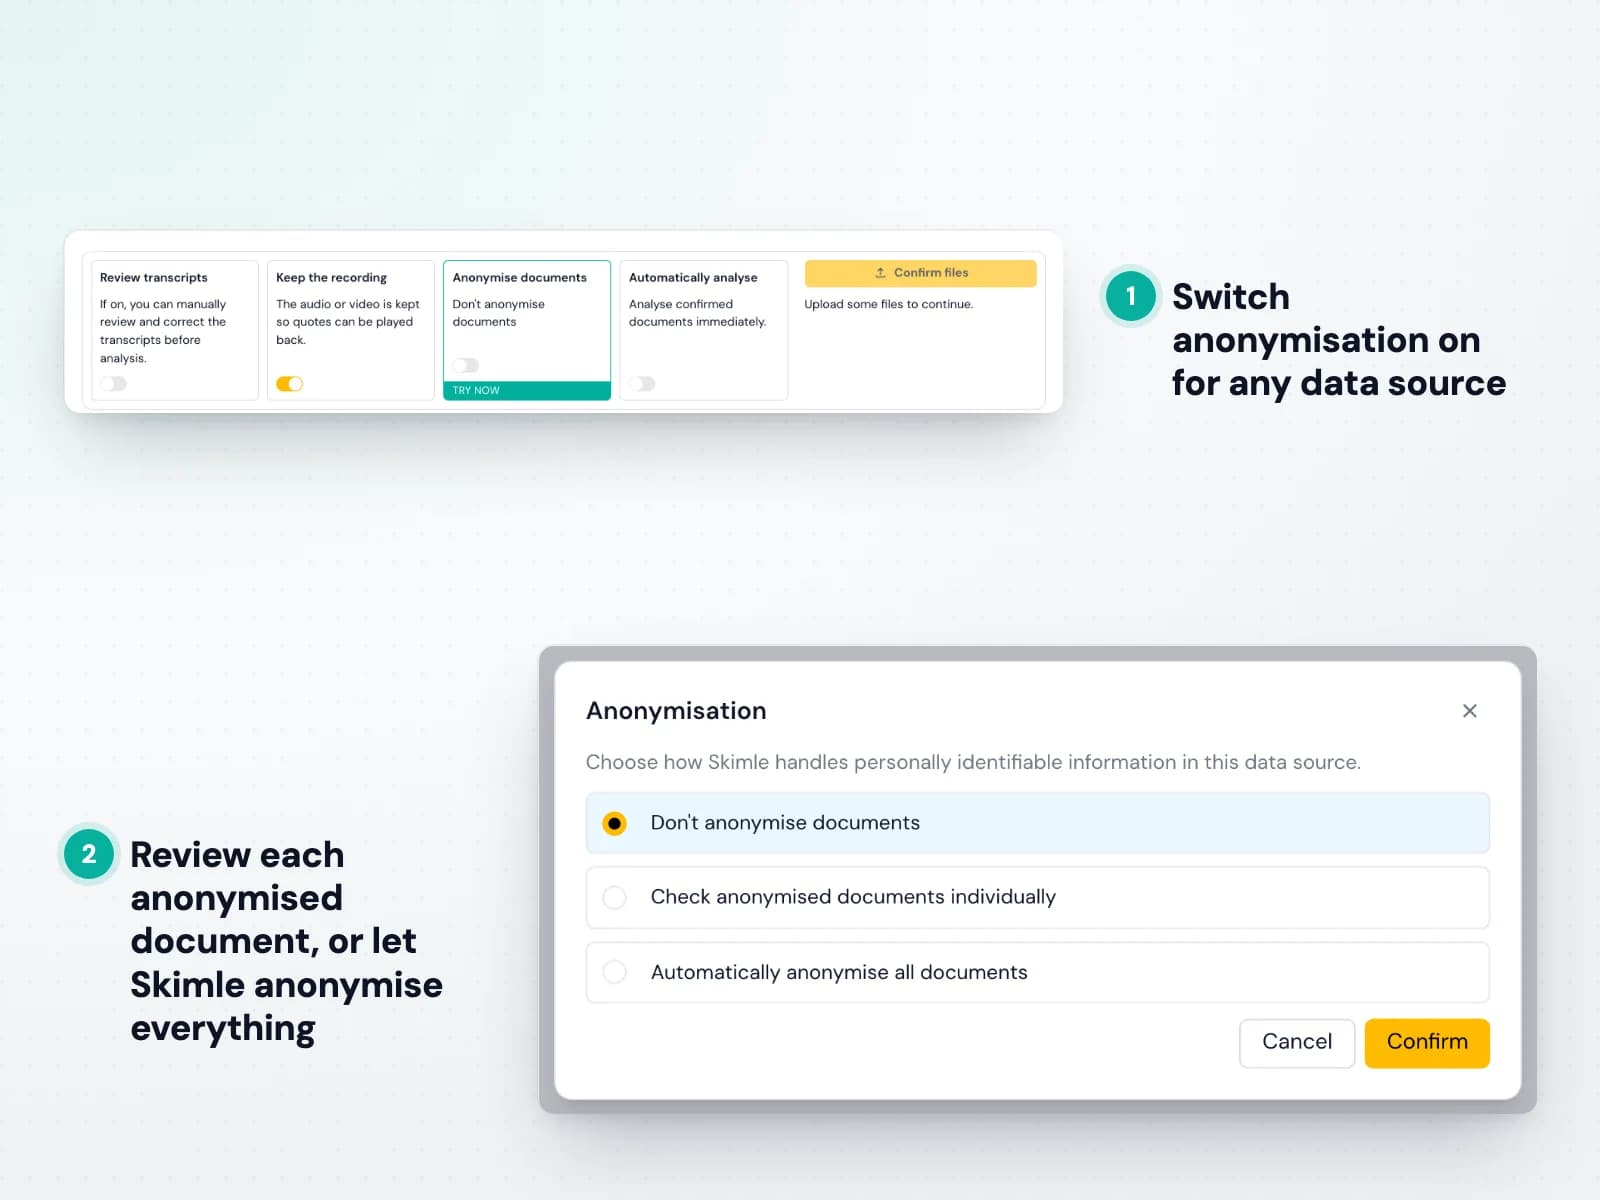
Skimle Anonymise oznacza identyfikatory w sześciu kategoriach (imiona i nazwiska, tytuły i stanowiska, miejsca, organizacje, daty i inne) w każdym dokumencie, spójnie we wszystkich plikach, dzięki czemu ta sama osoba zachowuje ten sam pseudonim.
- 4. Wybierz poziom anonimizacji
Wybierz lekką pseudonimizację, silną pseudonimizację lub anonimizację na poziomie HIPAA ze zniszczeniem klucza. Dostosuj każdą kategorię osobno i dodawaj własne reguły zwykłym językiem.
- 5. Eksportuj z dokumentacją audytu
Wyeksportuj raport audytowy w PDF i tabelę zamian w Excelu dla komisji etycznej, a następnie przekaż oczyszczoną transkrypcję prosto do procesu analizy w Skimle. Nagranie źródłowe jest potem bezpiecznie usuwane.

Przeprowadź analizę jakościową wywiadów wspieraną przez AI
Badania oparte na ponad 40 wywiadach powinny przynieść bogaty wkład teoretyczny (na przykład w doktoracie), ale ręczne kodowanie (zaznaczanie, porządkowanie, przekodowywanie, prowadzenie zestawień) pochłania większość dostępnego czasu i wciąż może pominąć ważne wzorce. Skimle systematycznie czyta każdy wywiad i daje ci uporządkowaną hierarchię tematów z dołączonymi dosłownymi cytatami, dzięki czemu możesz poświęcić czas na interpretację teoretyczną, której nikt poza tobą nie wykona.
Jak to działa
- 1. Prześlij transkrypcje
Przeciągnij transkrypcje wywiadów jako pliki PDF, Word lub zwykły tekst. Skimle przyjmuje dokumenty w dowolnym formacie i natywnie obsługuje ponad 100 języków.
- 2. Opisz pytanie badawcze
Określ swój cel analityczny, szeroko lub wąsko. Skimle porządkuje wstępne kodowanie wokół tego, co próbujesz zrozumieć teoretycznie.
- 3. Przejrzyj wstępną strukturę kodów
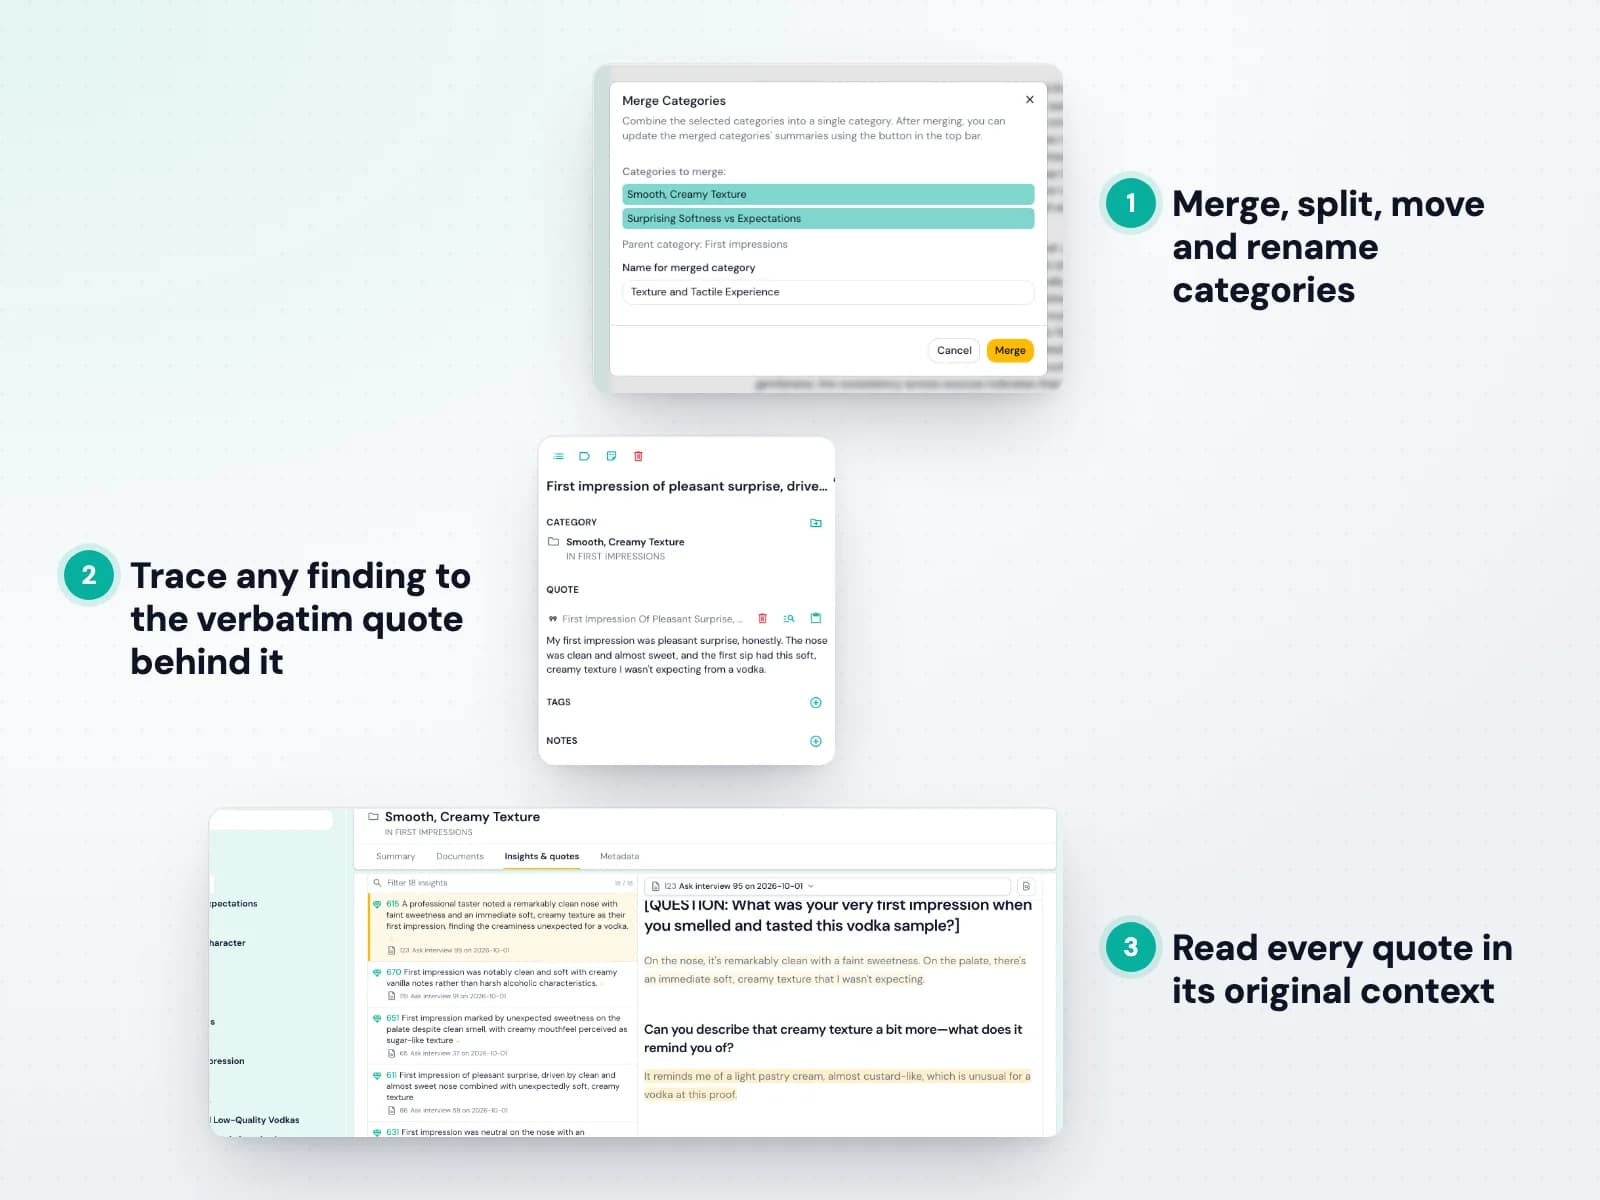
Skimle tworzy hierarchię tematów, z których każdy jest powiązany z dosłownymi cytatami z transkrypcji źródłowych. Nic nie jest zmyślone. Każdy kod prowadzi do tekstu.
- 4. Dopracuj ją pod swoje ramy teoretyczne
Scalaj, dziel, zmieniaj nazwy i reorganizuj kategorie, aby pasowały do wyłaniającego się modelu teoretycznego. Dwukierunkowa przejrzystość pozwala w każdej chwili sprawdzić, które cytaty potwierdzają które kody.
- 5. Eksportuj do aneksu metodologicznego
Wyeksportuj system kategorii i potwierdzające go cytaty jako tekst lub w otwartym formacie REFI-QDA (.qdpx), obsługiwanym przez tradycyjne programy CAQDAS, takie jak NVivo, ATLAS.ti czy MAXQDA.
Przeprowadź analizę metodami mieszanymi w całej próbie
Wyniki jakościowe mają większą wagę, gdy możesz pokazać, jak różnią się w próbie: według kohorty, roli, płci, miejsca czy warunku. Ręczne zestawianie tematów z cechami uczestników jest żmudne i łatwo o błąd. Skimle przypisuje metadane do każdego dokumentu i pozwala segmentować tę samą strukturę tematów według dowolnej zmiennej, dzięki czemu przechodzisz między bogatymi dosłownymi cytatami a skwantyfikowanymi wzorcami bez porzucania żadnej z metodologii.
Jak to działa
- 1. Przypisz metadane do dokumentów
Oznacz każdą transkrypcję zmiennymi istotnymi dla twojego planu badania (kohorta, rola, płeć, miejsce, fala badania lub warunek eksperymentalny), ręcznie albo na podstawie kolumny z pliku CSV.
- 2. Przeprowadź analizę jakościową
Skimle buduje jedną hierarchię tematów dla wszystkich dokumentów, dzięki czemu każdy uczestnik jest kodowany według tej samej struktury.
- 3. Segmentuj tematy według zmiennej
Zobacz, jak każdy temat różni się między grupami, i dostrzeż, gdzie wzorzec jest uniwersalny, a gdzie dotyczy tylko jednej kohorty.
- 4. Określ liczbowo częstość występowania
Odczytuj częstości i rozkłady tematów, aby raportować, jak często dany kod występuje w każdym segmencie. Każde zliczenie da się prześledzić do cytatów, z których powstało.
- 5. Eksportuj tabele i cytaty
Eksportuj tabele krzyżowe i potwierdzające cytaty do Excela lub Worda na potrzeby części artykułu poświęconej metodom mieszanym.

Najczęściej zadawane pytania
- Czy mogę cytować Skimle w swoich badaniach?
- Tak. W części metodologicznej opisz go jako „oprogramowanie do kodowania jakościowego wspieranego przez AI”, tak jak w przypadku NVivo lub MAXQDA. Artykuł metodologiczny, który zapewni formalne źródło do cytowania, jest w recenzji, a do tego czasu na prośbę możemy zaproponować sformułowanie.
- Czy recenzenci zaakceptują analizę wspieraną przez AI?
- Coraz częściej tak, pod warunkiem rzetelnej dokumentacji. Ścieżka audytu w Skimle daje recenzentom to, czego oczekują: udokumentowany, systematyczny proces kodowania, w którym każdy temat można prześledzić do konkretnych cytatów, więc część metodologiczna w dużej mierze pisze się sama.
- Jak Skimle wypada w porównaniu z NVivo czy MAXQDA?
- NVivo i MAXQDA sprawdzają się u badaczy, którzy mają tygodnie na analizę i licencję instytucjonalną. Skimle automatyzuje mechaniczny etap kodowania (z tygodni do godzin), zachowując tę samą systematyczną, przejrzystą metodologię, a nauka zajmuje minuty. Wielu badaczy korzysta z obu: ze Skimle do pierwszego etapu kodowania, z NVivo do integracji metod mieszanych.
- Czy Skimle nadaje się do teorii ugruntowanej?
- Tak. Skimle obsługuje kodowanie indukcyjne, w którym tematy wyłaniają się z danych, a nie są narzucane z góry. Zacznij od szerokiego ujęcia i pozwól, by struktura kategorii rozwijała się iteracyjnie, co odpowiada otwartemu kodowaniu w teorii ugruntowanej.
- Czy mogę przeprowadzić analizę metodami mieszanymi?
- Tak. Przypisz do każdego dokumentu zmienne metadanych (kohorta, rola, płeć, miejsce, warunek) i segmentuj strukturę tematów według dowolnej z nich. Otrzymasz częstości i rozkłady tematów według grup, każde możliwe do prześledzenia do dosłownych cytatów, gotowe do części artykułu poświęconej metodom mieszanym.
- Czy moje dane badawcze są bezpieczne?
- Twoje transkrypcje są przetwarzane w infrastrukturze hostowanej w UE i nigdy nie służą do trenowania modeli AI. Na potrzeby instytucjonalnych wymogów etycznych zawieramy umowy powierzenia przetwarzania danych i spełniamy większość wymagań bezpieczeństwa IT. Skontaktuj się z nami w sprawie konkretnych wymagań.
- Czy mogę dostać zniżkę akademicką?
- Tak. Naukowcy z ważnym adresem e-mail instytucji i stroną z afiliacją mogą kupić pakiet Skimle Academic ze zniżką. Jeśli potrzebujesz dostępu zespołowego dla grupy badawczej lub laboratorium, skontaktuj się z nami w sprawie licencji instytucjonalnej.
Stworzony dla profesjonalistów przez profesjonalistów
Skimle ma ponad 1500 zadowolonych użytkowników na ponad 50 uczelniach, w instytucjach publicznych, agencjach i firmach. Wszystkie dane są przechowywane w UE i przetwarzane zgodnie z naszą rygorystyczną polityką RODO i warunkami korzystania z usługi.
Chcesz dowiedzieć się więcej? Zajrzyj na blog Signal & Noise, do FAQ i do opisów zastosowań w poszczególnych branżach. Chętnie też zaprezentujemy produkt lub sprawdzimy, jak Skimle może odpowiedzieć na twoje potrzeby. Dowiedz się więcej o firmie stojącej za Skimle