以 AI 的速度,達到學術等級的嚴謹
Skimle 由學者為學者打造。共同創辦人 Henri Schildt 教授擁有數十年的質性研究經驗,論文發表於 Academy of Management Journal 與 Organization Science 等頂尖管理學期刊。他受夠了 NVivo 與 MAXQDA 緩慢笨重的工作流程,也擔心 ChatGPT 被用於缺乏透明度與完整性的分析。因此他打造了 Skimle:一個重現嚴謹、透明質性方法,並以 AI 為核心的平台。
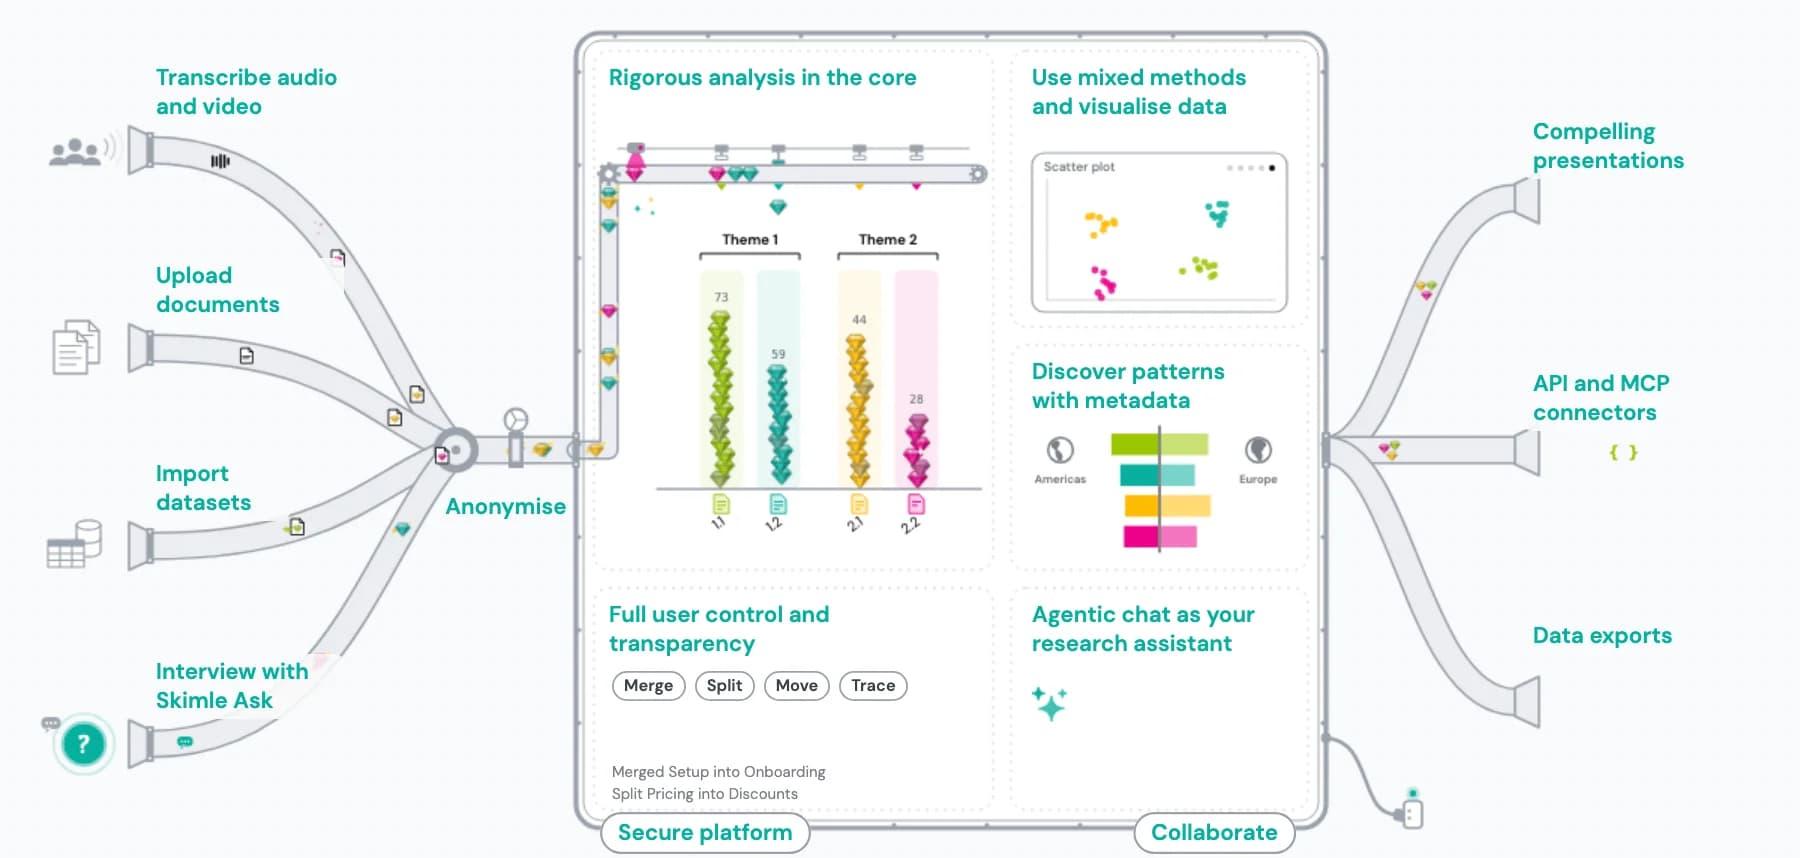
人工進行訪談的初步編碼可能要花上好幾週。Skimle 能在不犧牲方法嚴謹的情況下完成,而且常能找到人工會遺漏的引文。每個主題都連結到經過核實的逐字引文。完整的稽核軌跡能讓審稿人滿意。
教學教材 →嚴謹的分析,讓您專注於理論貢獻
Skimle 的做法受紮根理論(Glaser & Strauss;Strauss & Corbin)與 Gioia 方法啟發。它能產出同儕審查所要求的系統化、透明分析,省下原本耗在機械性編碼上、更適合用於理論思考的數週時間。支援 100 多種語言,每個專案最多可處理 1,000 份文件。
- 自動化初步編碼:每則引文都連結到其類別
- 完整的雙向稽核軌跡,支援同儕審查與方法透明
- 由您掌控的類別系統:自由合併、拆分、重新命名與重組類別
- 支援 100 多種語言,無需翻譯
- 可處理訪談、音訊與影片、書籍、文件與檔案資料
- 提供 Skimle Academic 優惠方案
轉錄並匿名化訪談
透過第三方服務把田野錄音轉成可用資料既慢又貴,而且產出的逐字稿含有姓名、所屬單位與地點,在您能分享、封存或引用之前就帶來 GDPR 與倫理上的義務。Skimle 在歐盟託管的安全環境中轉錄音訊與影片,再以研究等級的假名化進行匿名化,讓您當天就拿到合規、可直接編碼的逐字稿,資料也從未離開符合 GDPR 的基礎設施。
運作方式
- 1. 上傳音訊、影片或文字
直接上傳 MP3、M4A、WAV、MP4、MOV、PDF 或 Word 檔案。不需要外部轉錄服務,原生支援 100 多種語言。
- 2. 轉錄並標示說話者
Skimle 會轉錄錄音、辨識說話者的轉換,並處理口音與不同的音質。分析開始前,請先檢查並修正結果。
- 3. 自動偵測識別資訊
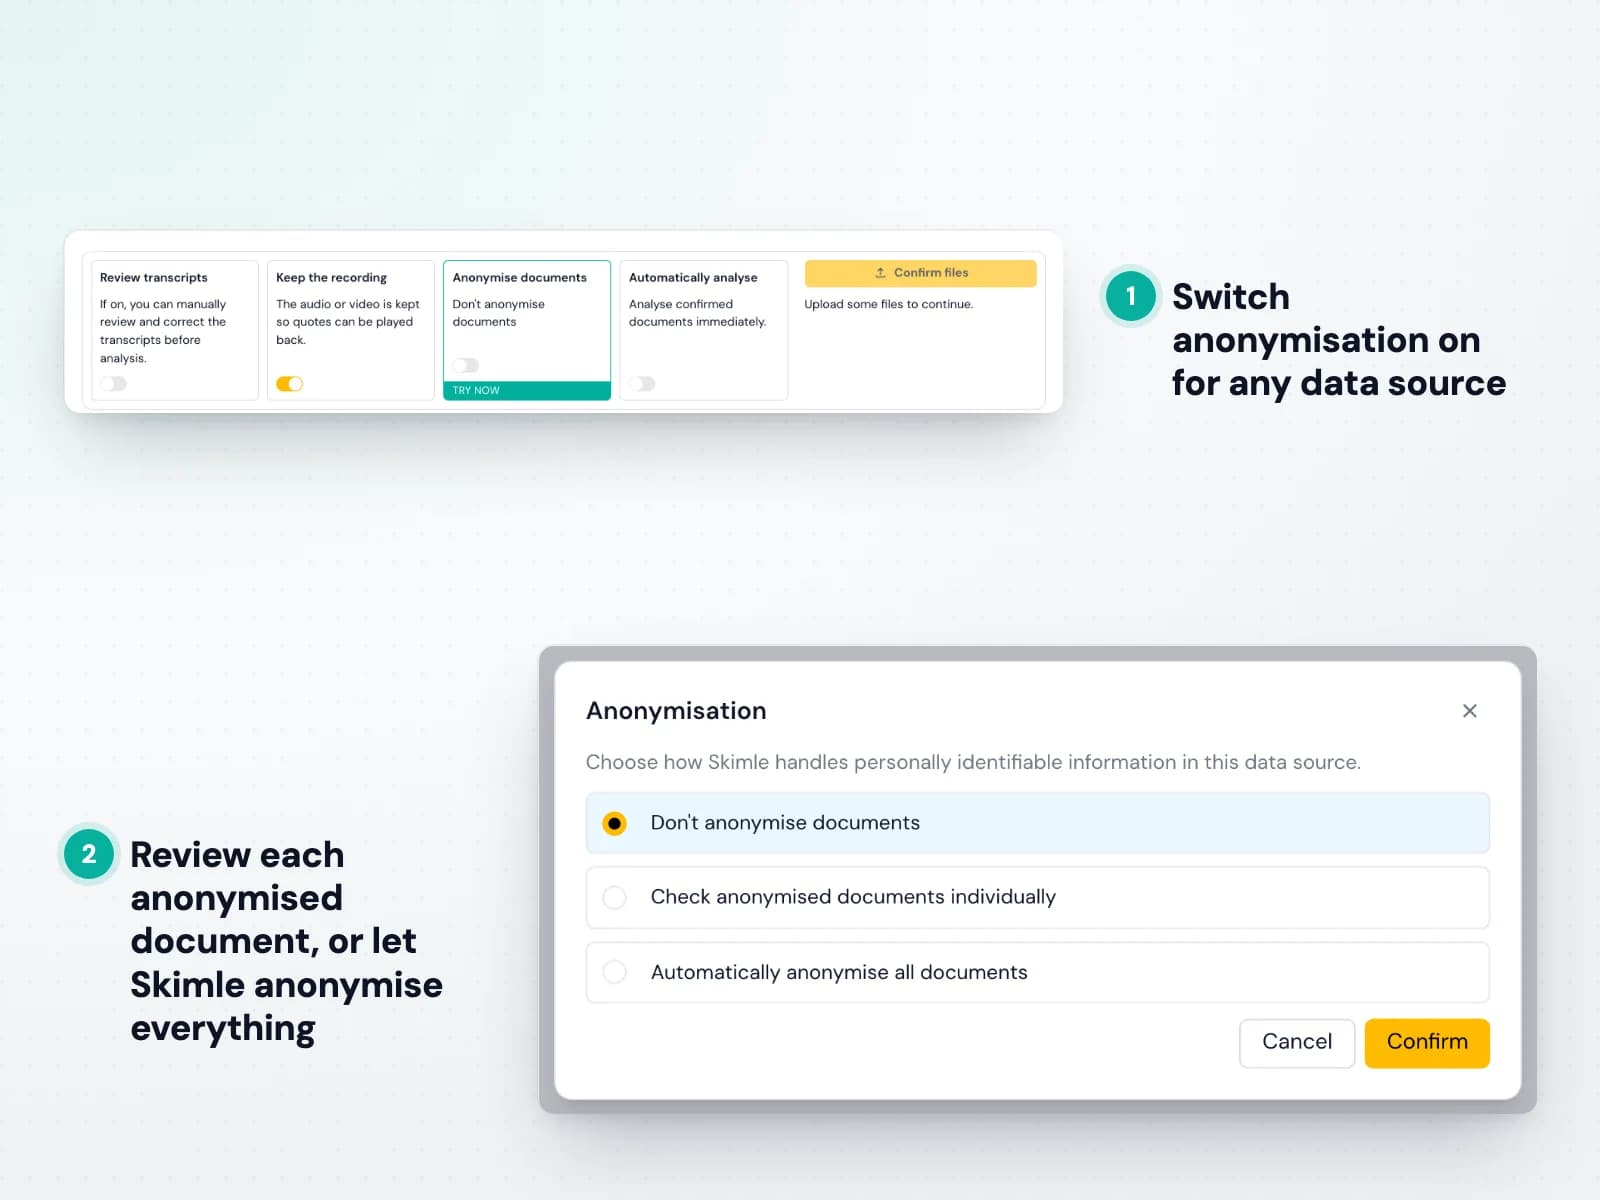
Skimle Anonymise 會在每份文件中標記六個類別的識別資訊(姓名、職稱與角色、地點、機構、日期及其他),並跨檔案保持一致,讓同一個人始終使用同一個化名。
- 4. 選擇匿名化等級
選擇輕度假名化、強度假名化,或銷毀金鑰的 HIPAA 等級匿名化。可分別調整每個類別,並以日常語言新增自訂規則。
- 5. 匯出並附上稽核文件
為倫理審查委員會匯出 PDF 稽核報告與 Excel 對照表,再將整理好的逐字稿直接送入 Skimle 的分析工作流程。原始音訊隨後會被安全刪除。

進行 AI 輔助的訪談質性分析
以 40 多場訪談為基礎的研究(例如您的博士論文)應該能產出豐富的理論貢獻,但人工編碼(標示、整理、重新編碼、建立追蹤表)會耗掉大部分可用時間,而且仍可能遺漏重要模式。Skimle 會系統化地閱讀每一份訪談,提供附有逐字引文的結構化主題階層,讓您把時間花在只有您能提供的理論詮釋上。
運作方式
- 1. 上傳逐字稿
拖曳 PDF、Word 或純文字格式的訪談逐字稿。Skimle 接受任何格式的文件,並原生支援 100 多種語言。
- 2. 描述研究問題
設定分析焦點,可寬可窄。Skimle 會圍繞您在理論上想理解的問題來建構初步編碼。
- 3. 檢視初步的代碼結構
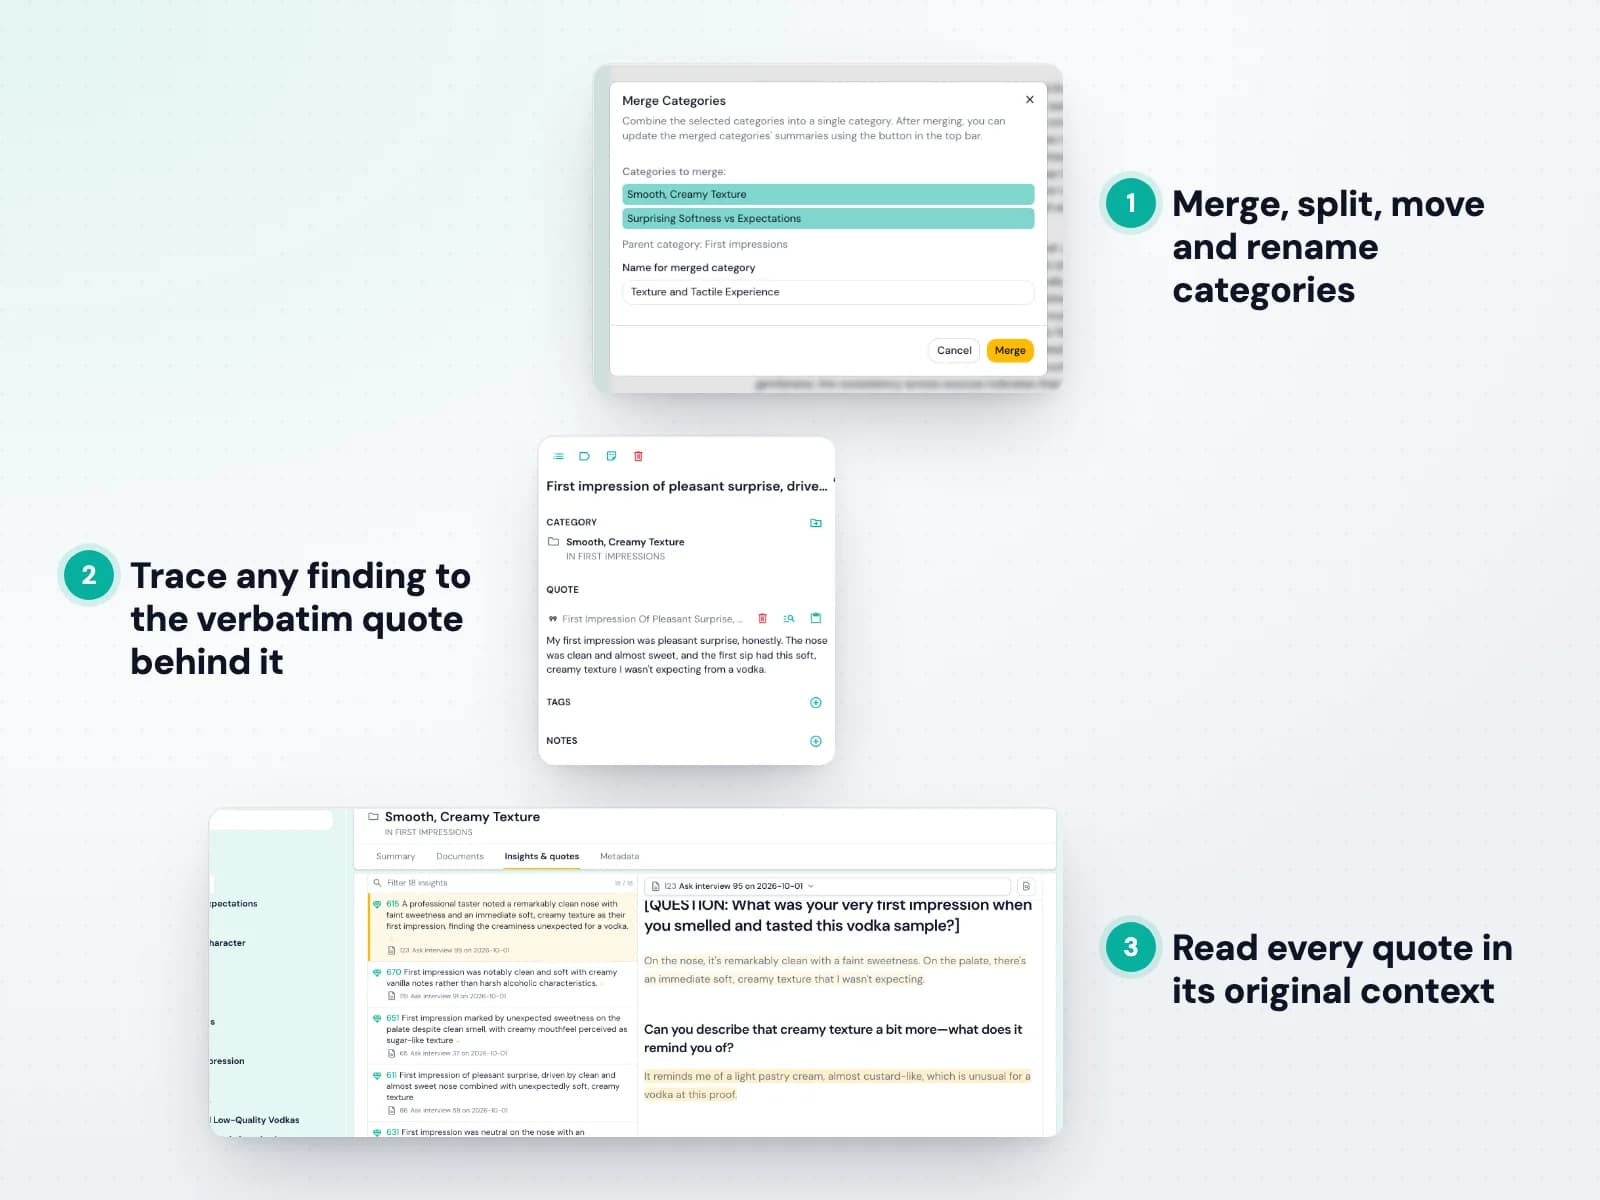
Skimle 會產出主題階層,每個主題都連結到來源逐字稿中的逐字引文。沒有任何捏造。每個代碼都能追溯到原文。
- 4. 依您的理論框架調整
合併、拆分、重新命名與重組類別,使其符合逐漸成形的理論模型。雙向透明讓您隨時確認哪些引文支持哪些代碼。
- 5. 匯出供方法附錄使用
將類別系統與佐證引文匯出為文字,或匯出為 NVivo、ATLAS.ti、MAXQDA 等傳統 CAQDAS 軟體支援的開放原始碼 REFI-QDA(.qdpx)格式。
在整個樣本中進行混合方法分析
若能呈現質性發現在樣本中如何變化(依世代、角色、性別、地點或條件),發現就更有份量。用人工將主題與受訪者屬性交叉分析既繁瑣又容易出錯。Skimle 會為每份文件附上元資料,讓您依任何變數區隔同一套主題結構,在豐富的逐字引文與量化模式之間自由切換,不必捨棄任何一種方法。
運作方式
- 1. 為文件附上元資料
為每份逐字稿標上對研究設計重要的變數(世代、角色、性別、地點、波次或實驗條件),可手動標記或從 CSV 欄位匯入。
- 2. 執行質性分析
Skimle 會為整個語料建立單一主題階層,讓每位受訪者都依同一套結構編碼。
- 3. 依變數區隔主題
查看每個主題在不同群體間的差異,找出哪些模式是普遍的,哪些只屬於某個世代。
- 4. 量化普遍程度
檢視主題的頻率與分布,報告某個代碼在各區隔中的普遍程度,每一個計數都能追溯到產生它的引文。
- 5. 匯出表格與引文
將交叉分析表與佐證引文匯出至 Excel 或 Word,用於論文的混合方法章節。

常見問題
- 我可以在研究中引用 Skimle 嗎?
- 可以。請在方法章節中將其描述為「AI 輔助質性編碼軟體」,就像引用 NVivo 或 MAXQDA 一樣。我們有一篇正在同儕審查中的方法論文,未來將提供正式的引用文獻;在此之前,如有需要我們可以提供建議的引用寫法。
- 同儕審查會接受 AI 輔助的分析嗎?
- 只要有適當的記錄,答案越來越是肯定的。Skimle 的稽核軌跡提供審稿人期待的內容:有記錄、系統化的編碼流程,每個主題都能追溯到具體引文,方法章節幾乎就能自然寫成。
- Skimle 和 NVivo 或 MAXQDA 相比如何?
- NVivo 與 MAXQDA 適合有數週時間做分析、且有機構授權的研究者。Skimle 將機械性的編碼階段自動化(從數週縮短到數小時),同時保留同樣系統化、透明的方法,而且幾分鐘就能上手。許多研究者兩者並用:用 Skimle 做初步編碼,用 NVivo 整合混合方法。
- Skimle 適用於紮根理論嗎?
- 適用。Skimle 支援歸納式編碼,讓主題從資料中浮現,而不是事先強加。從寬廣的焦點開始,讓類別結構反覆發展,這與紮根理論中的開放編碼非常接近。
- 我可以進行混合方法分析嗎?
- 可以。為每份文件附上元資料變數(世代、角色、性別、地點、條件),並依其中任何一項區隔主題結構。您會得到各群體的主題頻率與分布,每一項都能追溯到逐字引文,可直接用於論文的混合方法章節。
- 我的研究資料安全嗎?
- 您的逐字稿在歐盟託管的基礎設施上處理,絕不用於訓練 AI 模型。我們提供資料處理協議以符合機構的倫理審查要求,也能配合大多數 IT 資安需求。如有特殊需求,請與我們聯絡。
- 我可以享有學術優惠嗎?
- 可以。擁有有效機構電子郵件與所屬單位頁面的學術人員,可以購買 Skimle Academic 優惠方案。如果研究團隊或實驗室需要團隊存取權,請與我們聯絡洽談機構授權。
由專業人士打造,服務專業人士
Skimle 擁有超過 1,500 名滿意的使用者,遍及 50 多所大學、政府機關、代理商和企業。所有資料均儲存於歐盟境內,處理方式請參閱我們嚴格的 GDPR 政策 與 服務條款.
想了解更多?歡迎瀏覽我們的 Signal & Noise 部落格、我們的 常見問題,以及依產業劃分的應用情境。我們也很樂意為您示範產品,或一起探討 Skimle 如何契合您的需求。 了解 Skimle 背後的公司