Hver respondent hørt. Hver innsikt sporbar. Hver frist holdt.
Laget for markedsanalysebyråer som leverer til kunder, og for interne kundeinnsiktsteam som leverer til virksomheten. Begge står i samme klemme: kvalitative data er det rikeste signalet du har, og det er altfor mye av det til å lese nøye for hånd. Byråene blir bedt om dypere innsikt på kortere tid til lavere honorarer. Interne team skal holde tritt med produkt- og forretningsbeslutninger som ikke kan vente fjorten dager.
Skimle gjør den mekaniske kodingen som spiser mesteparten av en analytikers uke. Du står for tolkningen, «so what» og anbefalingen. To uker med koding blir to dager, og nyansene overlever komprimeringen.
Analyse på profesjonelt nivå som skalerer med forskningsvolumet ditt
60 dybdeintervjuer, 8 fokusgrupper i fire markeder eller 5000 NPS-kommentarer: volumet går langt utover det som kan leses nøye for hånd, og overfladiske verktøy mister nyansene kunden eller salgsdirektøren vil spørre om. Skimle skalerer uten å ofre dybde.
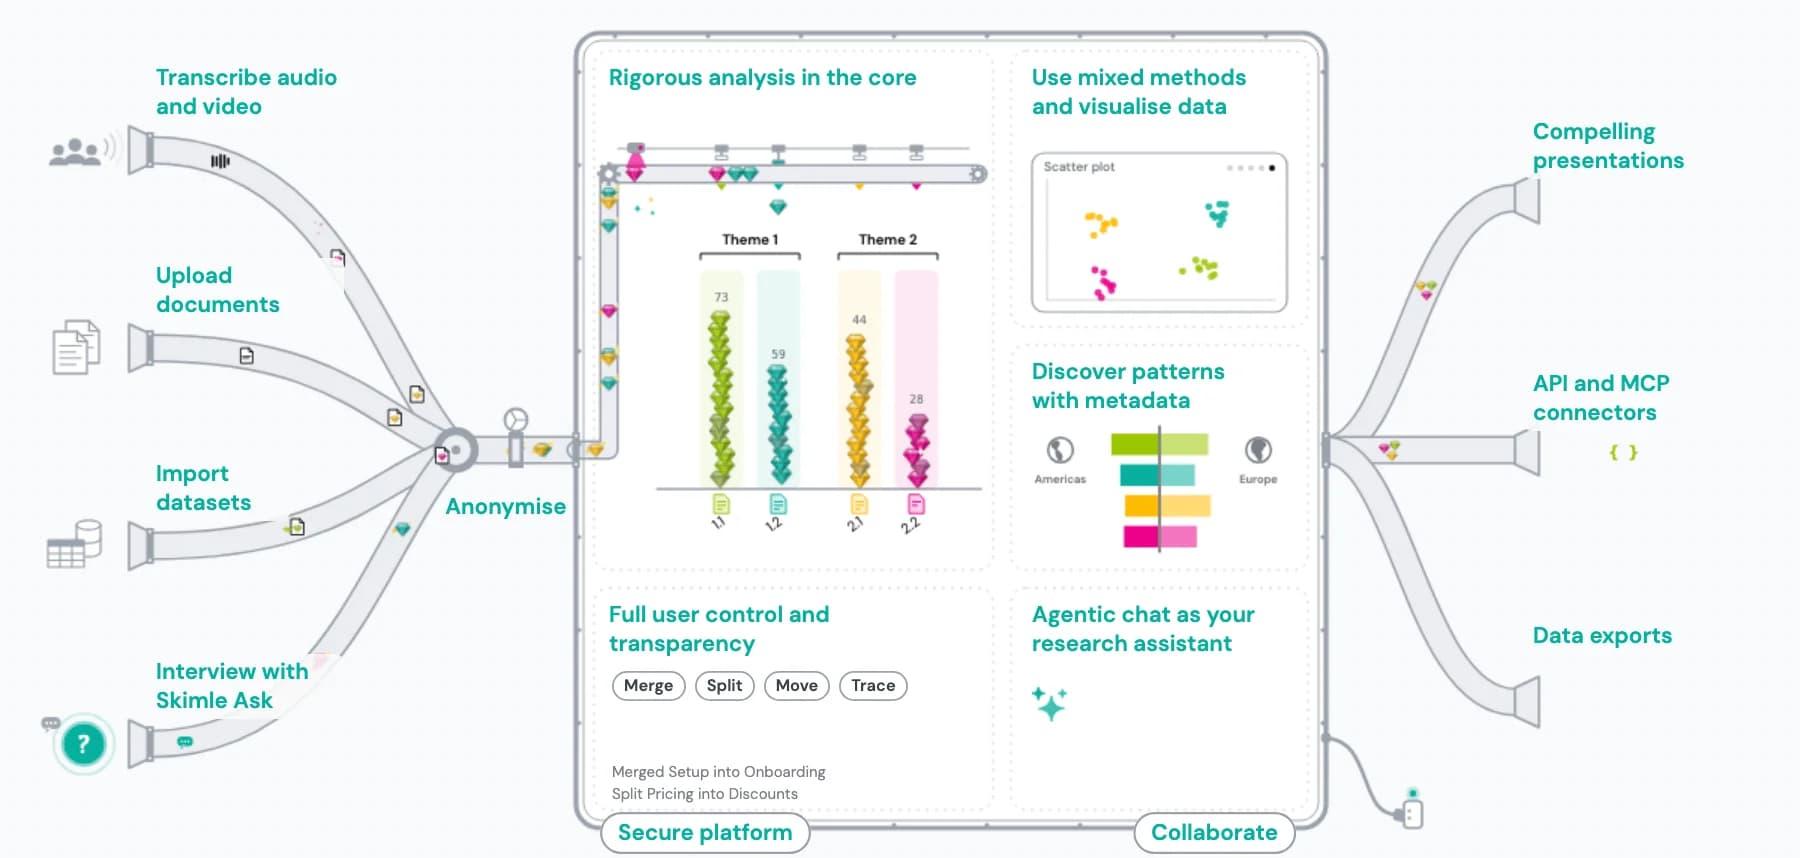
- Håndterer intervjuer, fokusgrupper, åpne spørsmål i spørreundersøkelser, anmeldelser og supportsaker i ett prosjekt
- Hvert tema knyttet til ordrette kundesitater, fra hele datasettet og ikke et utvalg
- Segmentanalyse innebygd: sammenlign på tvers av demografi, produktnivåer, geografier og NPS-grupper
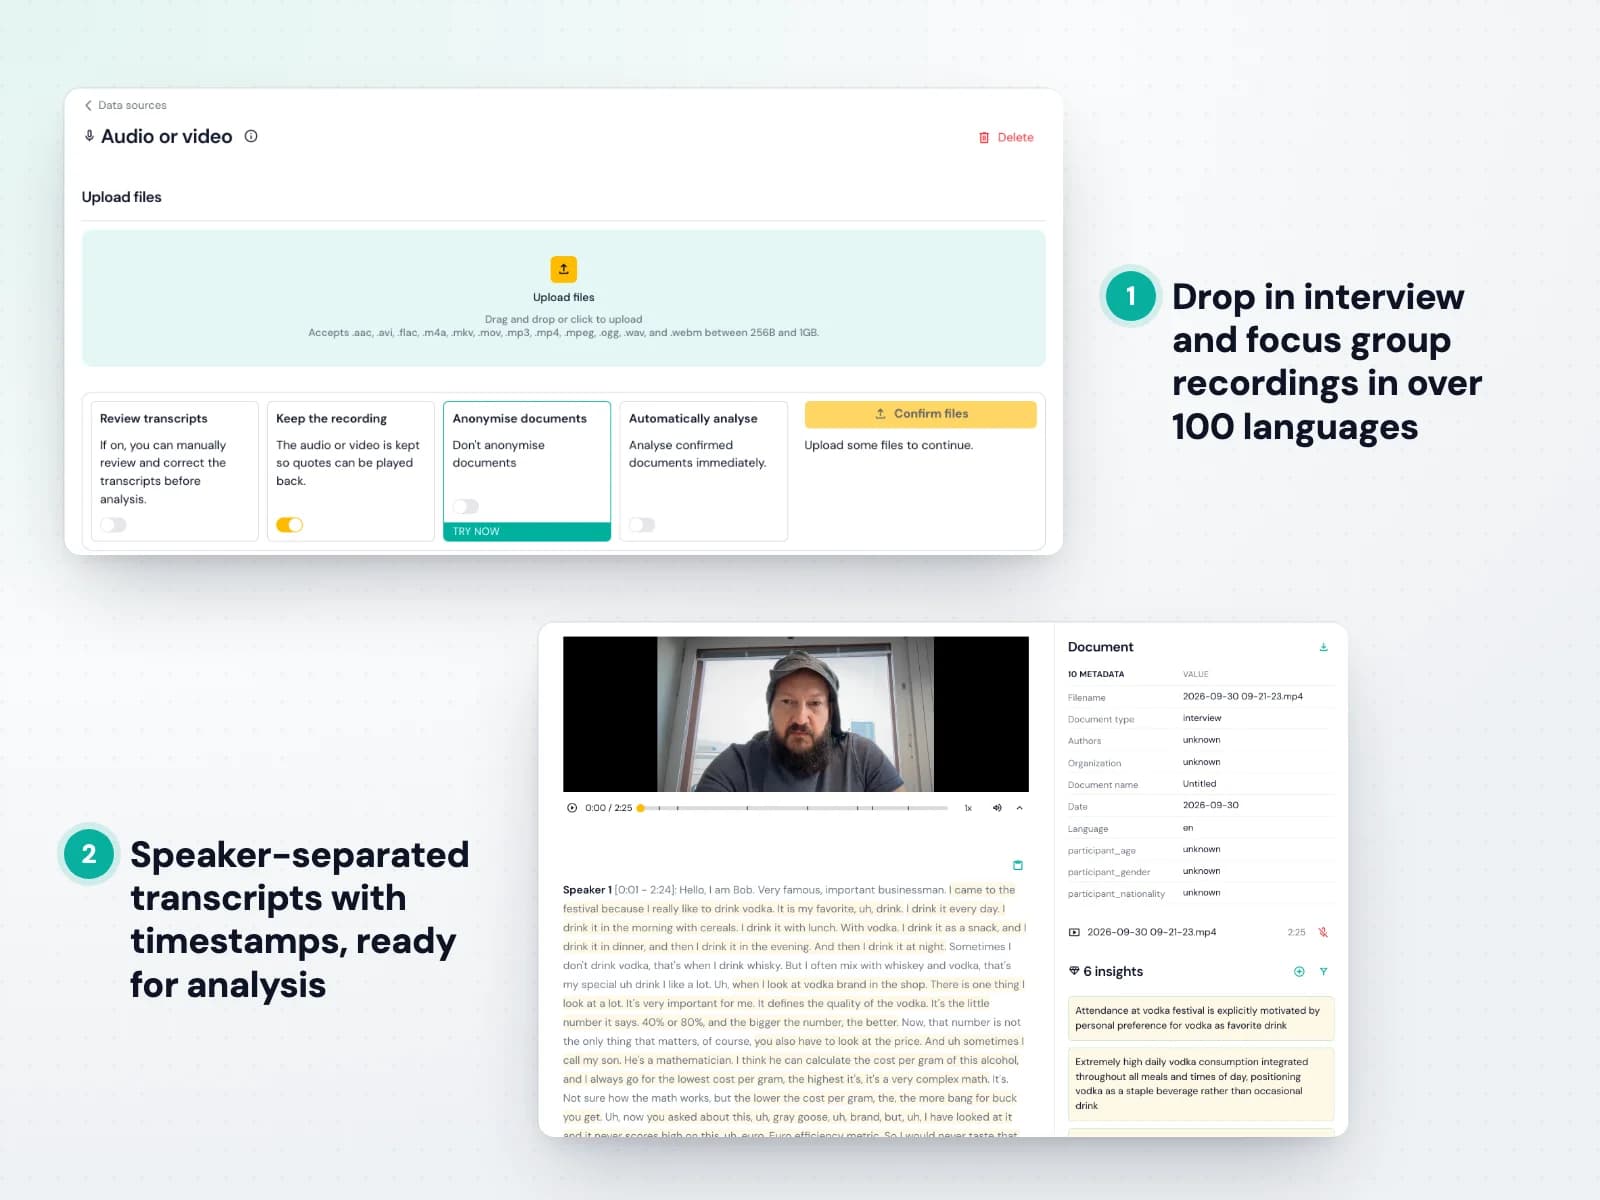
- Over 100 språk i ett prosjekt, uten oversettelsestrinn
- Presentasjonsklare eksporter til Word, PowerPoint og Excel på minutter
Analyser fokusgrupper og kundeintervjuer i stor skala
Fokusgrupper er de kvalitative dataene som er vanskeligst å analysere godt. Én frempå deltaker ser ut som fire uavhengige stemmer hvis du ikke holder oversikt over belegget. Dybdeintervjuer svikter på en annen måte: ved 20, 40 eller 60 transkripsjoner blir det flaskehalsen å kode den siste på samme måte som den første. Skimle bygger én temastruktur på tvers av alle øktene og viser hva som var konsistent, hva som varierte mellom segmenter og hva som var et enkeltstående avvik, slik at funnet holder når en kunde eller interessent protesterer.
Slik fungerer det
- 1. Importer hver økt som et dokument
Last opp transkripsjoner eller opptak fra Zoom, Teams, Otter eller Fireflies. Skimle transkriberer lyd og video direkte, slik at hver økt blir ett dokument klart til analyse.
- 2. Kjør analysen på tvers av alle øktene
Skimle leser hver transkripsjon og bygger temaer ut fra innholdet i alle øktene. Det finner ut hva som faktisk ble diskutert, i stedet for å tvinge fram et forhåndsbestemt kategorisystem.
- 3. Se hva som var konsistent og hva som varierte
Hvert tema viser hvilke grupper som bidro til det og hvor ofte, og skiller det universelle signalet fra én økt eller ett marked.
- 4. Vurder hvordan belegget fordeler seg
Klikk på et tema for å lese sitatene som støtter det og se hvilke økter de kom fra. Vurder effekten av dominerende stemmer direkte i stedet for etter hukommelsen.
- 5. Eksporter til kunden
Lag syntesedokumentet med representative sitater per gruppe, klart til presentasjonen eller hele rapporten.
Kod åpne spørsmål i spørreundersøkelser og sammenlign segmenter
Én samlet temaliste svarer aldri på spørsmålet virksomheten faktisk stilte: hvem mener dette, og hvordan varierer det mellom segmenter? Med tusenvis av åpne svar leser de fleste team et utvalg og mister minoritetssynene som gir det skarpeste signalet. Skimle koder hvert svar og lar deg dele opp den samme temastrukturen etter en hvilken som helst metadatavariabel, enten det er en NPS-gruppe, et produktnivå, et marked eller en demografisk egenskap, slik at de åpne svarene i en tracker blir en mixed methods-oversikt du kan handle ut fra.
Slik fungerer det
- 1. Last opp svar med metadata
Importer åpne svar som CSV fra SurveyMonkey, Typeform eller Qualtrics, med respondentenes metadatakolonner ved siden av, slik at hvert svar bærer med seg segmentet sitt.
- 2. Bygg hele temastrukturen
Skimle koder hvert svar inn i et temahierarki, ikke bare de vanlige, slik at minoritetssynene forblir synlige.
- 3. Segmenter etter hvilken som helst variabel
Filtrer og sammenlign temaer etter NPS-gruppe, produktnivå, geografi eller demografi for å se hvilke saker som betyr mest for hvilke kunder.
- 4. Kontroller belegget
Hvert mønster kan spores til ordrette sitater, slik at en forskjell mellom to segmenter støttes av nøyaktig de svarene som ga den.
- 5. Eksporter kundeklare resultater
Lag en tematisk rapport med ordrette sitater og krysstabeller, på minutter i stedet for dager.

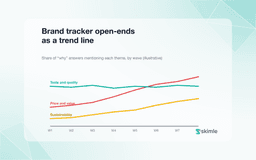
Samle alle tilbakemeldingskanaler i ett innsiktsbilde
Intervjuer, NPS-kommentarer, supportsaker, anmeldelser, opptak av salgssamtaler, gevinst- og tapsevalueringer, diskusjoner i nettsamfunn, analytiker- og konkurrentrapporter. Hver kanal får vanligvis sin egen analyse, sin egen presentasjon og sitt eget vokabular, slik at ingenting henger sammen og det samme kundeproblemet rapporteres tre ganger under tre navn. Skimle koder alle kilder mot én kategoristruktur i ett prosjekt og viser deretter hvor tungt hver kanal vektlegger det samme temaet. Byråer bruker det til å bygge skrivebordsundersøkelser og sekundærmateriale inn i en primærstudie. Interne team bruker det til et kontinuerlig bilde av kunden.
Slik fungerer det
- 1. Samle kanalene i ett prosjekt
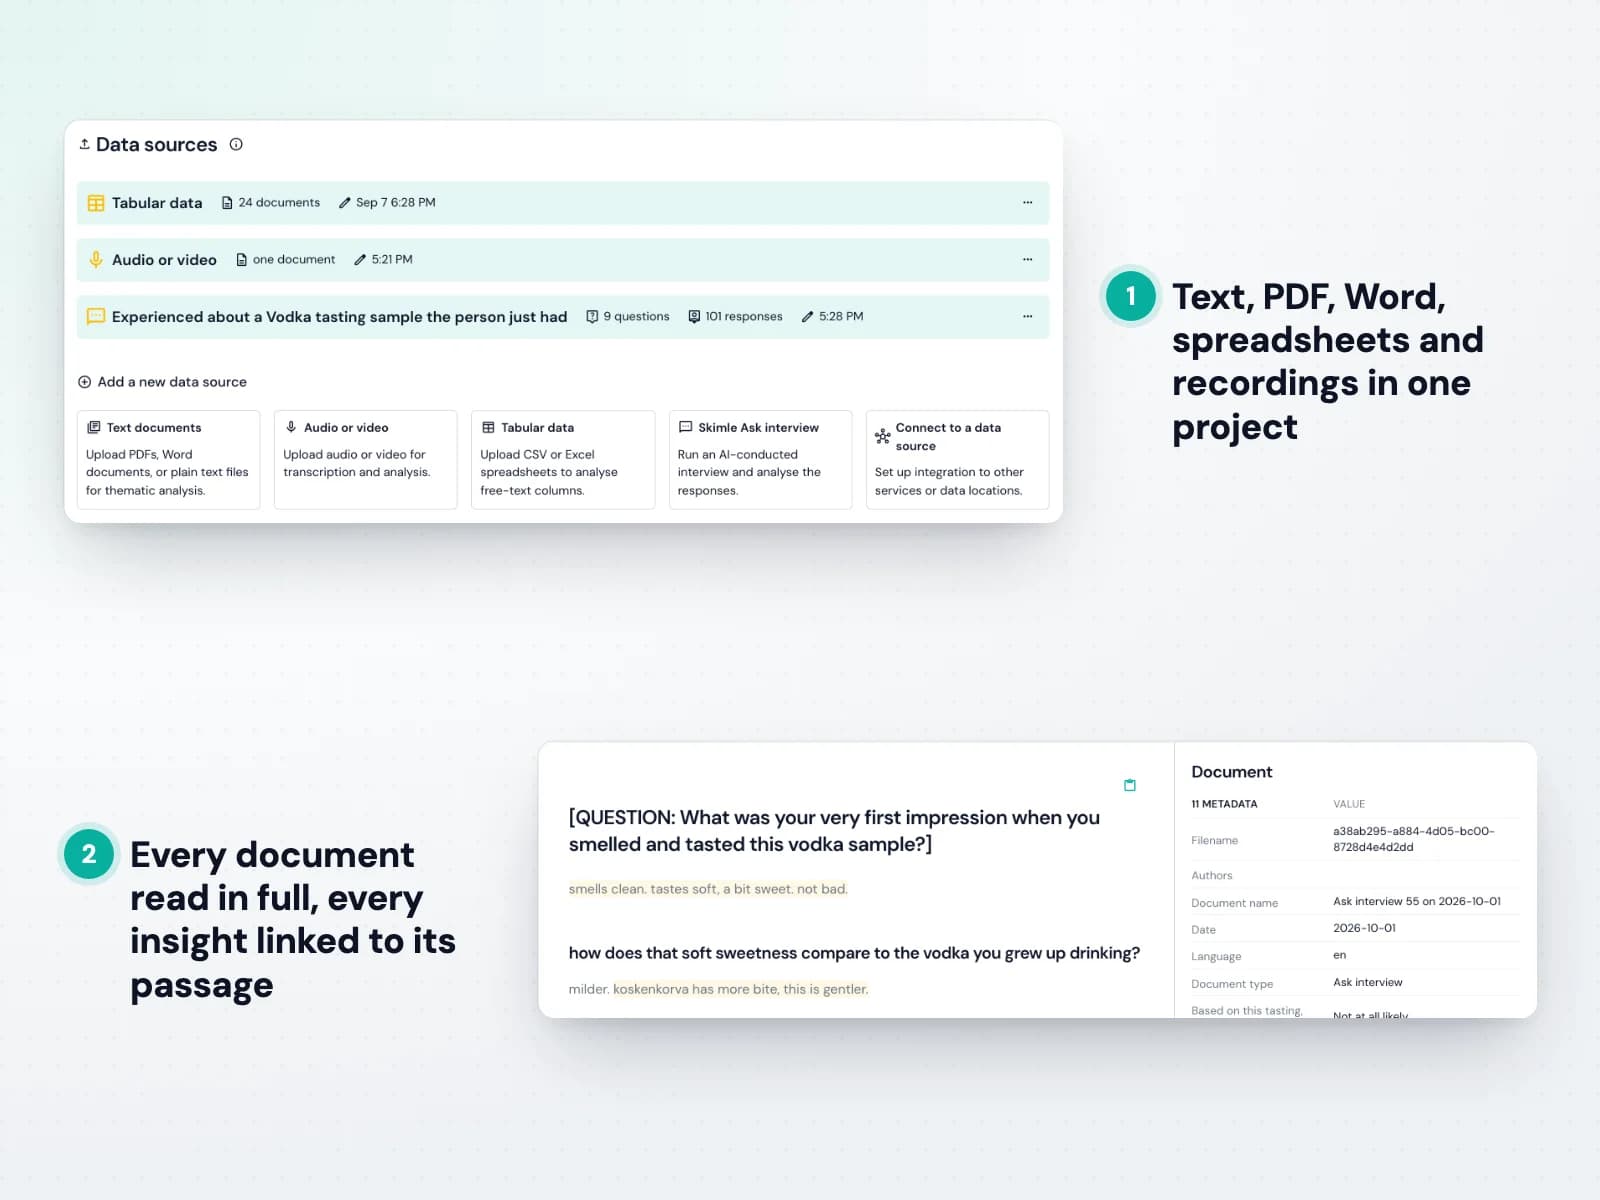
Last opp transkripsjoner, CSV-eksporter, PDF-er og opptak side om side. Eksporter fra supportsystemet, samlinger av anmeldelser, analytikerrapporter og intervjulyd blir alle dokumenter i det samme prosjektet.
- 2. Merk hvert dokument med kanalen sin
Kanal, segment, marked og dato legges inn som metadata, slik at hver senere sammenligning av kilder er et filter i stedet for en ny analyse.
- 3. Kod alt mot én struktur
Skimle bygger én temastruktur på tvers av alle kilder, eller bruker rammeverket du allerede rapporterer etter, slik at et funn betyr det samme i hver kanal.
- 4. Sammenlign hva hver kanal forteller deg
Se hvor kildene er enige og hvor de motsier hverandre. Et tema som er høylytt i supportsakene og fraværende i intervjuene er et funn, ikke et avvik som skal forklares bort.
- 5. Legg til neste runde uten å starte på nytt
Neste kvartals data kodes inn i den samme strukturen, slik at trackeren beholder sammenlignbarheten og den oppdaterte rapporten er en ny eksport i stedet for en ombygging.
Vanlige spørsmål
Dette er spørsmålene innsiktsteam og forskningsledere i byråer oftest stiller oss, inkludert de som kommer rett fra en anskaffelsesprosess. Vår leverandørnøytrale RFP-sjekkliste setter opp de samme spørsmålene du kan stille alle leverandørene du vurderer, også oss.
- Hvordan hjelper dette oss å konkurrere med billige, overfladiske alternativer?
- Lavprisleverandører og tynne AI-skall konkurrerer på pris med ordskyer og en flat temaliste. Skimle gir deg dybde i deres tempo, slik at et byrå skiller seg ut på kvaliteten i «so what» i stedet for på timeprisen, og et internt team får flere studier ut av et uendret budsjett. Analytikertimene flyttes fra mekanisk koding til tolkning, som er den delen noen faktisk betaler for. Se hvor pengene i en kvalitativ studie egentlig går →
- Hva sier vi når en kunde eller interessent stiller spørsmål ved AI-assistert analyse?
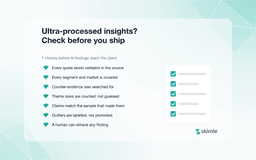
- Beskriv det presist: AI-en gjør den mekaniske kategoriseringen, en navngitt forsker gjennomgår hvert tema og skriver tolkningen. Vis deretter belegget. Hver påstand i en Skimle-rapport åpner det ordrette sitatet og dokumentet det kom fra, noe som er et sterkere svar enn manuell syntese kan gi, for der fantes kodelogikken bare i hodet til noen. 7 regler for ansvarlig bruk av AI i kvalitativ markedsanalyse →
- Analyserer Skimle hele datasettet eller et utvalg?
- Hele datasettet. Dette er verdt å spørre alle leverandører om, for flere verktøy henter en delmengde av dokumentene dine via et embeddingsøk, analyserer den og oppgir aldri hvilke dokumenter som ikke kom med. Resultatet ser ut som om det dekker hele materialet, men gjør det ikke. Skimle koder hvert dokument, og du kan åpne et hvilket som helst av dem for å se nøyaktig hvilke avsnitt som ble kodet og hvilke som ikke ble det.
- Kan vi bruke vårt eget kategorisystem, eller bare godta det AI-en lager?
- Begge deler, også på det samme materialet. Ta med et eksisterende kategorisystem, så koder Skimle deduktivt mot det, eller la det bygge strukturen induktivt ut fra dataene. Kategoriene kan slås sammen, deles opp, gis nye navn, omordnes og slettes etterpå, og analysen følger endringene dine. Byråer som kjører en tracker eller et standardrammeverk for en kunde år etter år, jobber som regel deduktivt; utforskende studier starter som regel motsatt vei.
- Hva hindrer at et oppdiktet sitat havner i rapporten vår?
- Hvert sitat kontrolleres maskinelt mot kildedokumentet. Hvis modellen lager tekst som ikke finnes ordrett i dataene dine, markerer Skimle den og behandler den på nytt i stedet for å vise den, slik at et oppdiktet sitat ikke havner i en kundepresentasjon. Du kan også åpne et hvilket som helst dokument og se hvilke avsnitt som ble kodet og hvilke som ikke ble det, og slik oppdager du den motsatte feilen, at noe er oversett. Slik fungerer åpenhet begge veier →
- Hvordan bør vi vurdere Skimle mot de andre verktøyene på listen vår?
- Kjør en pilot i stedet for å se på demoer. Ta et materiale du allerede har analysert, slik at du vet hva svaret bør være, skriv ned tre oppgaver før du begynner (én koding, én segmentsammenligning, ett søk etter belegg), ta tiden på hver av dem inkludert rettearbeidet, og vær bevisst uenig med verktøyet for å se hvor raskt du kan omstrukturere resultatet. Vi kjører gjerne ett levende prosjekt parallelt med din nåværende leverandør, og gratisversjonen lar én forsker danne seg et inntrykk på en ettermiddag før noe av dette. RFP-sjekklisten med 7 områder og en poengmal →
- Hvor mye data kan Skimle håndtere, og på hvor mange språk?
- Opptil 1000 dokumenter per prosjekt, noe som dekker alt fra en studie med 20 intervjuer til en global tracker med tusenvis av svar fra spørreundersøkelser, og over 100 språk som analyseres direkte uten oversettelsestrinn. Ett prosjekt kan blande engelsk, spansk, mandarin, tysk og arabisk, bygge én temastruktur på tvers av alt og beholde hvert sitat på originalspråket. Hvis du jevnlig ligger i øvre del av det spennet, ta kontakt med oss om volumavtaler.
- Er kundedata sikre og konfidensielle?
- Alle data lagres og behandles i EU på AWS, i et miljø konfigurert av en sertifisert tredjepart, og kundedata brukes aldri til å trene modeller. Databehandleravtaler er tilgjengelige, vi jobber under kundenes taushetserklæringer, pseudonymisering er bygget inn i arbeidsflyten, og single tenant- eller privat sky-oppsett er tilgjengelig der datasuverenitet krever det.
- Hva skjer med analysen vår hvis vi slutter å bruke Skimle?
- Du tar den med deg, i alle planer. Eksporter kodede data i det åpne REFI-QDA-formatet (.qdpx) og fortsett i NVivo, ATLAS.ti eller MAXQDA, eller ta med deg resultater i Word, PowerPoint og Excel med sitater ordnet etter tema. Vi implementerer interoperabilitetsstandarden nettopp for at det å bli skal være et valg og ikke en konsekvens.
- Hvordan fungerer prisingen når studievolumet vårt svinger?
- Skimle er et lett abonnement per bruker med en inkludert kredittkvote, pluss kredittpakker du kjøper for månedene en stor studie pågår. Abonnementet holder hele teamet i verktøyet mellom prosjektene; pakkene knytter kostnaden til prosjektet som forårsaket den, noe som betyr mye for byråer som fakturerer videre til kunder. Interessenter som bare trenger å lese funnene, trenger ikke egen lisens, for eksporter og utskrivbare forskningsrapporter dekker det.
- Kan flere forskere jobbe i det samme prosjektet?
- Ja, samtidig, og hver persons endringer og merknader bevares. Det passer for fagfellevurdering og kvalitetskontroll, og for å dele en stor studie mellom junior- og seniorforskere med én seniorleder som styrer kategoristrukturen.
Laget for fagfolk, av fagfolk
Skimle har over 1 500 fornøyde brukere ved mer enn 50 universiteter, offentlige etater, byråer og bedrifter. Alle data lagres i EU og behandles i henhold til våre strenge GDPR-retningslinjer og tjenestevilkår.
Vil du vite mer? Utforsk bloggen Signal & Noise, vanlige spørsmål og bruksområder etter sektor. Vi viser også gjerne produktet eller ser på hvordan Skimle kan passe dine behov. Les mer om selskapet bak Skimle