Oversikt over funksjonene i Skimle
Skimle er AI-native programvare for kvalitativ dataanalyse for markedsanalytikere, eksperter på kundeinnsikt, akademiske forskere, rådgivere og andre nysgjerrige fagfolk som vil gå dypere inn i dataene sine.
Last opp intervjutranskripsjoner, opptak fra fokusgrupper, tabeller med tusenvis av fritekstsvar, dokumenter eller andre kvalitative data på over 100 støttede språk. Skimles grundige nedenfra-og-opp-arbeidsflyt identifiserer innsikter og bygger en transparent kategoristruktur du kan redigere fritt. Du kan visualisere dataene med blandede metoder, oppdage mønstre ved hjelp av metadata, koble AI-agenten din til dataene via MCP, lage overbevisende presentasjoner og mye mer.
Plattformen vår inneholder også Skimle Ask, en kraftig AI-assistert spørreundersøkelsesmotor for å samle rike kvalitative innsikter i stor skala. Lag intervjuguiden din, del lenken med respondentene og samle inn data med svar i tekst, tale eller video og smarte oppfølgingsspørsmål.
Skimle forener akademisk grundighet med praktisk nytte for næringslivet. Mange AI-verktøy hopper over selve analysen og lager bare et sannsynlig, men uforsvarlig sammendrag som er utsatt for skjevheter og hallusinasjoner. Tradisjonelle verktøy som NVivo, MAXQDA eller ATLAS.ti tvinger deg til å bruke mesteparten av tiden på manuell koding i stedet for faktisk analyse. Skimle er bygget annerledes: du får en grundig, automatisert AI-arbeidsflyt for analyse med full toveis transparens og brukerkontroll.
Skimle er en komplett plattform for kvalitativ analyse
Skimle er et allsidig verktøy som lar deg…
Et animert diagram som viser hvordan Skimle fungerer. Data kommer inn gjennom fire inngangsrør: transkripsjon, dokumentopplasting, import av datasett og Skimle Ask-intervjuer. De passerer en anonymiseringsventil inn i maskinen, der innsiktene sorteres i temaer, utforskes med visualiseringer, sammenlignes på tvers av metadata og diskuteres med en AI-forskningsassistent. Resultatene går ut gjennom tre eksportrør: presentasjoner, API- og MCP-koblinger, og dataeksport.
Akademisk forskning
Litteraturgjennomgang
Importer artikler og sekundærkilder, kod temaer automatisk på tvers av hundrevis av dokumenter, og finn hull og mønstre i litteraturen på timer i stedet for uker.
Les mer →Tematisk analyse
Skimles AI identifiserer gjentakende temaer i intervjutranskripsjoner og bygger et kategoritre du kan gå gjennom, redigere og validere, der hvert tema kan spores til bestemte sitater.
Les mer →Grounded theory
Bygg teori induktivt fra rådata. Skimle koder transkripsjonene dine, løfter frem nye begreper og lar deg finjustere kategorisystemet trinnvis etter hvert som mønstrene utvikler seg.
Les mer →Induktiv koding
Start med åpen koding og la Skimle foreslå kategorier rett fra dataene dine. Gå gjennom, slå sammen og gi nytt navn til koder slik at de passer ditt analytiske perspektiv, med full kontroll hele veien.
Les mer →Deduktiv koding
Bruk et forhåndsdefinert kategorisystem på materialet ditt. Skimle matcher kategoriene dine mot nye data med full innsikt i hvilke sitater som utløste hver kode.
Les mer →Blandede metoder
Kombiner kvantitative metadata med kvalitative temaer. Krysstabuler kodekategorier mot respondentenes demografi for å finne statistisk meningsfulle mønstre.
Les mer →
Markedsanalyse og kundeinnsikt
Kvalitativ markedsanalyse
Gjennomfør og analyser dybdeintervjuer, fokusgrupper og fritekstsvar på ett sted: hele arbeidsflyten for kvalitativ markedsanalyse, fra transkripsjon til temaer underbygget med sitater.
Les mer →Fokusgruppestudier
Transkriber og analyser fokusgruppediskusjoner, med oversikt over hvem som sa hva og hvordan temaene varierer mellom deltakergrupper, moderatorer og økter.
Les mer →Kundeintervjuer
Kod dybdeintervjuer systematisk, finn ut når programmet ditt når metning, og eksporter ryddige rapporter underbygget med sitater til kundepresentasjoner.
Les mer →Markedets stemme
Samle og kod fritekstsvar fra store utvalg for å forstå markedsoppfatninger, udekkede behov og nye trender på tvers av segmenter.
Les mer →Fokusintervjuer
Gjennomfør strukturerte dybdeintervjuer med Skimle Ask, kod svarene automatisk og sammenlign funnene på tvers av respondentsegmenter med en gang.
Les mer →
Rådgivning og due diligence
Sammenfatning av ekspertsamtaler
Transkriber og kod samtaler med eksperter fra ekspertnettverk i et prosjekt. Bygg et strukturert bilde av ekspertenes syn på markedsdynamikk, risikoer og muligheter på en brøkdel av tiden.
Les mer →Analyse av innspill fra interessenter
Analyser interessentintervjuer og resultater fra arbeidsmøter systematisk, slik at alle stemmer er representert og kan spores i de endelige anbefalingene dine.
Les mer →Oppsummering av dokumenter
Hent ut hovedtemaer og standpunkter fra store dokumentsamlinger, som regulatoriske dokumenter, årsrapporter og forskningsartikler, på en brøkdel av tiden.
Les mer →AI-basert dataanalyse
Bruk Skimles AI til raskt å kode og kategorisere kvalitative data fra intervjuer, spørreundersøkelser og dokumenter, slik at rådgiverne kan konsentrere seg om sammenfatning og innsikt.
Les mer →Skrivebordsundersøkelser
Organiser og analyser sekundærkilder, kod temaer automatisk og følg nøyaktig hvor hver innsikt stammer fra i dokumentsamlingen din.
Les mer →
Nysgjerrige fagfolk
Bedriftens hukommelse
Bygg en søkbar, kodet samling av bedriftskunnskap: møtenotater, strategidokumenter og analyser som teamet ditt kan søke i, analysere og bygge videre på over tid.
Les mer →AI-basert dataanalyse
Last opp ustrukturerte data (e-poster, rapporter, notater) og la Skimle strukturere og kode dem, slik at spredt råmateriale blir ordnet og søkbar kunnskap.
Les mer →Dokumentanalyse
Analyser kontrakter, policydokumenter eller forskningsartikler for å hente ut hovedtemaer og innsikter uten å lese hvert ord, med sitater som kan spores til originalkilden.
Les mer →Engangsanalyse
Gjør en rask strukturert analyse av et hvilket som helst datasett (intervjunotater, kunde-e-poster, tilbakemeldinger) uten å binde deg til et langt forskningsprogram eller lære et komplisert verktøy.
Les mer →Sammenfatning av datasett
Kombiner innsikt fra flere datakilder i ett felles kategorisystem, og finn felles temaer og forskjeller mellom datasett fra ulike sammenhenger.
Les mer →
Produktledelse
Analyse av kundetilbakemeldinger
Samle appanmeldelser, supportsaker og svar på spørreundersøkelser i strukturerte temaer. Se de største smertepunktene og funksjonsønskene med en gang, uansett datamengde.
Les mer →Kontinuerlig discovery
Gjennomfør lette intervjurunder og kod funnene inn i en varig innsiktsbank. Følg hvordan temaene utvikler seg på tvers av produktiterasjoner og kvartaler.
Les mer →Brukerforskning
Transkriber og analyser brukertester, dybdeintervjuer og dagbokstudier. Kom raskere frem til innsikt uten å miste de rike kvalitative detaljene teamet ditt trenger.
Les mer →Analyse av samtalelogger
Last opp opptak av salgs- eller supportsamtaler, transkriber dem automatisk og kod i stor skala for å finne gjentakende innvendinger, funksjonsønsker og mønstre i stemningen.
Les mer →
HR, mennesker og kultur
Analyse av sluttsamtaler
Kod svar fra sluttsamtaler i stor skala for å finne risikoer for frafall, mønstre i ledelsen og systemiske problemer før de vokser seg store i organisasjonen.
Les mer →Medarbeiderundersøkelser
Gjør fritekstsvar fra undersøkelser om til strukturerte temaer. Forstå hva som driver engasjement og misnøye på tvers av team, steder og ansiennitetsgrupper.
Les mer →Pulsundersøkelser
Gjennomfør hyppige korte intervjuer med Skimle Ask og følg hvordan temaene i de ansattes stemning utvikler seg over tid, slik at HR får et oppdatert bilde av organisasjonens helse.
Les mer →Kulturundersøkelser
Analyser kvalitative data fra kulturkartlegginger for å finne gapet mellom uttalte og etterlevde verdier, med full sporbarhet til bestemte sitater fra respondentene i rapporteringen til ledelsen.
Les mer →
Offentlig sektor og politikkanalyse
Analyse av høringer
Analyser høringssvar i stor skala, kod innspillene og finn de vanligste standpunktene, bekymringene og anbefalingene i tusenvis av bidrag.
Les mer →Gjennomgang av politikkdokumenter
Hent ut hovedtemaer og standpunkter fra politikkdokumenter, regulatoriske dokumenter og lovtekster, der hvert funn kan spores til kildeavsnittet.
Les mer →Tilbakemeldinger fra interessenter
Kod og analyser strukturerte tilbakemeldinger fra innbyggere, tjenestebrukere eller partnere systematisk, slik at alle stemmer fanges opp og blir representert i rapporteringen.
Les mer →Programevaluering
Analyser intervju- og spørreundersøkelsesdata fra programdeltakere for å vurdere effekten, løfte frem gjentakende temaer og lage evalueringsrapporter underbygget av belegg.
Les mer →
Koble til med MCP
Bruk Skimle fra Claude
Koble Skimle til Claude via MCP og still spørsmål om forskningsdataene, kategoriene og innsiktene dine på vanlig språk, uten å bytte kontekst.
Les mer →Bygg AI-arbeidsflyter
Bruk MCP-serveren i Skimle til å integrere de kvalitative forskningsdataene dine i et hvilket som helst MCP-kompatibelt AI-verktøy, automatisere analysetrinn og sende resultatene videre i bredere arbeidsflyter.
Les mer →Spør i forskningen via API
Få programmatisk tilgang til data i Skimle via API-et. Hent prosjekter, dokumenter, kategorier og innsikter til egne dashbord eller eksterne rapporteringsverktøy.
Les mer →
Temaene vokser frem fra dataene
Alle endringer loggføres og kan angres.
Trinn 1
Last opp og samle inn data
Hent inn opptak, dokumenter og datasett, eller samle inn nye data med AI-assisterte intervjuer, og anonymiser dem før analysen.
Transkriber lyd og video
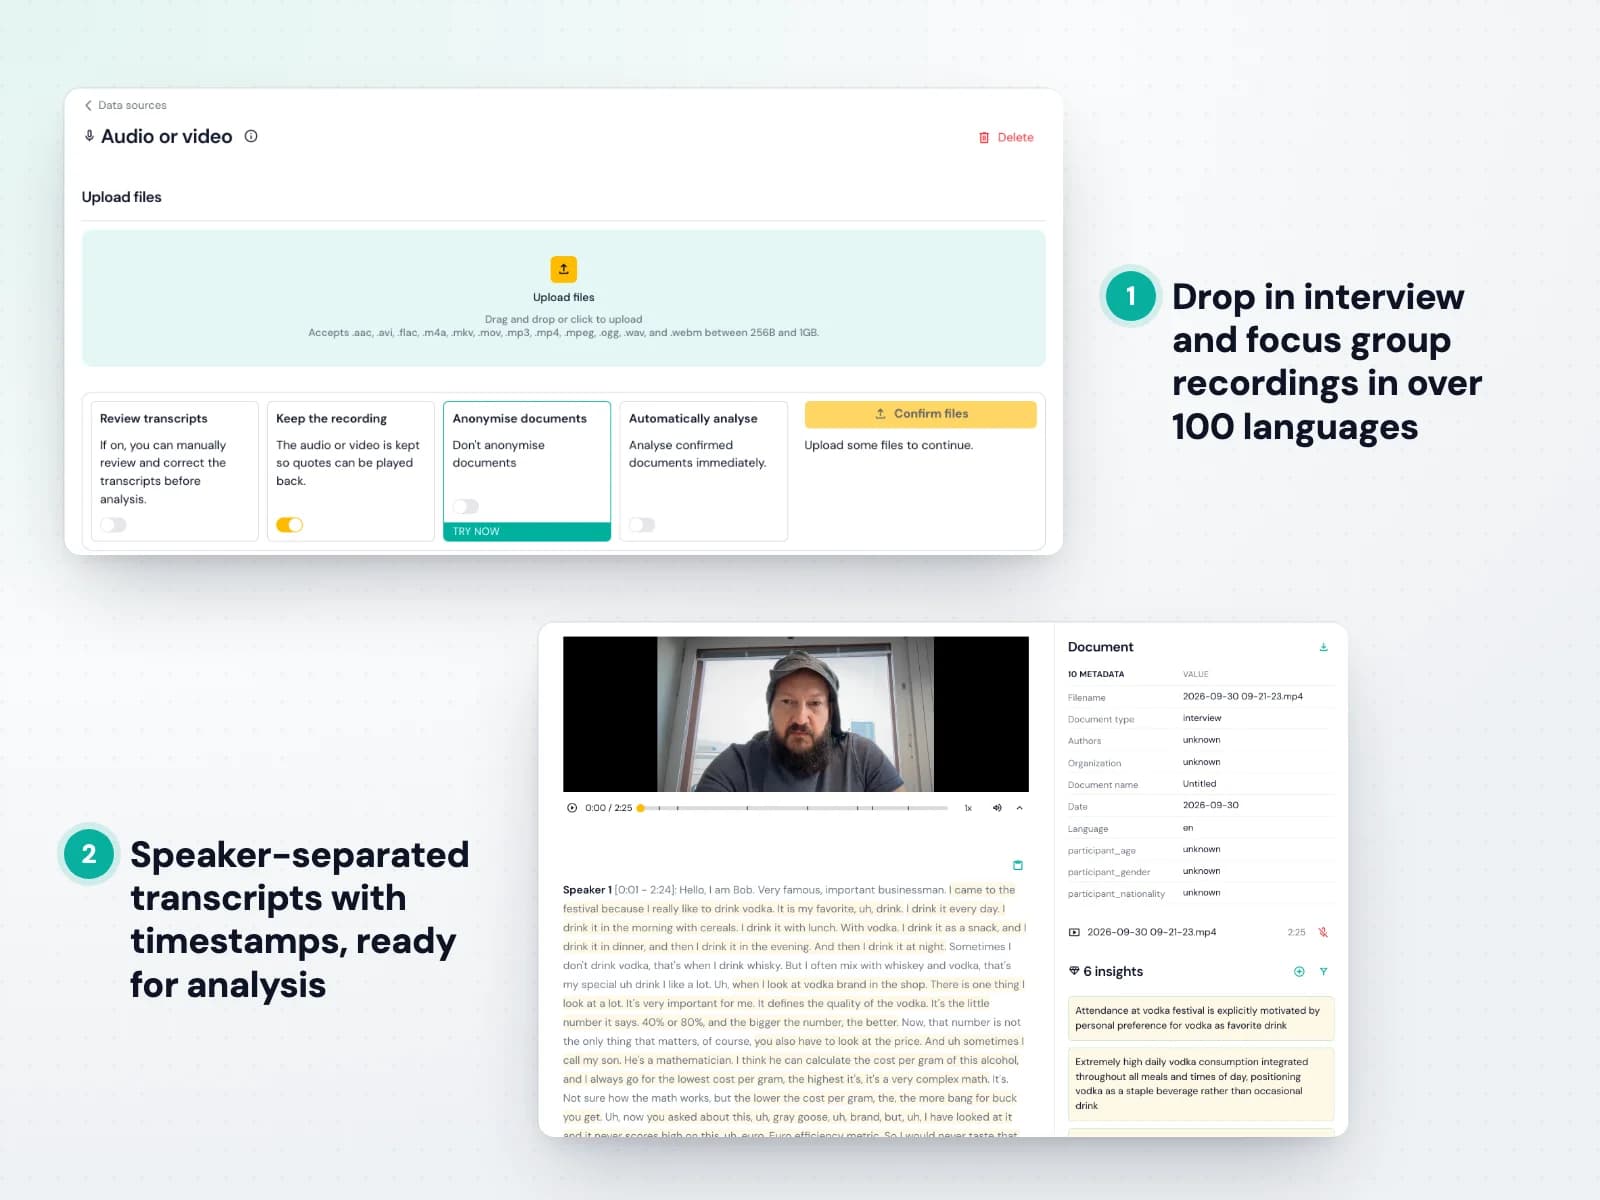
Last opp lyd eller video, så gjør Skimle det om til nøyaktige transkripsjoner med flere talere på over 100 språk. Du trenger ikke betale for et eget transkripsjonsverktøy eller flytte filer mellom systemer: teksten går rett inn i prosjektet ditt. Se hvordan du laster opp opptak.
For hver datakilde velger du om du vil gå gjennom transkripsjonene før analysen, om hvert opptak skal beholdes for avspilling eller slettes når transkripsjonen er klar, og om teksten skal anonymiseres før noe annet skjer.
- MP3, M4A, WAV, MP4, MOV og andre vanlige formater
- Skille mellom talere og tidskoder
- Valgfri manuell gjennomgang før analysen
Last opp dokumenter
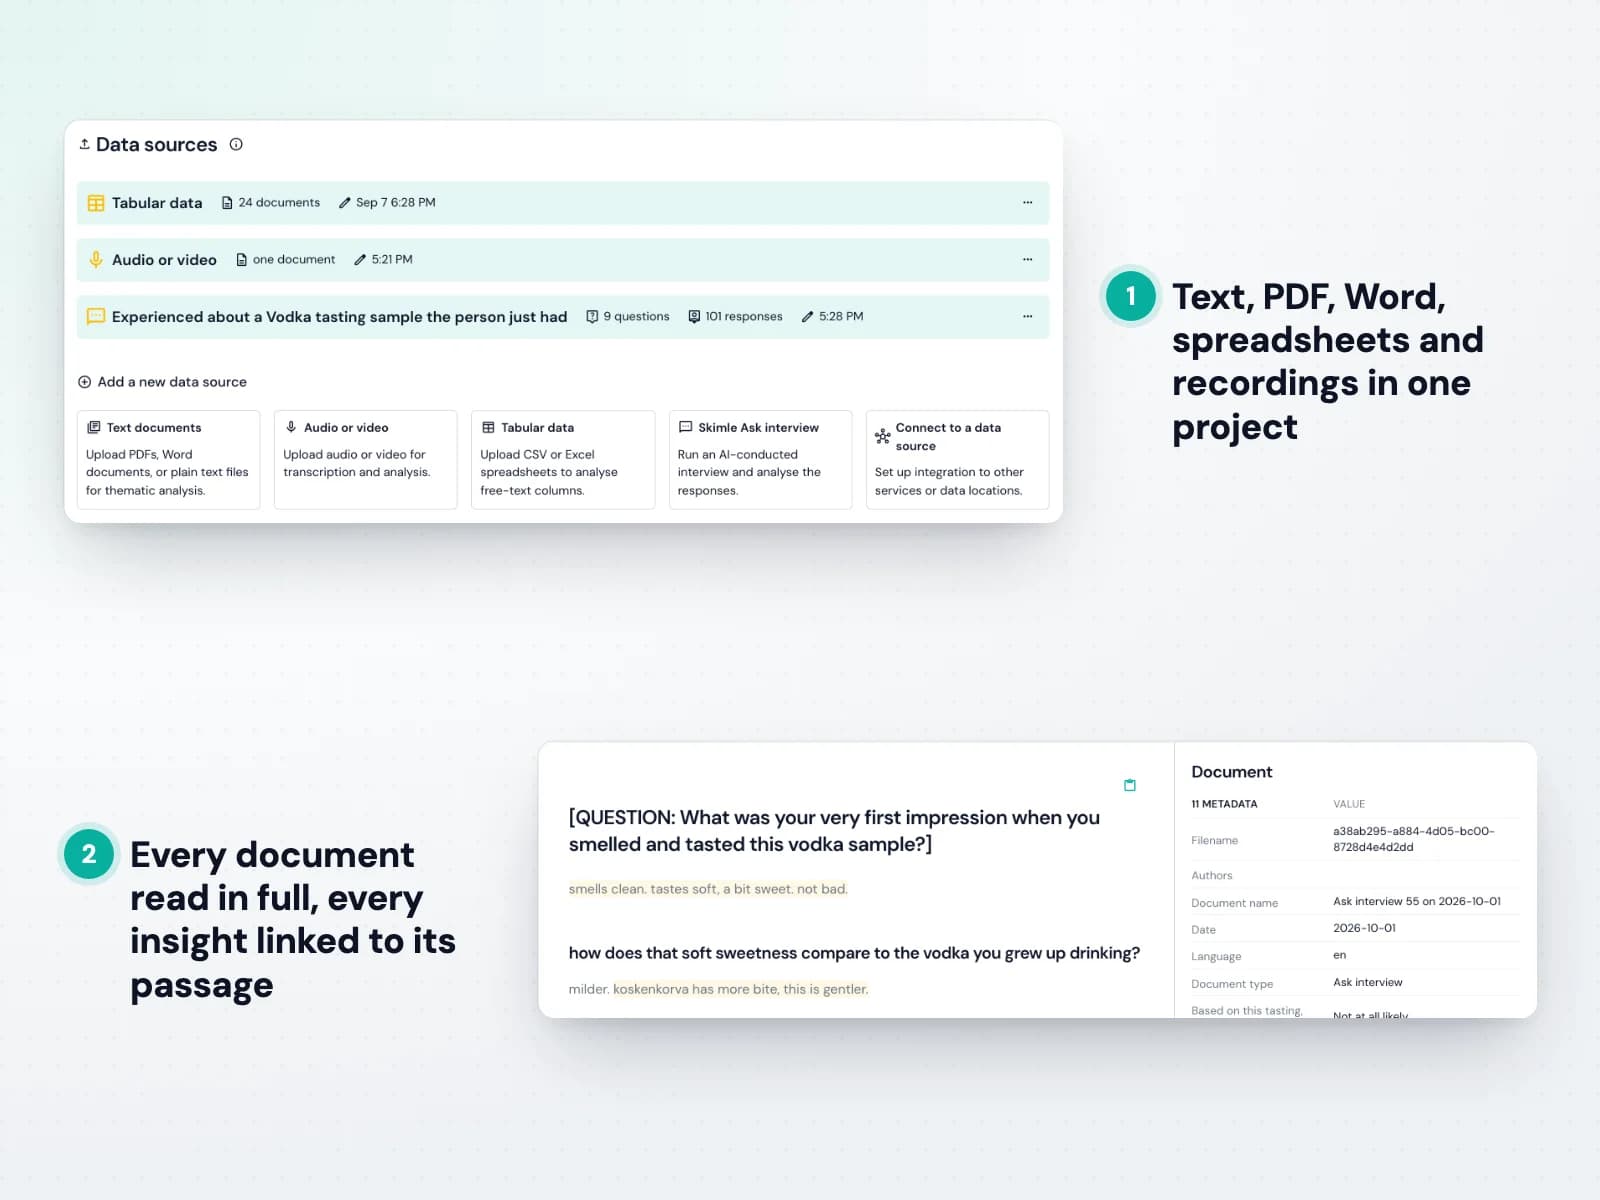
Hent inn intervjutranskripsjoner, rapporter, artikler, notater og åpne svar i formatene du allerede bruker, og bland språk fritt i ett prosjekt. Se støttede formater.
Skimle leser hvert dokument i sin helhet og beholder en lenke fra hver innsikt til det nøyaktige avsnittet den kom fra, så ingenting går tapt og alt kan kontrolleres.
- PDF, Word (DOCX), RTF og TXT
- Over 100 språk, blandet i ett prosjekt
- Hver innsikt knyttet til kildeavsnittet
Importer datasett
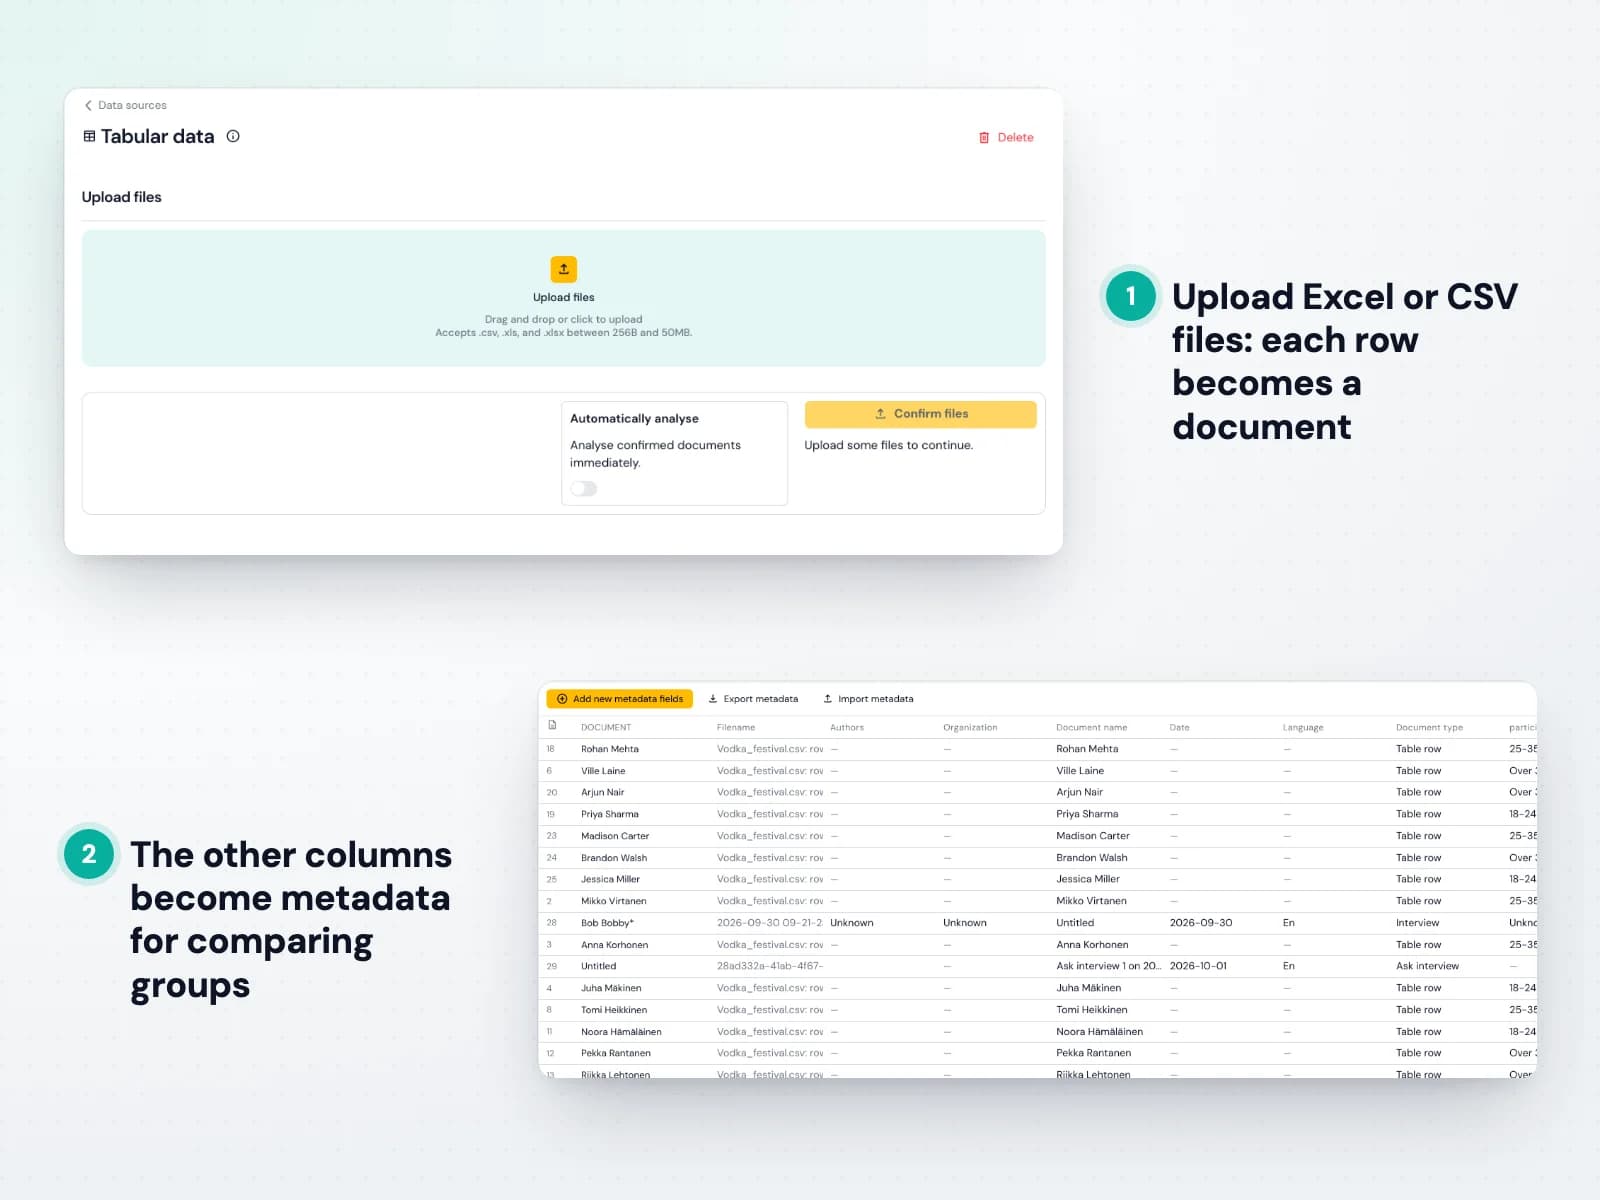
Importer regneark og eksporter fra spørreundersøkelser i én operasjon. Hver rad blir et dokument, og for hver kolonne bestemmer du om den er innhold, metadata eller skal ignoreres. Se hvordan du importerer og legger til metadata.
Fordi metadataene følger hvert svar, kan du senere sammenligne hva ulike grupper av respondenter sa, for eksempel nye mot lojale kunder, eller én region mot en annen.
- Import av Excel og CSV
- Velg kolonner for innhold og metadata
- Tusenvis av svar per prosjekt
Intervju med Skimle Ask
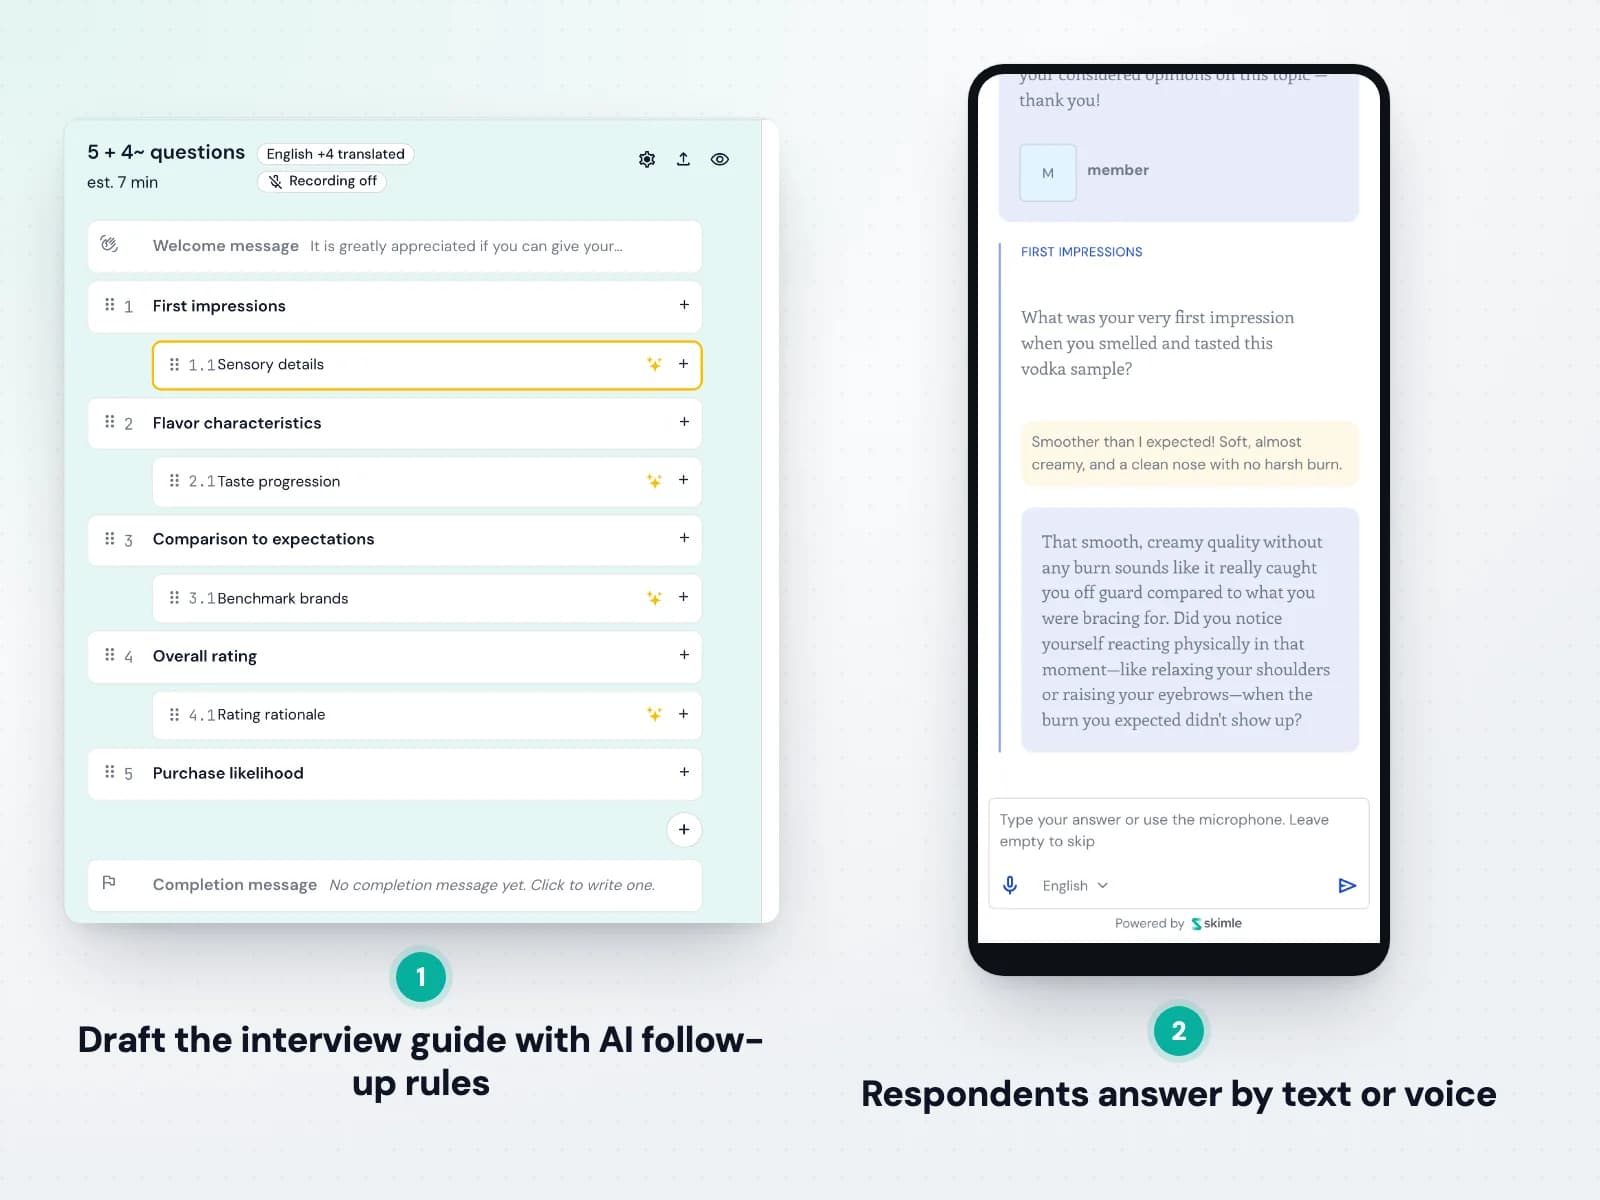
Skimle Ask gjennomfører kvalitative intervjuer i samme skala som en spørreundersøkelse. Beskriv hva du vil finne ut, la AI lage et utkast til intervjuguiden, og finjuster hvert spørsmål og instruksjonene for oppfølging. Se hvordan du lager et Ask-intervju.
Respondentene åpner en lenke, svarer med tekst eller tale, og AI-intervjueren graver etter detaljer som en erfaren forsker. Fullførte intervjuer går rett inn i analysen sammen med de andre dataene dine.
- Åpne spørsmål og flervalgsspørsmål
- AI-oppfølging med en dybde du styrer
- Intervjuer på flere språk

Anonymiser
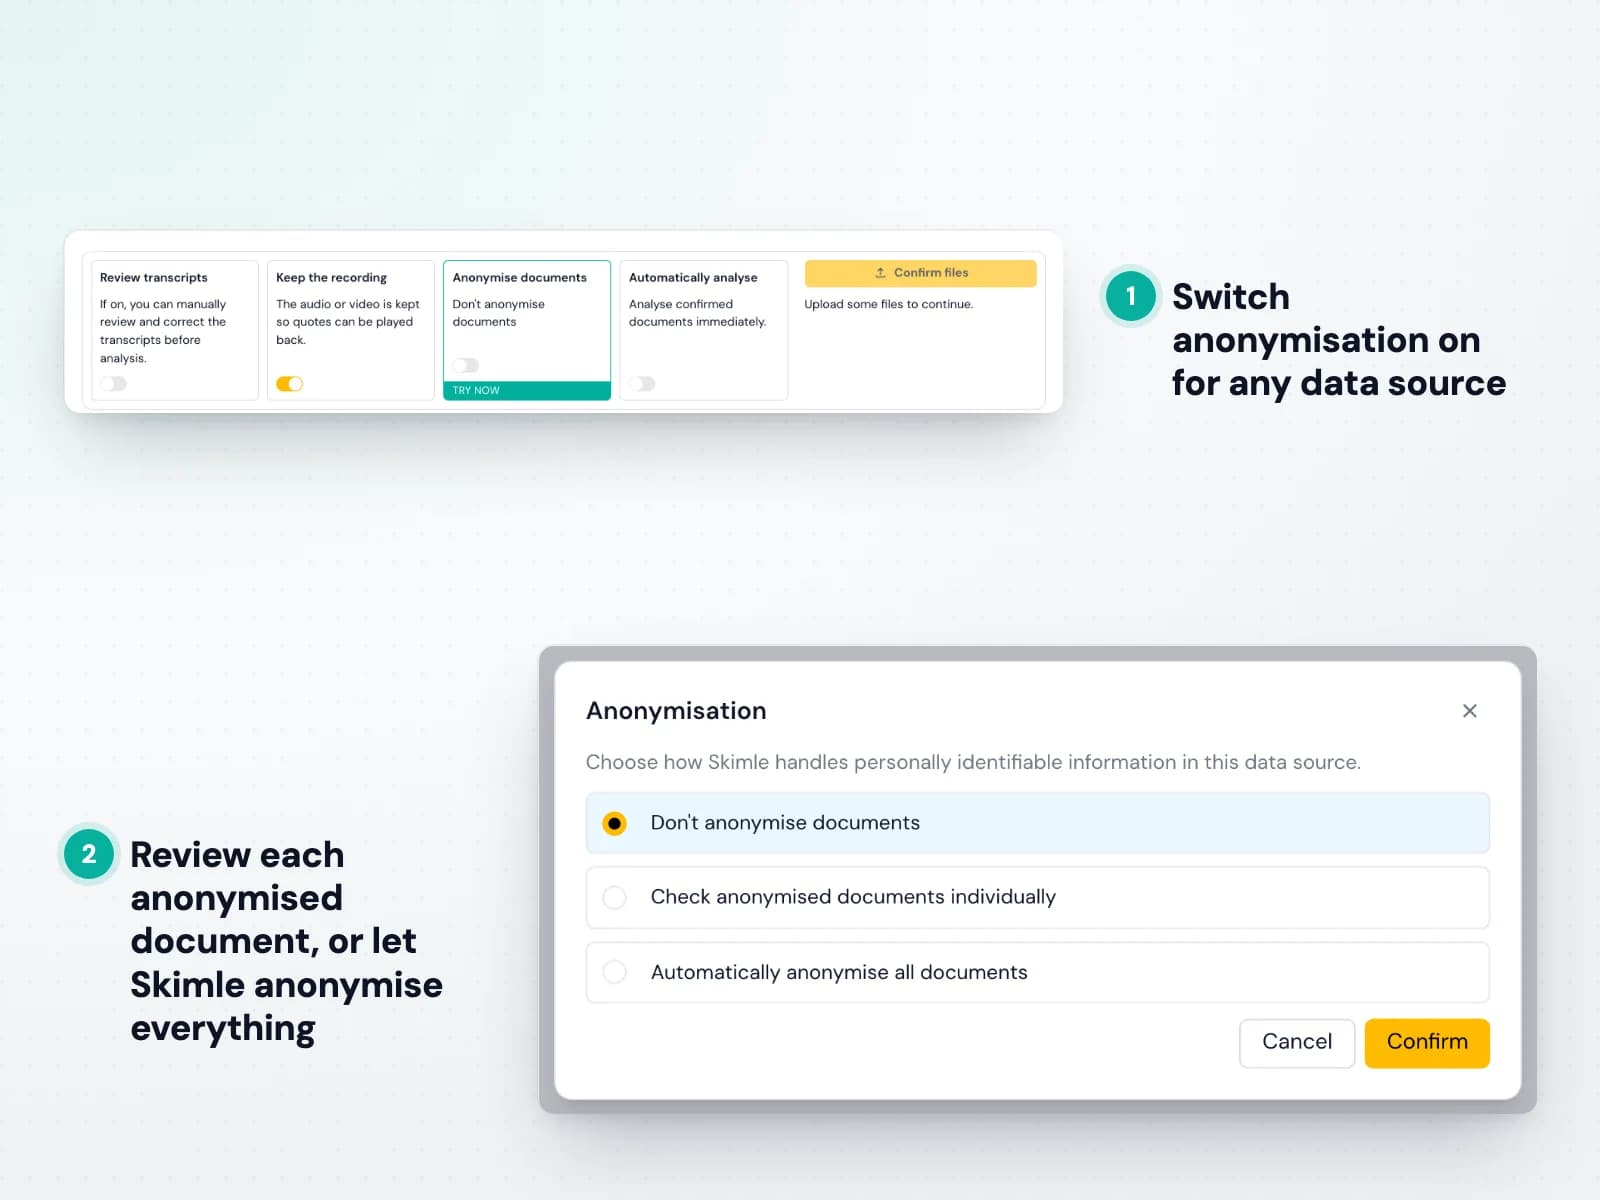
Skimle Anonymise finner personidentifiserende opplysninger i seks kategorier og erstatter dem før dataene dine analyseres. Slå funksjonen på per datakilde, og velg om du vil kontrollere hvert dokument eller anonymisere alt automatisk. Se hvordan anonymisering fungerer.
Den samme personen får det samme pseudonymet i alle dokumentene dine, så analysen henger sammen, og respondentene kan snakke fritt fordi de vet at de ikke kan identifiseres.
- Navn, roller, steder, organisasjoner, datoer og andre identifikatorer
- Konsekvente pseudonymer i alle dokumenter
- Revisjonsrapport og oversettelsestabell for etikkomiteer
Vi presenterer Skimle Anonymise: grundig pseudonymisering av kvalitative data
Verktøy for anonymisering i kvalitativ forskning i 2026: De-ID, Textwash, Presidio, MAXQDA og Skimle sammenlignet
Slik anonymiserer og pseudonymiserer du kvalitative forskningsdata: avidentifisering av intervjutranskripsjoner i tråd med IRB
Trinn 2
Analyser og utforsk dataene dine
En grundig analysemotor med full transparens og kontroll, visninger for blandede metoder, sammenligninger på metadata og en AI-forskningsassistent.
Grundig analyse i kjernen
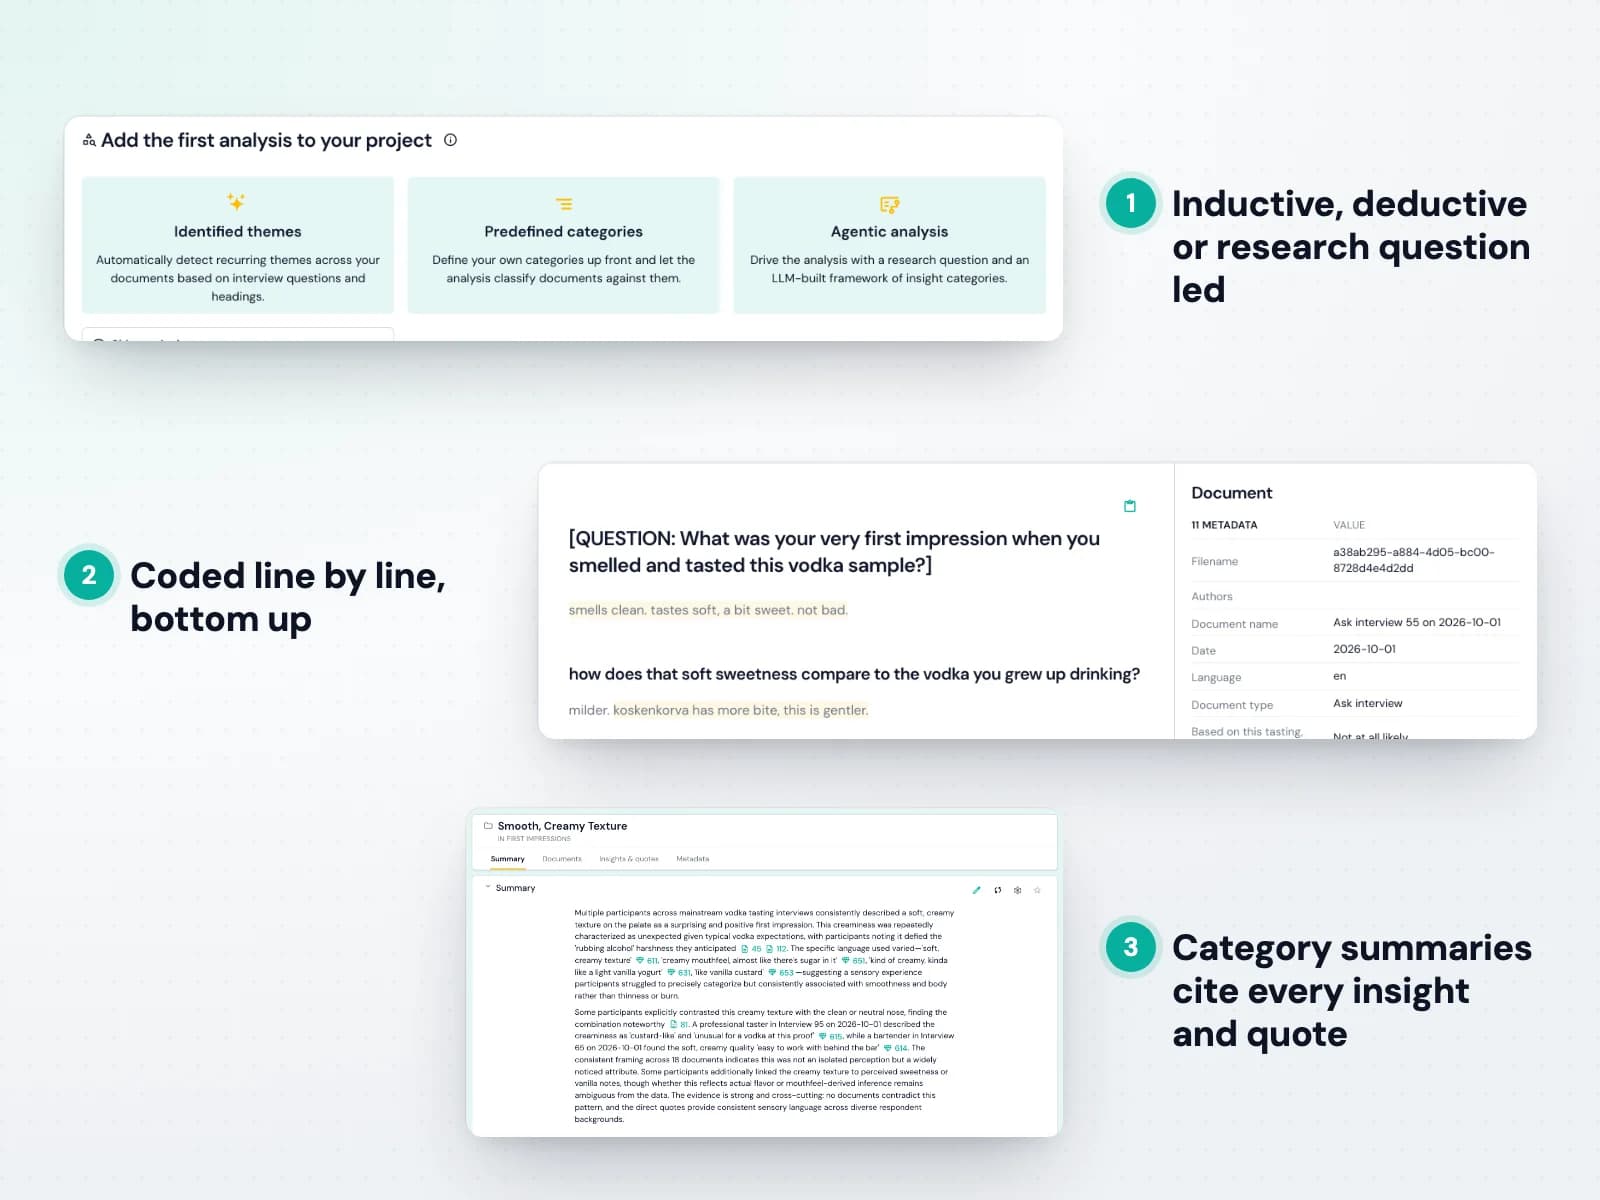
Skimle følger etablerte kvalitative metoder i stedet for å oppsummere. Den leser hvert dokument i sin helhet, identifiserer innsikter nedenfra og opp og ordner dem i kategorier, hver knyttet til sitt kildesitat. Se hvordan analysen fungerer.
Velg identifiserte temaer for å la strukturen vokse fram fra dataene, forhåndsdefinerte kategorier for å kode etter ditt eget kategorisystem, eller en agentisk analyse som drives av forskningsspørsmålet ditt. Sammendragene for hver kategori viser deretter til hver innsikt og hvert sitat de bygger på.
- Induktiv, deduktiv og forskningsspørsmålsdrevet analyse
- Hver innsikt knyttet til et ordrett sitat
- Sammendrag som viser til bevisene sine
Full brukerkontroll og transparens
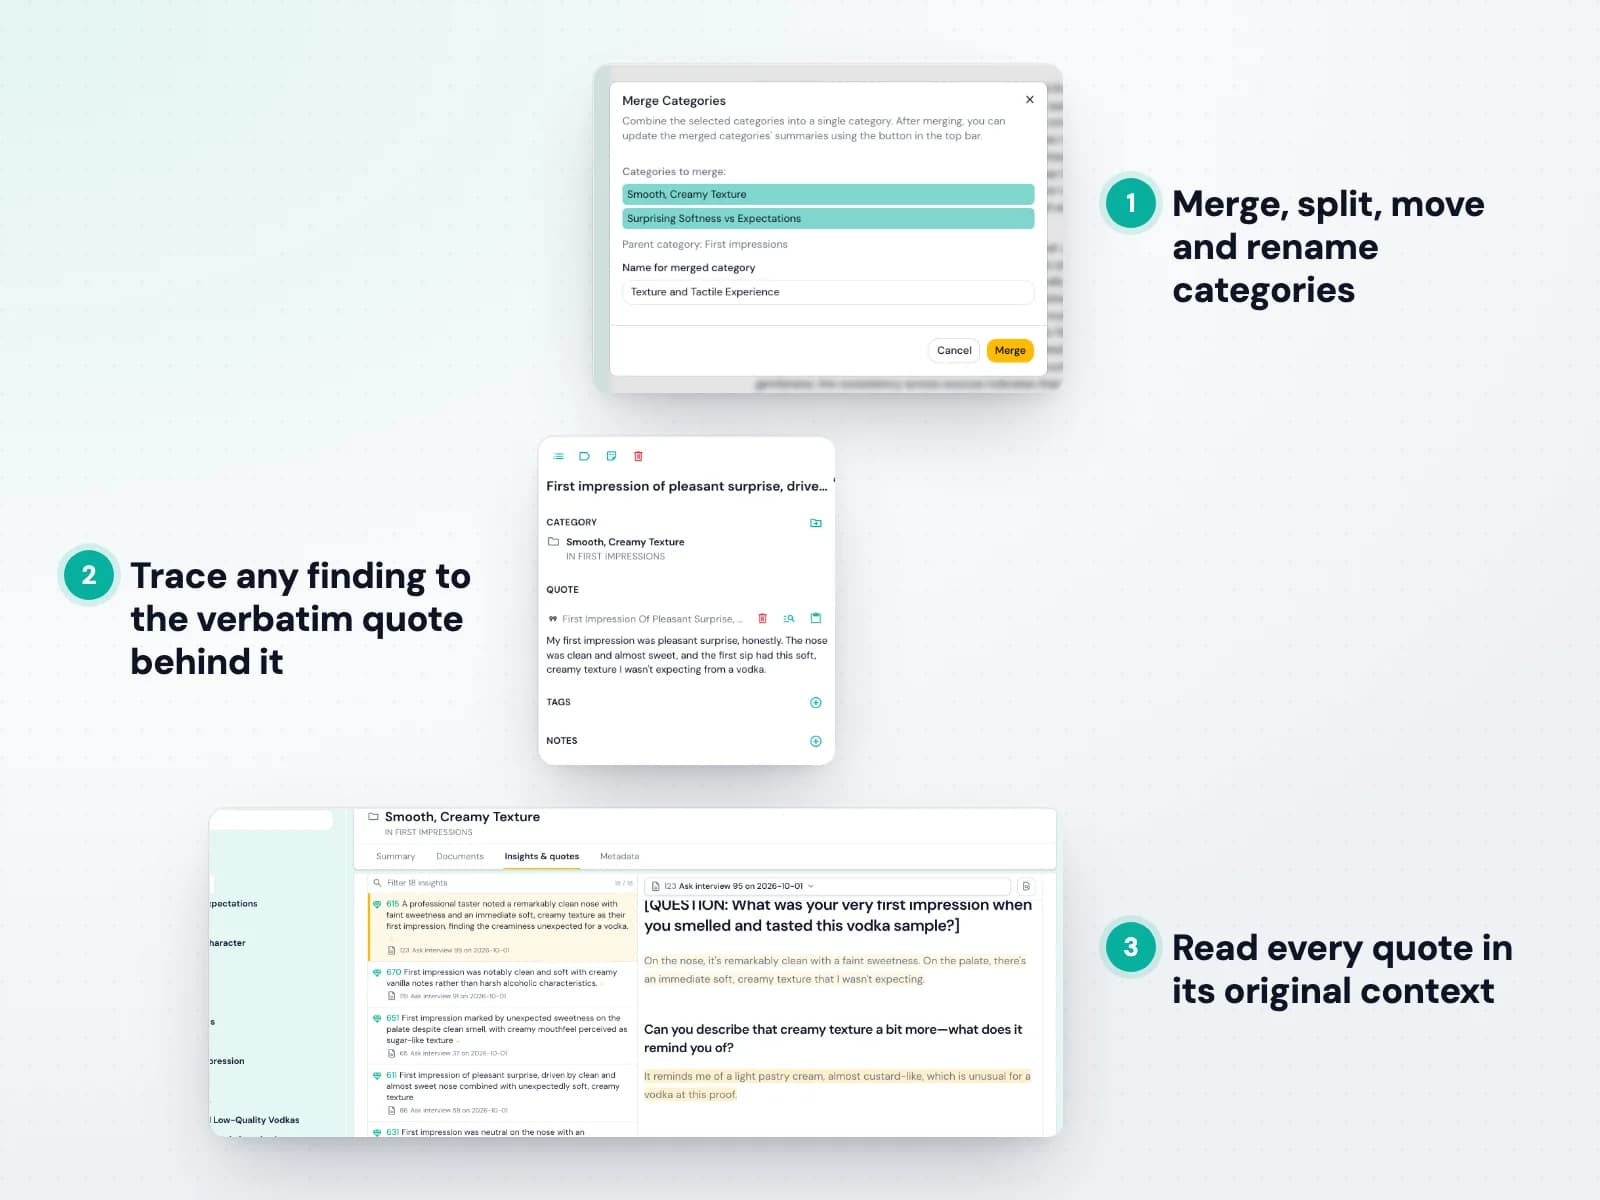
Skimles toveis transparens betyr at du alltid kan kontrollere arbeidet. Klikk på en kildehenvisning i et sammendrag for å se innsikten og det ordrette sitatet bak den, og åpne dokumentet for å se nøyaktig hva som ble kodet og hva som ikke ble det. Se hvordan du administrerer kategorier.
Når strukturen ikke stemmer med tankegangen din, endrer du den: slå sammen kategorier som overlapper, del opp de som er for brede, gi dem navn med dine egne ord og flytt innsikter mellom dem. Alle endringer kan angres.
- Slå sammen, del opp, flytt og gi nytt navn til kategorier
- Spor funn til kilden, og kilder til funnene
- Angre enhver endring
Bruk blandede metoder og visualiser data
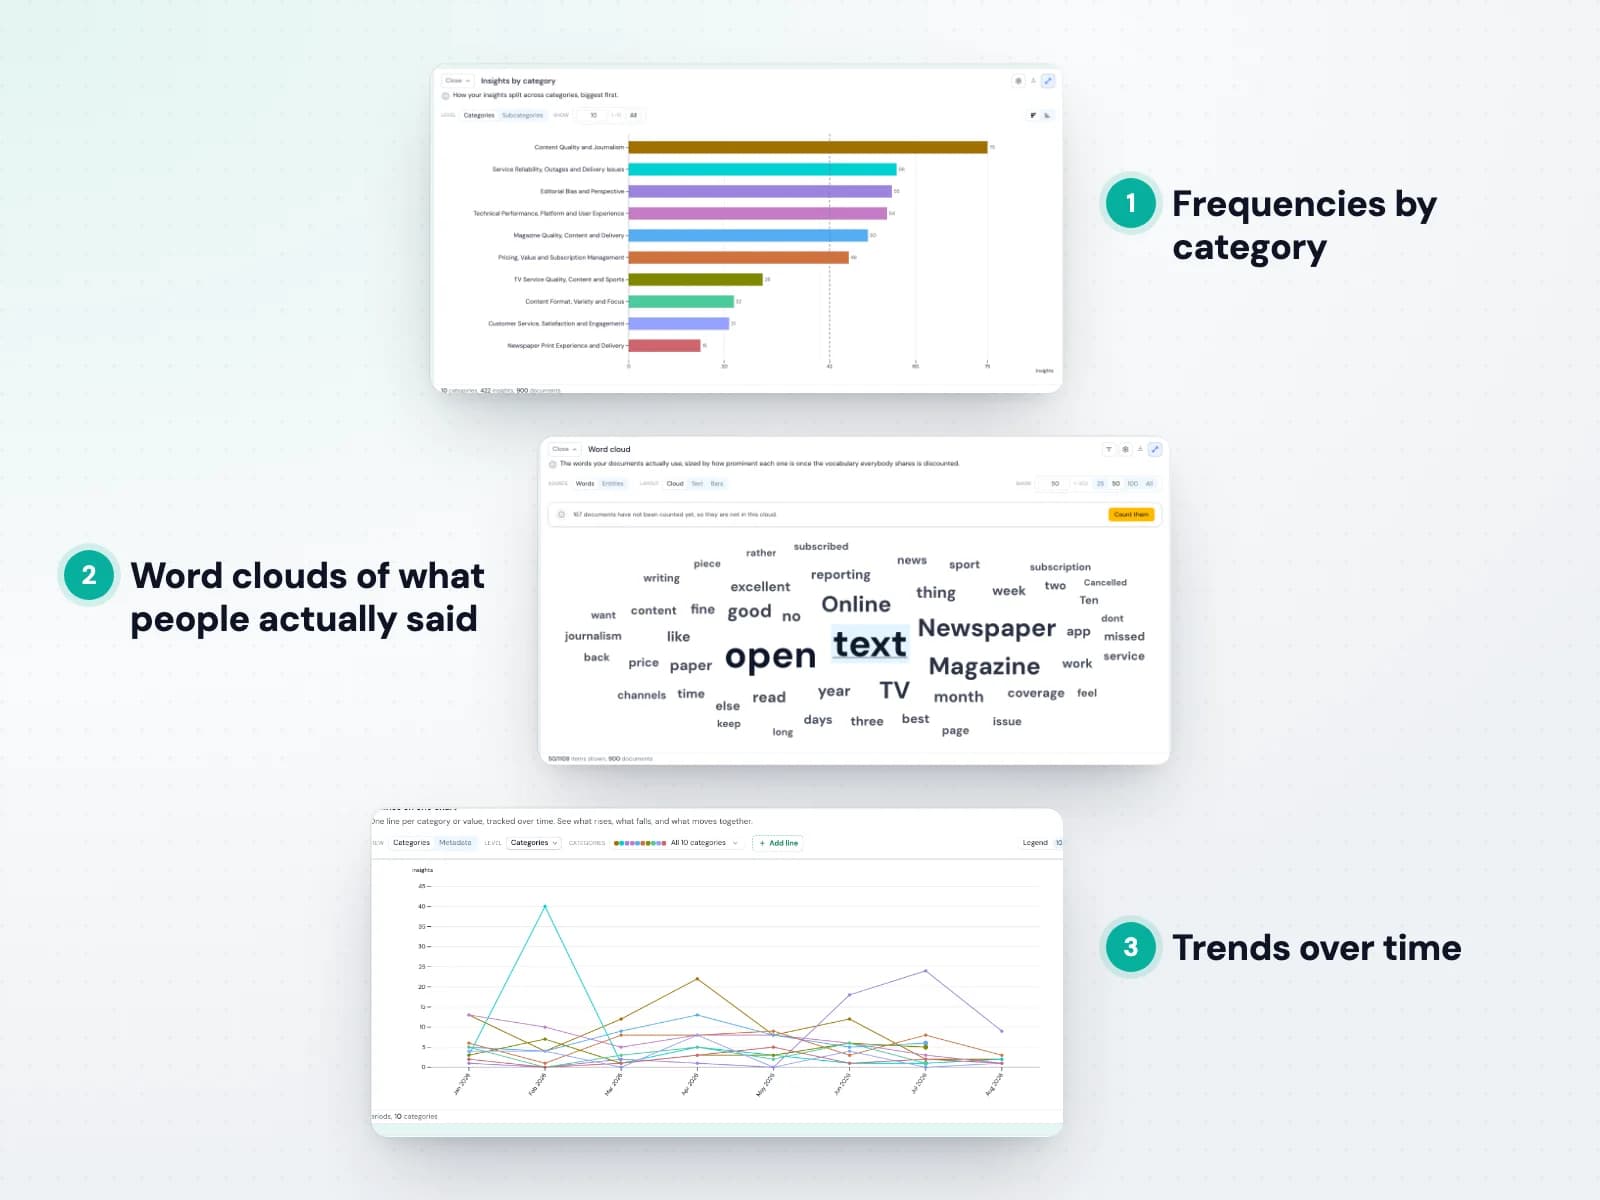
De kodede dataene dine blir tall du kan stole på, fordi hver opptelling bygger på verifiserte innsikter. Utforsk frekvenser per kategori, ordskyer, varmekart på tvers av dokumenter og utvikling over tid. Se statistikkvisningen.
Visningene oppdateres mens du finjusterer strukturen, og hver stolpe eller hvert punkt leder tilbake til innsiktene og sitatene bak, så tallene og historiene alltid stemmer overens.
- Frekvenser, ordskyer og varmekart
- Utvikling over tid
- Hvert tall kan spores til sitatene
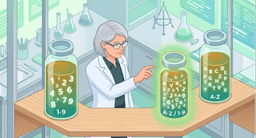
Oppdag mønstre med metadata

Sammenlign to grupper av dokumenter etter metadataene deres, så viser Skimle hvilke kategorier hver gruppe tar opp oftere enn den andre. Deretter skriver den hva som skiller gruppene og hva de har felles, med kildehenvisninger. Se hvordan du analyserer metadata.
Usikker på hvilken inndeling som betyr noe? Skimle rangerer hver metadatainndeling etter hvor langt den skiller gruppene fra hverandre, så du finner forskjellene som er verdt å rapportere i stedet for å teste dem én etter én.
- Gruppesammenligninger med skrevne sammendrag
- Hver inndeling rangert etter effektstørrelse
- Metadata fra dataene dine eller utledet av AI
Agentisk chat som forskningsassistent
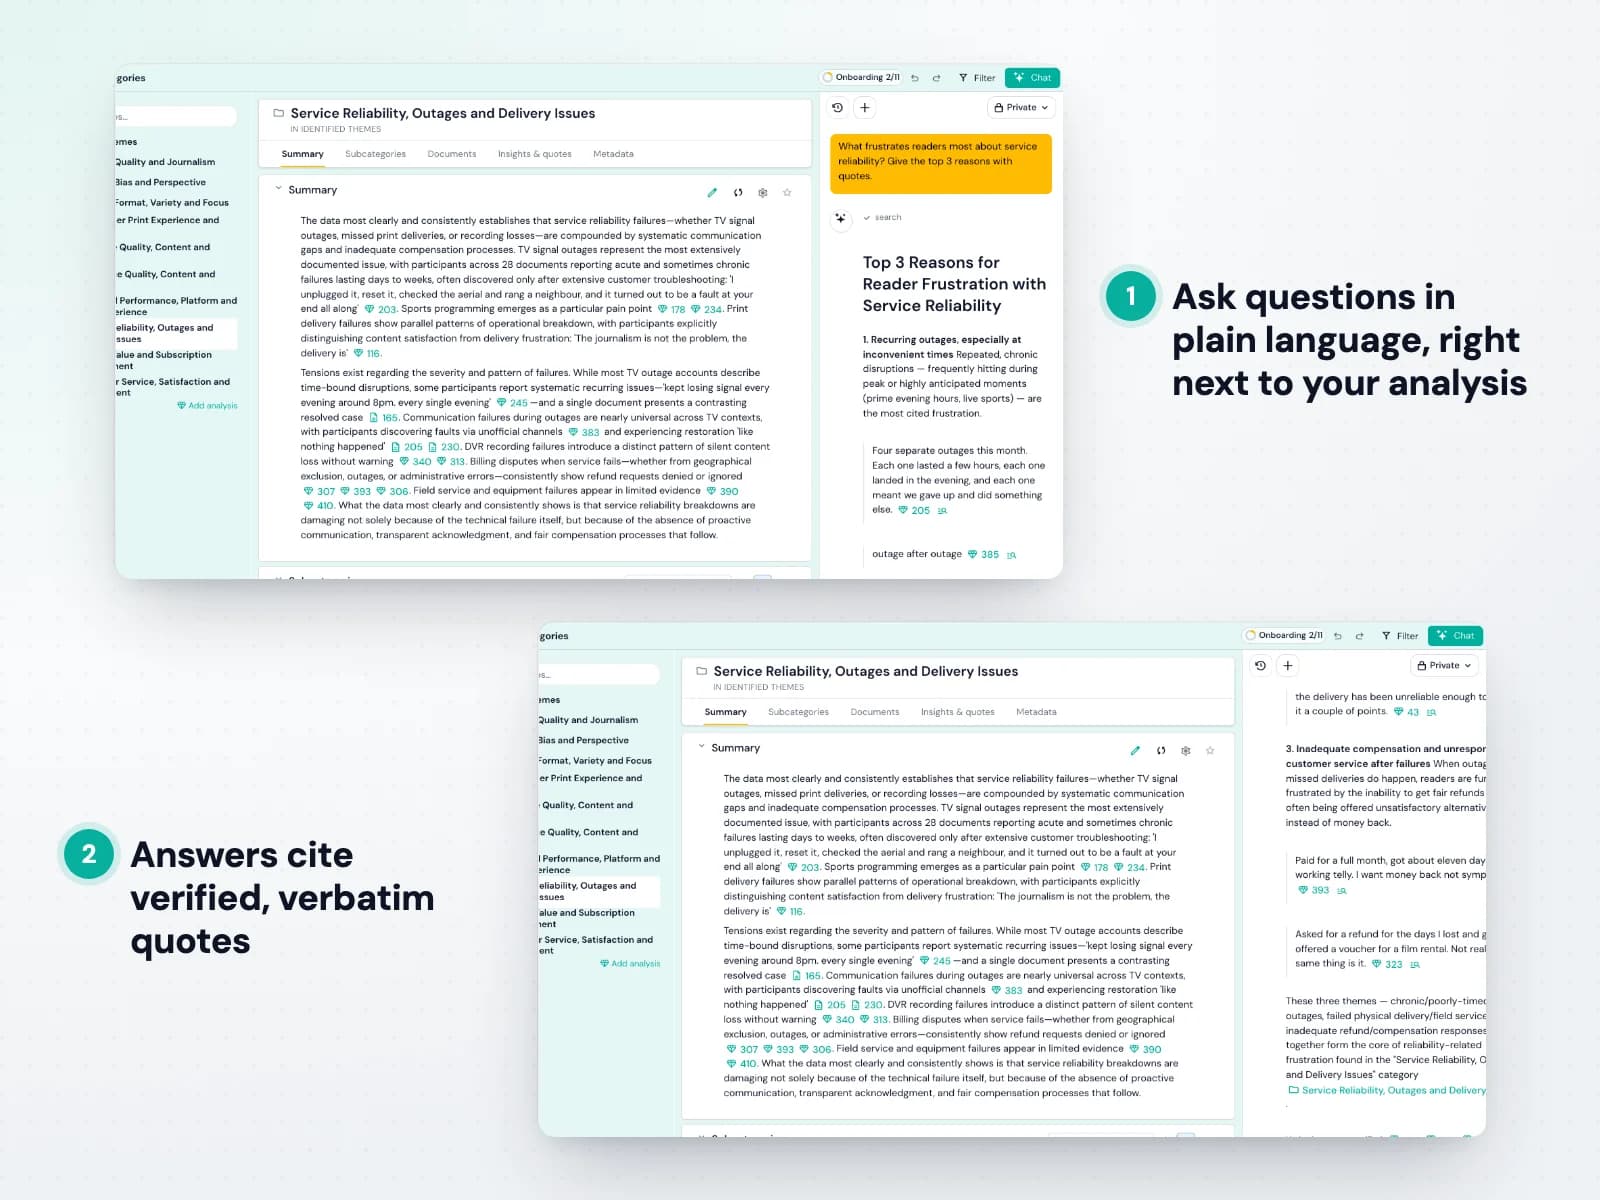
Forskningsassistenten arbeider på den strukturerte analysen din i stedet for på rå dokumenter. Still spørsmål på vanlig språk, så søker den i de kodede innsiktene dine, resonnerer i trinn du kan følge og svarer med verifiserte, ordrette sitater. Se hvordan du bruker AI-chatten.
Den kan også gjøre endringer i analysen: opprette innsikter, omorganisere kategorier og legge til notater, alt gjennom de samme kommandoene du selv bruker, så hver endring forblir synlig og kan reverseres.
- Svar forankret i verifiserte sitater
- Søker i alle kodede innsikter
- Kan omorganisere og kommentere analysen
Trinn 3
Eksporter og integrer
Del funn som presentasjoner og rapporter, eksporter til verktøyene du bruker, og koble til dine egne systemer og AI-agenter.
Overbevisende presentasjoner
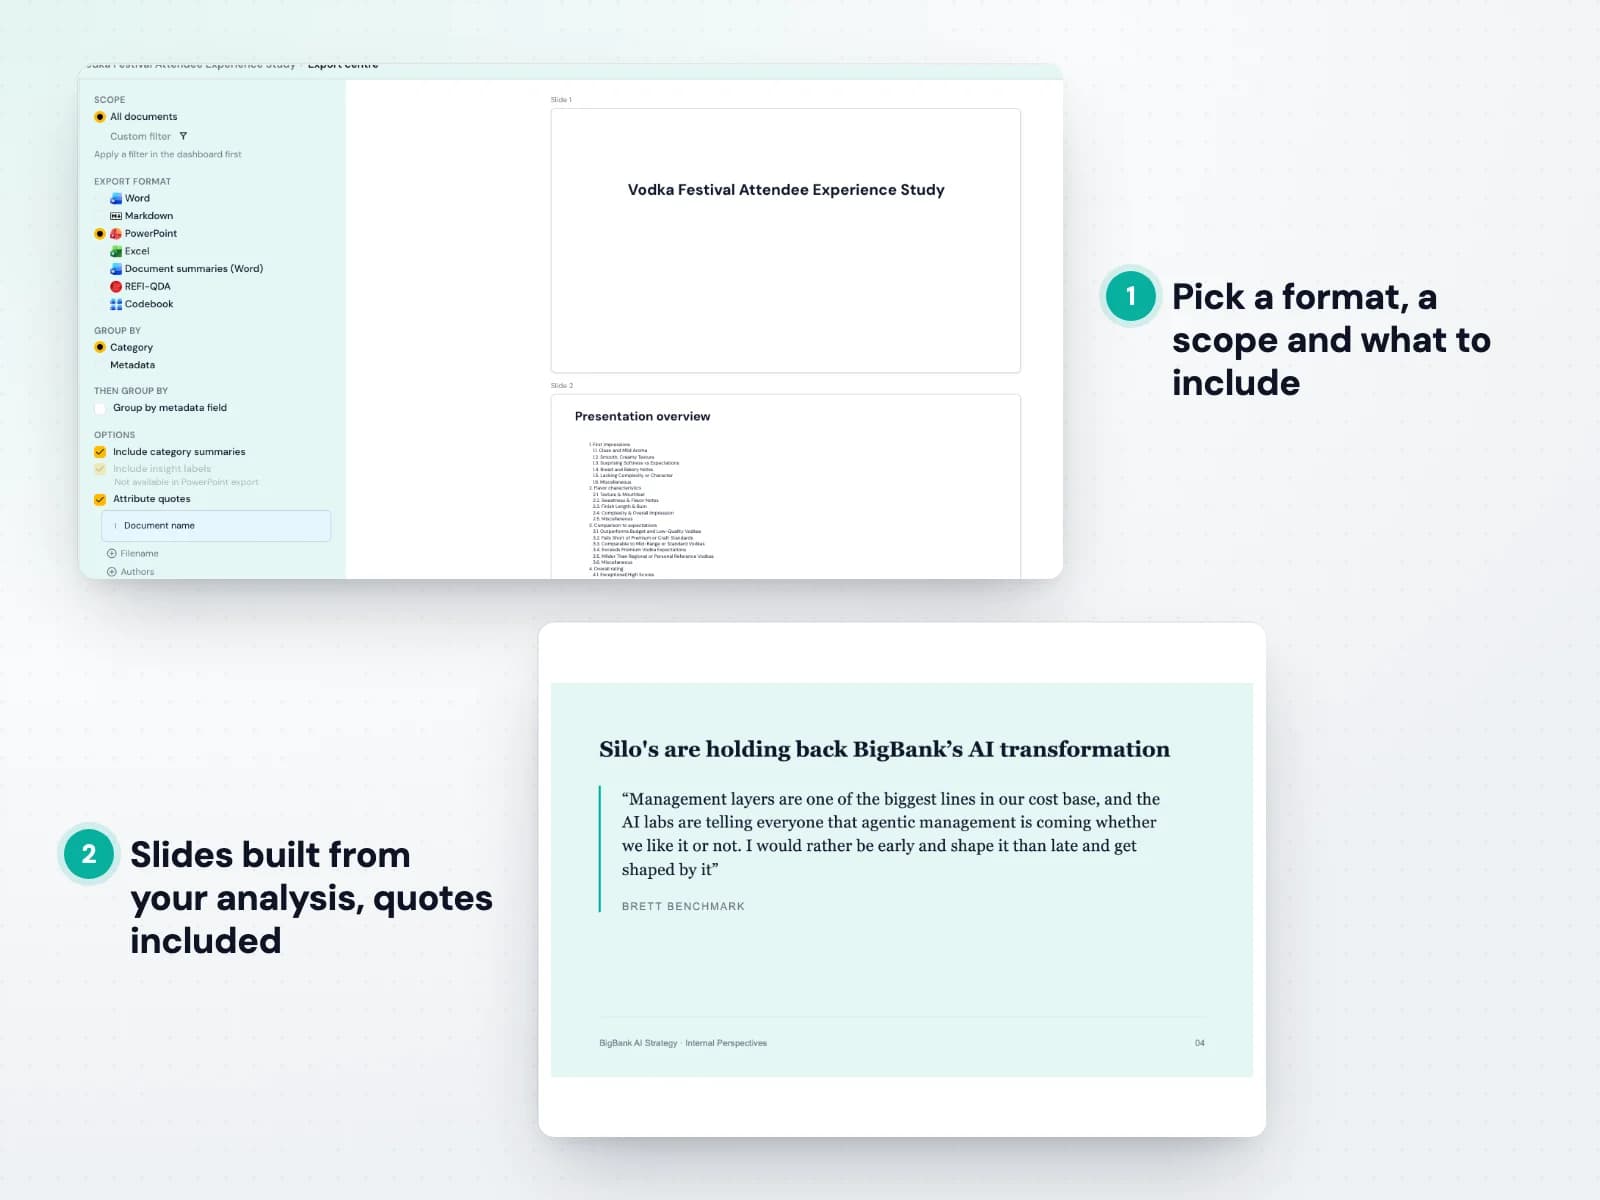
Eksporter analysen som en PowerPoint-presentasjon eller en Word-rapport. Velg omfang, grupper funnene etter kategori eller metadata, og bestem om sammendrag, kildehenvisninger og tilskrevne sitater skal være med. Se hvordan du eksporterer til Office.
Resultatet er et ferdig utgangspunkt for rapporten eller presentasjonen din: temaer, belegg og sitater er allerede på plass, og hvert av dem kan spores tilbake til analysen.
- PowerPoint-presentasjoner og Word-rapporter
- Sammendrag, kildehenvisninger og tilskrevne sitater
- Omfang og gruppering etter eget valg
API- og MCP-koblinger
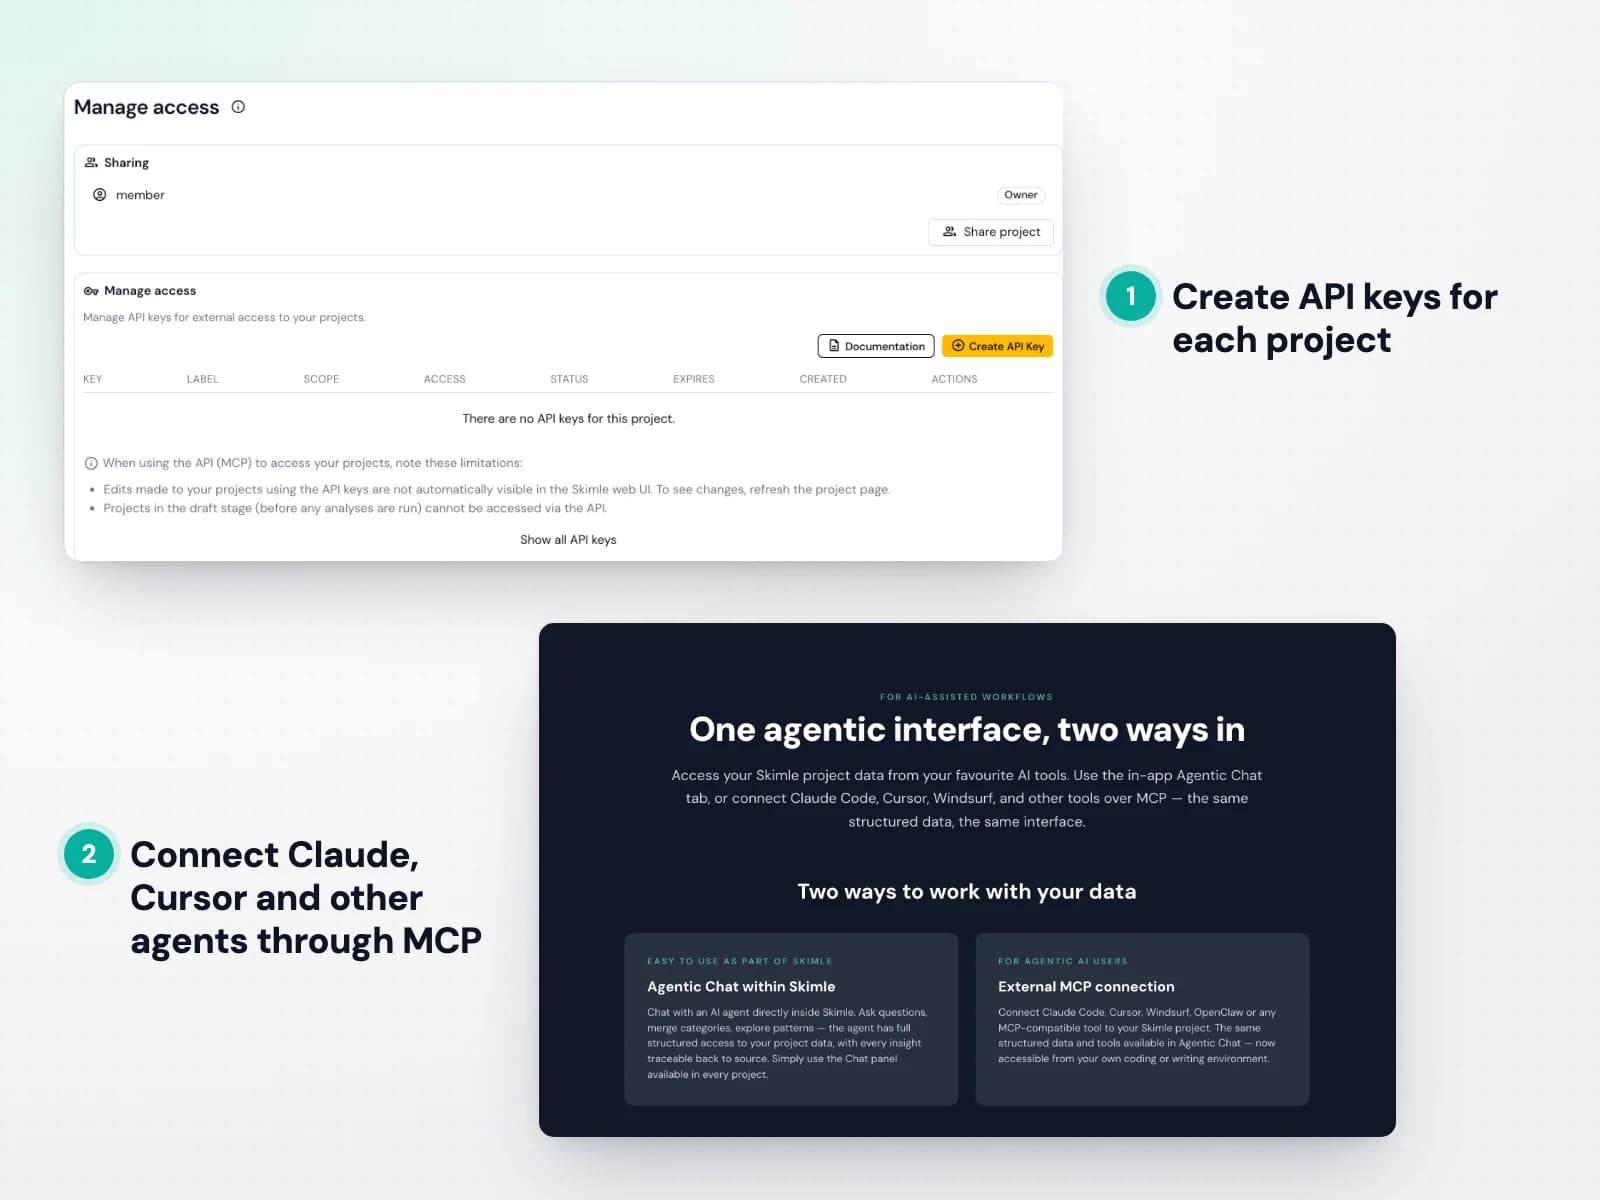
Skimles MCP-server lar Claude, Cursor, Windsurf og andre kompatible agenter arbeide med de strukturerte prosjektdataene dine, med de samme verktøyene som den innebygde agenten bruker. Les mer om tilkobling med MCP.
REST-API-et lar dine egne systemer lese og skrive prosjektdata eller kjøre et prosjekt fra start til slutt. Opprett API-nøkler per prosjekt, med lese- eller redigeringstilgang, fra prosjektets tilgangsinnstillinger.
- MCP for Claude, Cursor og andre agenter
- REST-API for lesing og skriving av prosjektdata
- API-nøkler per prosjekt
Dataeksport
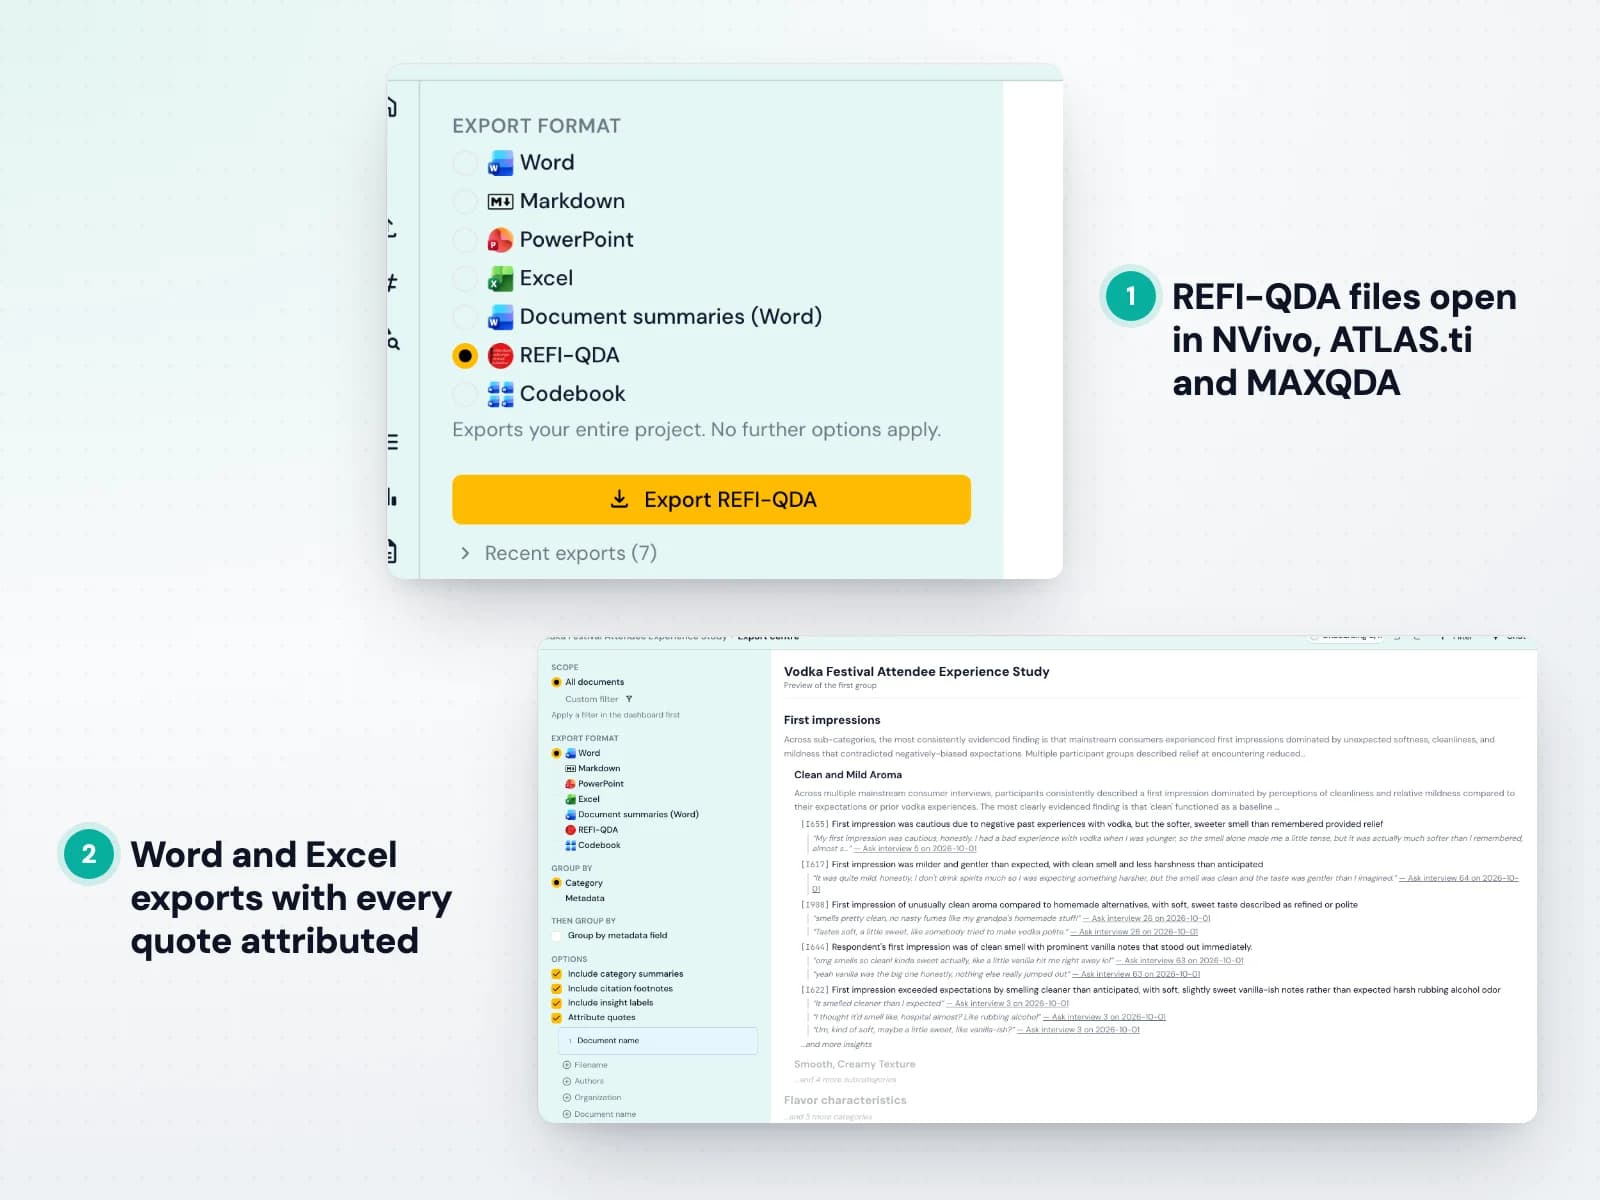
Ta med deg analysen dit du trenger den: Excel for hele Skimle-tabellen, Word med kodingen vist som kommentarer, og det åpne REFI-QDA-formatet for NVivo, ATLAS.ti og MAXQDA. Se hvordan du eksporterer til REFI-QDA.
Eksporter kategorisystemet, behold en kopi av hele analysen sammen med forskningsdataene dine, eller fortsett med manuell koding i et tradisjonelt verktøy.
- Excel, Word og REFI-QDA (.qdpx)
- Eksport av kategorisystemet
- Fungerer med NVivo, ATLAS.ti og MAXQDA
Plattform
Sikker plattform for samarbeid
Databeskyttelse på bedriftsnivå, mens teamet ditt jobber sammen om én felles analyse.
Sikker plattform
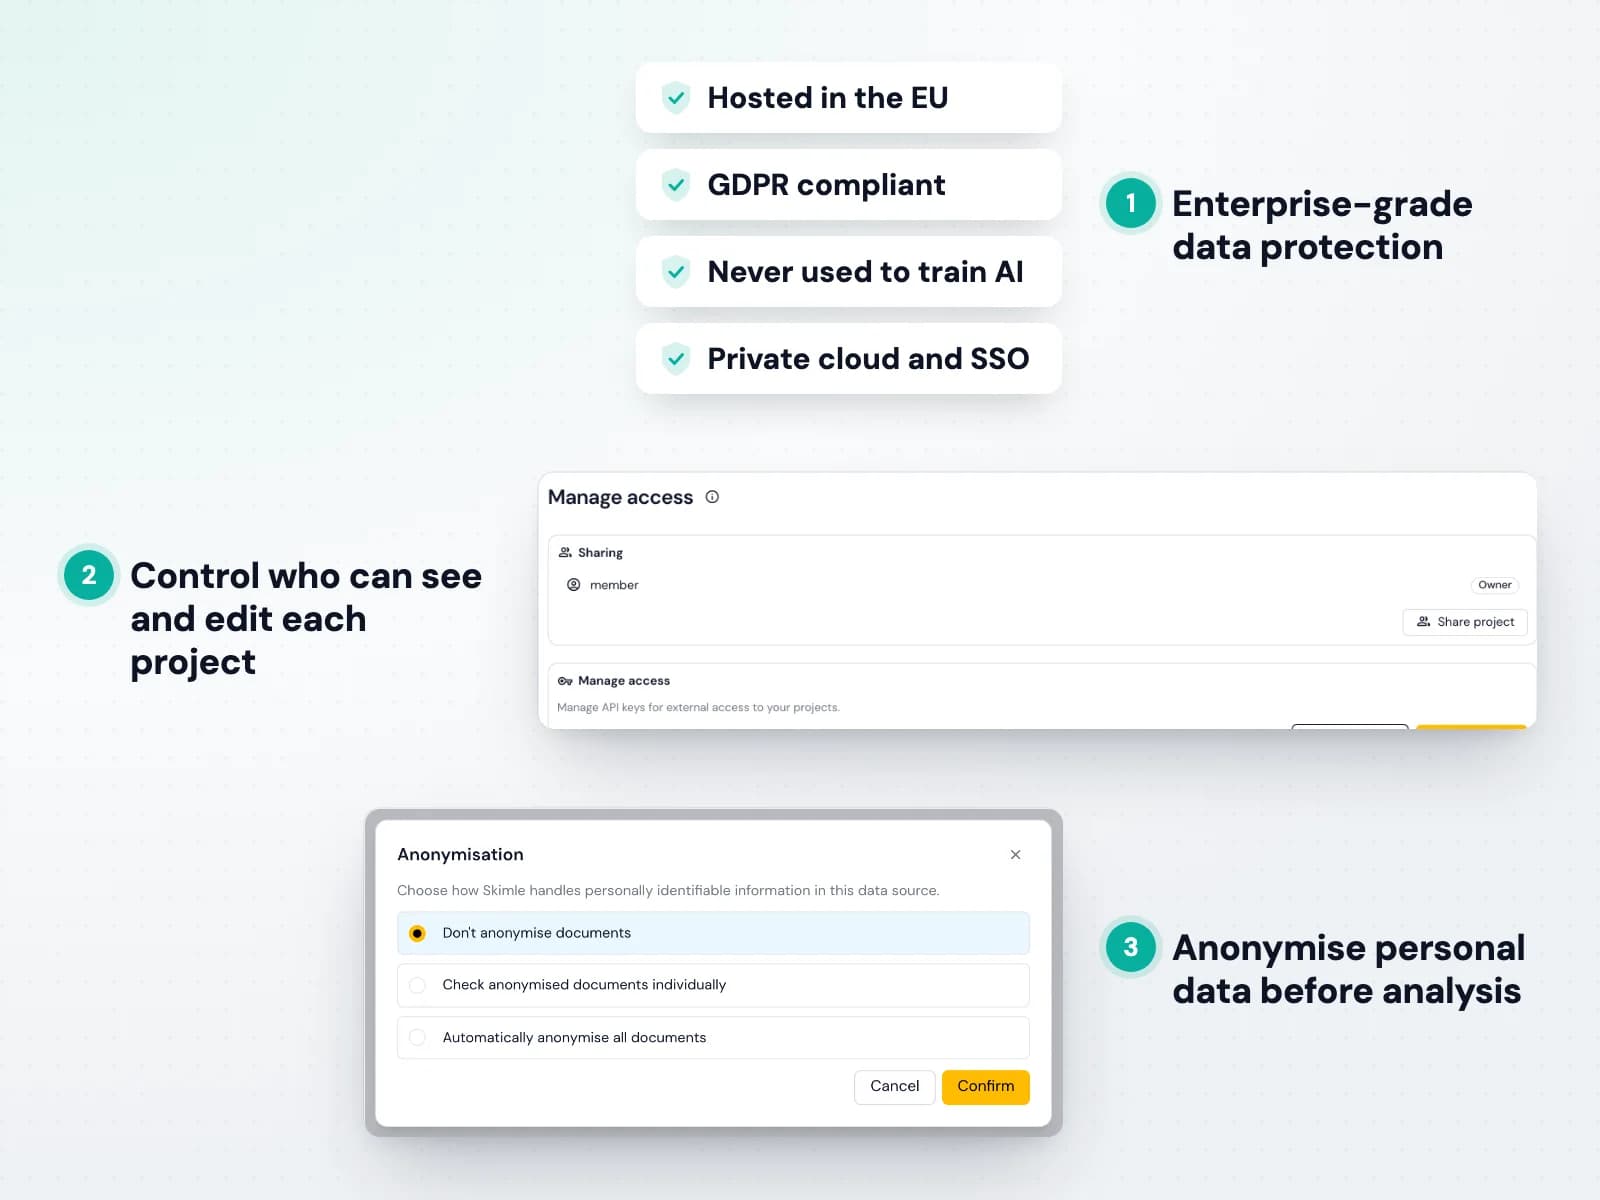
Skimle er laget for sensitiv forskning. Alle data driftes i EU, krypteres under overføring og lagring, og brukes aldri til å trene AI-modeller. Les personvernerklæringen vår.
Du styrer hvem som kan se og redigere hvert prosjekt, personopplysninger kan anonymiseres før analysen, og en databehandleravtale er tilgjengelig. Bedriftskunder kan velge privat sky og enkel pålogging (SSO).
- Drift i EU og samsvar med GDPR
- Brukes aldri til å trene AI-modeller
- Privat sky og SSO for bedrifter
Samarbeid
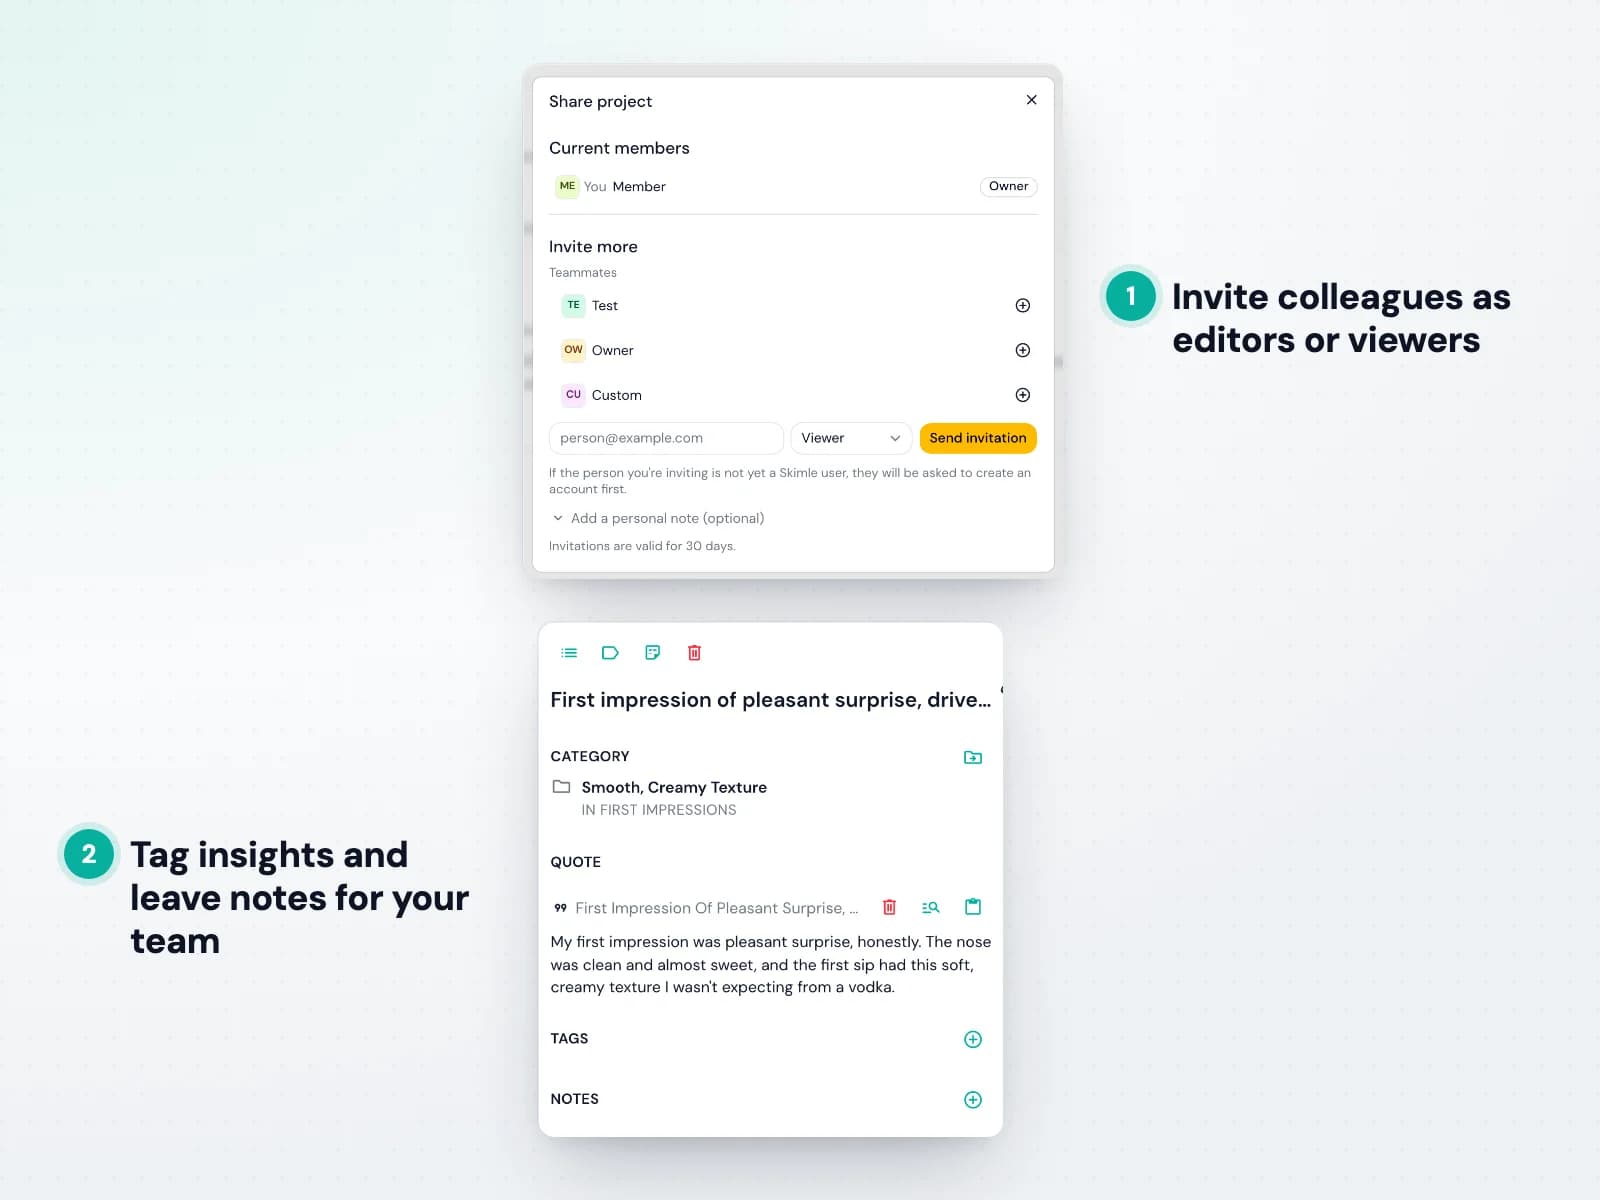
Et Skimle-prosjekt er en delt arbeidsflate. Inviter kolleger som redaktører som kan laste opp og redigere, eller som lesere som kan utforske alt uten å endre noe. Se hvordan deling fungerer.
Kodebeslutninger, tagger og notater samles på ett sted, så et forskningsteam, en kunde eller en veileder alltid ser på den samme, oppdaterte analysen.
- Roller for redaktører og lesere
- Tagger og notater på innsikter
- Én felles, oppdatert analyse
Hvordan Skimle står seg mot andre verktøy
Manuelle verktøy er grundige, men trege, generell AI er rask, men kan ikke etterprøves, og bransjespesifikke verktøy er laget for én oppgave til en premiumpris. Bare Skimle kombinerer en grundig analysemotor, full transparens og allsidighet, fra 20 € per bruker per måned.
| Manuelle verktøy NVivo, MAXQDA, ATLAS.ti… | Generelle AI-verktøy ChatGPT, Claude… | Bransjespesifikke verktøy CoLoop, Listen Labs… | Skimle | |
|---|---|---|---|---|
| Grundig analysemotor |  | | | |
| Toveis transparens, fra sammendrag til kilde | | | | |
| Allsidig på tvers av datatyper og bruksområder | | | | |
| Raskt | | | | |
| Lett å lære | | | | |
| Pris | ~80 € per bruker per måned | ~20 € per bruker per måned | 400+ € per måned | Fra 20 € per måned, gratis prøveperiode |
| Skala | Begrenset av arbeidet med manuell koding | Begrenset kontekst, dekningen kan ikke etterprøves | Varierer fra verktøy til verktøy | Tusenvis av dokumenter per prosjekt |
| GDPR og datasikkerhet | Avhenger av driftsmodell | Avhenger av plan og innstillinger | Varierer fra leverandør til leverandør | Innebygd · servere i EU · databehandleravtale tilgjengelig |
| Vurdering | Grundighet på publiseringsnivå, men uker med manuell koding per prosjekt. | Raskt, men svarene varierer med prompten og kan verken spores eller forsvares. | Laget for én arbeidsflyt, ofte til bedriftspriser. | Akademisk grundighet i AI-fart, helt transparent, for alle typer kvalitative data. |
Vanlige spørsmål
Vanlige spørsmål
- Hva er Skimle?
- Skimle er en AI-drevet plattform for kvalitativ dataanalyse som systematisk strukturerer ustrukturerte dokumenter (intervjuer, rapporter, høringer, kundetilbakemeldinger) til ordnede, analyserbare datasett med full sporbarhet. I motsetning til chatboter behandler Skimle hele dokumentsamlingen din på forhånd, henter ut innsikter og ordner dem i hierarkiske temaer der hvert funn er knyttet til et verifisert ordrett sitat.
- Hvordan skiller Skimle seg fra ChatGPT eller RAG-baserte verktøy?
- RAG-verktøy henter relevante avsnitt i det øyeblikket du spør, så du får ulike svar hver gang du stiller det samme spørsmålet. Skimle analyserer hele datasettet ditt systematisk på forhånd og bygger en stabil struktur der hvert tema er knyttet til verifiserte sitater. Du får full dekning, konsistente resultater og full sporbarhet i stedet for svar fra en svart boks.
- Hvordan skiller Skimle seg fra NVivo, MAXQDA eller ATLAS.ti?
- Tradisjonelle verktøy krever manuell koding av hvert avsnitt: systematisk, men tidkrevende, med uker eller måneder med arbeid. Skimle automatiserer kodingen med AI og beholder den samme systematiske, transparente metodikken. Du får grundighet på NVivo-nivå på en brøkdel av tiden, med et mer intuitivt skybasert grensesnitt som ikke krever ukevis med opplæring.
- Kan jeg bruke Skimle til akademisk forskning?
- Ja. Skimle er bygget av akademikere og inspirert av etablerte metoder: tematisk analyse (Braun & Clarke), grounded theory (Glaser & Strauss; Strauss & Corbin) og Gioia-metoden (Gioia, Corley & Hamilton). Skimles fullstendige revisjonsspor lar deg dokumentere nøyaktig hvordan temaene ble utledet, noe som oppfyller kravene ved fagfellevurdering. Forskere ved over 30 universiteter bruker Skimle i dag, og vi gir forslag til kildehenvisning på forespørsel.
- Hvilke språk og filformater støtter Skimle?
- Skimle støtter over 100 språk og tar imot PDF, Word (.docx), RTF, TXT, CSV, lyd (MP3, M4A, WAV) og video (MP4, MOV). Du kan blande formater og språk i ett prosjekt: last opp engelske intervjuer, tyske rapporter og spanske svar på spørreundersøkelser sammen. Lyd og video transkriberes automatisk.
- Er Skimle GDPR-kompatibelt og sikkert?
- Ja. Alle data lagres i EU og forlater aldri servere i EU. Skimle overholder GDPR fullt ut og tilbyr databehandleravtaler til institusjonelle kunder. Dokumentene dine brukes aldri til å trene AI-modeller. Skyløsninger med egen instans er tilgjengelige for bedriftskunder med strengere krav til datasuverenitet.
- Hvordan hindrer Skimle AI-hallusinasjoner?
- Hver innsikt Skimle genererer kontrolleres mot kildedokumentene: hvis AI-en produserer tekst som ikke finnes ordrett i dataene dine, flagger systemet det og behandler avsnittet på nytt. Toveis transparens lar deg klikke på et hvilket som helst tema for å se de nøyaktige sitatene som støtter det, og åpne et hvilket som helst dokument for å se hvilken tekst som ble kodet og hvilken som ikke ble det. Slik kan ingenting bli diktet opp eller oversett.
- Hvor raskt kan jeg få de første resultatene?
- De fleste prosjekter tar noen minutter å behandle. Større datasett med over 1000 dokumenter kan ta lengre tid. Et vanlig sett med 10 til 20 intervjutranskripsjoner behandles som regel på under en time. Du kan laste opp, starte en analyse og ha strukturerte temaer med støttende sitater klare til utforsking samme dag, uten oppsett eller opplæring.
- Trenger jeg tekniske ferdigheter for å bruke Skimle?
- Nei. Skimle er laget for kvalitative forskere, analytikere og rådgivere, ikke for utviklere. Du laster opp dokumentene dine, beskriver forskningsspørsmålet ditt, og Skimle tar seg av resten. Redigering av kategorier, utforsking av temaer og eksport av rapporter gjøres med noen få klikk. Ingen programmering, skripting eller AI-kompetanse kreves.
- Hvordan fungerer prisene? Finnes det virkelig en gratis prøveperiode?
- Ja. Skimle tilbyr en gratis prøveperiode med 200 kreditter (nok til omtrent 200 til 300 sider med dokumenter), uten at du trenger kredittkort. Betalte planer starter på 20 € per måned for enkeltpersoner med årlig fakturering (25 € med månedlig betaling), med større planer for storbrukere. Organisasjons- og bedriftsplaner med tilpassede volumer, SSO og egen instans er tilgjengelige på forespørsel.
- Hvor mange dokumenter kan jeg analysere?
- Skimle støtter tusenvis av dokumenter per prosjekt. Det er langt mer enn noen manuell tilnærming kan håndtere, og dekker de fleste profesjonelle bruksområder, fra 10 dybdeintervjuer til over 1000 fritekstsvar i spørreundersøkelser. Har du et spesielt stort datasett eller løpende analysebehov, kan du kontakte oss for å diskutere mulighetene.
Laget for fagfolk, av fagfolk
Skimle har over 1 500 fornøyde brukere ved mer enn 50 universiteter, offentlige etater, byråer og bedrifter. Alle data lagres i EU og behandles i henhold til våre strenge GDPR-retningslinjer og tjenestevilkår.
Vil du vite mer? Utforsk bloggen Signal & Noise, vanlige spørsmål og bruksområder etter sektor. Vi viser også gjerne produktet eller ser på hvordan Skimle kan passe dine behov. Les mer om selskapet bak Skimle