Akademisk grundighet i AI-fart
Skimle er bygget av akademikere for akademikere. Medgründer, professor Henri Schildt, har flere tiårs erfaring med kvalitativ forskning og har publisert i ledende ledelsestidsskrifter som Academy of Management Journal og Organization Science. Han ble lei av de trege, tungvinte arbeidsflytene i NVivo og MAXQDA, og var bekymret for hvordan ChatGPT brukes til analyser uten transparens og fullstendighet. Derfor bygget han Skimle som plattformen som etterligner grundig, transparent kvalitativ metodikk, med AI i kjernen.
Innledende koding av intervjuer kan ta uker manuelt. Skimle gjør det uten å gi avkall på metodisk grundighet, og fanger ofte opp sitater et menneske ville oversett. Hvert tema er knyttet til et verifisert ordrett sitat. Det fullstendige revisjonssporet tilfredsstiller fagfellevurderere.
Undervisningsmateriell →Grundig analyse som lar deg konsentrere deg om det teoretiske bidraget ditt
Skimles tilnærming er inspirert av grounded theory (Glaser & Strauss; Strauss & Corbin) og Gioia-metoden. Den gir den systematiske, transparente analysen fagfellevurdering krever, uten ukene med mekanisk koding som spiser tid du heller burde bruke på teori. Den fungerer på over 100 språk og håndterer opptil 1 000 dokumenter per prosjekt.
- Automatisert innledende koding: hvert sitat knyttet til sin kategori
- Fullstendig revisjonsspor begge veier for fagfellevurdering og åpenhet om metode
- Et kategorisystem du styrer: slå sammen, del opp, gi nytt navn og omorganiser kategorier fritt
- Fungerer på over 100 språk uten oversettelse
- Håndterer intervjuer, lyd og video, bøker, dokumenter og arkivmateriale
- Skimle Academic, en rabattert plan, er tilgjengelig
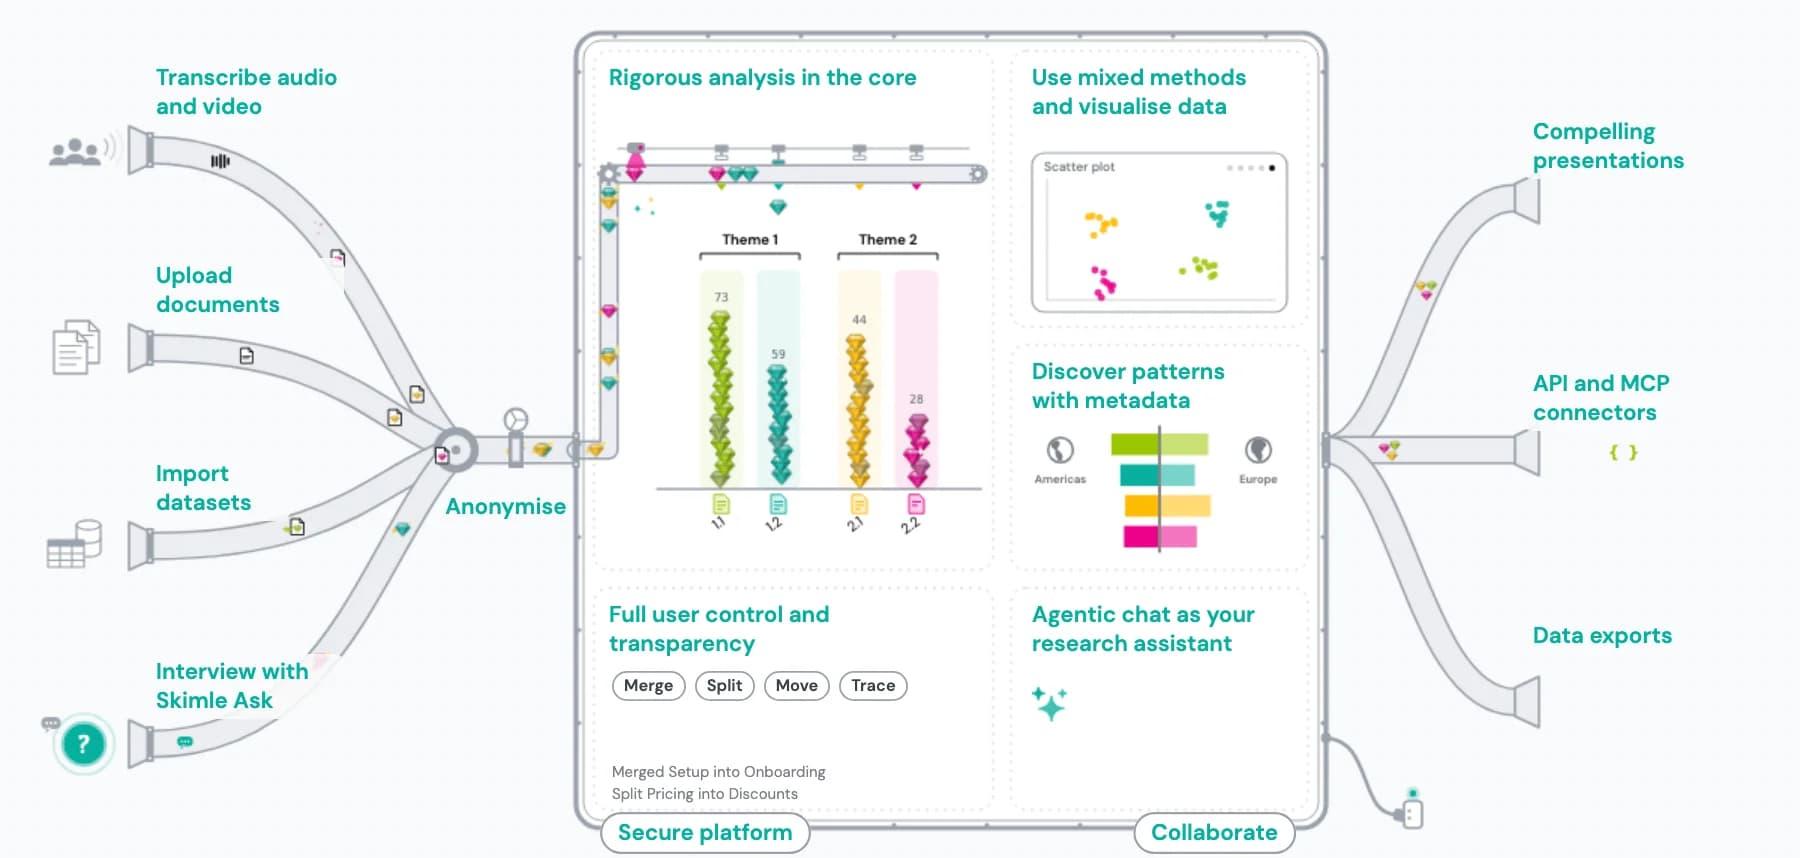
Transkriber og anonymiser intervjuer
Å gjøre feltopptak om til brukbare data er tregt og dyrt via en ekstern tjeneste, og transkripsjonene inneholder navn, tilknytninger og steder som skaper forpliktelser etter GDPR og etiske regler før du kan dele, arkivere eller sitere dem. Skimle transkriberer lyd og video i sitt sikre miljø driftet i EU og anonymiserer deretter med pseudonymisering på forskningsnivå, så du har en transkripsjon som er i samsvar med reglene og klar til koding samme dag, uten at dataene noen gang forlater GDPR-samsvarende infrastruktur.
Slik fungerer det
- 1. Last opp lyd, video eller tekst
Last opp MP3-, M4A-, WAV-, MP4-, MOV-, PDF- eller Word-filer direkte. Ingen ekstern transkripsjonstjeneste, og over 100 språk støttes direkte.
- 2. Transkriber med talermerking
Skimle transkriberer opptaket, finner talerbytter og håndterer aksenter og varierende lydkvalitet. Gå gjennom og rett resultatet før analysen starter.
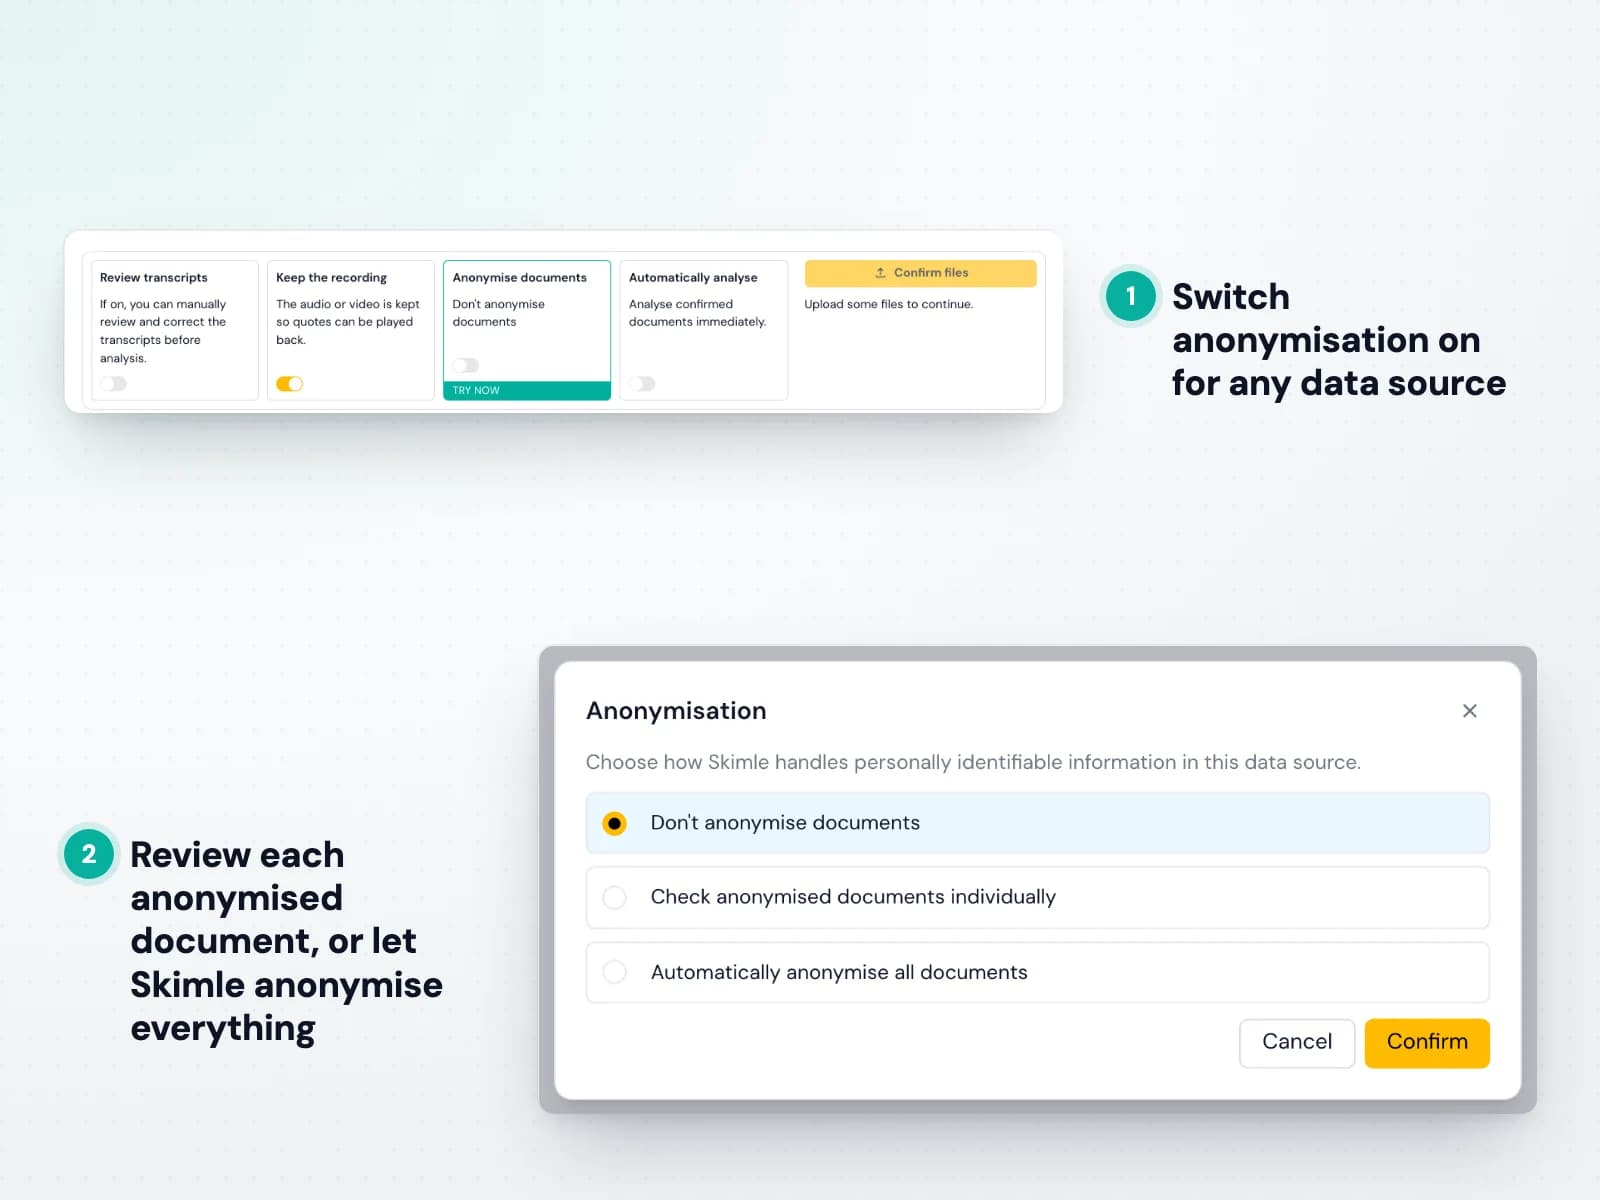
- 3. Finn identifikatorer automatisk
Skimle Anonymise markerer identifikatorer i seks kategorier (navn, titler og roller, steder, organisasjoner, datoer og annet) i hvert dokument, konsekvent på tvers av filer, slik at samme person beholder samme pseudonym.
- 4. Velg nivå for anonymisering
Velg lett pseudonymisering, sterk pseudonymisering eller anonymisering på HIPAA-nivå der nøkkelen destrueres. Juster hver kategori for seg og legg til egne regler på vanlig språk.
- 5. Eksporter med revisjonsdokumentasjon
Eksporter en PDF-revisjonsrapport og en Excel-oversettelsestabell til etikkomiteen, og send deretter den rensede transkripsjonen rett inn i analyseflyten i Skimle. Lydkilden slettes sikkert etterpå.

Gjennomfør AI-assistert kvalitativ analyse av intervjuer
Forskning basert på over 40 intervjuer bør gi et rikt teoretisk bidrag (for eksempel til doktorgraden din), men manuell koding (markering, organisering, omkoding, oversikter) spiser mesteparten av tiden og kan likevel overse viktige mønstre. Skimle leser hvert intervju systematisk og gir deg et strukturert temahierarki med ordrette sitater knyttet til, slik at du kan bruke tiden på den teoretiske tolkningen bare du kan stå for.
Slik fungerer det
- 1. Last opp transkripsjonene dine
Dra inn intervjutranskripsjoner som PDF, Word-filer eller ren tekst. Skimle tar imot dokumenter i alle formater og støtter over 100 språk direkte.
- 2. Beskriv forskningsspørsmålet ditt
Angi det analytiske fokuset ditt, bredt eller spesifikt. Skimle strukturerer den innledende kodingen rundt det du prøver å forstå teoretisk.
- 3. Gå gjennom den innledende kodestrukturen
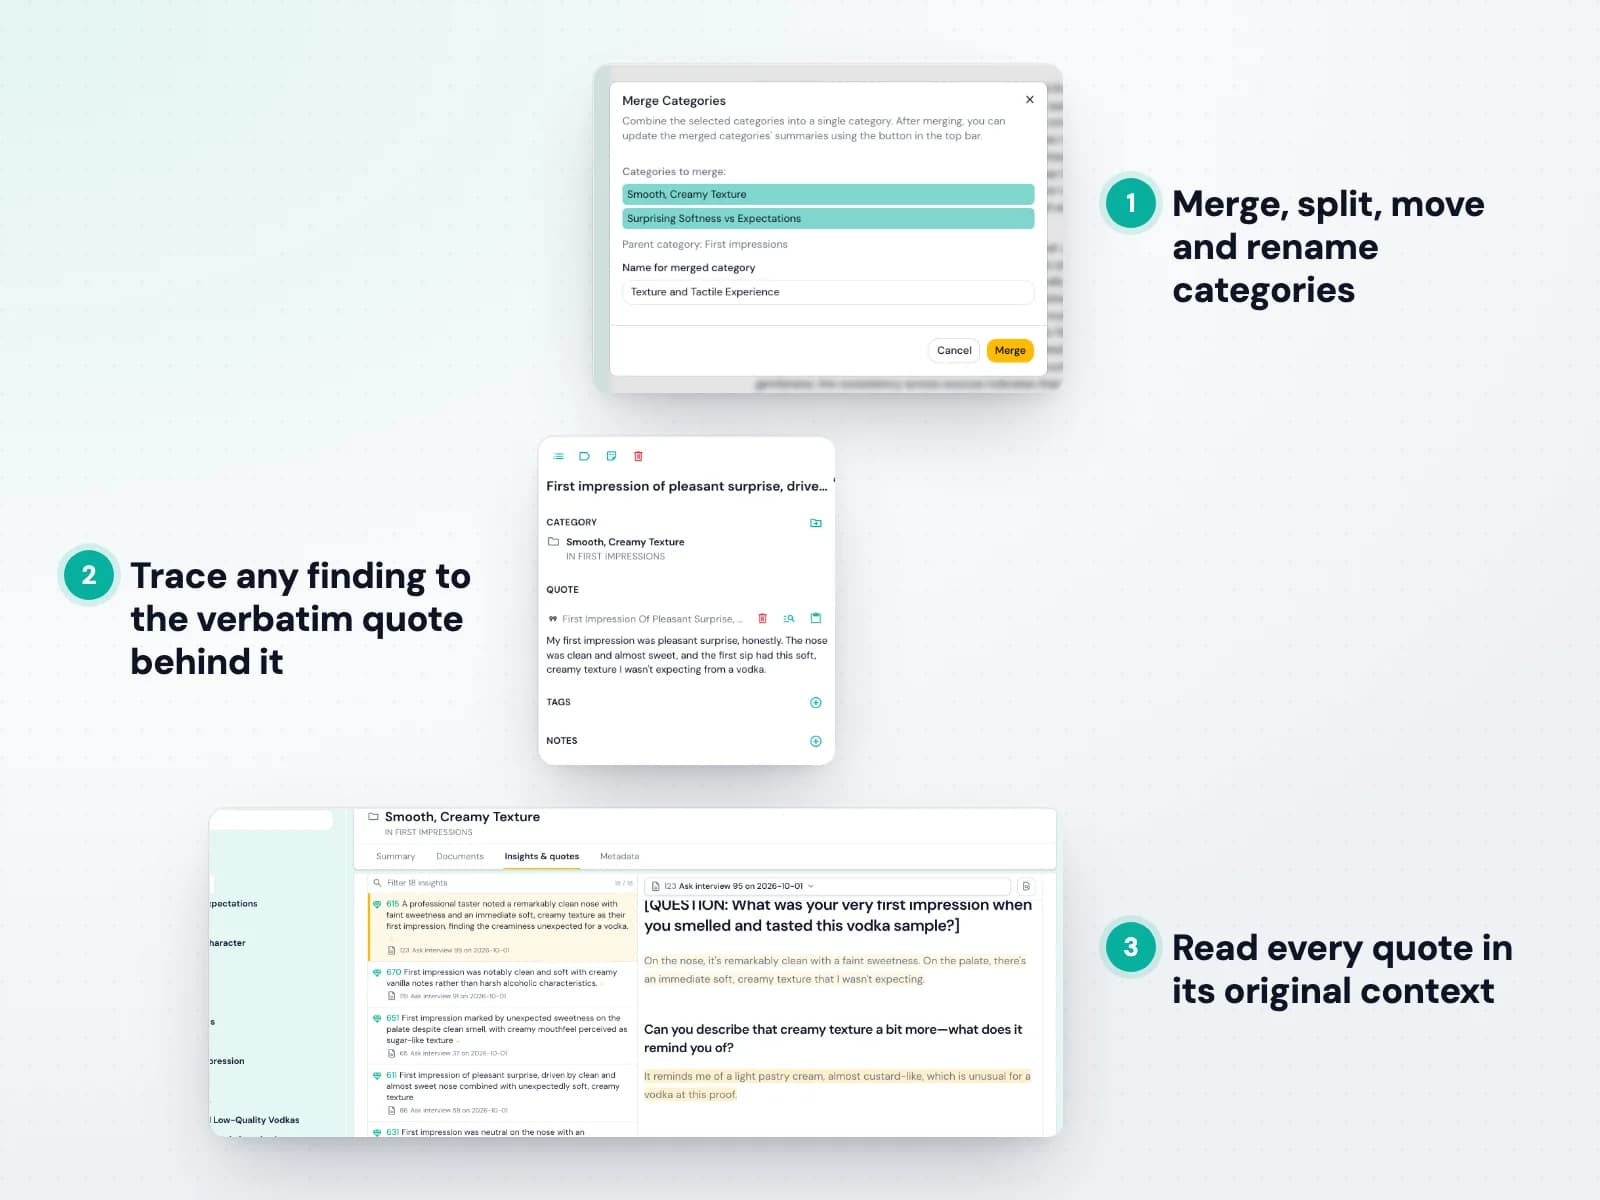
Skimle lager et hierarki av temaer, hvert knyttet til ordrette sitater fra de opprinnelige transkripsjonene. Ingenting blir diktet opp. Hver kode kan spores til tekst.
- 4. Finjuster etter ditt teoretiske rammeverk
Slå sammen, del opp, gi nytt navn og omorganiser kategorier slik at de passer den fremvoksende teoretiske modellen din. Åpenhet begge veier lar deg når som helst kontrollere hvilke sitater som støtter hvilke koder.
- 5. Eksporter til metodevedlegget ditt
Eksporter kategorisystemet ditt og sitatene som støtter det som tekst eller i det åpne REFI-QDA-formatet (.qdpx), som tradisjonelle CAQDAS-programmer som NVivo, ATLAS.ti og MAXQDA støtter.
Gjennomfør analyse med blandede metoder på tvers av utvalget
Kvalitative funn veier tyngre når du kan vise hvordan de varierer i utvalget: etter kull, rolle, kjønn, sted eller betingelse. Å krysstabulere temaer mot deltakernes egenskaper for hånd er tidkrevende og lett å gjøre feil. Skimle knytter metadata til hvert dokument og lar deg segmentere den samme temastrukturen etter en hvilken som helst variabel, slik at du kan veksle mellom rike ordrette sitater og tallfestede mønstre uten å legge noen av metodene til side.
Slik fungerer det
- 1. Knytt metadata til dokumentene
Merk hver transkripsjon med variablene som betyr noe for forskningsdesignet ditt (kull, rolle, kjønn, sted, måletidspunkt eller eksperimentell betingelse), manuelt eller fra en CSV-kolonne.
- 2. Kjør den kvalitative analysen
Skimle bygger ett temahierarki på tvers av alle dokumentene, slik at hver deltaker kodes mot den samme strukturen.
- 3. Segmenter temaer etter variabel
Se hvordan hvert tema varierer mellom grupper, og oppdag hvor et mønster er universelt eller særegent for ett kull.
- 4. Tallfest utbredelsen
Les av temafrekvenser og fordelinger for å rapportere hvor vanlig en kode er per segment, der hver opptelling kan spores tilbake til sitatene den bygger på.
- 5. Eksporter tabeller og sitater
Eksporter krysstabeller og støttende sitater til Excel eller Word for mixed methods-delen av artikkelen din.

Vanlige spørsmål
- Kan jeg sitere Skimle i forskningen min?
- Ja. Beskriv det i metodekapittelet som «programvare for AI-assistert kvalitativ koding», slik du ville oppgitt NVivo eller MAXQDA. Vi har en metodeartikkel til fagfellevurdering som vil gi en formell referanse, og inntil da kan vi foreslå en formulering på forespørsel.
- Godtar fagfellevurderere AI-assistert analyse?
- I økende grad ja, med god dokumentasjon. Revisjonssporet i Skimle gir fagfellene det de forventer: en dokumentert, systematisk kodeprosess der hvert tema kan spores til konkrete sitater, slik at metodekapittelet stort sett skriver seg selv.
- Hvordan står Skimle seg mot NVivo eller MAXQDA?
- NVivo og MAXQDA passer for forskere som har uker til analysen og en institusjonslisens. Skimle automatiserer den mekaniske kodefasen (fra uker til timer) og beholder den samme systematiske, åpne metodikken, og læringskurven er et spørsmål om minutter. Mange forskere bruker begge: Skimle til den første koderunden, NVivo til integrering av mixed methods.
- Fungerer Skimle for grounded theory?
- Ja. Skimle støtter induktiv koding der temaene vokser fram fra dataene i stedet for å bli bestemt på forhånd. Start med et bredt fokus og la kategoristrukturen utvikle seg iterativt, noe som ligger tett opp til åpen koding i grounded theory.
- Kan jeg gjennomføre en mixed methods-analyse?
- Ja. Knytt metadatavariabler til hvert dokument (kull, rolle, kjønn, sted, betingelse) og segmenter temastrukturen etter hvilken som helst av dem. Du får temafrekvenser og fordelinger per gruppe, hver sporbar til ordrette sitater, klare for mixed methods-delen av artikkelen din.
- Er forskningsdataene mine trygge?
- Transkripsjonene dine behandles på infrastruktur som driftes i EU, og brukes aldri til å trene AI-modeller. Vi tilbyr databehandleravtaler for institusjonelle etikkrav og kan imøtekomme de fleste krav til IT-sikkerhet. Kontakt oss med dine konkrete krav.
- Kan jeg få akademisk rabatt?
- Ja. Akademikere med gyldig e-postadresse fra institusjonen og en tilknytningsside kan kjøpe den rabatterte Skimle Academic-pakken. Kontakt oss om institusjonslisens hvis du trenger teamtilgang for en forskningsgruppe eller et laboratorium.
Laget for fagfolk, av fagfolk
Skimle har over 1 500 fornøyde brukere ved mer enn 50 universiteter, offentlige etater, byråer og bedrifter. Alle data lagres i EU og behandles i henhold til våre strenge GDPR-retningslinjer og tjenestevilkår.
Vil du vite mer? Utforsk bloggen Signal & Noise, vanlige spørsmål og bruksområder etter sektor. Vi viser også gjerne produktet eller ser på hvordan Skimle kan passe dine behov. Les mer om selskapet bak Skimle