دستههای از پیش تعیینشده
دستههایی را که باید استخراج شوند تعریف کنید، یا از پیشنهادهای Skimle انتخاب کنید، و بگذارید تحلیل اسناد شما را بر اساس آنها دستهبندی کند.
دستههای از پیش تعیینشده حالت تحلیلی است که وقتی میخواهید تصمیم بگیرید چه چیزی از دادههای شما به دست میآید، از آن استفاده میکنید. دستههایی را که باید استخراج شوند نامگذاری میکنید، Skimle هر سند را بر اساس آنها دستهبندی میکند، و سپس از آنچه یافته است زیردستهها میسازد.
این حالت هر دو سر دامنه استقرایی-قیاسی را پوشش میدهد. چارچوب دستهبندیای که از قبل دارید را وارد کنید و تحلیل قیاسی خواهد بود. از پیشنهادهای Skimle، یا از یک دسته کلی شروع کنید و بگذارید زیردستهها از دادهها پدیدار شوند، و تحلیل استقرایی خواهد بود. همان صفحه، همان گردش کار.
گام ۱: دستههای خود را انتخاب کنید
دو راه برای تکمیل فهرست دستهها وجود دارد که میتوانید آنها را با هم ترکیب کنید:
- دسته خودتان را اضافه کنید. روی دسته خودتان را اضافه کنید کلیک کنید و نام آن را مشخص کنید. این مسیر را در صورتی دنبال کنید که از قبل میدانید به دنبال چه چیزی هستید.
- از پیشنهادها انتخاب کنید. Skimle پروژه شما را میخواند و دستههایی را که از خود محتوا استخراج شدهاند پیشنهاد میدهد. برای افزودن هر یک، روی آن کلیک کنید. این مسیر را در صورتی دنبال کنید که میخواهید دادهها راه را نشان دهند.
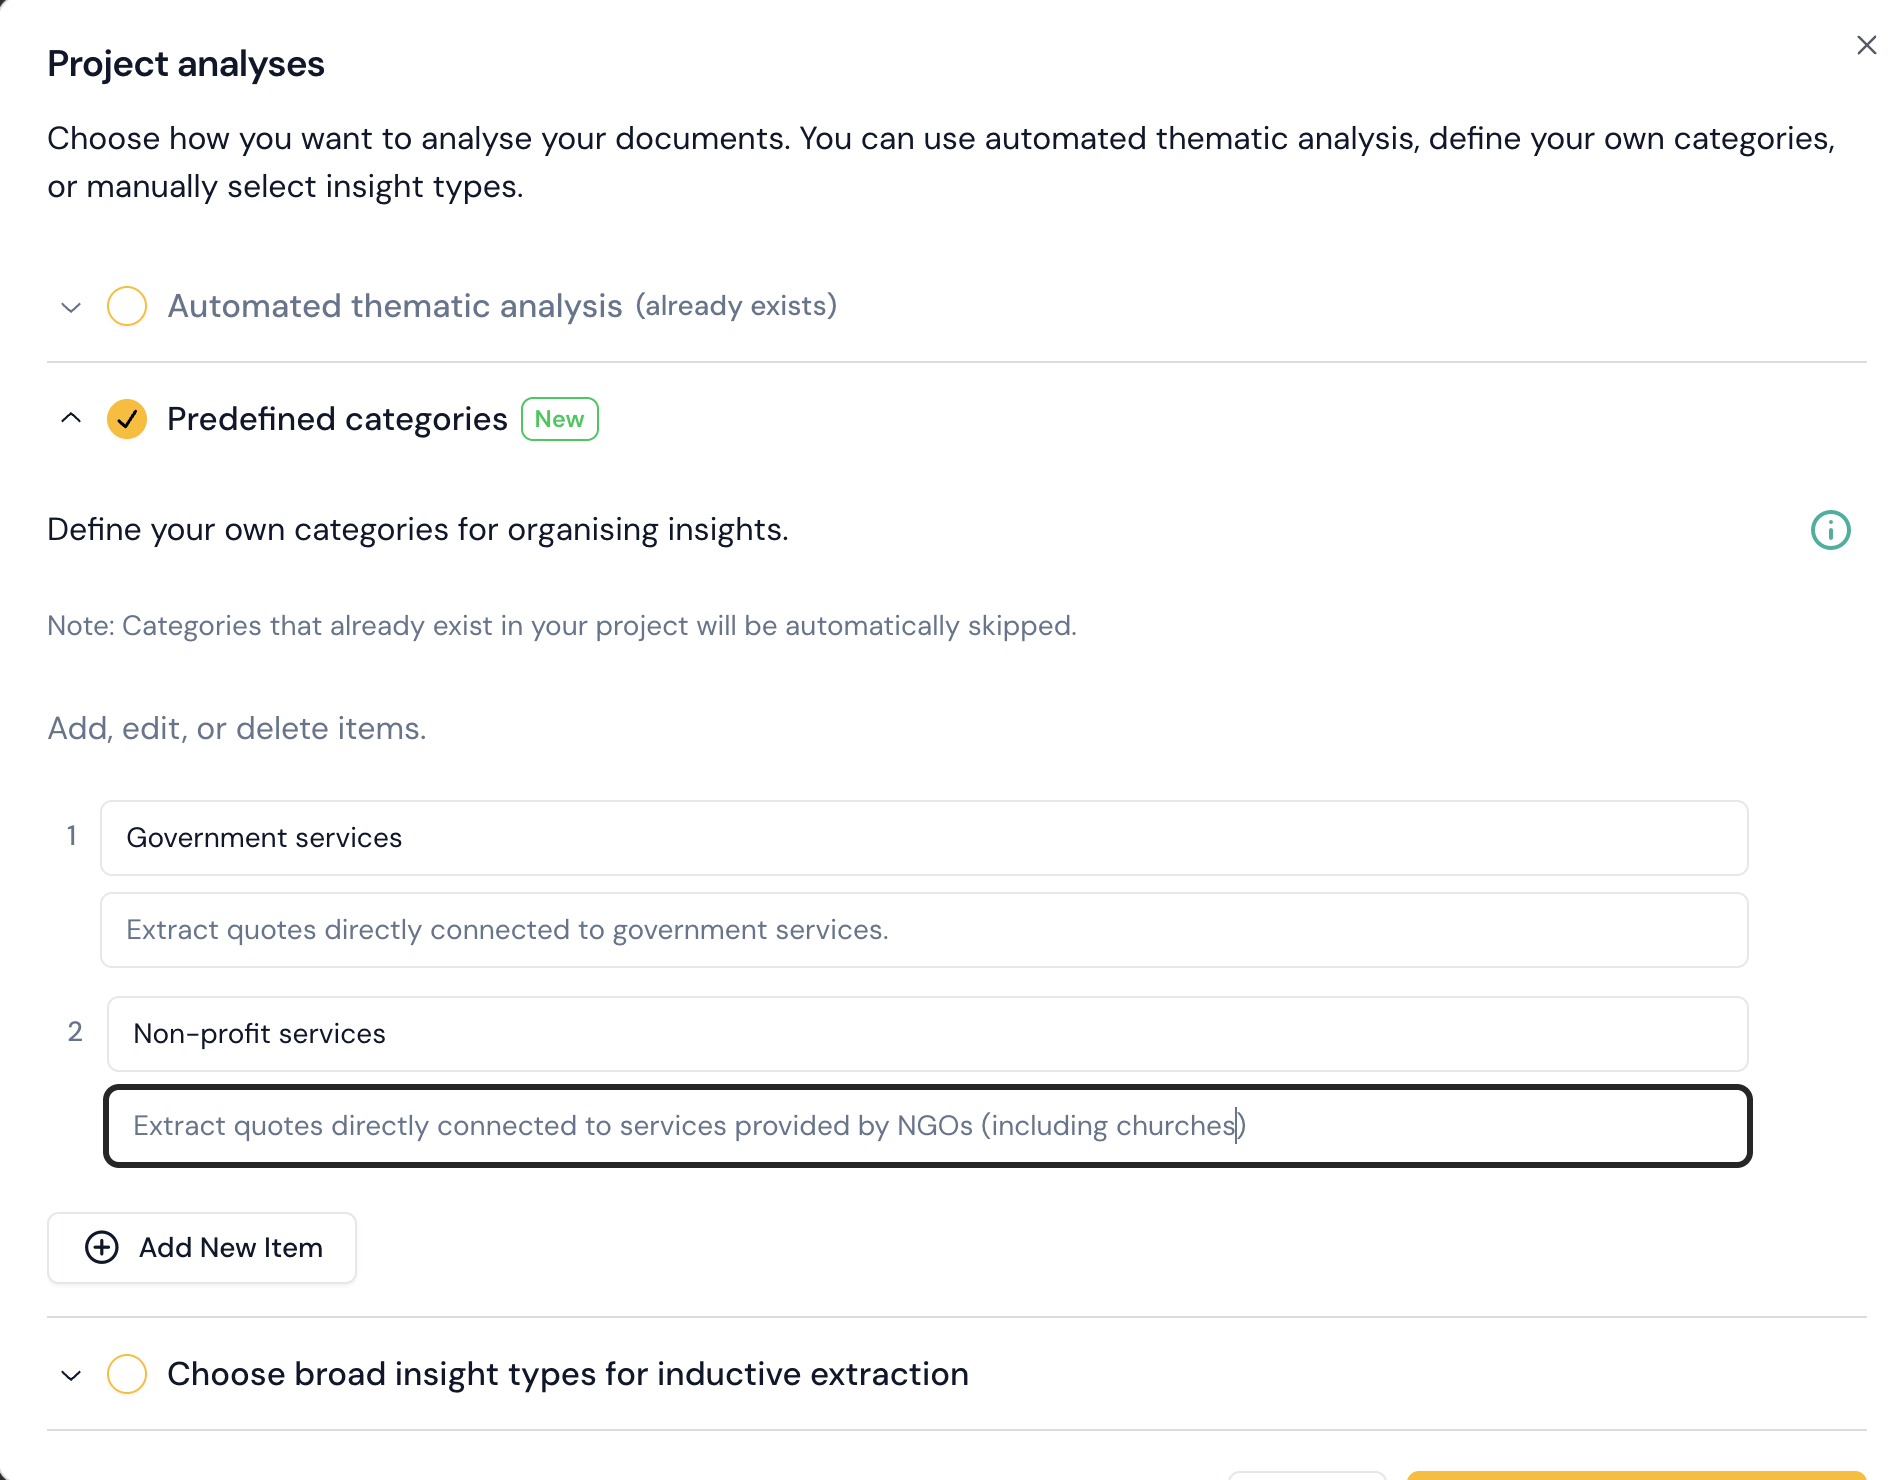
هر دسته میتواند دستورالعملهای اختیاری داشته باشد:
- دستورالعملها مشخص میکنند که هوش مصنوعی برای این دسته چه چیزی را استخراج کند و به شما امکان میدهند محتوای درجشده را گستردهتر یا محدودتر کنید.
- دستورالعملهای دستهبندی مشخص میکنند که بینشها چگونه در زیردستههای زیر آن مرتب شوند.
- نمونهها میتوانند تولید شوند تا پیش از اجرای کامل، پیشنمایشی از نوع بینشی که هوش مصنوعی پیدا خواهد کرد ارائه دهند.
دستهای که دستورالعملی ندارد نیز بهخوبی کار میکند. دستورالعملها زمانی بیشترین اهمیت را دارند که نام یک دسته بهتنهایی مبهم باشد، یا وقتی دو دسته هر دو بتوانند بهطور معقول یک قطعه متن یکسان را ادعا کنند.
گام ۲: استخراج داده
Skimle هر یک از اسناد شما را بررسی میکند و بینشهایی را که با دستهها و دستورالعملهای آنها مطابقت دارند استخراج میکند. هر نقلقول استخراجشده در برابر سند منبع بررسی میشود، بنابراین نقلقولی که عیناً در متن اصلی وجود نداشته باشد هرگز به تحلیل شما نمیرسد.
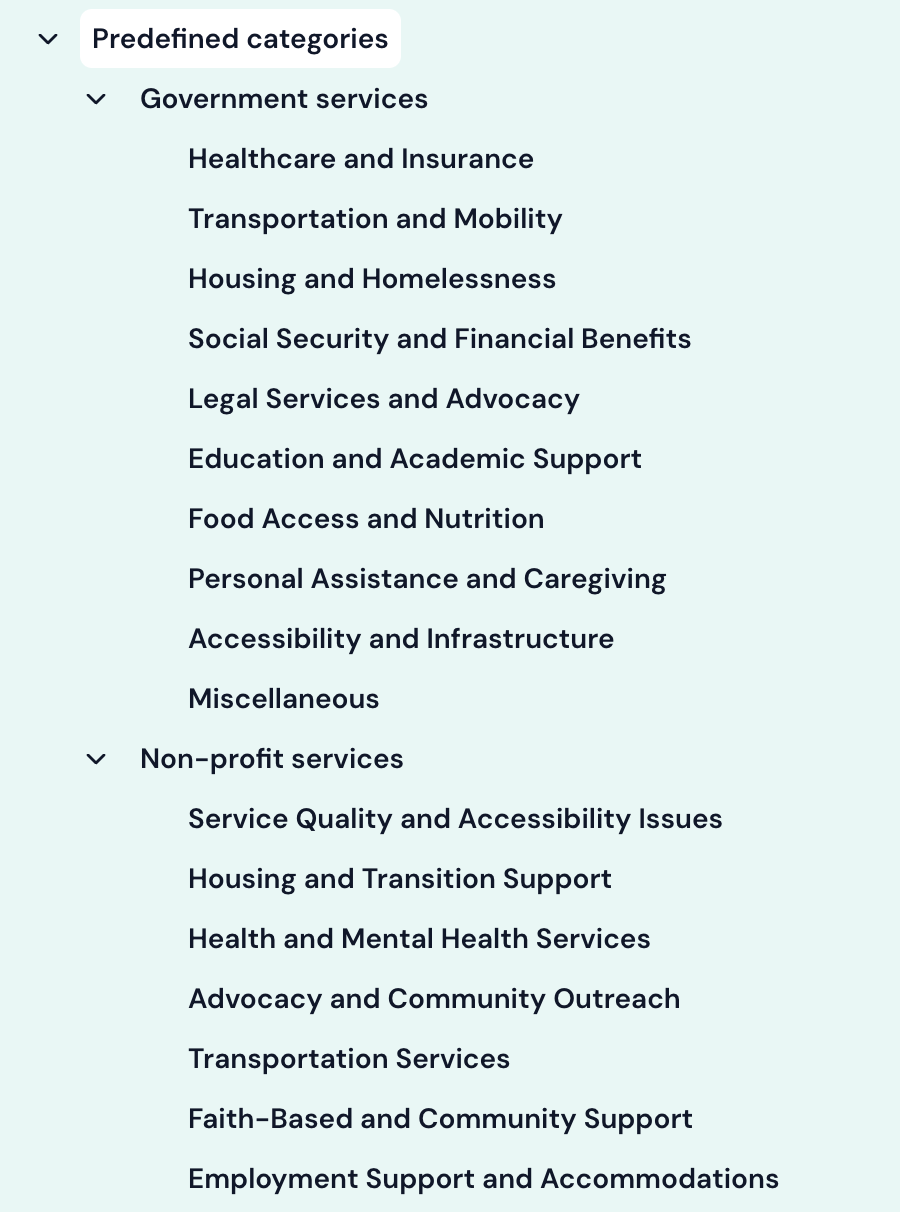
گام ۳: زیردستهها از بینشها شکل میگیرند
Skimle بینشهای اختصاصیافته به هر دسته را بررسی میکند و زیردستهها را میسازد، سپس هر بینش را به مناسبترین زیردسته منتقل میکند. این همان جایی است که یک تحلیل استقرایی ساختار خود را به دست میآورد: شما کانون کلی را مشخص میکنید، و سطح پایینتر از دادهها شکل میگیرد.
توجه: زیردستهها فقط در صورتی شکل میگیرند که تعداد قابلتوجهی از بینشها به دسته اختصاص یافته باشد. دستهای که تنها تعداد اندکی بینش به خود جذب کرده باشد، بدون زیردسته باقی میماند که معمولاً نشانه آن است که دسته بیش از حد محدود بوده یا این محتوا در دادهها وجود ندارد.
گام ۴: خلاصههای دسته
پس از دستهبندی دادهها، Skimle برای هر دسته خلاصهای مینویسد. این خلاصهها در نمای دستهها قابل مشاهدهاند، جایی که میتوانید هر چیزی را که تحلیل تولید کرده است نیز تغییر نام دهید، ادغام کنید، تقسیم کنید و دوباره سازماندهی کنید.
وارد کردن فایل CSV
هنگامی که یک فایل CSV وارد میکنید، نام ستونهای «محتوا» ذخیره میشود و برای ایجاد دستههای پیشفرض این نوع تحلیل استفاده میشود. این یک دلیل دیگر برای تعیین یک ردیف سرستون روشن و آموزنده برای دادههای خود پیش از وارد کردن آن است. برای اطلاعات بیشتر در مورد نحوه کار وارد کردن CSV، به فرمتهای فایل پشتیبانیشده و وارد کردن CSV مراجعه کنید.
چه زمانی از آن استفاده کنیم
هر وقت میدانید تحلیل باید در سطح دسته به چه پرسشی پاسخ دهد، از دستههای از پیش تعیینشده استفاده کنید، خواه دستهها از چارچوب خودتان بیایند یا از پیشنهادهای Skimle. اگر اسناد شما ساختار مشترکی دارند و میخواهید دستهها بدون هیچ ورودیای از آن ساختار ساخته شوند، تحلیل موضوعی خودکار سریعتر است. اگر بهجای یک درخت دستهبندی، پاسخی تحلیلی و نوشتاری به یک سؤال پژوهش میخواهید، از تحلیل عاملمحور استفاده کنید.