اولین پروژه شما
راهنمای گامبهگام و دوستانه: یک پروژه بسازید، دادههای خود را اضافه کنید، نوع تحلیل مناسب را انتخاب کنید و نتایج خود را در Skimle کاوش کنید.
خوش آمدید! این صفحه شما را از یک صفحه خالی تا یک تحلیل دستهبندیشده و قابل کاوش، در اولین پروژه Skimle همراهی میکند. حدود پانزده دقیقه از وقت شما را میگیرد، بهعلاوه مدتی کوتاه انتظار تا Skimle اسناد شما را بخواند.
چهار مرحله وجود دارد:
| مرحله | کاری که انجام میدهید | زمان |
|---|---|---|
| ۱. ایجاد یک پروژه | روی پروژه جدید کلیک کنید و نامی برای آن انتخاب کنید | چند ثانیه |
| ۲. افزودن دادههای خود | اسناد، ضبطها یا یک صفحهگسترده بارگذاری کنید، سپس آنها را تأیید کنید | چند دقیقه |
| ۳. انتخاب یک تحلیل | انتخاب کنید Skimle دادههای شما را چگونه بخواند | یک دقیقه برای راهاندازی، چند دقیقه برای اجرا |
| ۴. کاوش نتایج شما | دستهها، نقلقولها، نمودارها و اسناد را مرور کنید و از چت بپرسید | هر چقدر که دوست دارید |
مرحله ۱: ایجاد یک پروژه
در صفحه اصلی، در گوشه بالا راست بخش پروژههای شما روی پروژه جدید کلیک کنید.
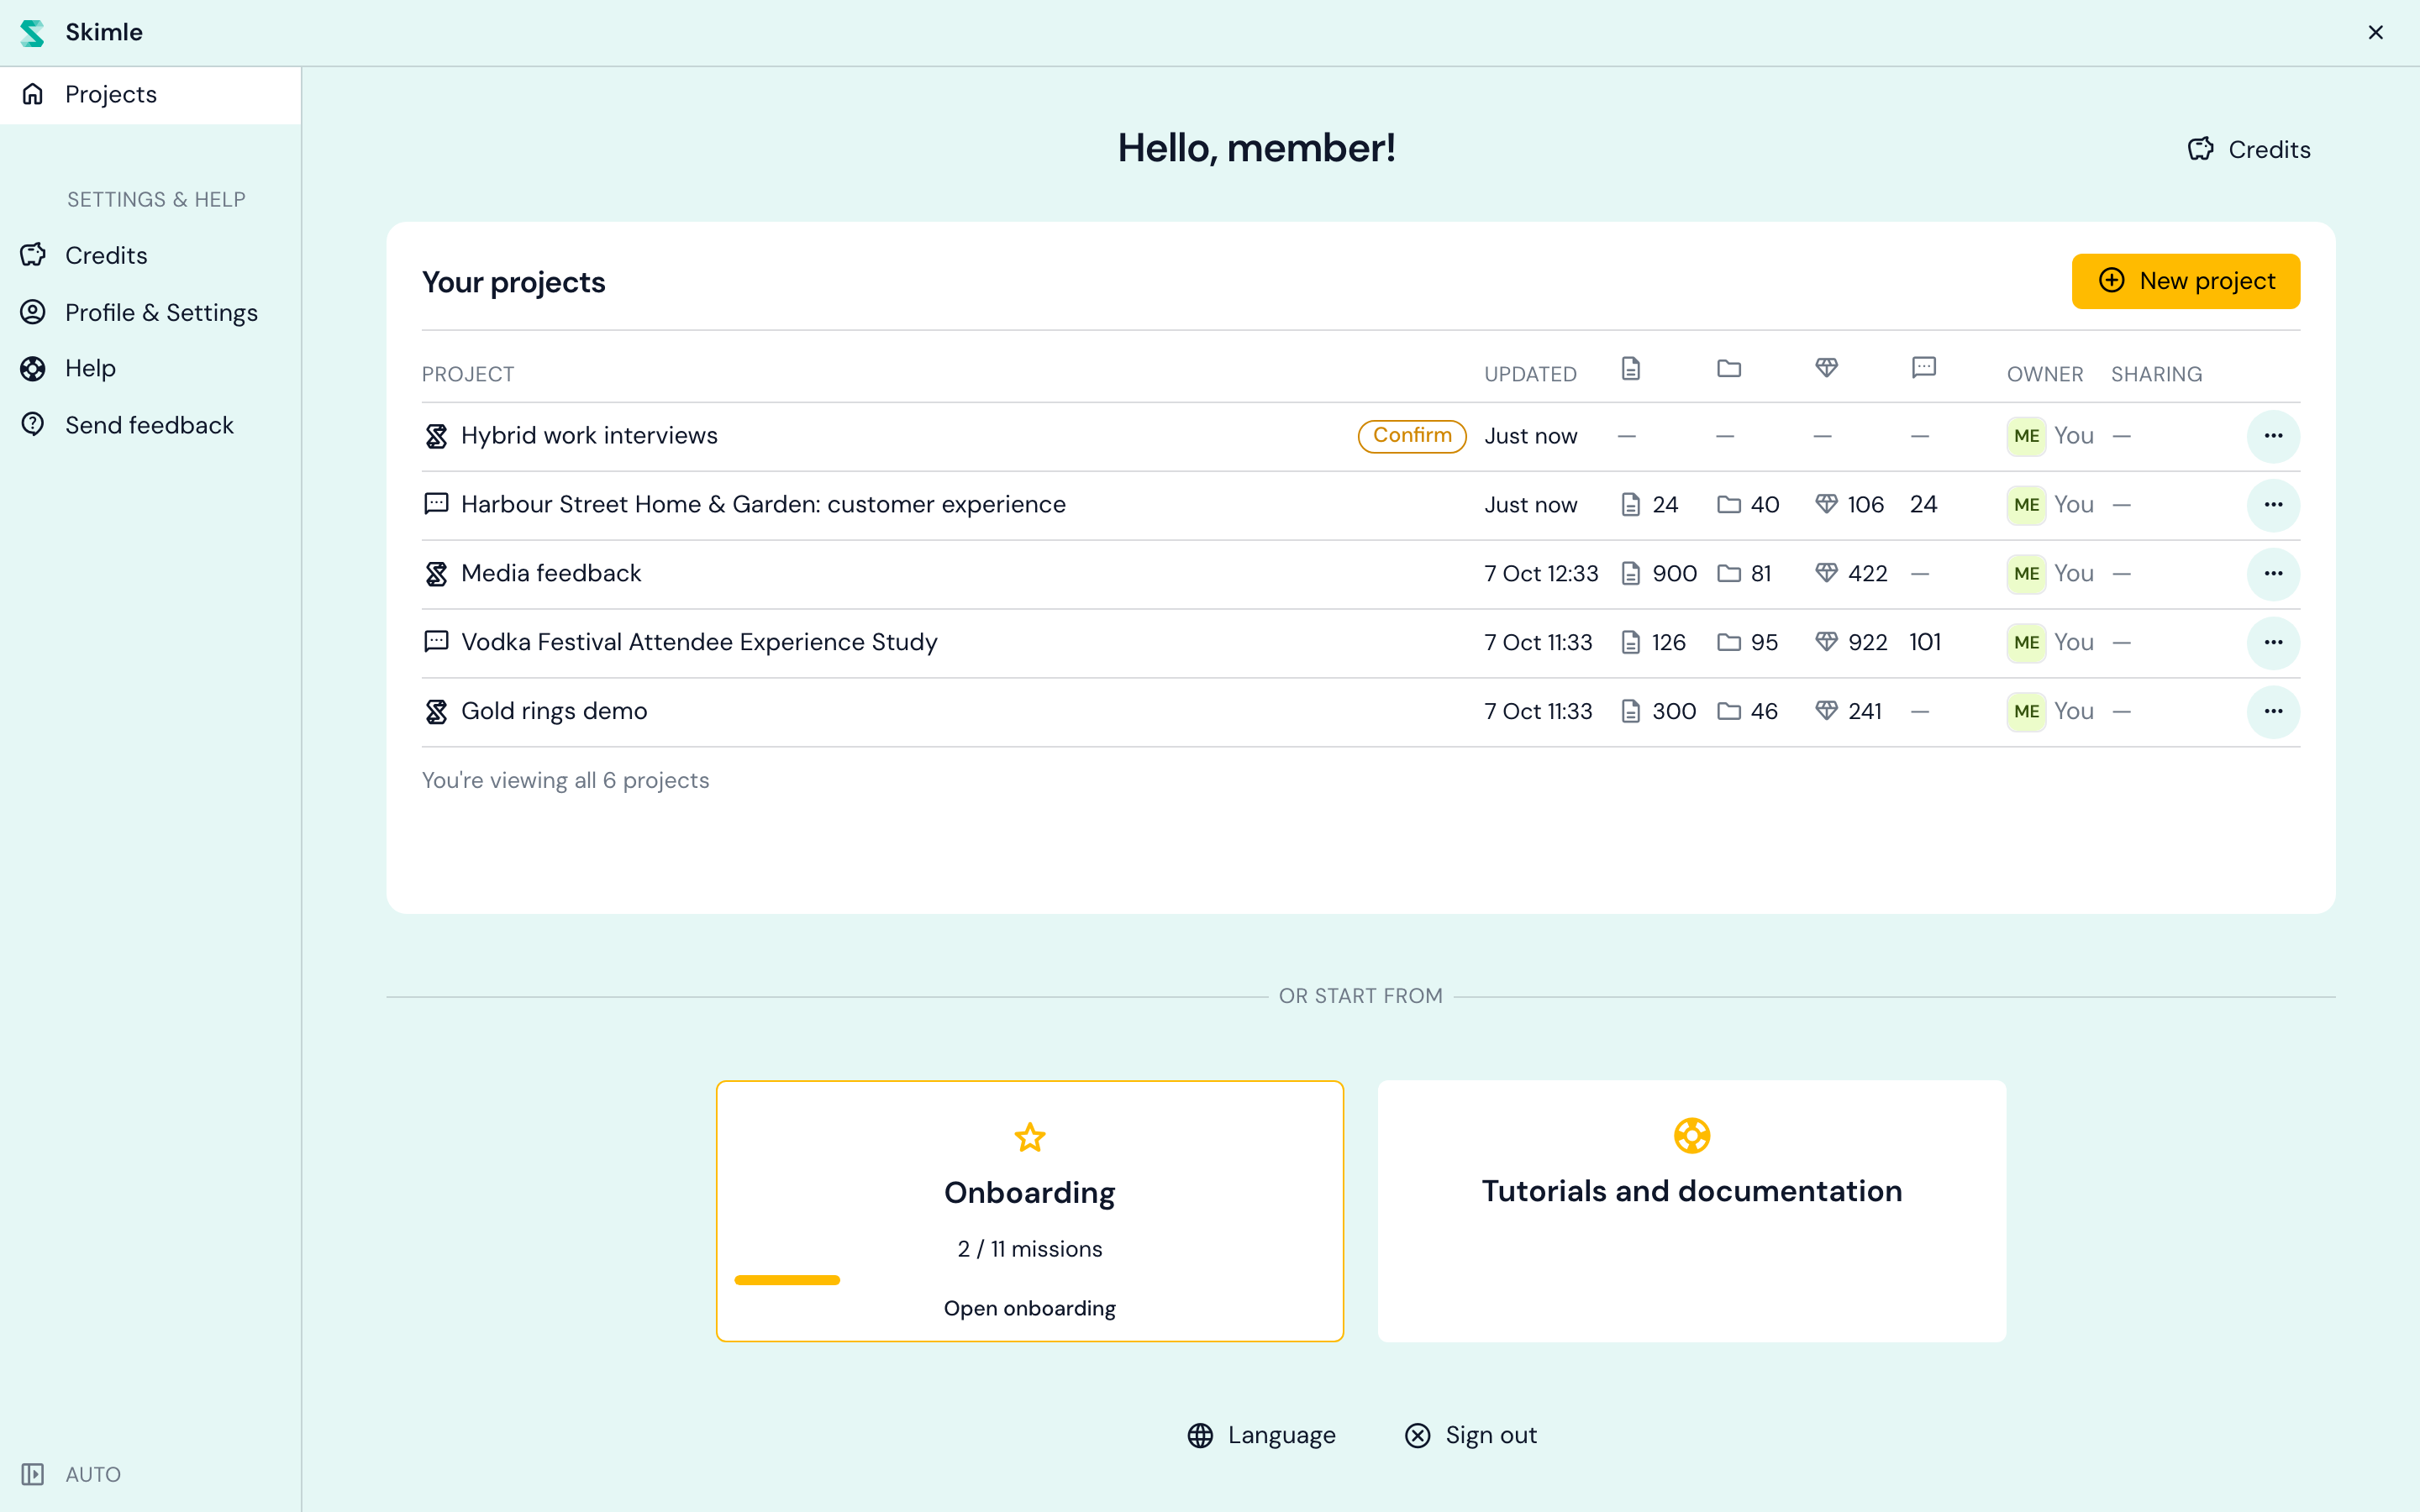
Skimle بلافاصله پروژه را ایجاد میکند و شما را به صفحه منابع داده آن میبرد. این پروژه زندگی خود را با نام «پروژه بدون عنوان» آغاز میکند: روی نام آن در نوار بالا کلیک کنید تا آن را به چیزی که بعداً آن را تشخیص خواهید داد تغییر دهید، مثلاً «مصاحبههای کار ترکیبی».
مرحله ۲: افزودن دادههای خود
یک پروژه جدید با صفحه بیایید کمی داده اضافه کنیم! باز میشود. یک منبع داده یک مجموعه از مطالب است که آن را به پروژه اضافه میکنید و با هم تحلیل میکنید، و یک پروژه میتواند چند مورد از اینها را داشته باشد (مثلاً مصاحبهها و خروجی یک نظرسنجی).
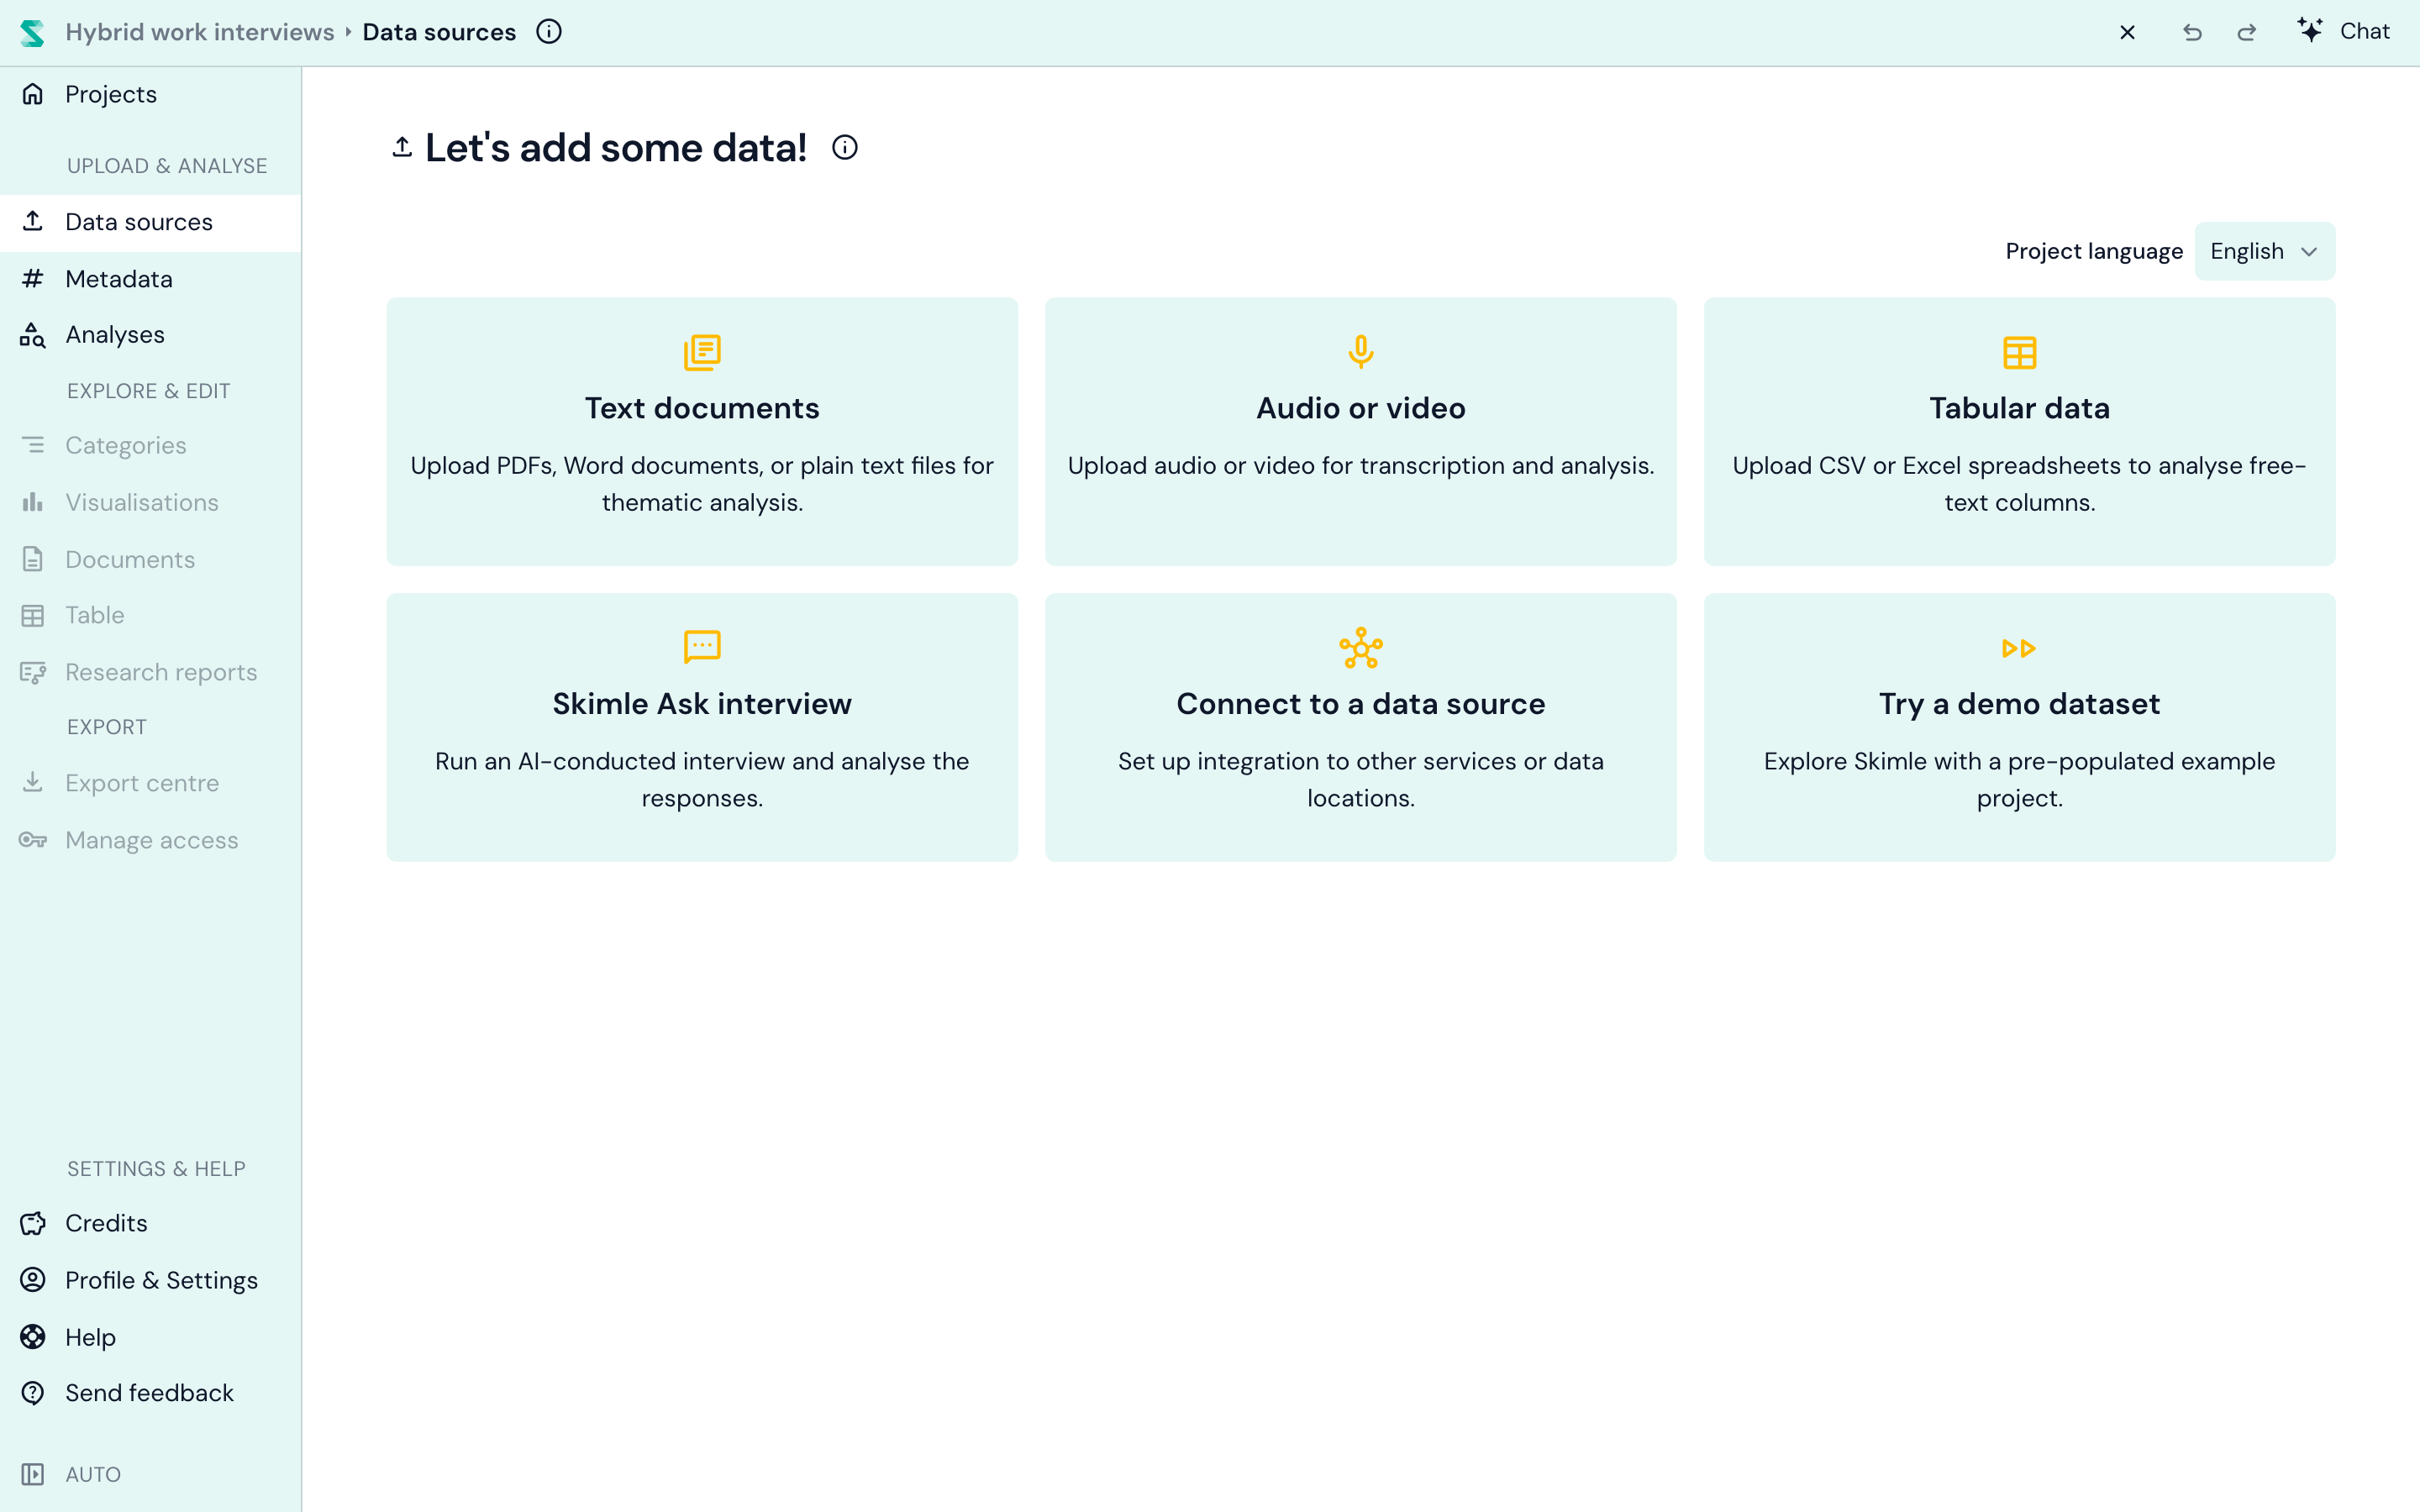
ابتدا، زبان پروژه را در گوشه بالا راست بررسی کنید. این زبان، زبان همه چیزی را که Skimle برای شما مینویسد تعیین میکند: نام دستهها، خلاصهها، گزارشها. اسناد شما میتوانند به هر زبانی باشند، و میتوانید در یک پروژه چند زبان را با هم ترکیب کنید. پس از افزودن اسناد، زبان پروژه قابل تغییر نیست، پس ارزش دارد که همین الان نگاهی به آن بیندازید.
سپس نوع دادهای که دارید را انتخاب کنید:
| منبع داده | استفاده از آن برای |
|---|---|
| اسناد متنی | متن مصاحبهها، گزارشها، یادداشتها، مقالهها. فایلهای PDF، Word، PowerPoint، Markdown، RTF، متن ساده و Excel را میپذیرد. |
| صدا یا ویدیو | ضبط مصاحبهها و گروههای کانونی. Skimle آنها را با جداسازی گویندگان رونویسی میکند، سپس متن رونویسیشده را تحلیل میکند. |
| دادههای جدولی | یک خروجی CSV یا Excel که در آن هر ردیف یک پاسخ است، مانند پاسخهای باز نظرسنجی، نظرات یا تیکتهای پشتیبانی. هر ردیف به یک سند تبدیل میشود، و شما انتخاب میکنید کدام ستونها محتوا هستند و کدامها به فراداده تبدیل میشوند. به قالبهای پشتیبانیشده و درونریزی CSV مراجعه کنید. |
| مصاحبه Skimle Ask | یک مصاحبه انجامشده با هوش مصنوعی که برای شرکتکنندگان ارسال میکنید. پاسخهای آنها بهصورت اسناد وارد پروژه میشوند. |
| اتصال به یک منبع داده | وارد کردن داده از یک سرویس یا محل داده دیگر. |
| آزمایش یک مجموعه داده نمایشی | یک پروژه نمونه از پیش آماده، اگر میخواهید قبل از بارگذاری چیزی از خودتان، کمی اطراف را ببینید. |
برای اولین پروژه، اسناد متنی سادهترین شروع است. فایلهای خود را به ناحیه بارگذاری بکشید (یا برای مرور کردن روی آن کلیک کنید)، و هر تعداد که دوست دارید یکجا اضافه کنید.
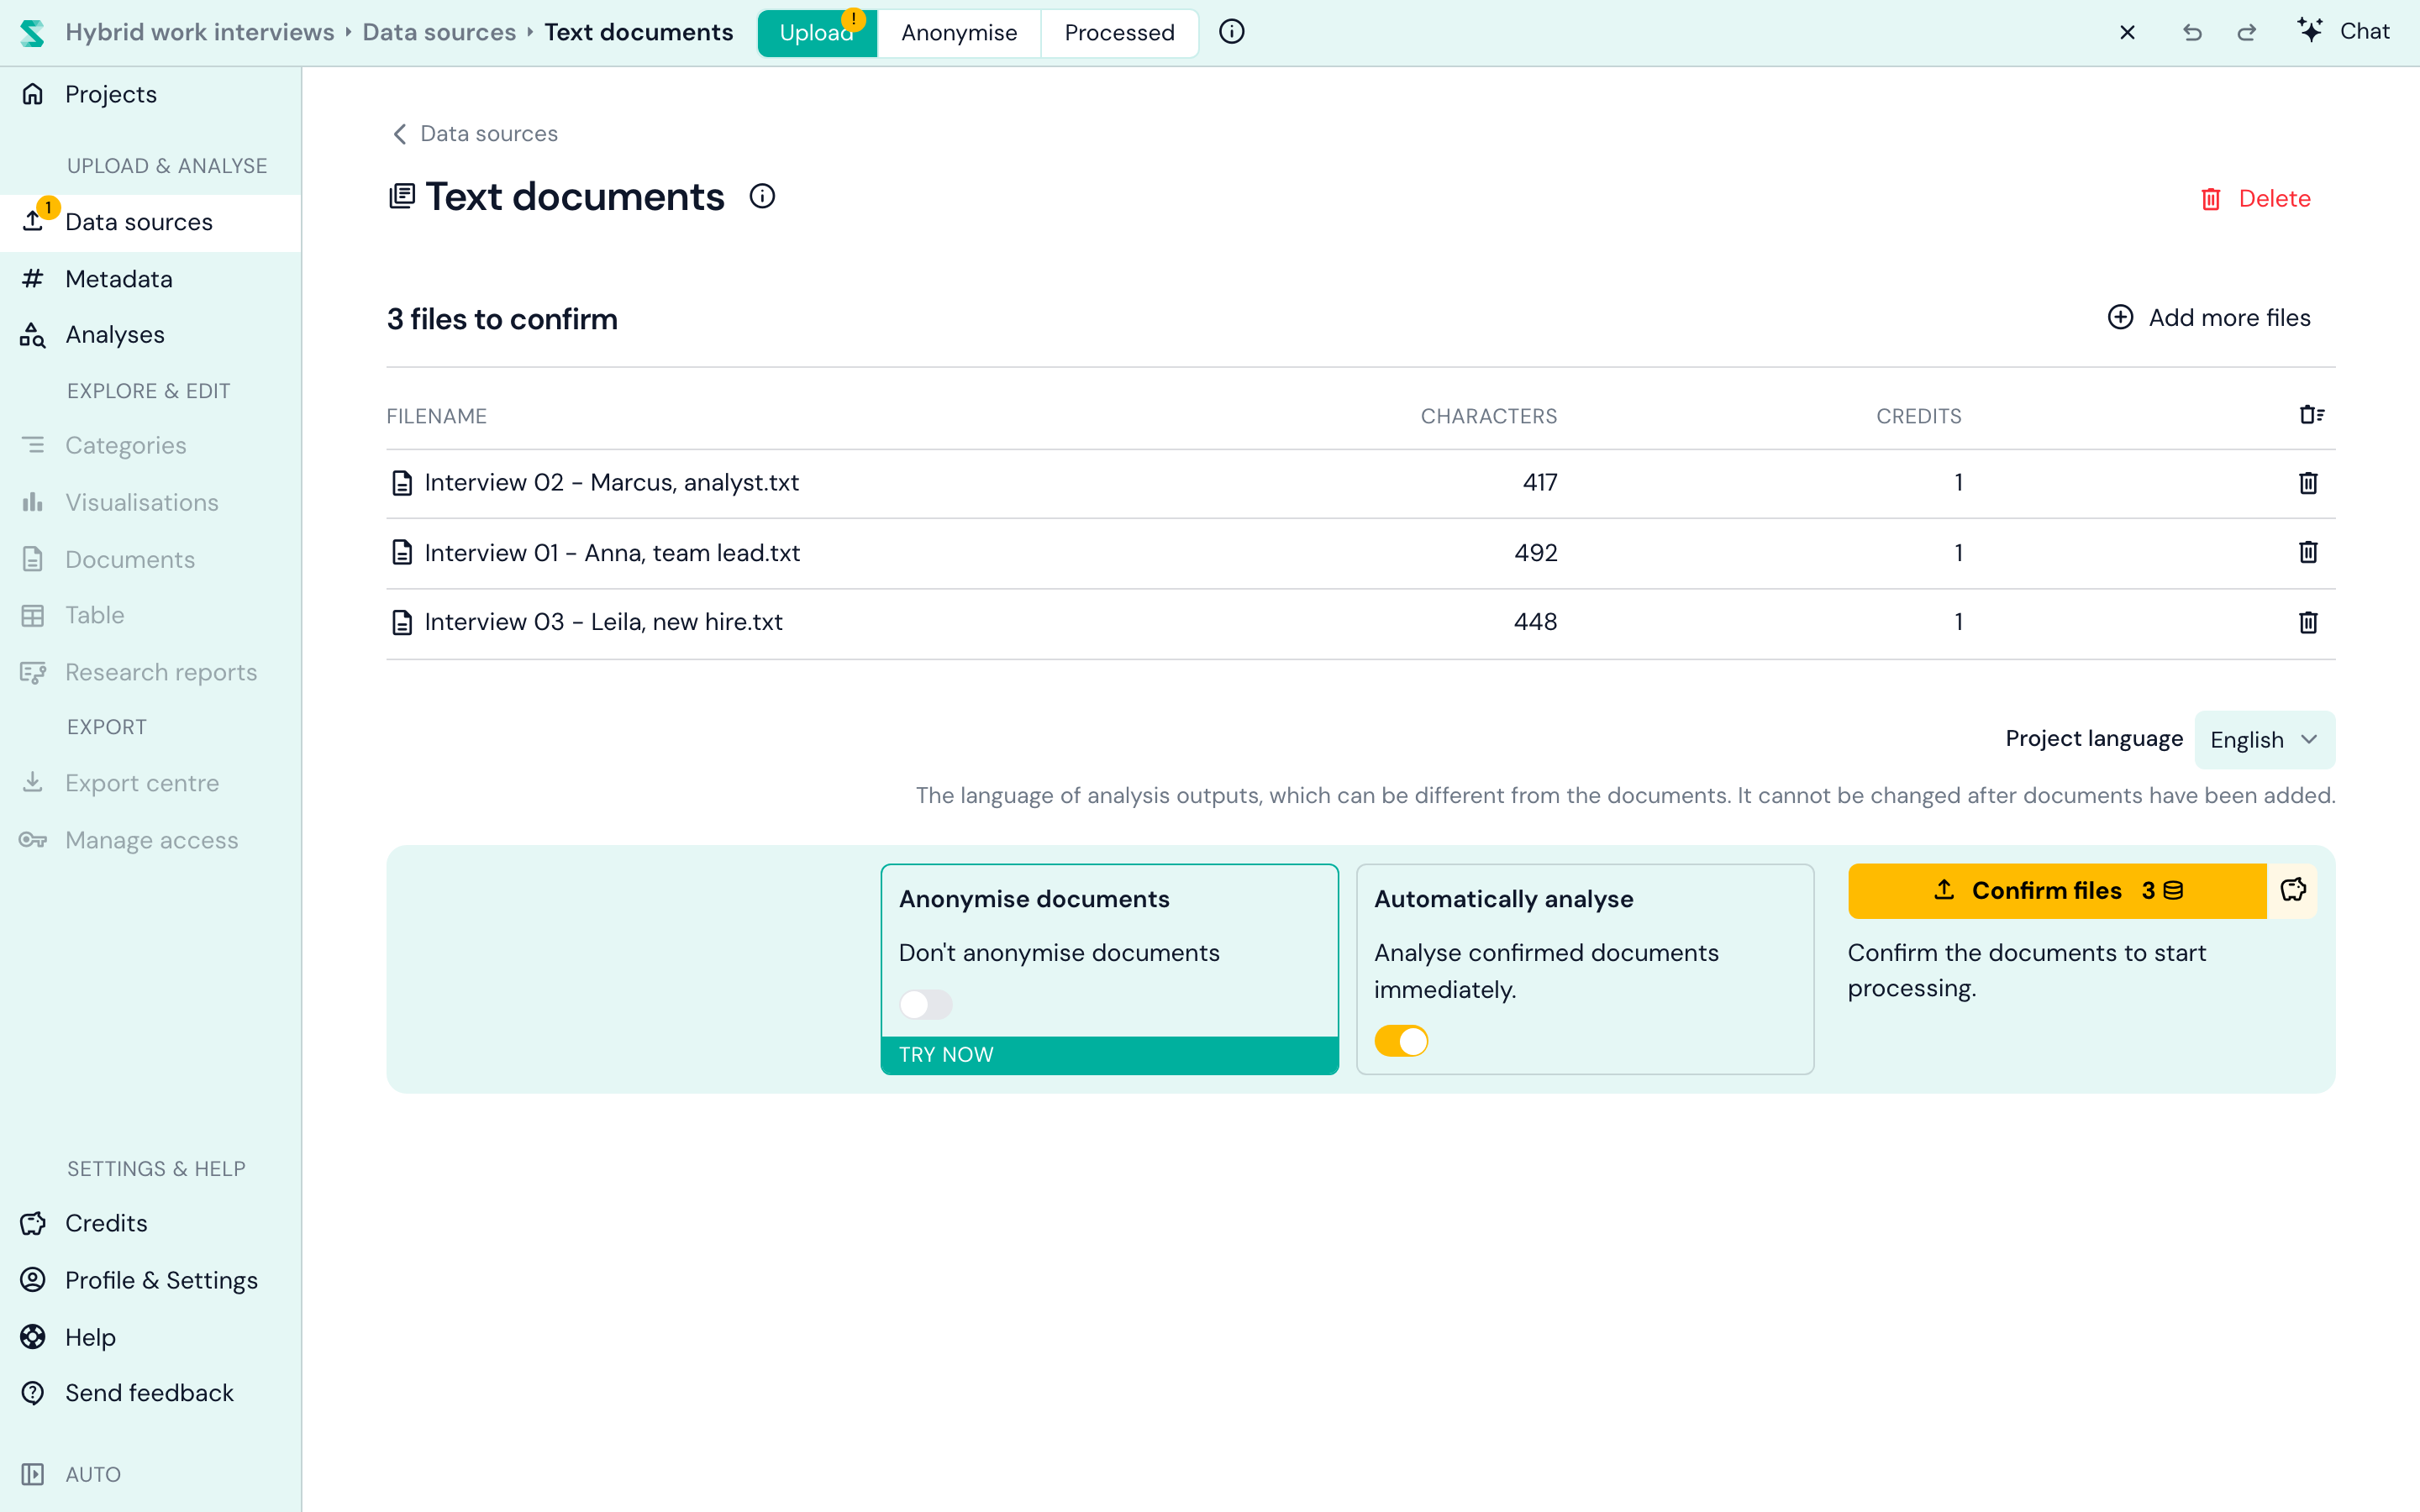
فایلهای شما اکنون در فهرستی برای تأیید منتظر هستند و طول هر یک و اعتبارهایی که هرکدام هزینه دارد را نشان میدهند. پیش از تأیید، دو تنظیم ارزش دانستن دارند:
- ناشناسسازی اسناد نامها و دیگر جزئیات شناساییکننده را پیش از تحلیل حذف میکند. این گزینه بهطور پیشفرض خاموش است؛ برای گزینهها به ناشناسسازی اسناد مراجعه کنید.
- تحلیل خودکار تحلیلهای پروژه شما را بر روی اسناد جدید، بهمحض پردازششدن آنها اجرا میکند. این گزینه بهطور پیشفرض روشن است و برای همه منابع داده پروژه اعمال میشود. این فقط زمانی اثر دارد که پروژه حداقل یک تحلیل داشته باشد، پس در یک پروژه کاملاً جدید هنوز چیزی اجرا نمیشود: شما اولین تحلیل خود را در مرحله بعد انتخاب میکنید. اگر ترجیح میدهید خودتان بهصورت دستی انتخاب کنید کدام اسناد وارد یک تحلیل شوند، آن را خاموش کنید.
وقتی راضی بودید، روی تأیید فایلها کلیک کنید. این همان لحظهای است که اعتبارها مصرف میشوند (به قیمتگذاری مراجعه کنید). برای اکثر پروژهها، اینها تنها اعتبارهایی هستند که برای آن اسناد تا به حال نیاز خواهید داشت: بهمحض اینکه یک سند در پروژه شما قرار گیرد، میتوانید آن را هر چند بار و به هر شکلی که دوست دارید بدون هزینه اضافی تحلیل کنید.
دادهای در دسترس ندارید؟ مجموعه داده نمایشی را آزمایش کنید، یا فهرست ما از مجموعه دادههای رایگان برای پژوهش کیفی را مرور کنید، از آرشیوهای مصاحبه تا سخنرانیهای پارلمانی.
مرحله ۳: انتخاب یک تحلیل
تحلیلها را در منوی سمت چپ باز کنید. در یک پروژه جدید، افزودن اولین تحلیل به پروژه خود را با پنج گزینه خواهید دید.
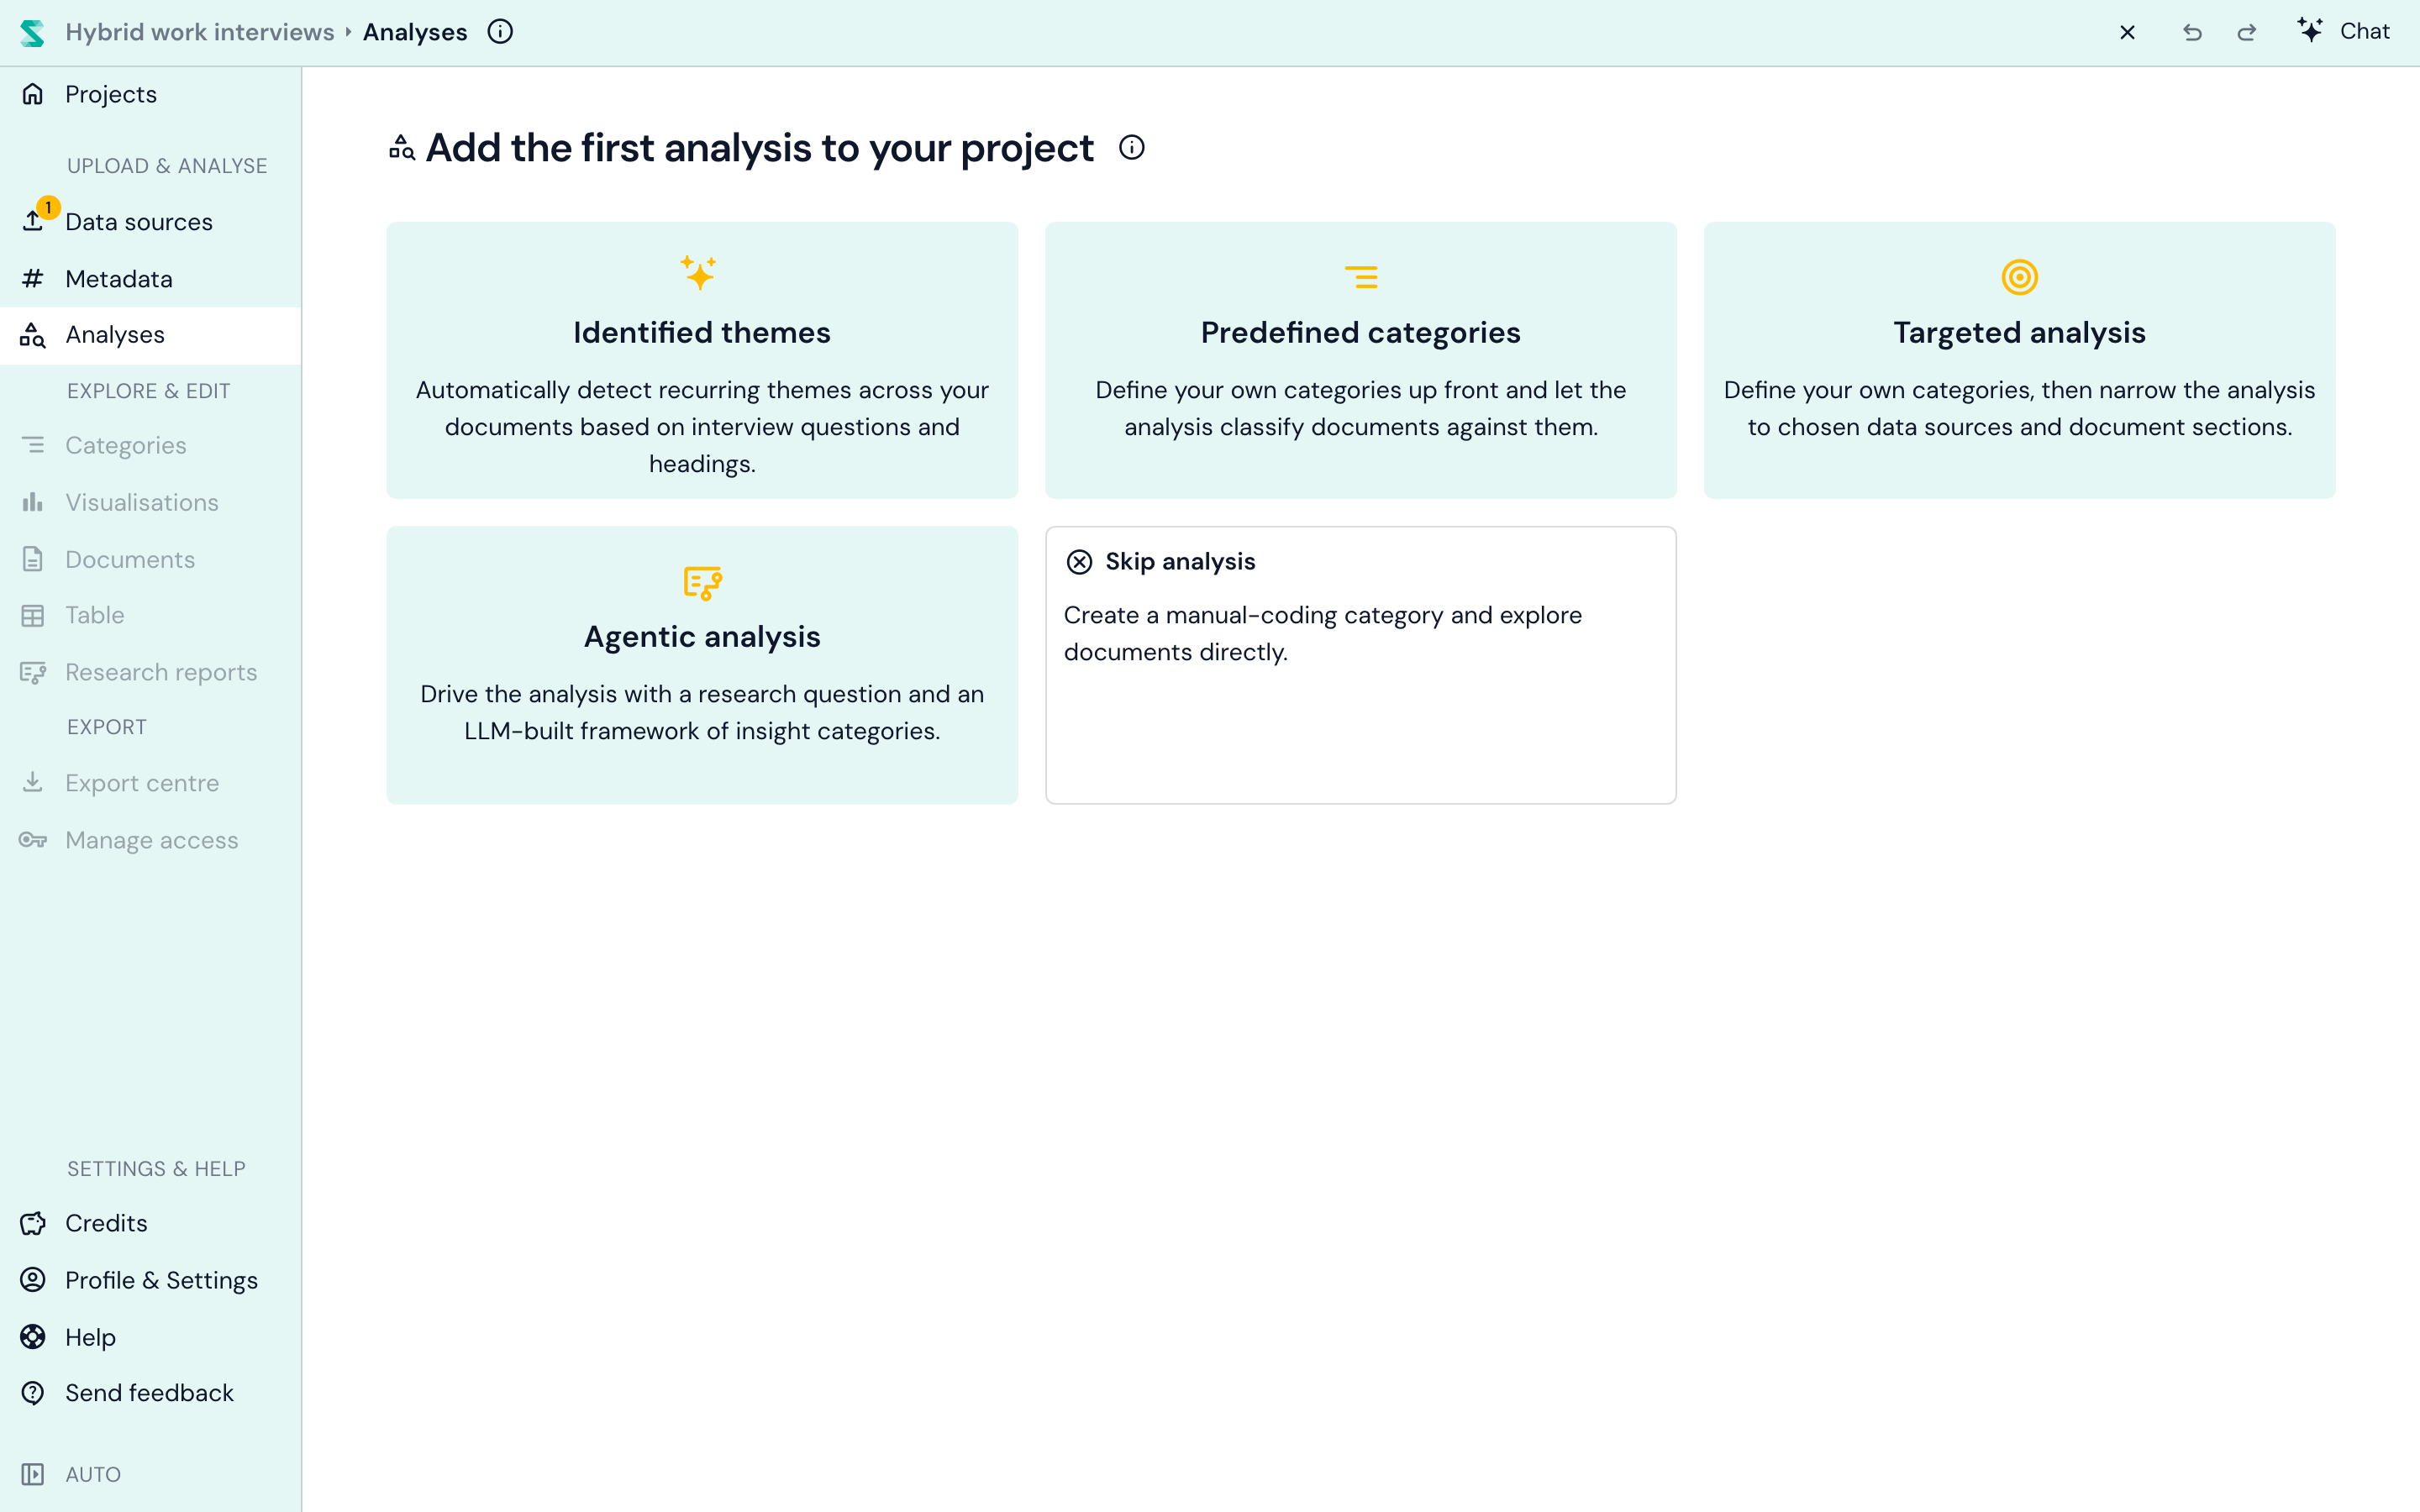
هر کدام به یک پرسش متفاوت درباره دادههای شما پاسخ میدهند. در ادامه نسخه کوتاه آن آمده است:
| تحلیل | زمانی آن را انتخاب کنید که میخواهید... | شما ارائه میدهید | شما به دست میآورید |
|---|---|---|---|
| موضوعهای شناساییشده | ببینید در داده چه چیزی وجود دارد، بدون هیچ راهاندازی | هیچچیز | موضوعهایی بر اساس پرسشها و تیترهای اسناد شما، همراه با زیرموضوعها و نقلقولها |
| دستههای از پیش تعیینشده | دادهها را بر اساس دستههایی که انتخاب میکنید دستهبندی کنید | نام دستهها (دستههای خودتان یا پیشنهادهای Skimle) | دستههای شما، پر از بینشها، و زیردستههایی که از داده پدیدار میشوند |
| تحلیل هدفمند | هر دسته را به سوی پرسشها، بخشها یا ستونهای مشخصی هدفگیری کنید | دستهها، بههمراه بخشهایی از هر سند که باید خوانده شود | همان دستههای از پیش تعیینشده، اما فقط از جایی که مشخص کردهاید خوانده میشود |
| تحلیل عاملمحور | به یک سؤال پژوهش پاسخ دهید | یک سؤال پژوهش | یک چارچوب، شواهد دستهبندیشده، موضوعهای تحلیلی و یک گزارش نوشتهشده |
| رد کردن تحلیل | بهصورت دستی دستهبندی کنید | هیچچیز | یک دسته خالی برای شروع کدگذاری دستی |
مطمئن نیستید؟ با موضوعهای شناساییشده شروع کنید. این گزینه نیاز به هیچ راهاندازی ندارد و نقشه خوبی از هر مطلب شبیه به مصاحبه در اختیار شما قرار میدهد. میتوانید هر یک از گزینههای دیگر را بعداً روی همان اسناد اضافه کنید، بدون هزینه اضافی.
موضوعهای شناساییشده: بگذارید دادهها خودشان حرف بزنند
این گزینه «بدون پرامپت» Skimle است. Skimle پرسشها و تیترهای مشترک میان اسناد شما را پیدا میکند، آنها را به مجموعهای موجز از موضوعها تبدیل میکند، برای هر یک از آنها از تمام اسناد بینش استخراج میکند و آنها را در زیرموضوعها گروهبندی میکند. این گزینه بهترین عملکرد را زمانی دارد که اسناد شما ساختار مشابهی داشته باشند، همانطور که مصاحبههای برگرفته از یک راهنمای مصاحبه دارند.
هر پروژه فقط یک تحلیل موضوعهای شناساییشده دارد، به همین دلیل پس از افزودن آن، کارت آن ناپدید میشود. برای اطلاعات بیشتر به تحلیل مضمون خودکار مراجعه کنید، یا ببینید چگونه در یک روش کامل جای میگیرد: چگونه با هوش مصنوعی تحلیل مضمون انجام دهیم و چگونه موضوعها را در میان مصاحبهها بیابیم.
دستههای از پیش تعیینشده: مشخص کنید چه چیزی به دست میآید
در اینجا نام دستههایی که میخواهید را مشخص میکنید، و Skimle هر سند را بر اساس آنها دستهبندی میکند. روی دسته خودتان را اضافه کنید کلیک کنید، یا از پیشنهادهایی که Skimle از دادههای شما استخراج میکند انتخاب کنید. هر دسته میتواند دستورالعملهایی درباره آنچه باید شامل شود داشته باشد، و زیردستهها از آنچه Skimle پیدا میکند شکل میگیرند.
این باعث میشود که این روش از هر دو جهت کار کند: یک چارچوب دستهبندی موجود را وارد کنید و تحلیل قیاسی میشود؛ از یک دسته کلی شروع کنید و اجازه دهید زیردستهها پدیدار شوند، و آن استقرایی است. راهنمای ما درباره دستهبندی استقرایی، قیاسی و ابداعی به شما در تصمیمگیری کمک میکند، و دستههای از پیش تعیینشده همه تنظیمات را پوشش میدهد.
تحلیل هدفمند: هر دسته را به جای درست هدفگیری کنید
تحلیل هدفمند مانند دستههای از پیش تعیینشده عمل میکند، با یک تفاوت: شما انتخاب میکنید هر دسته از کجا بخواند. این موضوع زمانی اهمیت دارد که فقط بخشی از هر سند مرتبط باشد. اگر مصاحبههای شما پرسشی درباره پیشنهادهای بهبود دارند، دستهای به نام «پیشنهادهای بهبود» باید پاسخهای آن پرسش را بخواند، نه هر شکایت گذرا در متن مصاحبه.
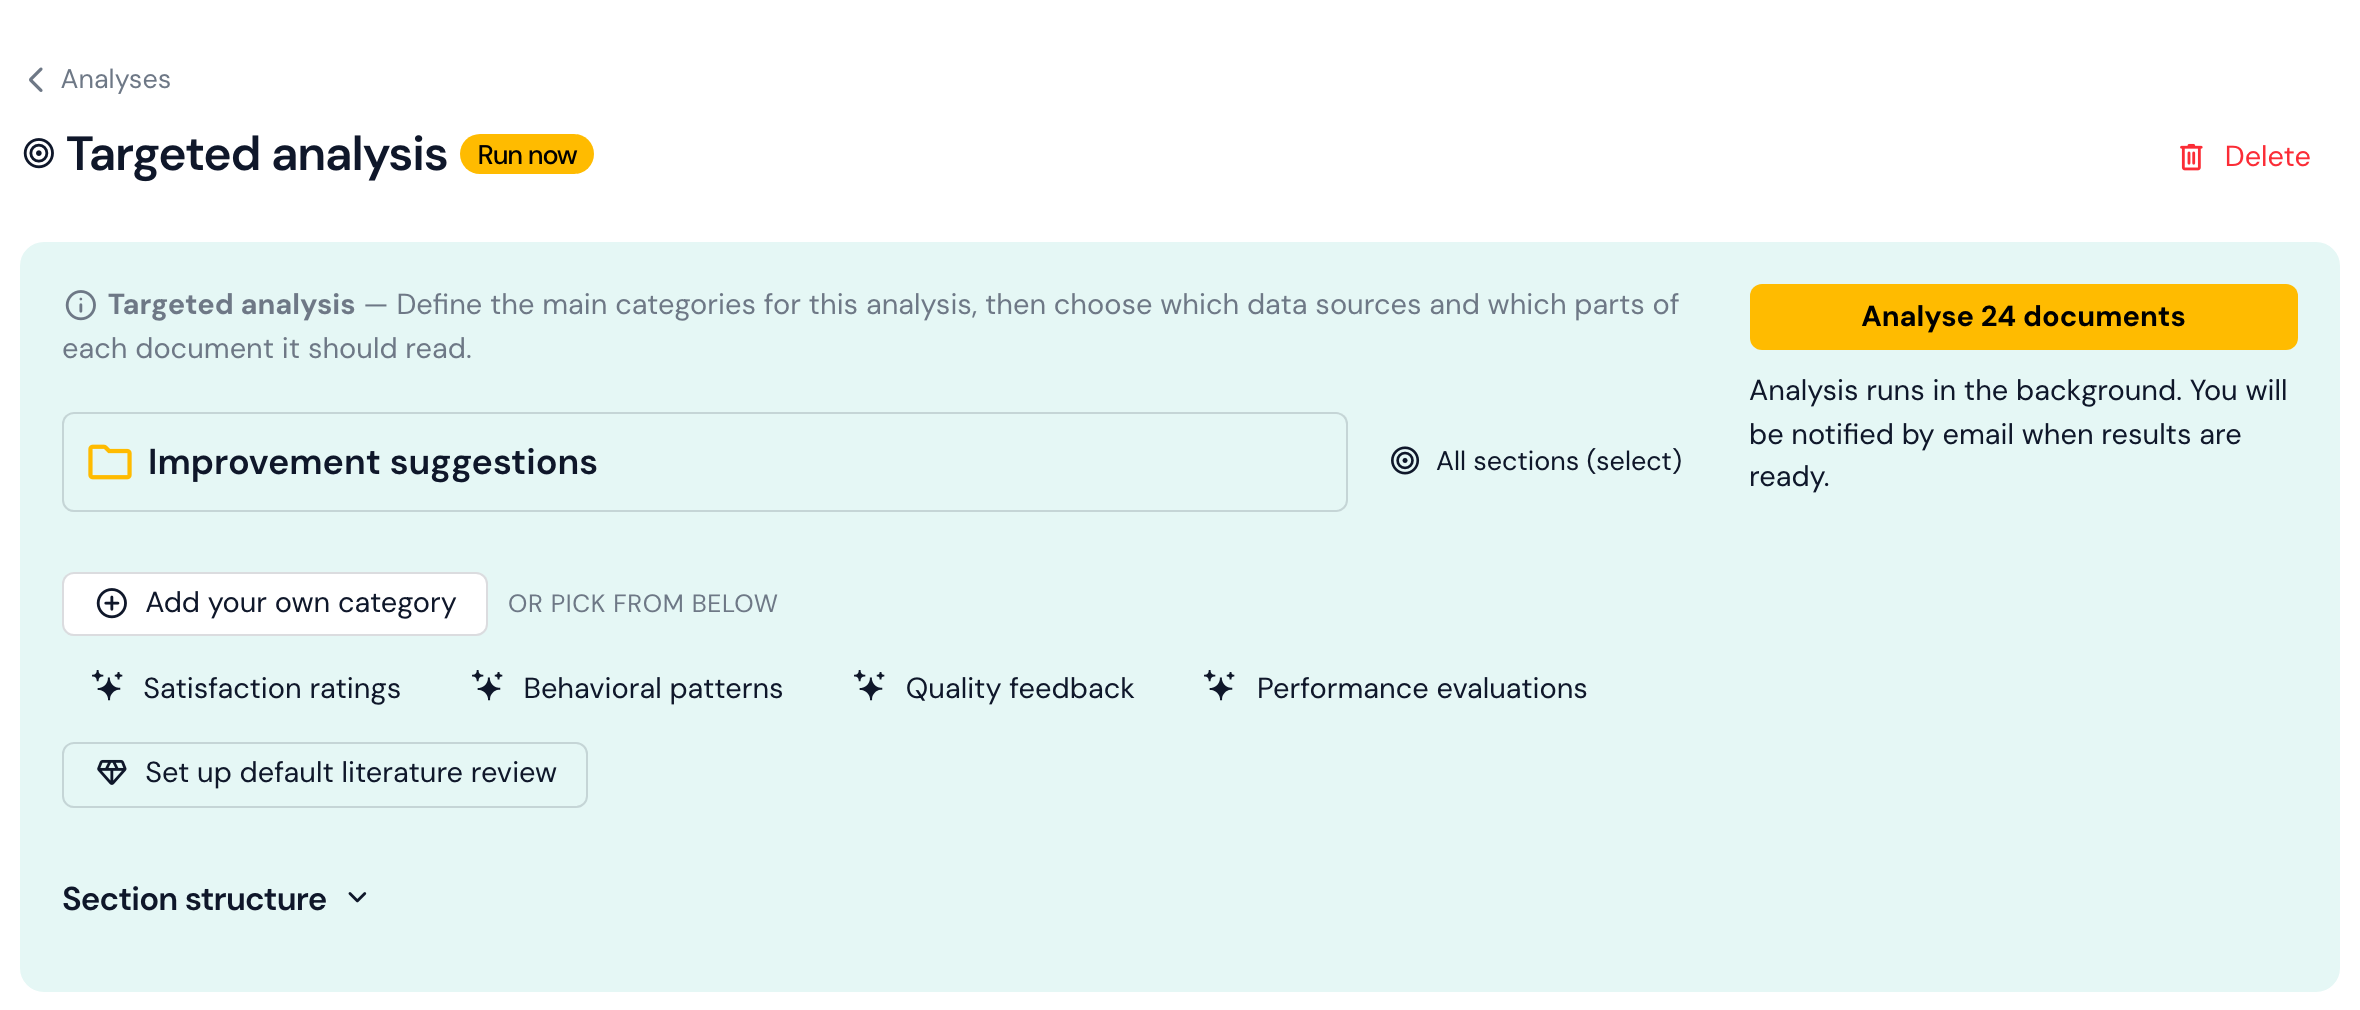
Skimle بخشهای اسناد شما را برای شما مشخص میکند: پرسشهای مصاحبه، تیترهای سند، یا ستونهای یک صفحهگسترده. در کنار هر دسته، تنظیم بخشهای خواندهشده یک انتخابگر باز میکند که بخشهای مشترک میان اسناد شما و تعداد اسنادی که هر بخش را دارند فهرست میکند.
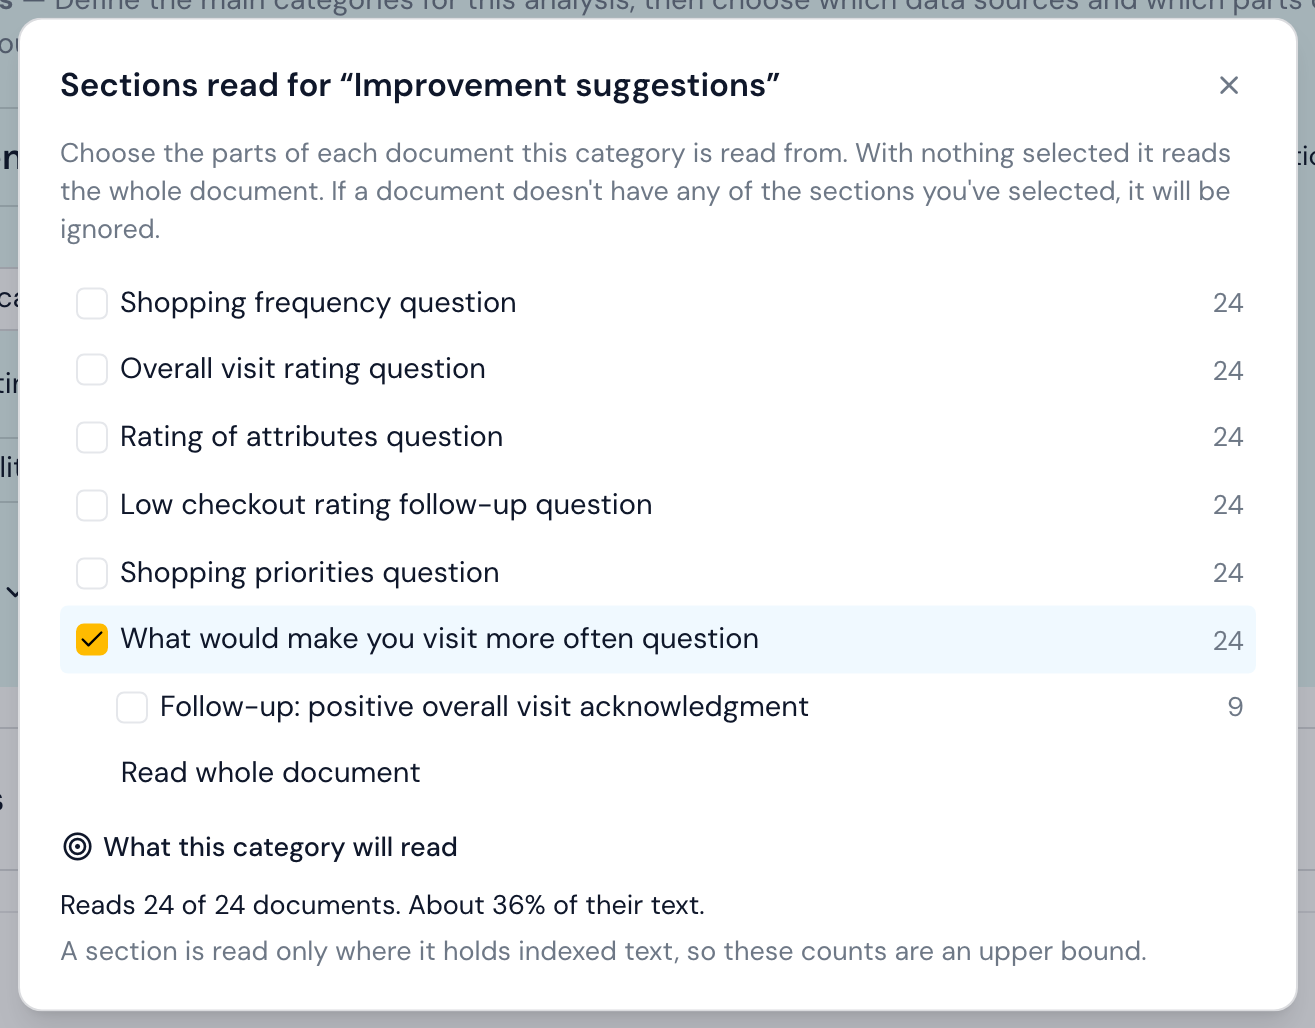
بخشهایی را که دسته باید بخواند تیک بزنید، یا همه را بدون تیک رها کنید تا کل اسناد خوانده شوند. پیشنمایش در پایین دقیقاً نشان میدهد که دسته چه چیزی را پوشش خواهد داد: در اینجا، هر ۲۴ مصاحبه، اما فقط حدود یکسوم از متن آنها. سندی که هیچکدام از بخشهای تیکخورده را نداشته باشد، برای آن دسته نادیده گرفته میشود.
چند کار دیگر که تحلیل هدفمند میتواند انجام دهد:
- محدود کردن اینکه کدام اسناد خوانده شوند، برای مثال فقط مصاحبهها و نه نظرسنجی. ویرایش دامنه اسناد در زیر تنظیمات اختیاری بر اساس منبع داده، فراداده یا حذف اسناد مجزا فیلتر میکند. هر نوع تحلیل این تنظیم را دارد.
- راهاندازی مرور پیشینه با یک کلیک. دکمه راهاندازی مرور پیشینه پیشفرض شش دسته از پیش آمادهشده اضافه میکند (خلأ پژوهشی و انگیزه، تعریف مفاهیم، یافتههای کلیدی، مشارکتهای اصیل، انتخابهای روششناختی و زمینه تجربی)، که هر یک به بخشهای متناظر مقالات دانشگاهی، مانند مقدمه، روش یا بحث، اشاره میکند. این ویژگی آن بخشها را به هر زبانی که مقالات نوشته شده باشند تشخیص میدهد. برای روشی که پشت آن است، به راهنمای ما درباره ترکیب شواهد کیفی مراجعه کنید.
- بازسازی ساختار بخشها اگر از اولین بارگذاری تعداد زیادی سند اضافه کردهاید، تا Skimle بخشها را در سراسر همه چیزی که وارد کردهاید دوباره بررسی کند.
تحلیل عاملمحور: شروع از یک سؤال پژوهش
تحلیل عاملمحور دقیقترین حالت Skimle است. شما یک سؤال پژوهش تایپ میکنید، مثل «چرا برخی مشتریان پس از یک خرید، دیگر بازنمیگردند؟»، و یک گفتگوی راهاندازی کوتاه آن را با شما روشن میکند و چارچوبی از دستهها و پرسشهای گستردهتر پیشنهاد میدهد که میتوانید آن را ویرایش کنید. سپس Skimle شواهد را در سراسر اسناد شما دستهبندی میکند، به دنبال شواهد مخالف میگردد و موضوعهای تحلیلی و گزارشی مینویسد که به سؤال شما پاسخ میدهد.
زمانی آن را انتخاب کنید که «چرا» به همان اندازه «چه چیزی» اهمیت دارد. برای جزئیات، تحلیل عاملمحور را بخوانید، و برای یک نمونه کاربردی، چگونه از تحلیل عاملمحور در Skimle استفاده کنیم را ببینید.
رد کردن تحلیل: دستهبندی دستی
ترجیح میدهید همه چیز را خودتان بخوانید و دستهبندی کنید، یا فقط میخواهید ابتدا اسناد را مرور کنید؟ رد کردن تحلیل یک دسته خالی برای کدگذاری دستی ایجاد میکند. شما همچنان میتوانید در هر زمان بعداً یک تحلیل هوش مصنوعی اضافه کنید. بسیاری از پژوهشگران این دو را با هم ترکیب میکنند؛ به ترکیب تحلیل هوش مصنوعی Skimle با کدگذاری دستی مراجعه کنید.
اجرای تحلیل شما
پس از انتخاب و راهاندازی یک تحلیل، آن را با دکمه تحلیل شروع کنید. اگر هنگام تأیید اسناد شما، تحلیل خودکار روشن بوده باشد، Skimle بهمحض وجود داشتن تحلیل، خودش شروع به تحلیل آنها میکند.
تحلیل در پسزمینه اجرا میشود و معمولاً بسته به میزان متنی که دارید، چند دقیقه طول میکشد. وقتی آماده شد، ایمیلی همراه با یک پیوند دریافت خواهید کرد (اگر ایمیل نرسید، پوشه هرزنامه خود را بررسی کنید)، و در این مدت میتوانید تب را ببندید. وقتی چندین تحلیل بهطور همزمان در حال اجرا هستند، ممکن است تحلیل شما مدتی کوتاه در صف منتظر بماند، اما بهمحض اتمام، مرور نتایج آن فوری است.
مرحله ۴: کاوش نتایج شما
وقتی تحلیل آماده شد، بخش کاوش و ویرایش در منوی سمت چپ فعال میشود. نمای دستهها بهترین جا برای شروع است.
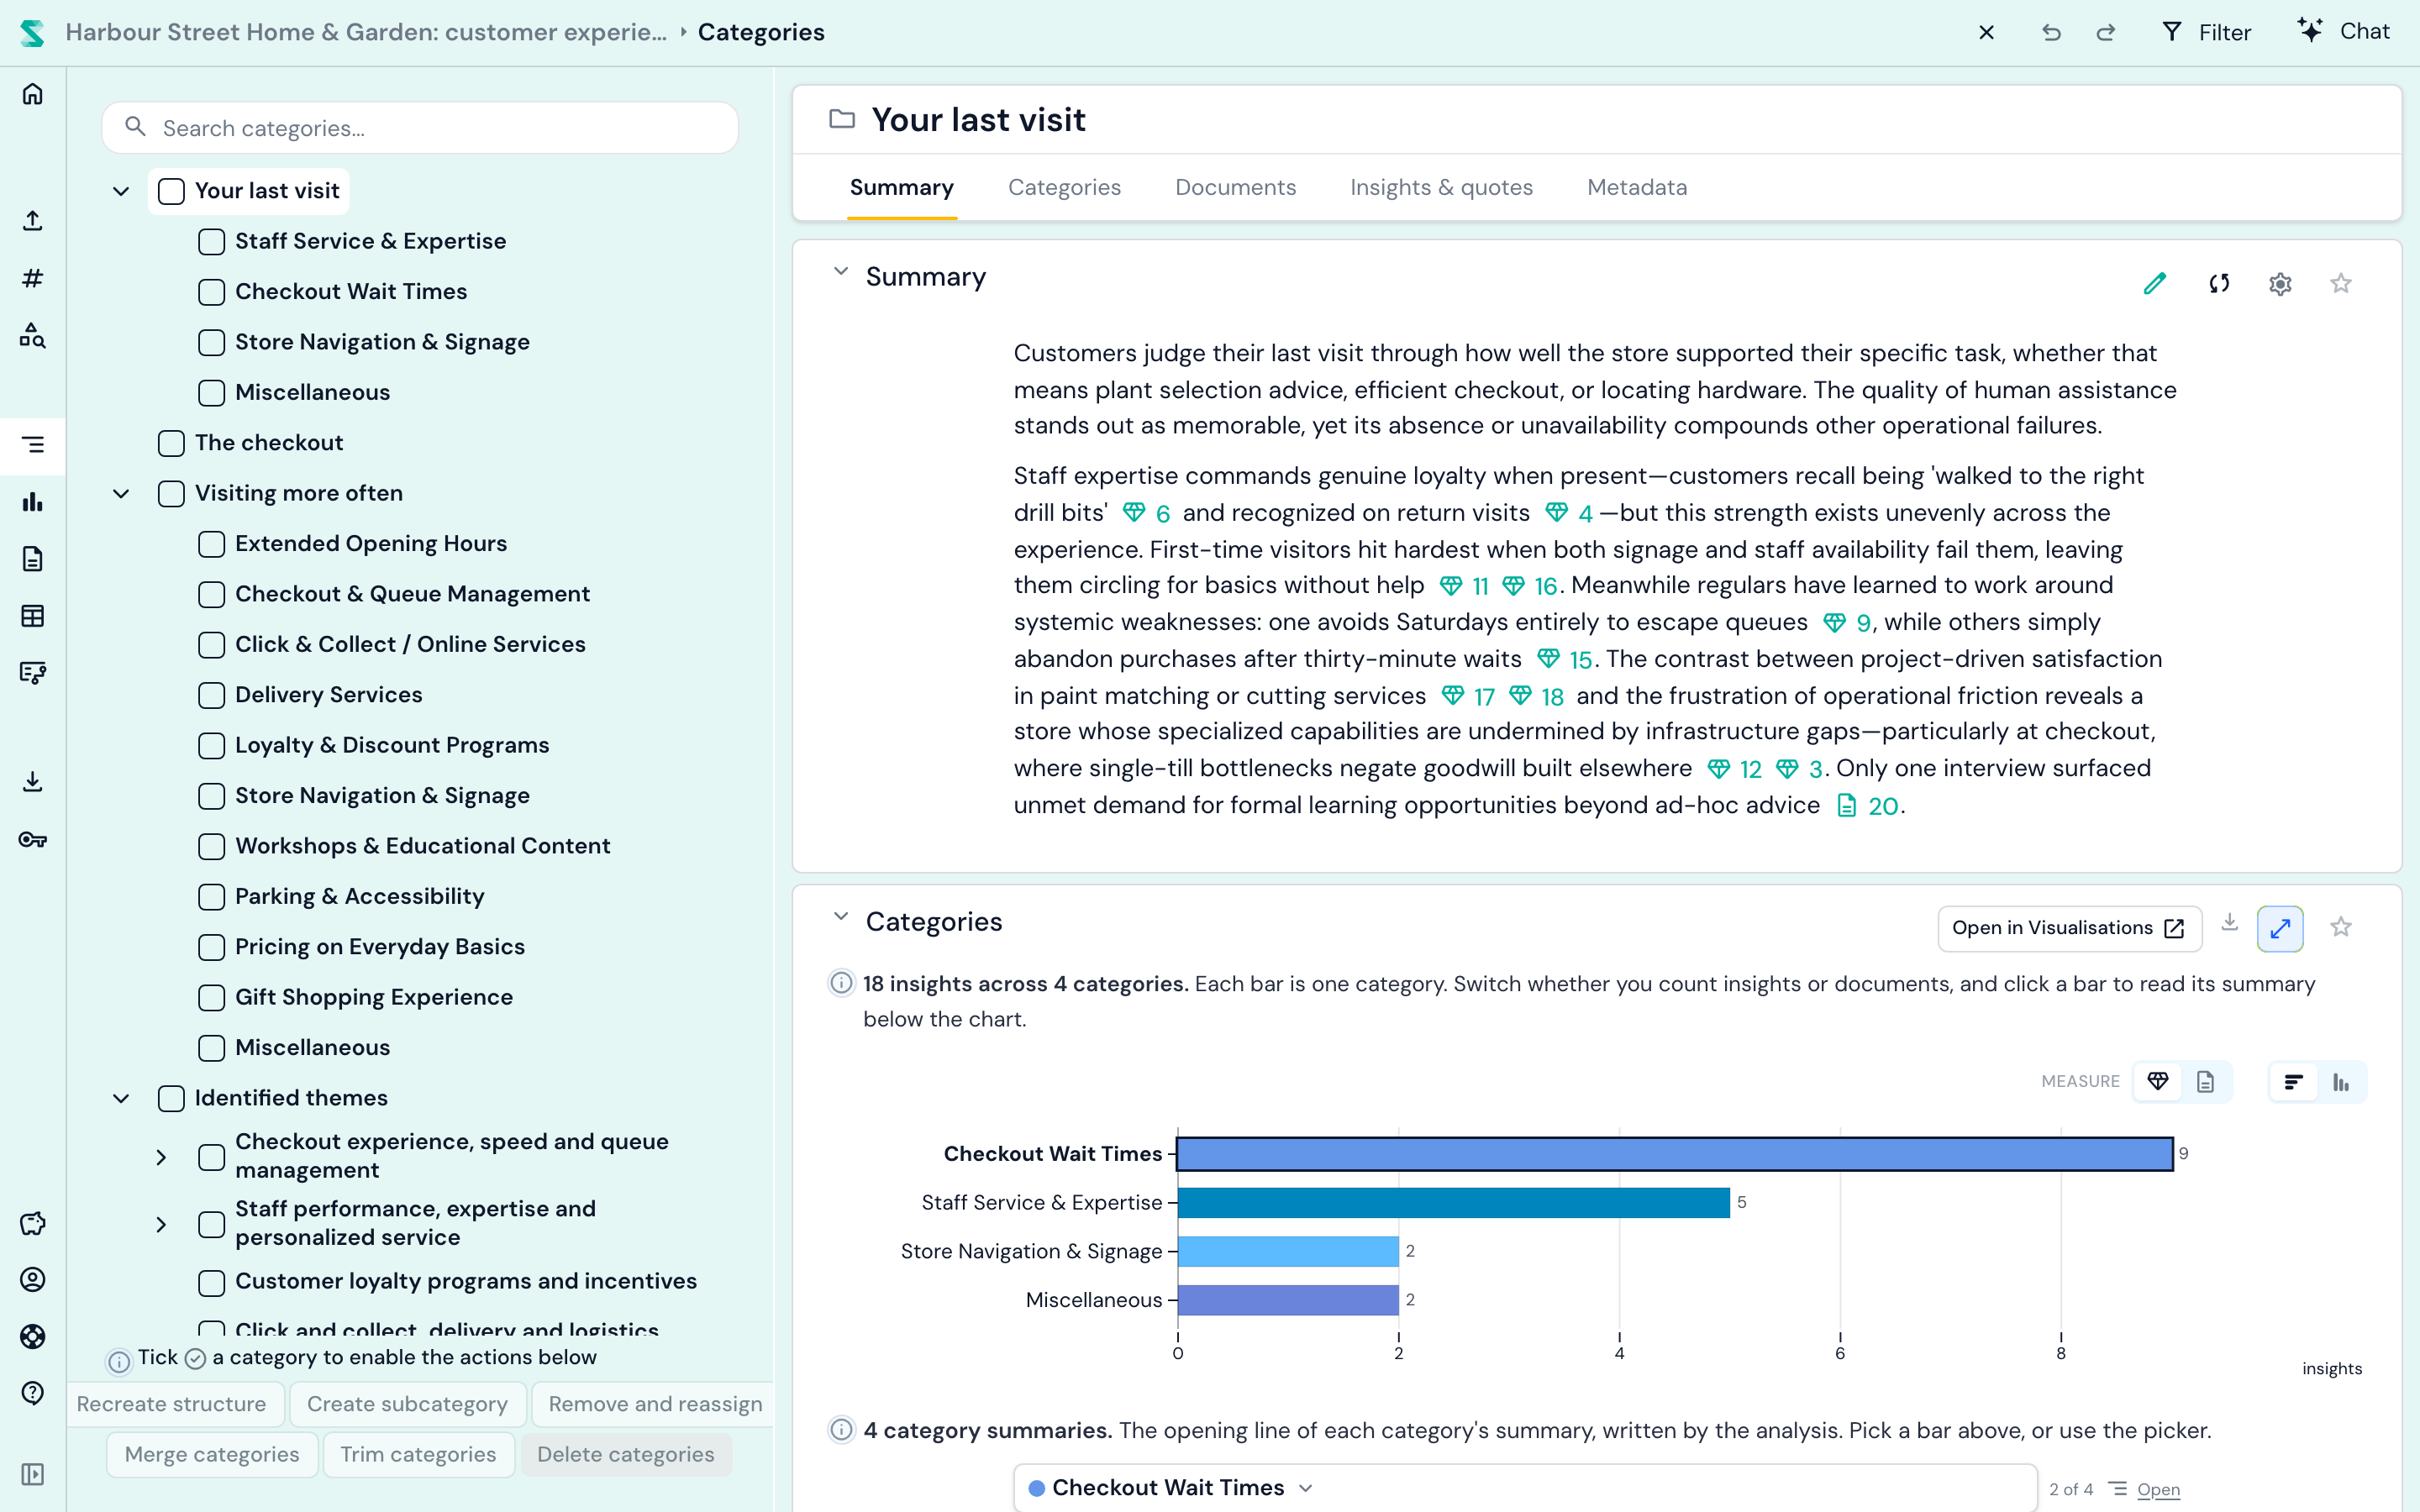
در سمت چپ، درخت دستههای شما قرار دارد؛ روی هر دسته کلیک کنید تا خلاصه نوشتهشده توسط هوش مصنوعی آن را بخوانید، ببینید بینشهای آن چگونه توزیع شدهاند، و هر بینش را همراه با نقلقول عینی آن باز کنید. هر نقلقول به مکان دقیق آن در سند مبدأ پیوند میخورد، پس همیشه میتوانید زمینه آن را بررسی کنید. شما مسؤول ساختار هستید: دستهها را هر طور که دوست دارید تغییر نام دهید، ادغام کنید، تفکیک کنید و منتقل کنید (ویرایش در نمای دستهها).
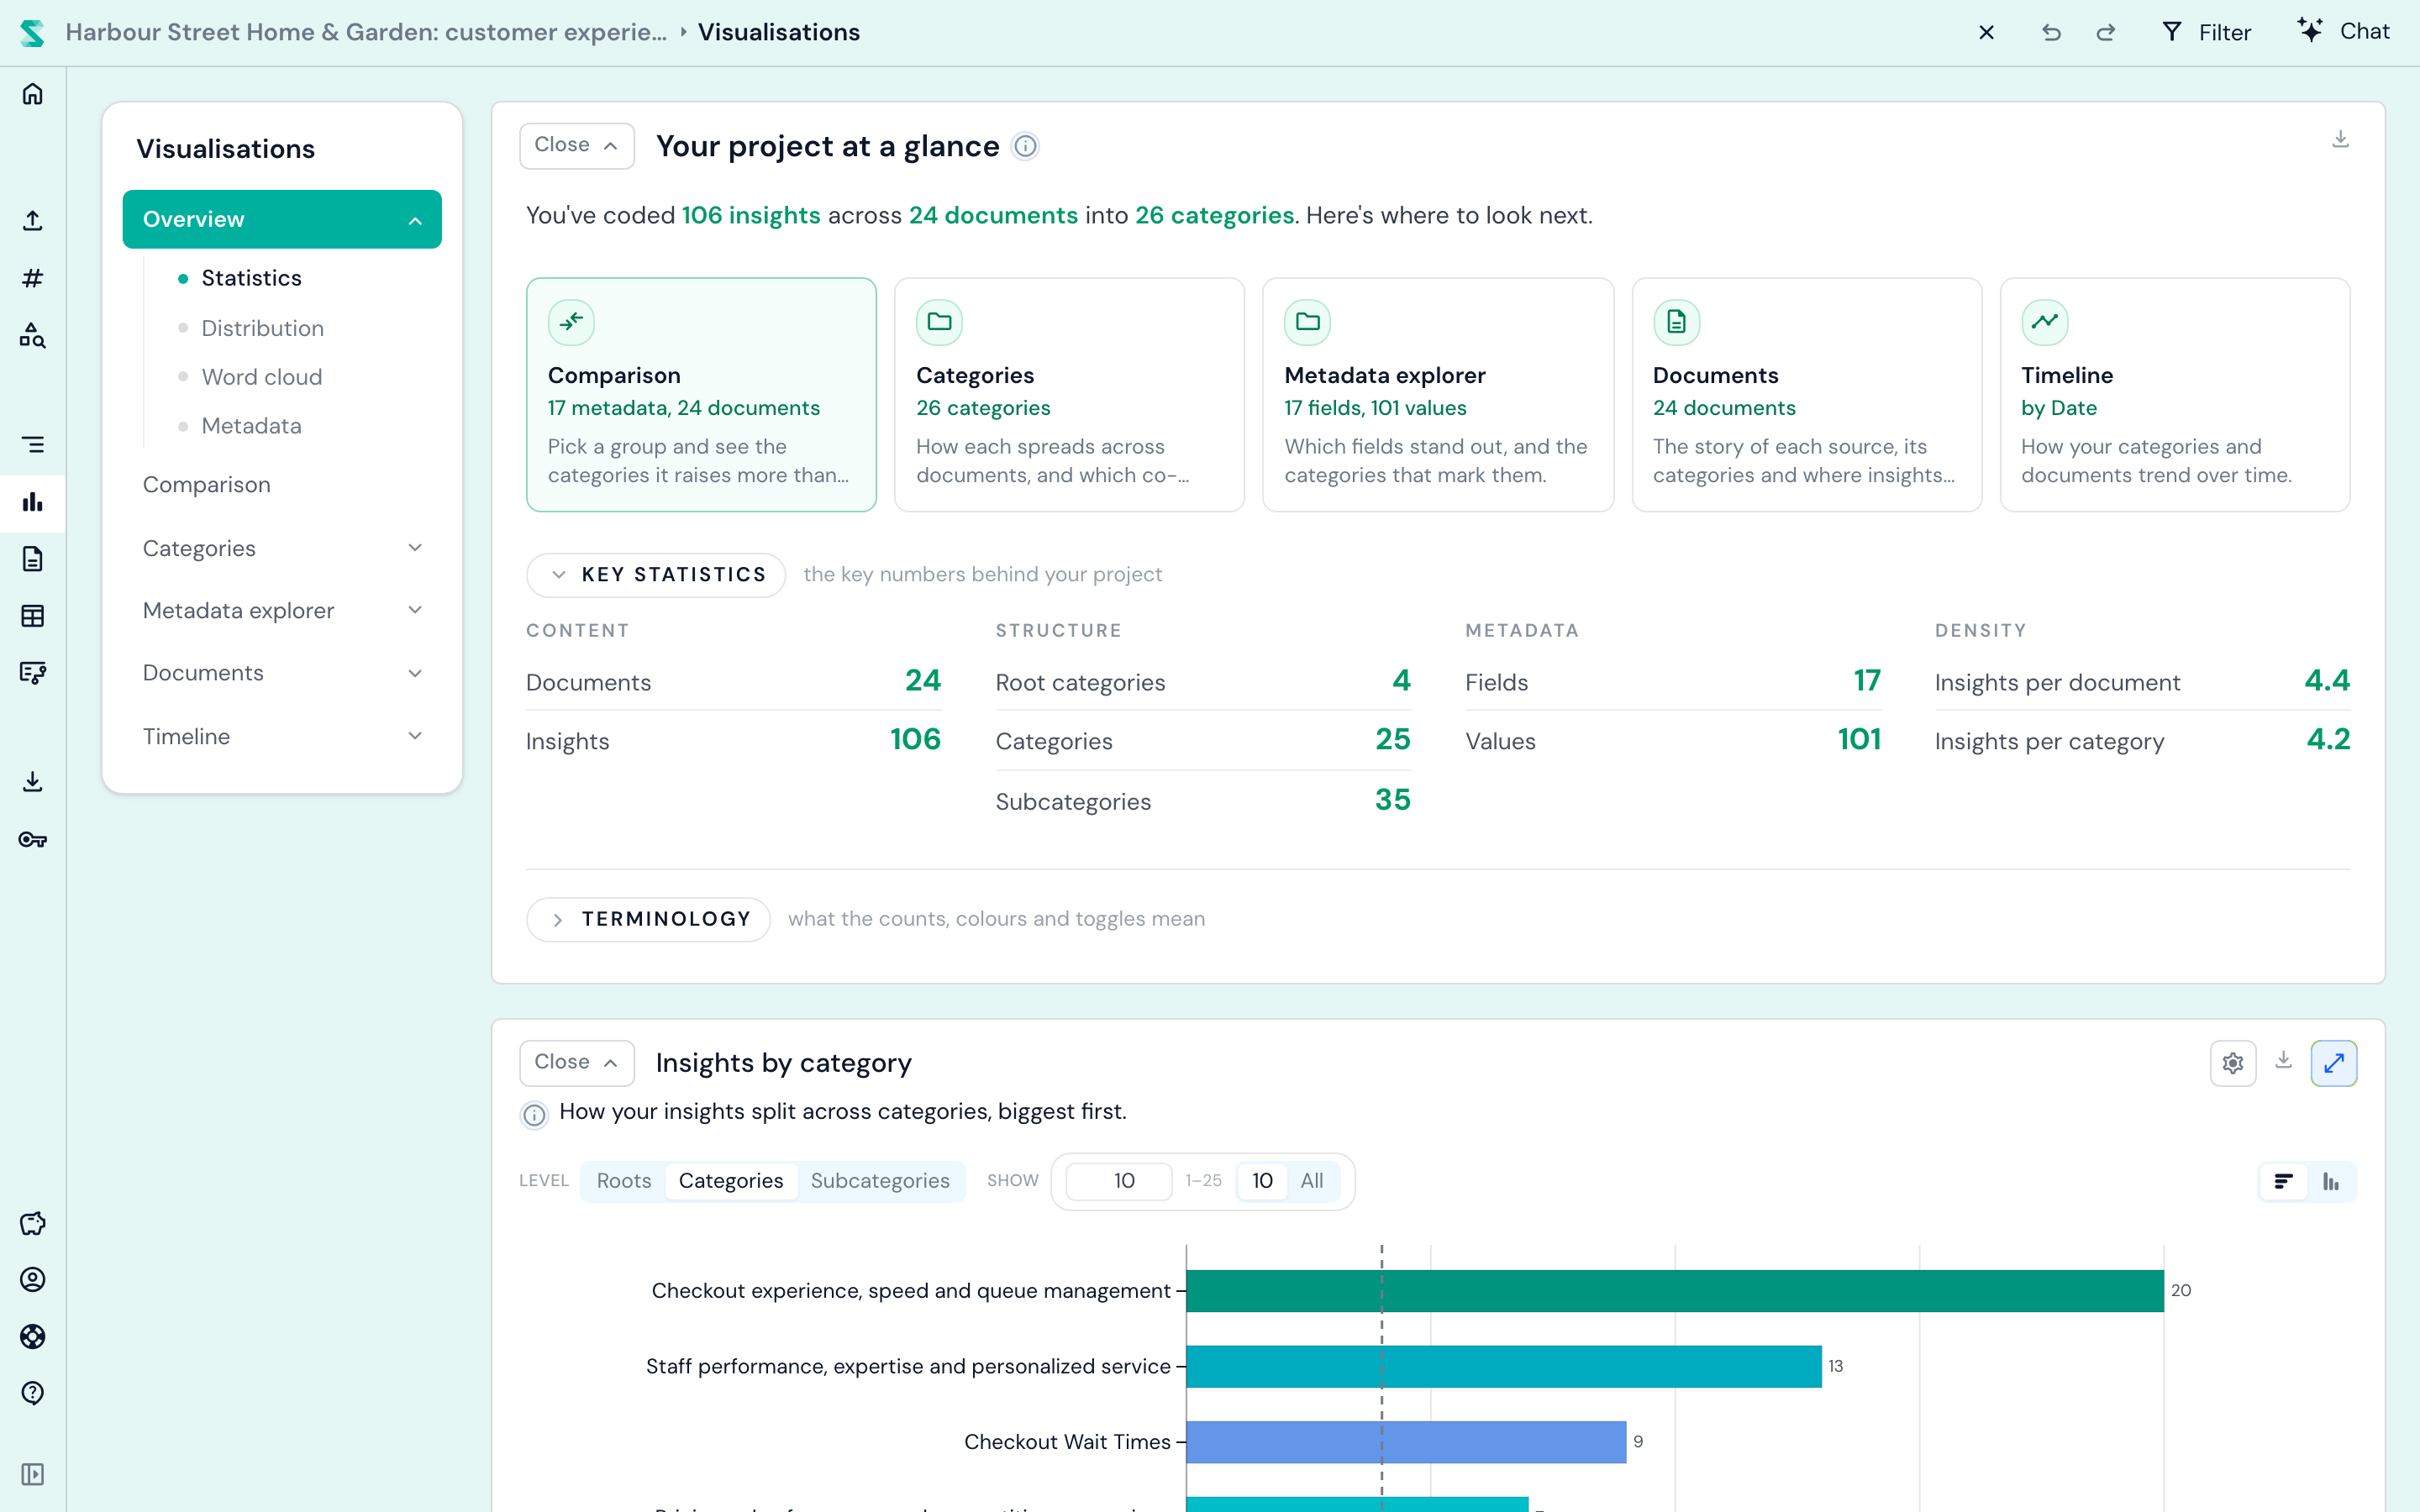
تصویرسازیها کل پروژه را در یک نگاه به شما نشان میدهد: کدام دستهها بزرگترین هستند، چگونه میان گروهها متفاوتاند و چگونه در طول زمان تغییر میکنند.
از اینجا، چند قدم بعدی خوب:
- اسناد را بخوانید در نمای اسناد، با هایلایت هر نقلقول دستهبندیشده، یا همه چیز را یکجا در نمای جدول ببینید.
- گروهها را مقایسه کنید با افزودن فراداده، مانند نقش، سایت یا بخش مشتری، و با استفاده از تحلیل فراداده. نمونه کاربردی ما درباره کشف موضوعها با متغیرهای فراداده نحوه این کار را نشان میدهد.
- سؤال بپرسید در چت: «بیشترین ناامیدی مشتریان از چه چیزی است؟ سه نقلقول به من بده.» برای ده کاری که میتواند انجام دهد، چگونه از چت Skimle استفاده کنیم را ببینید.
- نشانهگذاری کنید با برچسبها و یادداشتها که فراتر از دستهها عمل میکنند.
- نتایج خود را به اشتراک بگذارید و خروجی بگیرید به Word، Excel، PowerPoint یا REFI-QDA برای NVivo، ATLAS.ti و MAXQDA، از مرکز خروجی.
قدم بعدی چیست
- مطالب بیشتری وارد کنید: صدا و ویدیو، صفحهگستردهها یا یک مصاحبه Skimle Ask.
- با همکاران کار کنید: اشتراکگذاری و همکاری.
- بفهمید در پشت صحنه چه اتفاقی میافتد: تحلیل چگونه کار میکند.
سؤالی دارید یا جایی گیر کردهاید؟ از ارسال بازخورد در منوی سمت چپ استفاده کنید، و یک شخص واقعی با شما تماس خواهد گرفت.