Попередньо визначені категорії
Визначте категорії, які потрібно видобути, або виберіть із пропозицій Skimle, і дайте аналізу категоризувати Ваші документи відповідно до них.
Попередньо визначені категорії - це режим аналізу, який Ви використовуєте, коли хочете вирішити, що має вийти з Ваших даних. Ви називаєте категорії, які потрібно видобути, Skimle категоризує кожен документ за ними, а потім формує підкатегорії з того, що знайшов.
Він охоплює весь спектр від індуктивного до дедуктивного підходу. Принесіть систему категорій, яку Ви вже маєте, - і аналіз буде дедуктивним. Почніть із пропозицій Skimle або з однієї широкої категорії й дозвольте підкатегоріям сформуватися з даних - і аналіз буде індуктивним. Той самий екран, той самий робочий процес.
Крок 1: Виберіть Ваші категорії
Існує два способи заповнити список категорій, і Ви можете поєднувати їх:
- Додайте власну категорію. Натисніть Додайте свою власну категорію та назвіть її. Це той шлях, який варто обрати, якщо Ви вже знаєте, що шукаєте.
- Виберіть із пропозицій. Skimle читає Ваш проєкт і пропонує категорії, взяті із самого матеріалу. Натисніть на одну з них, щоб додати її. Це той шлях, який варто обрати, якщо Ви хочете, щоб дані вели аналіз.
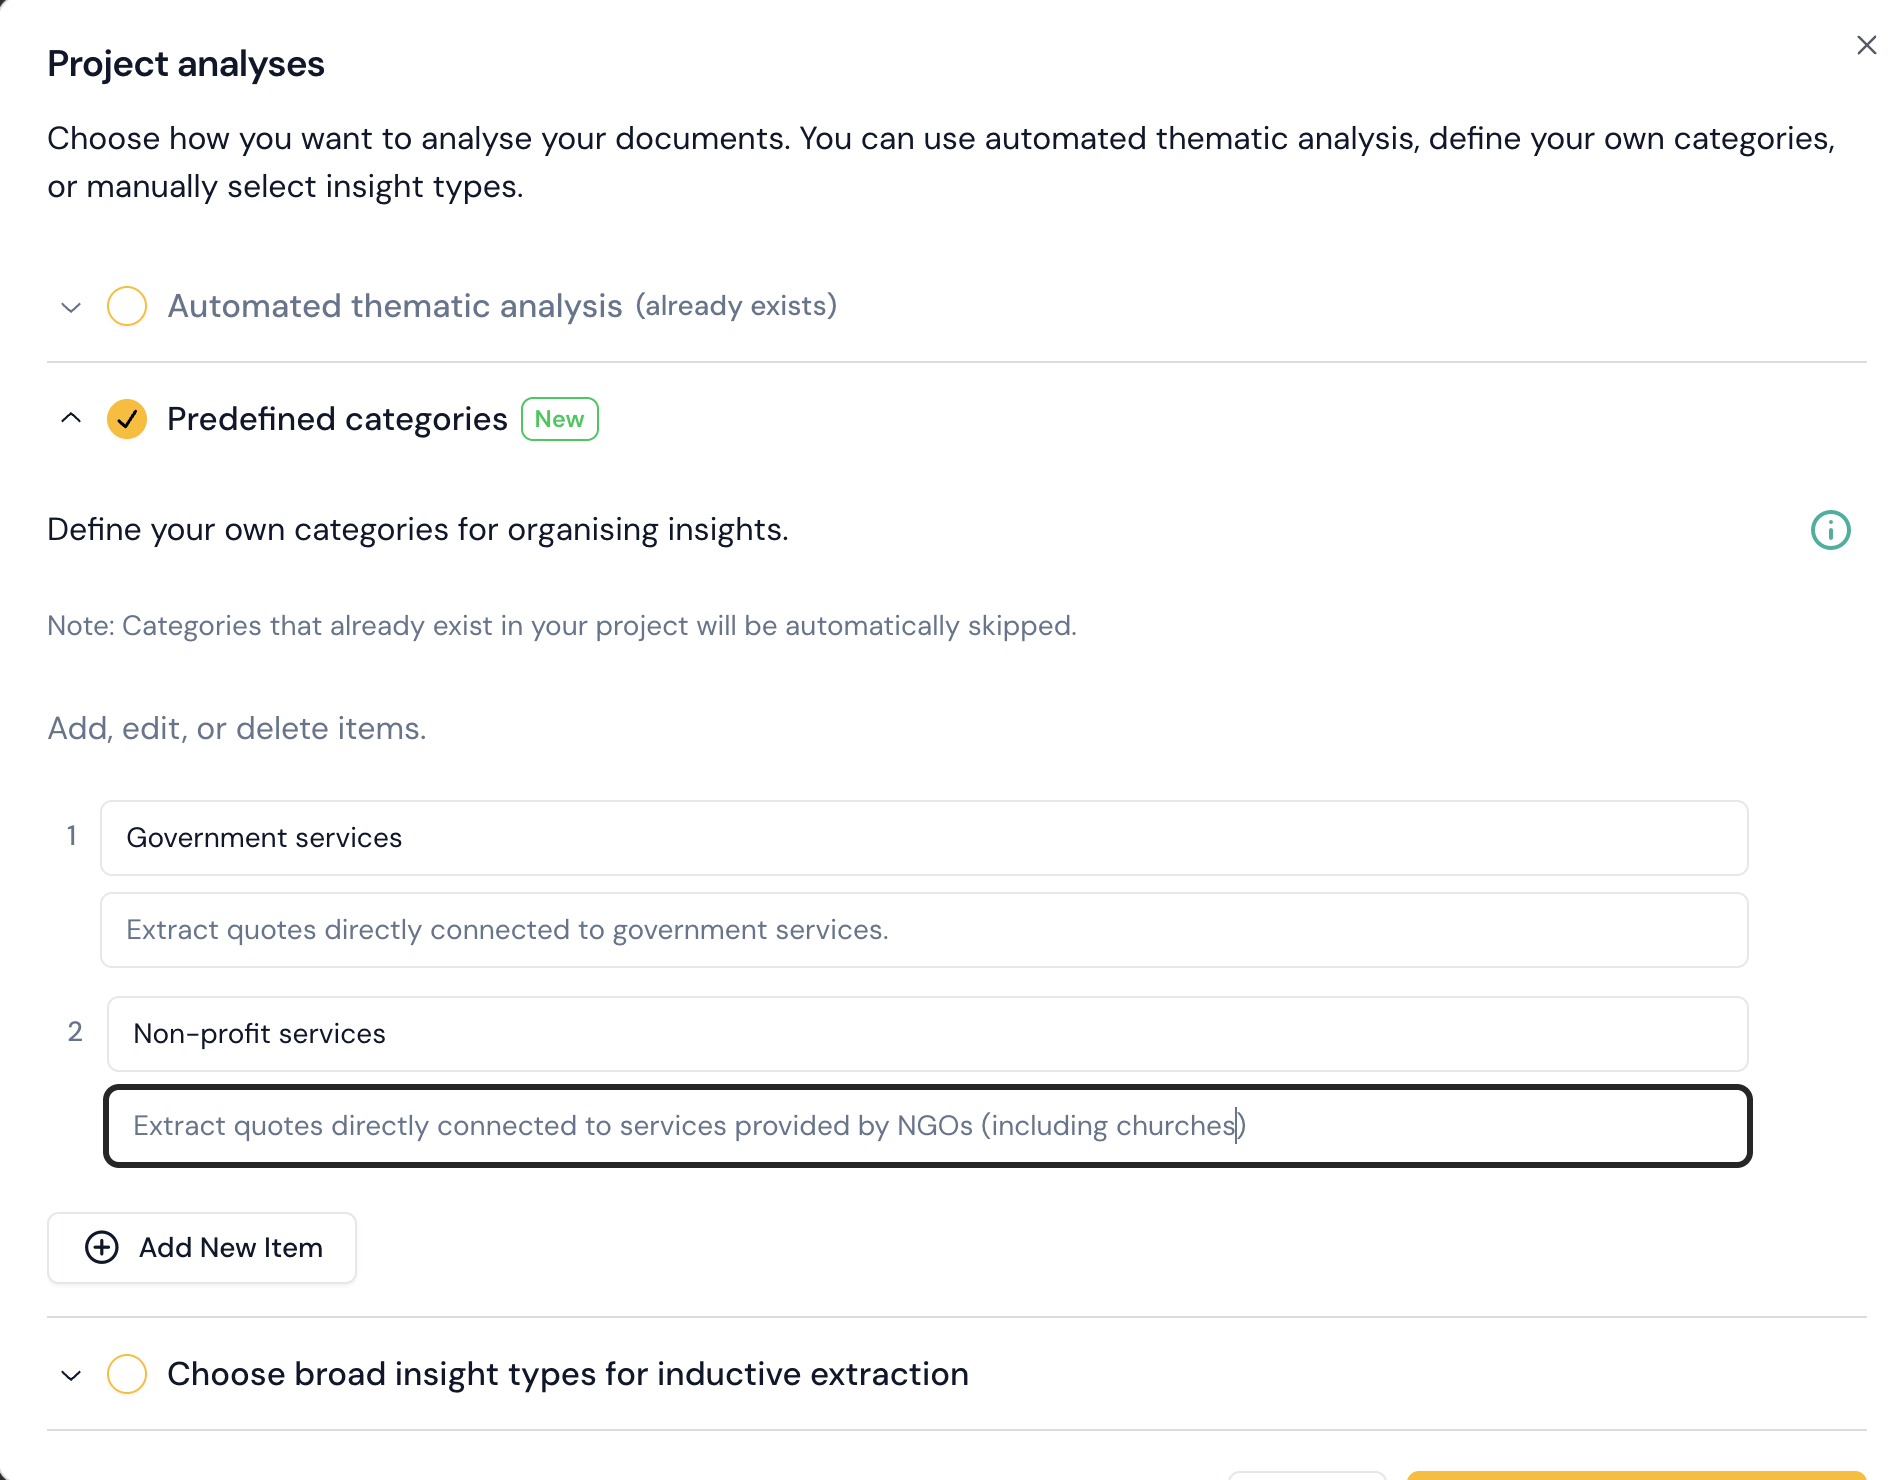
Кожна категорія може містити необов'язкові інструкції:
- Інструкції визначають, що ШІ видобуває для цієї категорії, дозволяючи Вам розширити або звузити обсяг включеного вмісту.
- Інструкції щодо категорій визначають, як спостереження розподіляються на підкатегорії під нею.
- Приклади можна згенерувати, щоб отримати попередній перегляд того, який тип спостереження знайде ШІ, перш ніж Ви запустите повний аналіз.
Категорія без інструкцій також працює добре. Інструкції мають найбільше значення, коли назва категорії сама по собі неоднозначна, або коли дві категорії можуть претендувати на той самий уривок.
Крок 2: Видобування даних
Skimle проходить кожен із Ваших документів і видобуває спостереження, що відповідають Вашим категоріям та їхнім інструкціям. Кожна видобута цитата перевіряється на відповідність вихідному документу, тож цитата, яка не з'являється в оригіналі слово в слово, ніколи не потрапляє до Вашого аналізу.
Крок 3: Підкатегорії формуються зі спостережень
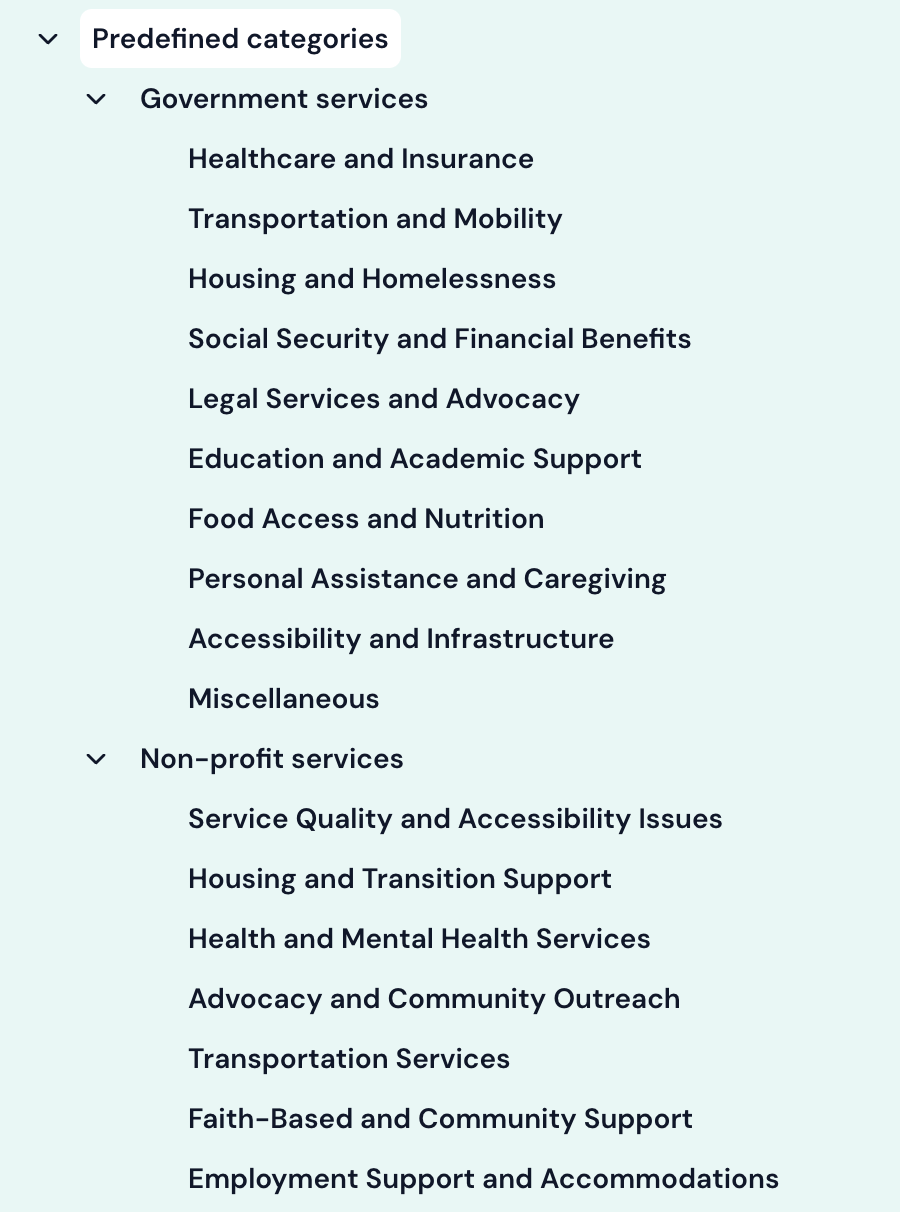
Skimle аналізує спостереження, призначені кожній категорії, і формує підкатегорії, а потім переміщує кожне спостереження до найбільш відповідної з них. Саме тут індуктивний аналіз отримує свою структуру: Ви задаєте широкий фокус, а рівень нижче формується з даних.
Примітка: підкатегорії формуються лише тоді, коли категорії призначено достатню кількість спостережень. Категорія, яка зібрала лише кілька спостережень, залишається пласкою, що зазвичай свідчить про те, що категорія була занадто вузькою або потрібного матеріалу просто немає.
Крок 4: Підсумки категорій
Після того як дані категоризовано, Skimle складає підсумок для кожної категорії. Підсумки відображаються в перегляді категорій, де Ви також можете перейменовувати, об'єднувати, розділяти та реорганізовувати все, що створив аналіз.
Імпорт CSV-файлу
Коли Ви імпортуєте CSV-файл, назви стовпців, що мають заголовок «Вміст», зберігаються і використовуються для створення категорій за замовчуванням для цього типу аналізу. Ще одна причина встановити чіткий та інформативний рядок заголовків для Ваших даних перед імпортуванням. Детальніше про те, як працює імпорт CSV, дивіться в розділі підтримувані формати файлів та імпорт CSV.
Коли це використовувати
Використовуйте попередньо визначені категорії, коли Ви знаєте, на яке питання аналіз має відповісти на рівні категорій, незалежно від того, походять категорії з Вашого власного фреймворку чи з пропозицій Skimle. Якщо Ваші документи мають спільну структуру і Ви хочете, щоб категорії будувалися на основі цієї структури без будь-якого введення даних, автоматичний тематичний аналіз буде швидшим. Якщо Вам потрібна письмова аналітична відповідь на Дослідницьке питання, а не дерево категорій, отримане шляхом категоризації, скористайтеся Агентним аналізом.