ワードクラウド
文書が使用する単語と、文書が名指しする人物、場所、組織、トピックです。
ワードクラウドは、文書が何について話しているかを示します - 単語そのもの、または分析が見つけた人物、場所、組織、トピックです。項目が大きいほど、選択した測定基準での順位が高いことを意味します。これはビジュアライゼーションの概要レンズにあり、すべての項目はクリック可能です:ドリルカードには、その背後にある文書が正確に表示されます。
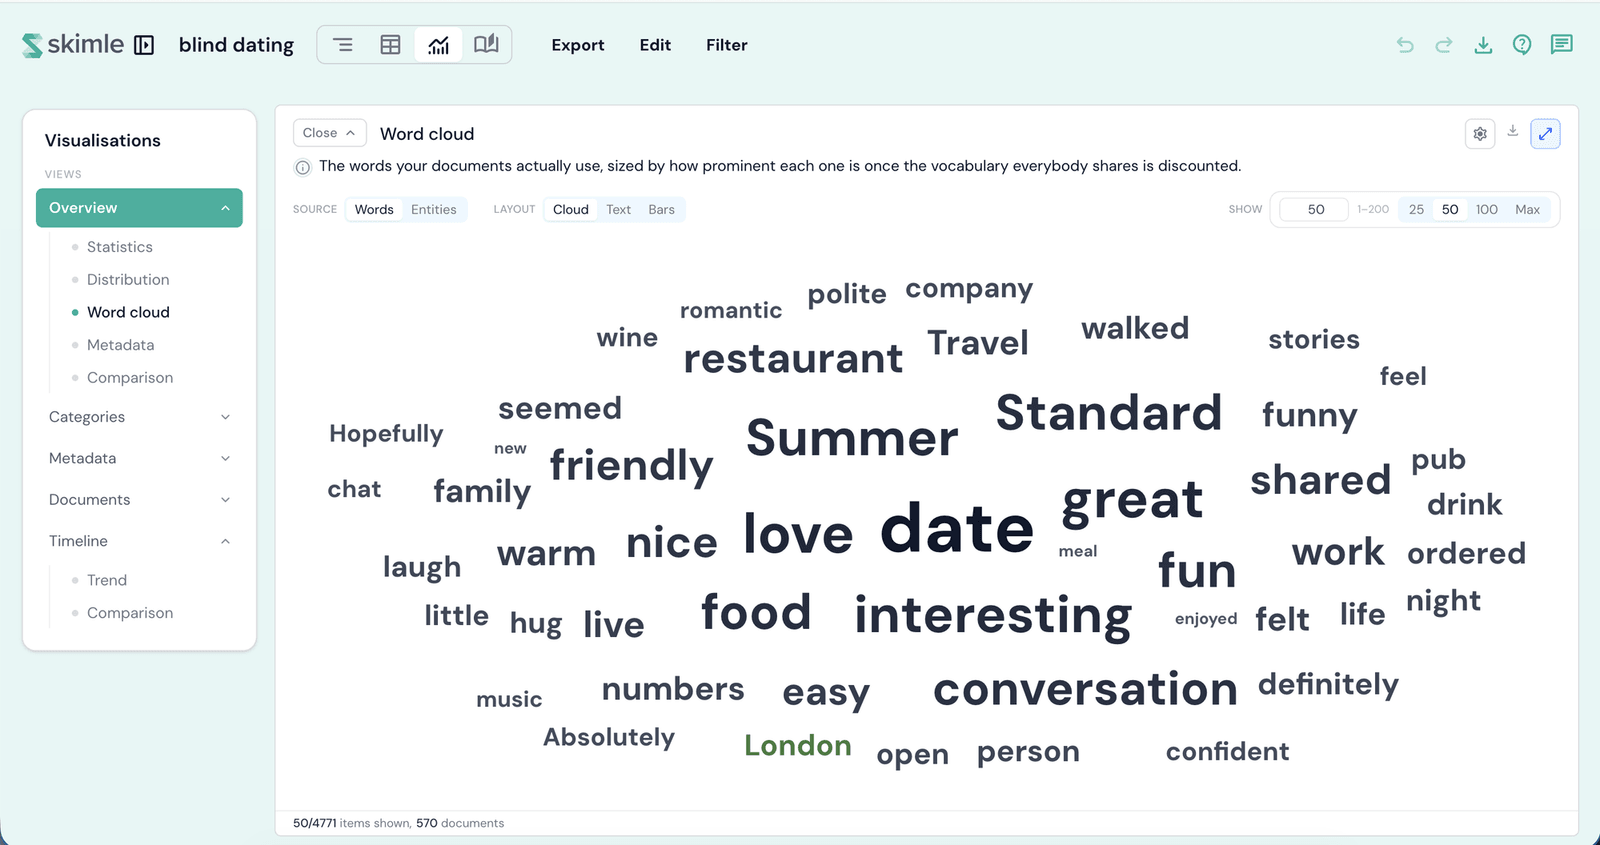
単語とエンティティ
ソースコントロールは、まったく異なる2つのプール間を切り替えます:
- 単語 - 文書自体の語彙です。単語は語幹処理されるため、talk、talking、talkedは1つとしてカウントされます。
- エンティティ - 分析が見つけた人物、場所、組織、イベント、トピックです。色はエンティティの種類を示し、ツールバー下のチップで種類の表示・非表示を切り替えられます。
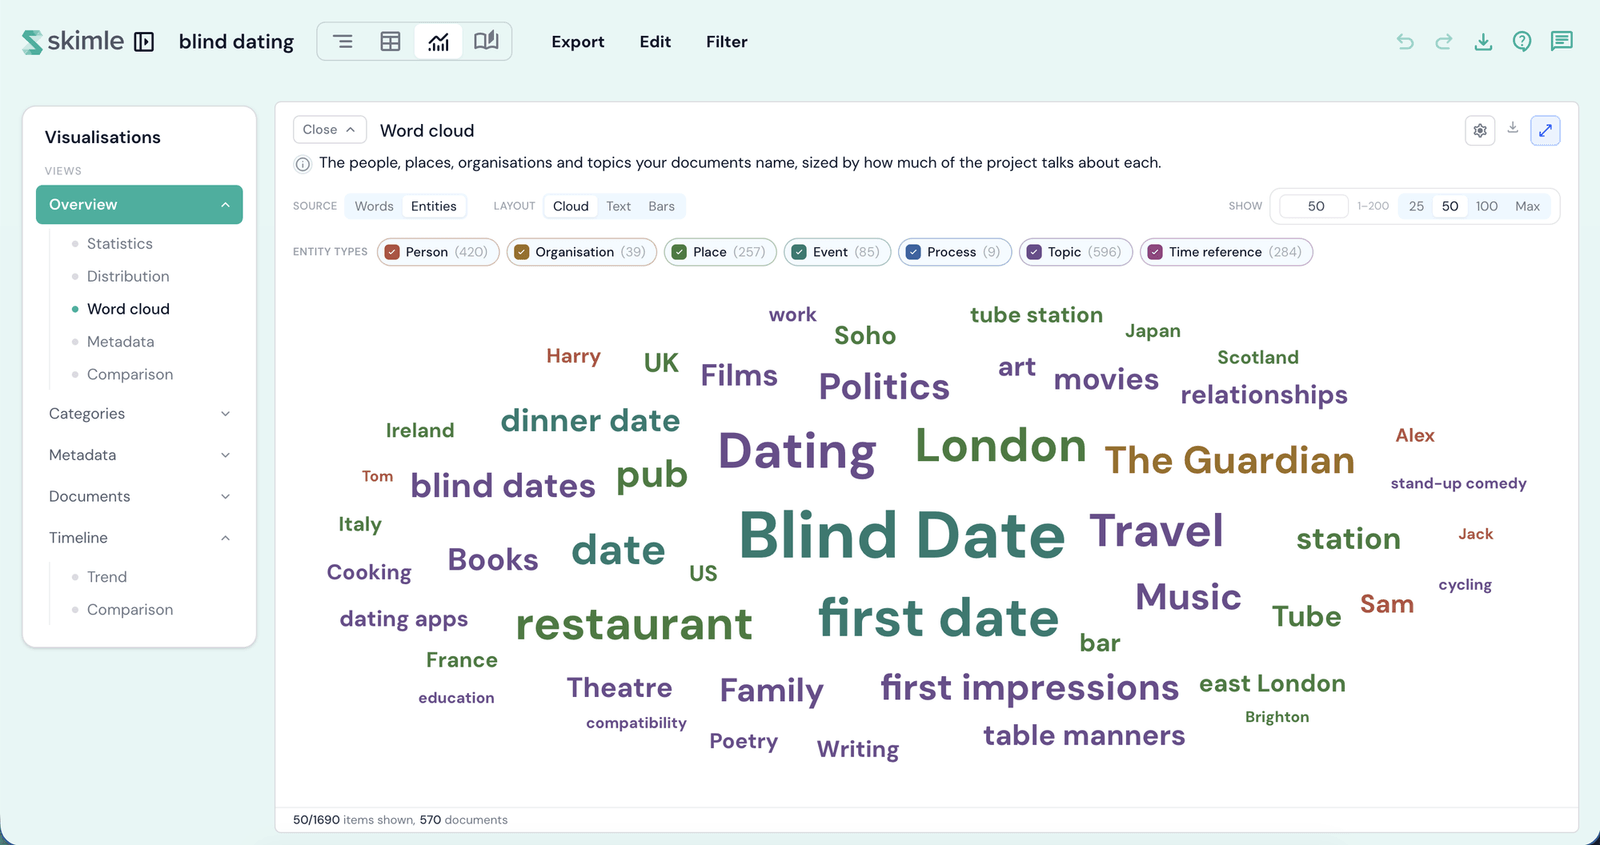
エンティティについては一つ正直な注意点があります:エンティティはテキストの照合ではなく、言語モデルが意味を読み取って見つけ出したものです。つまり、文書はその名前を一度も書かなくてもエンティティに含まれることがあり - また、職種名を人物と誤認したり、同じ名前の2つの表記が別々に扱われたりといった、たまの誤りも入り込みます。エンティティをクリックすると、その背後にある文書を確認し、自分で判断できます。ドリルカードは、名前を書いている文書と、名前を出さずにそれについて述べている文書を分けて表示します。
レイアウト
- クラウド - 従来のスパイラル表示です。重なり合わずに配置できない項目は除外されるため、フッターには実際に描画された項目数が表示されます。
- テキスト - 流れるようなブロックで、大きいものから順に並びます。
- 棒グラフ - 同じ項目をランク付けされた棒グラフとして、正確なカウントとともに表示します。
表示は描画する項目数を設定します - 正確な数値を入力するか、プリセットを選択してください。レイアウトごとに個別に記憶されます。
並べ替え基準
ギアアイコンの背後にある並べ替え基準は、サイズと順序を決める測定基準を選択します:
- 言及回数 - 単純な合計:出現した回数です。純粋な量を見るのに最も良い指標ですが、1つの文書での繰り返しによって数値が膨らむことがあります。単語のみに適用されます。
- 文書数 - 到達した文書の数です。共通の関心事を、1人の声が大きいだけのものと見分けるのに最も良い指標です。
- 特出度 - 多く言及されているが、どこにでもあるわけではないものです。すべての文書に出現する項目 - インタビューの質問文やメールヘッダーなど - はほぼゼロまで下がるため、残るのはここで特徴的なものだけです。
単語はデフォルトで言及回数、エンティティはデフォルトで文書数で開きます。
最小言及数
ギアアイコンの背後には、下限値を設定してロングテールを隠す機能もあります:「すべて」からプール内の最大カウントまでスライダーをドラッグするか、正確な数値を入力してください。単語では最小言及数、エンティティでは最小文書数となります。
不要語を隠す
単語では、不要語を隠すスイッチにより、just、really、thinkなどのありふれた不要語や、FriやGMTといったヘッダーの残留物が隠されます。10件以上の文書を含むプロジェクトでは、ほぼすべての文書に出現する単語も隠されます。どこにでもある単語は、何も区別しないためです。何も削除されるわけではありません - スイッチを切れば、すべての単語が元に戻ります。エンティティは一切フィルタリングされません。
ドリルカード
任意の項目をクリックすると、その項目が出現する文書を文書別のカウントとともに確認でき、直接開くこともできます。まず試してみるとよいのは、単語で並べ替え基準を文書数に設定することです - 上位に跳び出すのは、たいてい参加者ではなく質問シートです。