定義済みカテゴリ
抽出するカテゴリを定義するか、Skimleの候補から選択し、分析によって文書をそれらに基づいて分類させます。
定義済みカテゴリは、データから何を抽出するかを自分で決めたいときに使う分析モードです。抽出するカテゴリに名前を付けると、Skimleがすべての文書をそれらのカテゴリに基づいて分類し、その結果からサブカテゴリを形成します。
これは演繹的分析と帰納的分析の両方の範囲をカバーします。すでにお持ちの分類枠組みを使用すれば、分析は演繹的になります。Skimleの候補、または1つの広いカテゴリから始めて、データからサブカテゴリを浮かび上がらせれば、分析は帰納的になります。画面もワークフローも同じです。
ステップ1:カテゴリを選択する
カテゴリリストを作成する方法は2つあり、組み合わせることもできます。
- 独自に追加する。 独自のカテゴリを追加をクリックして名前を付けます。これは、何を探しているかがすでに分かっている場合に取るべき方法です。
- 候補から選ぶ。 Skimleはプロジェクトを読み取り、資料そのものから引き出したカテゴリを提案します。クリックすると追加されます。これは、データに主導させたい場合に取るべき方法です。
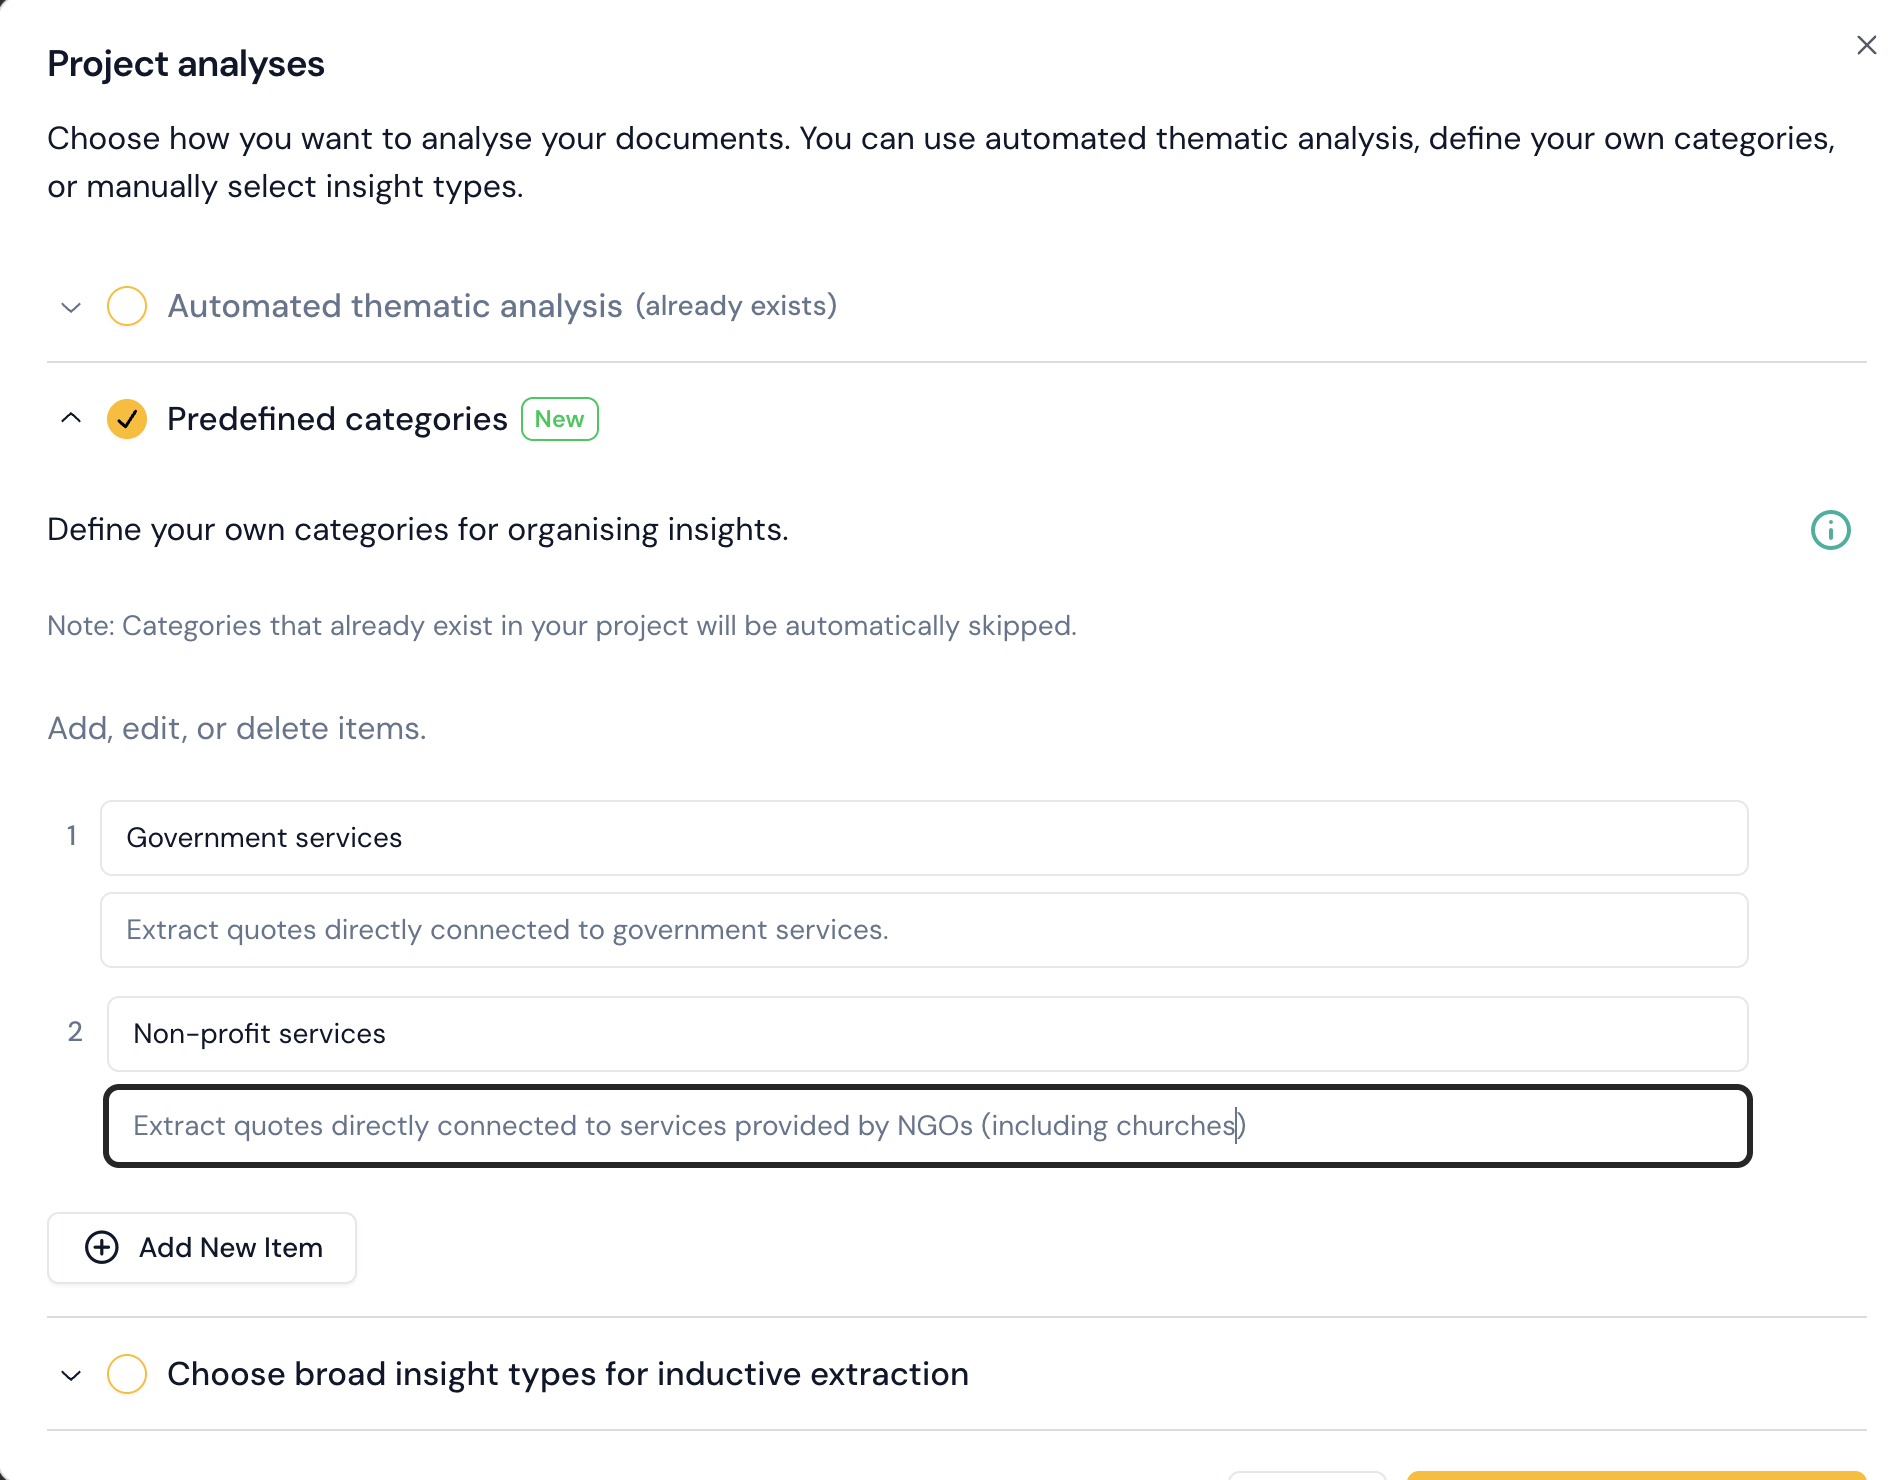
各カテゴリには、任意で指示を付けることができます。
- 指示は、AIがこのカテゴリについて何を抽出するかを導くもので、含まれるコンテンツを広げたり絞ったりできます。
- 分類の指示は、インサイトがその下のサブカテゴリにどのように振り分けられるかを導きます。
- 例を生成して、本格的な実行を行う前に、AIが見つけるインサイトの種類を事前に確認できます。
指示のないカテゴリでも問題なく機能します。指示が最も重要になるのは、カテゴリ名だけでは意味が曖昧な場合や、2つのカテゴリが同じ文章を取り得る場合です。
ステップ2:データ抽出
Skimleは文書を1つずつ確認し、カテゴリとその指示に合致するインサイトを抽出します。抽出された引用はすべて元の文書と照合して検証されるため、原文に逐語的に存在しない引用は分析に反映されません。
ステップ3:インサイトからサブカテゴリを形成する
Skimleは各カテゴリに割り当てられたインサイトを調べてサブカテゴリを形成し、各インサイトを最も適切なサブカテゴリに移動します。帰納的分析が構造を得るのはここです。大まかなフォーカスを与えれば、その下の階層はデータから生まれます。
注:サブカテゴリが形成されるのは、カテゴリに十分な数のインサイトが割り当てられている場合のみです。 わずかなインサイトしか集まらなかったカテゴリは階層化されず、これは通常、カテゴリが狭すぎたか、該当する資料がないことを示しています。
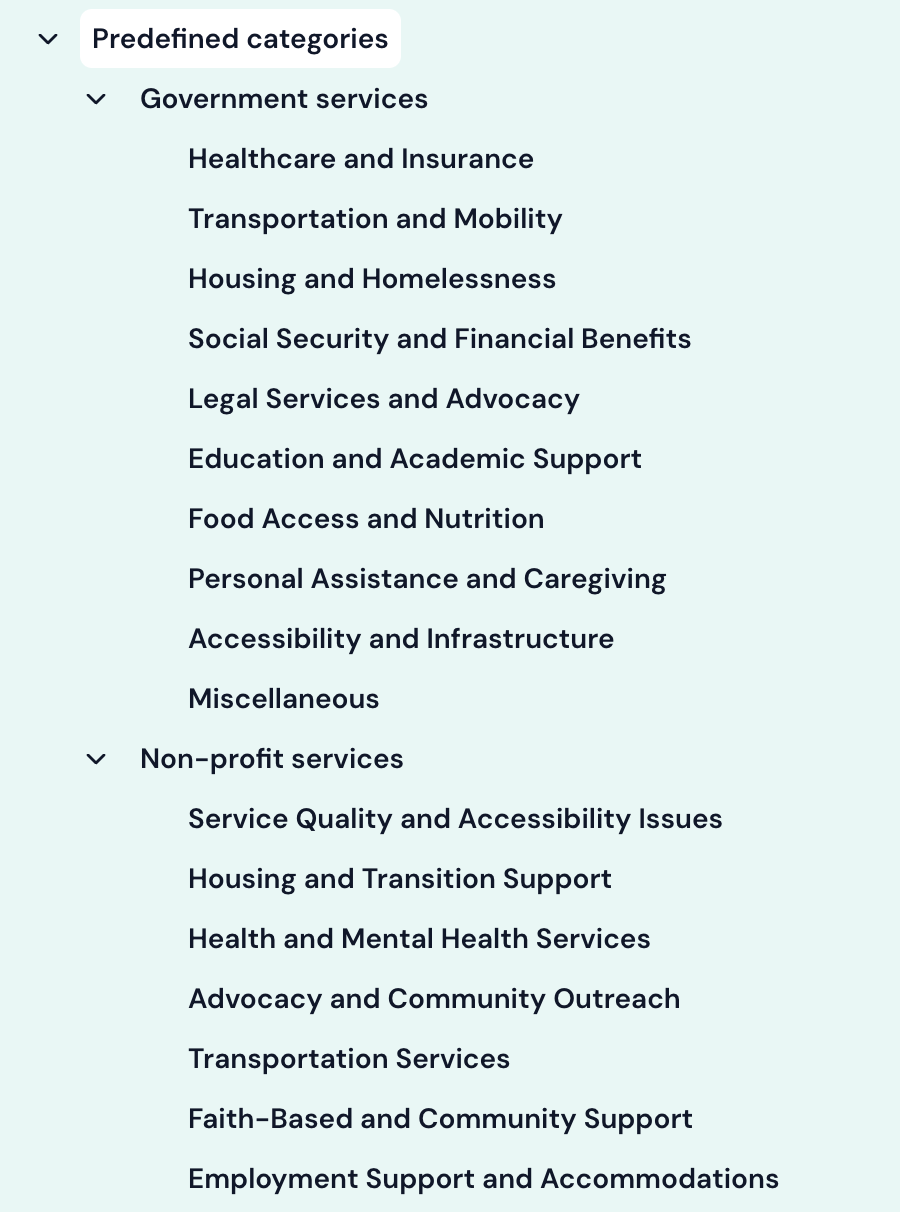
ステップ4:カテゴリの要約
データが分類されると、Skimleは各カテゴリの要約を作成します。要約はカテゴリビューで確認でき、そこでは分析結果に対して名前の変更、統合、分割、再編成を行うこともできます。
CSVファイルのインポート
CSVファイルをインポートすると、「コンテンツ」列の名前が保存され、この分析タイプのデフォルトカテゴリの作成に使用されます。これは、インポートする前にデータの見出し行を明確で分かりやすいものにしておくべき理由の一つです。CSVインポートの仕組みについては、サポートされているファイル形式とCSVインポートを参照してください。
いつ使うか
定義済みカテゴリは、カテゴリが自分のフレームワークから来るか、Skimleの候補から来るかにかかわらず、分析がカテゴリレベルでどの問いに答えるべきかが分かっている場合に使用してください。文書に共通の構造があり、その構造から何も入力せずにカテゴリを構築したい場合は、自動テーマ分析の方が早く済みます。分類されたカテゴリツリーではなく、研究課題に対する文章による分析結果を求める場合は、エージェント分析を使用してください。