पूर्वनिर्धारित श्रेणियाँ
निष्कर्षण के लिए श्रेणियाँ तय करें, या Skimle के सुझावों में से चुनें, और विश्लेषण को इनके अनुसार अपने दस्तावेज़ों को वर्गीकृत करने दें।
पूर्वनिर्धारित श्रेणियाँ वह विश्लेषण प्रकार है जिसका उपयोग आप तब करते हैं जब आप यह तय करना चाहते हैं कि आपके डेटा से क्या निकलेगा। आप निष्कर्षण के लिए श्रेणियों के नाम तय करते हैं, Skimle हर दस्तावेज़ को इनके अनुसार वर्गीकृत करता है, और फिर जो मिला उससे उपश्रेणियाँ बनाता है।
यह आगमनात्मक-निगमनात्मक सीमा के दोनों सिरों को कवर करता है। अपना मौजूदा वर्गीकरण ढांचा लाएं और विश्लेषण निगमनात्मक हो जाता है। Skimle के सुझावों से, या एक व्यापक श्रेणी से शुरुआत करें, और उपश्रेणियों को डेटा से उभरने दें, और विश्लेषण आगमनात्मक हो जाता है। वही स्क्रीन, वही वर्कफ़्लो।
चरण 1: अपनी श्रेणियाँ चुनें
श्रेणी सूची भरने के दो तरीके हैं, और आप इन्हें मिला सकते हैं:
- स्वयं जोड़ें। अपनी स्वयं की श्रेणी जोड़ें पर क्लिक करें और उसका नाम रखें। यह तरीका तब अपनाएं जब आपको पहले से पता हो कि आपका खोज का विषय क्या है।
- सुझावों में से चुनें। Skimle आपकी परियोजना को पढ़ता है और सामग्री से ही तैयार श्रेणियाँ सुझाता है। किसी एक पर क्लिक करके उसे जोड़ें। यह तरीका तब अपनाएं जब आप चाहते हैं कि डेटा दिशा तय करे।
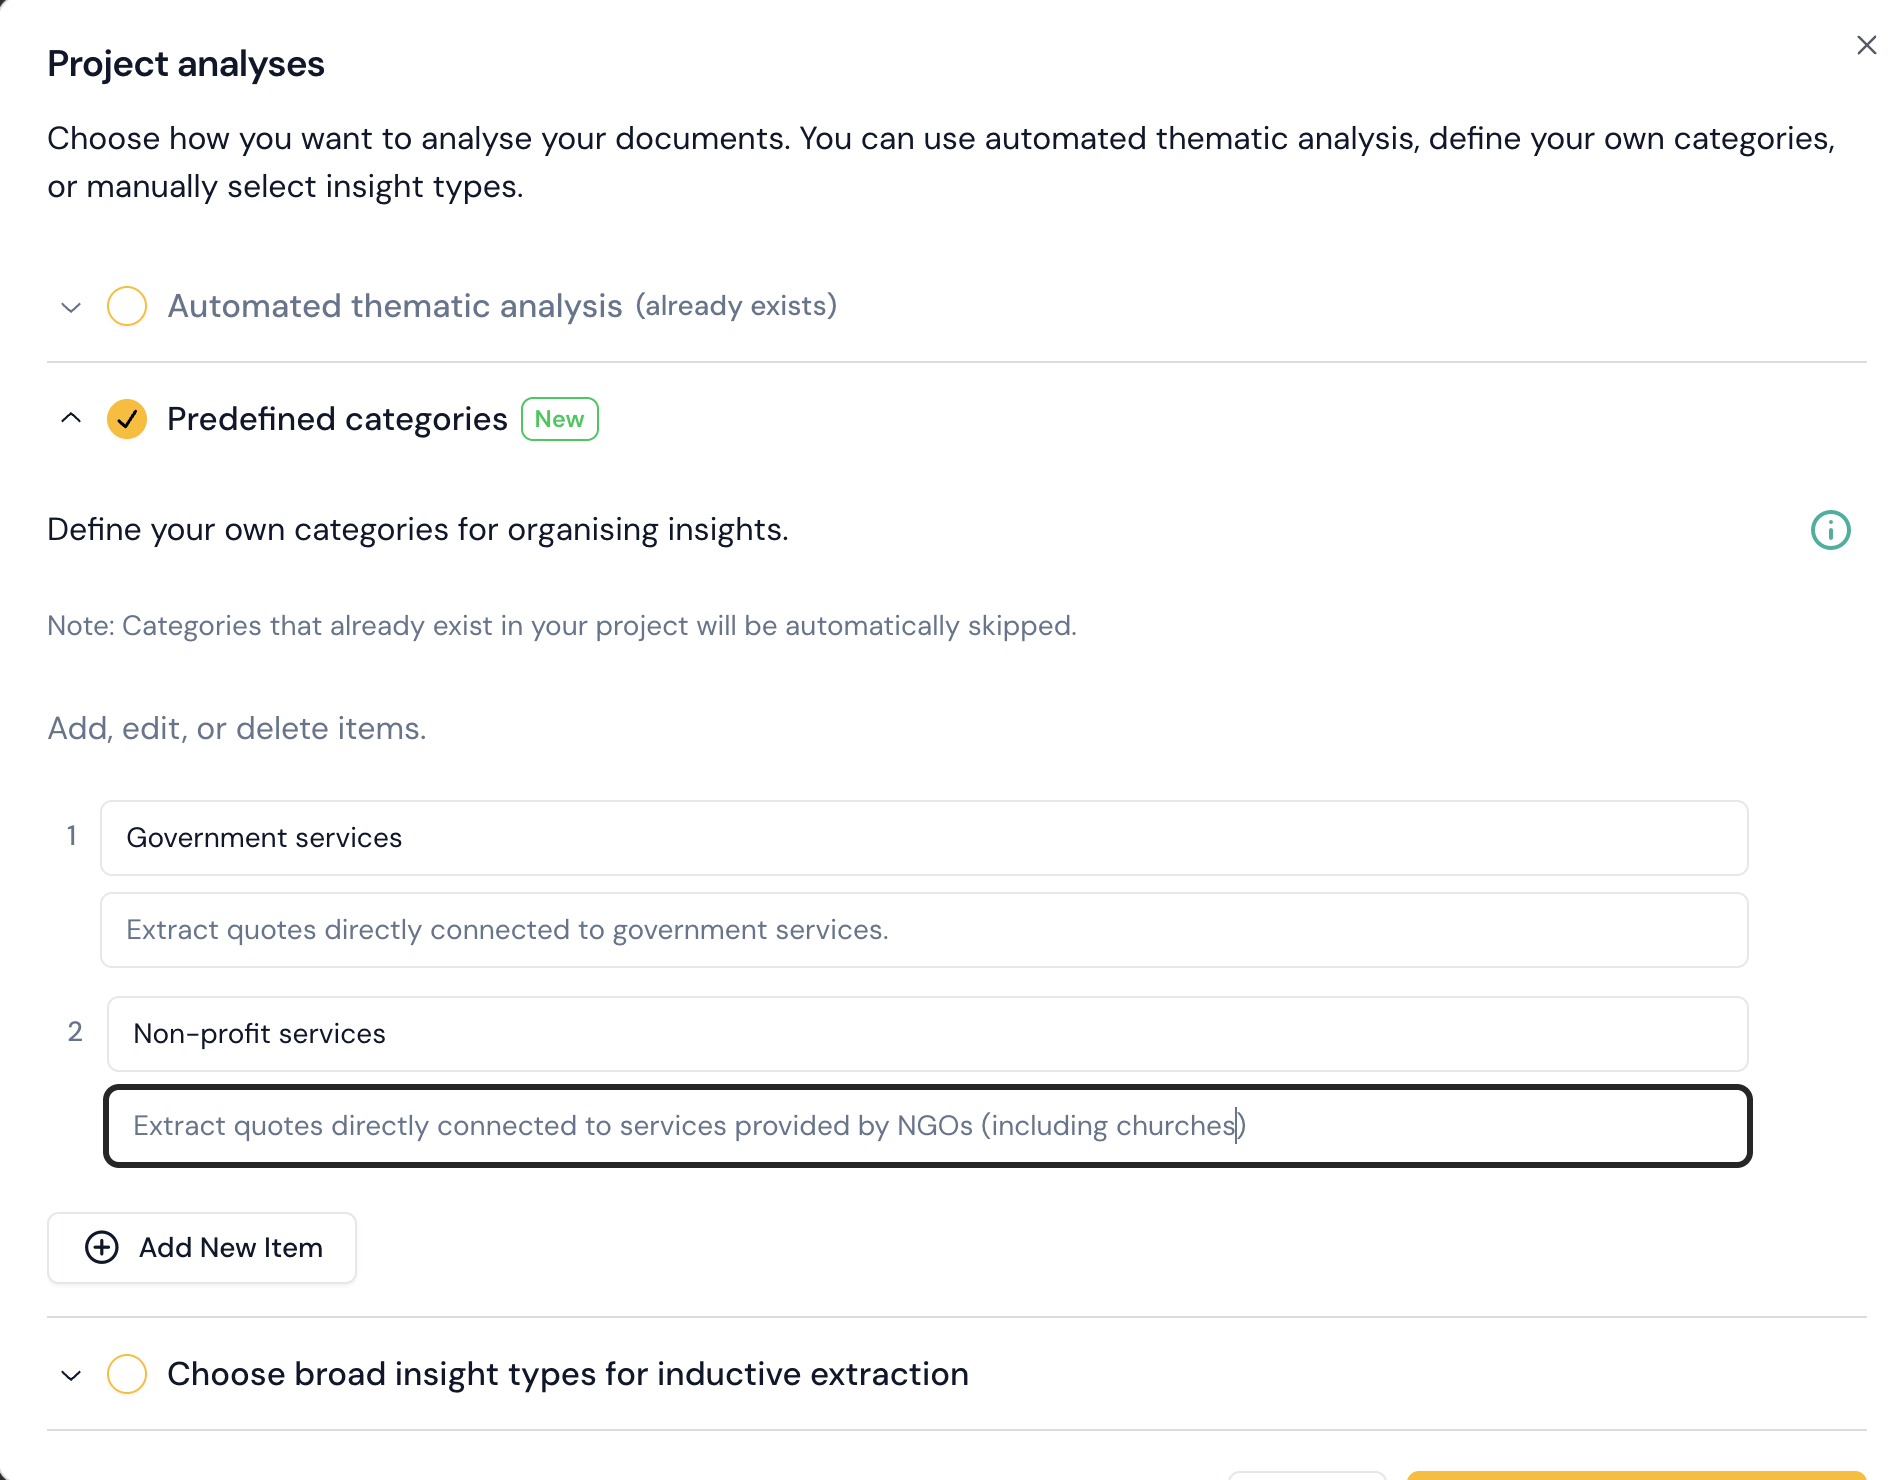
हर श्रेणी में वैकल्पिक निर्देश जोड़े जा सकते हैं:
- निर्देश यह तय करते हैं कि AI इस श्रेणी के लिए क्या निष्कर्षित करे, जिससे आप शामिल की गई सामग्री को व्यापक या संकुचित कर सकते हैं।
- श्रेणीकरण निर्देश यह तय करते हैं कि अंतर्दृष्टियों को इसके अंतर्गत उपश्रेणियों में किस तरह बांटा जाए।
- उदाहरण तैयार किए जा सकते हैं, जिससे पूरा विश्लेषण करने से पहले AI को मिलने वाली अंतर्दृष्टि के प्रकार का पूर्वावलोकन किया जा सकता है।
बिना निर्देश वाली श्रेणी भी ठीक तरह से काम करती है। निर्देश तब सबसे अधिक मायने रखते हैं जब श्रेणी का नाम अपने आप में अस्पष्ट हो, या जब दो श्रेणियाँ किसी एक ही अंश पर दावा कर सकती हों।
चरण 2: डेटा निष्कर्षण
Skimle आपके हर दस्तावेज़ की जांच करता है और आपकी श्रेणियों तथा उनके निर्देशों से मेल खाने वाली अंतर्दृष्टियाँ निष्कर्षित करता है। निष्कर्षित किया गया हर उद्धरण स्रोत दस्तावेज़ से सत्यापित किया जाता है, इसलिए जो उद्धरण मूल में शब्दशः नहीं मिलता, वह आपके विश्लेषण तक कभी नहीं पहुंचता।
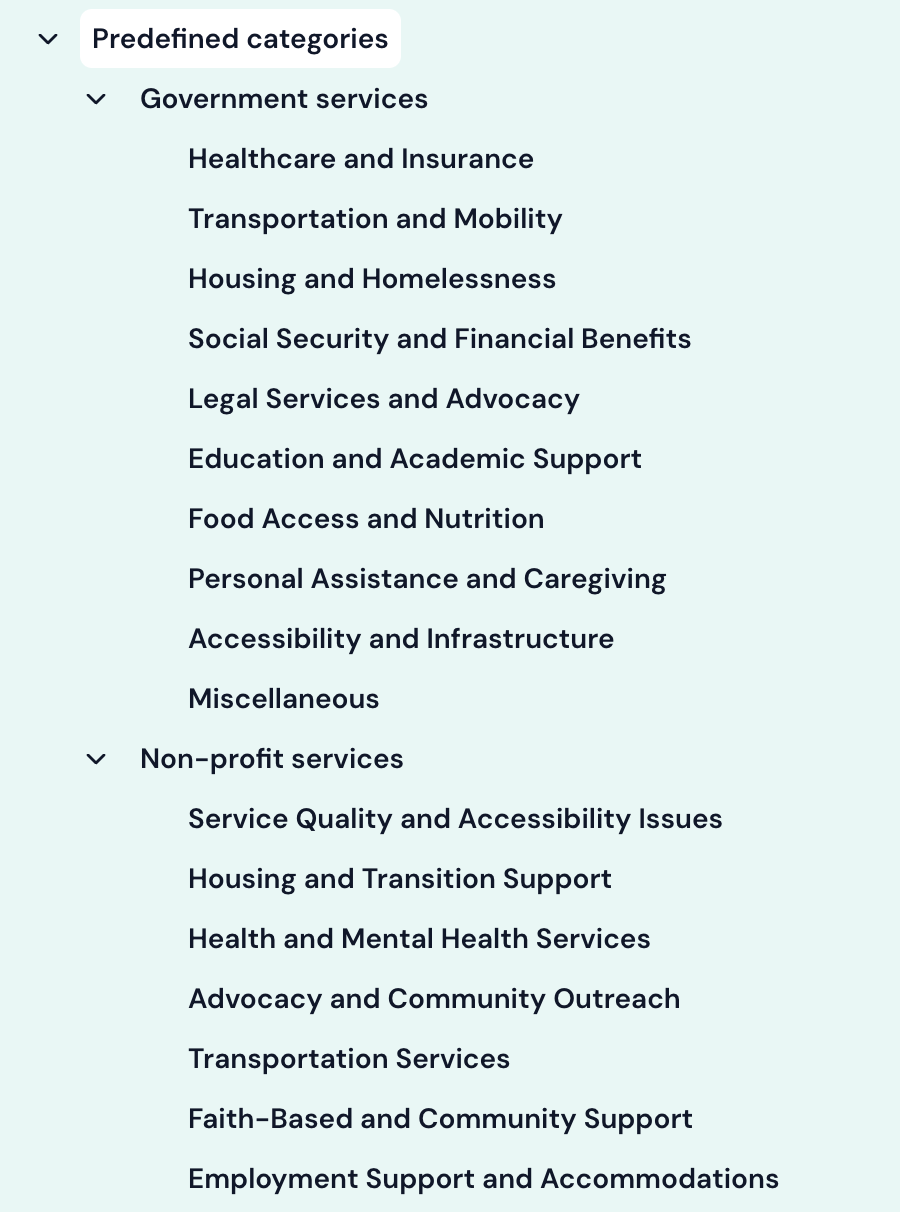
चरण 3: अंतर्दृष्टियों से उपश्रेणियाँ बनती हैं
Skimle हर श्रेणी को सौंपी गई अंतर्दृष्टियों की जांच करता है और उपश्रेणियाँ बनाता है, फिर हर अंतर्दृष्टि को सबसे उपयुक्त उपश्रेणी में भेजता है। यहीं से आगमनात्मक विश्लेषण को उसकी संरचना मिलती है: आप व्यापक फ़ोकस तय करते हैं, और उससे नीचे का स्तर डेटा से आता है।
नोट: उपश्रेणियाँ तभी बनती हैं जब किसी श्रेणी को सौंपी गई अंतर्दृष्टियों की संख्या सार्थक हो। जिस श्रेणी में केवल कुछ ही अंतर्दृष्टियाँ आई हों, वह सपाट ही रहती है, जो आमतौर पर यह संकेत देता है कि श्रेणी बहुत संकुचित थी या सामग्री उपलब्ध नहीं थी।
चरण 4: श्रेणी सारांश
जब डेटा श्रेणीबद्ध हो जाता है, तो Skimle हर श्रेणी के लिए एक सारांश लिखता है। सारांश श्रेणियाँ दृश्य में देखे जा सकते हैं, जहां आप विश्लेषण से प्राप्त किसी भी चीज़ का नाम बदल सकते हैं, उसे मिला सकते हैं, विभाजित कर सकते हैं और पुनः व्यवस्थित कर सकते हैं।
CSV फ़ाइल आयात
जब आप कोई CSV फ़ाइल आयात करते हैं, तो "सामग्री" कॉलम के नाम सहेजे जाते हैं और इस विश्लेषण प्रकार के लिए डिफ़ॉल्ट श्रेणियाँ बनाने में उपयोग किए जाते हैं। यह एक और वजह है कि आयात करने से पहले अपने डेटा के लिए स्पष्ट और सूचनाप्रद हेडर पंक्ति तैयार करें। CSV आयात किस तरह काम करता है, इसके बारे में अधिक जानकारी के लिए समर्थित फ़ाइल प्रारूप और CSV आयात देखें।
इसका उपयोग कब करें
जब भी आपको पता हो कि विश्लेषण को श्रेणी स्तर पर किस प्रश्न का उत्तर देना चाहिए, पूर्वनिर्धारित श्रेणियाँ का उपयोग करें, चाहे श्रेणियाँ आपके अपने ढांचे से आएं या Skimle के सुझावों से। अगर आपके दस्तावेज़ों की संरचना एक समान है और आप बिना किसी इनपुट के उस संरचना से बनी श्रेणियाँ चाहते हैं, तो स्वचालित विषयगत विश्लेषण अधिक तेज़ है। यदि आप श्रेणियों के वर्गीकृत ढांचे के बजाय किसी शोध प्रश्न का लिखित विश्लेषणात्मक उत्तर चाहते हैं, तो एजेंटिक विश्लेषण का उपयोग करें।