文字雲
您的文件使用的詞彙,以及其中提及的人物、地點、組織與主題。
文字雲顯示您的文件談論的內容 - 詞彙本身,或分析所找到的人物、地點、組織與主題。項目越大,代表在您所選的衡量指標上排名越高。它位於視覺化的「總覽」檢視中,且每個項目皆可點擊:向下鑽研卡會顯示確切是哪些文件包含該項目。
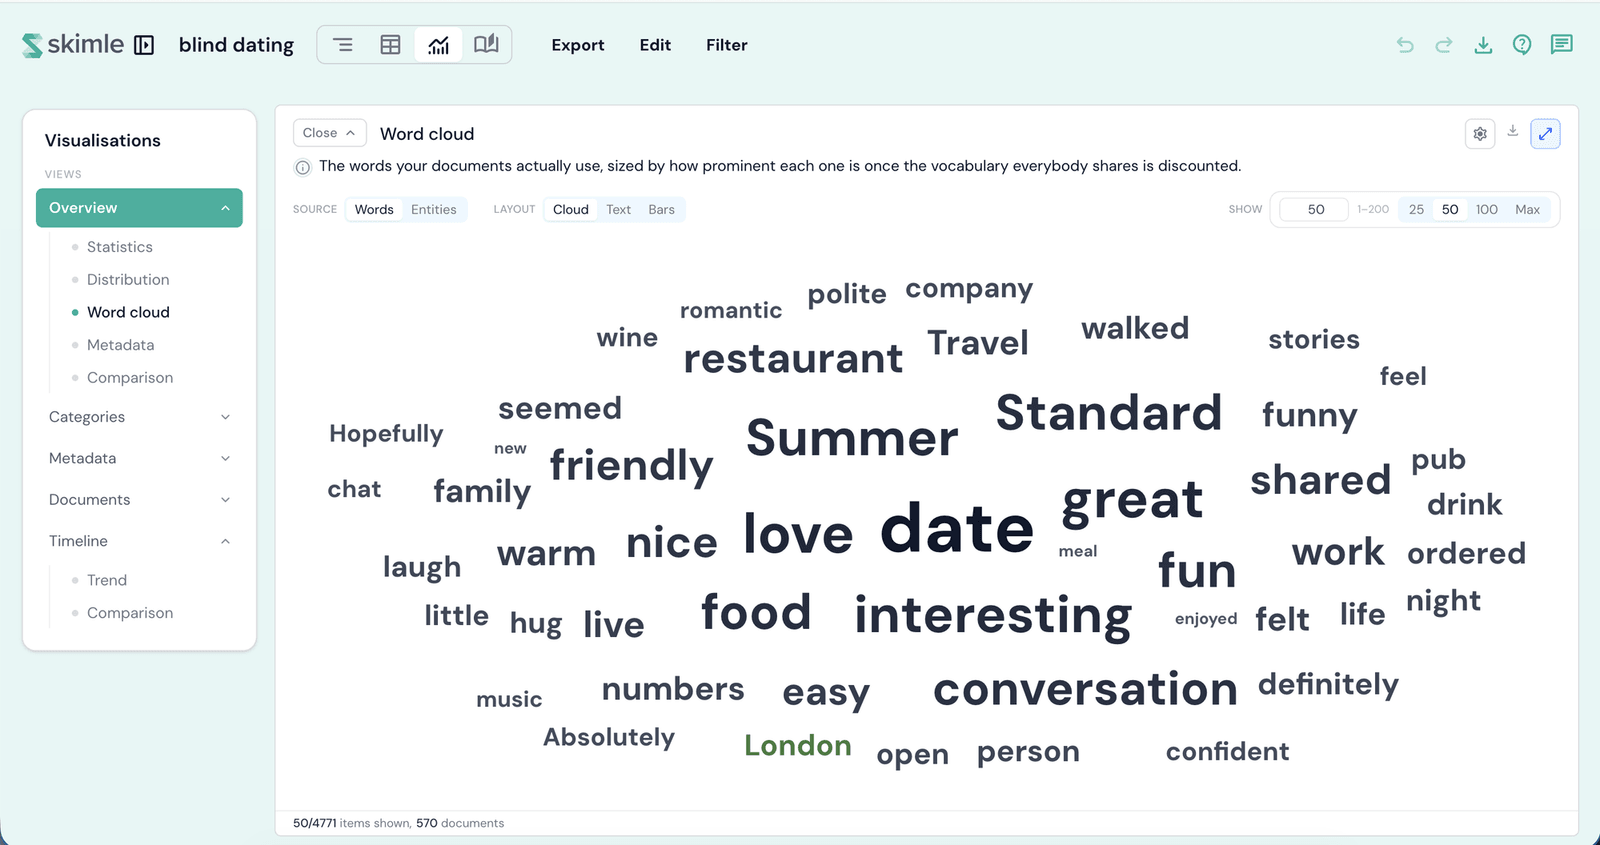
詞彙與實體
來源控制項可在兩個截然不同的資料集之間切換:
- 詞彙 - 您文件本身所使用的詞彙。詞彙會進行詞幹還原,因此 talk、talking、talked 只會計算一次。
- 實體 - 分析所找到的人物、地點、組織、事件與主題。顏色代表實體類型,工具列下方的標籤可用於開啟或關閉各類型。
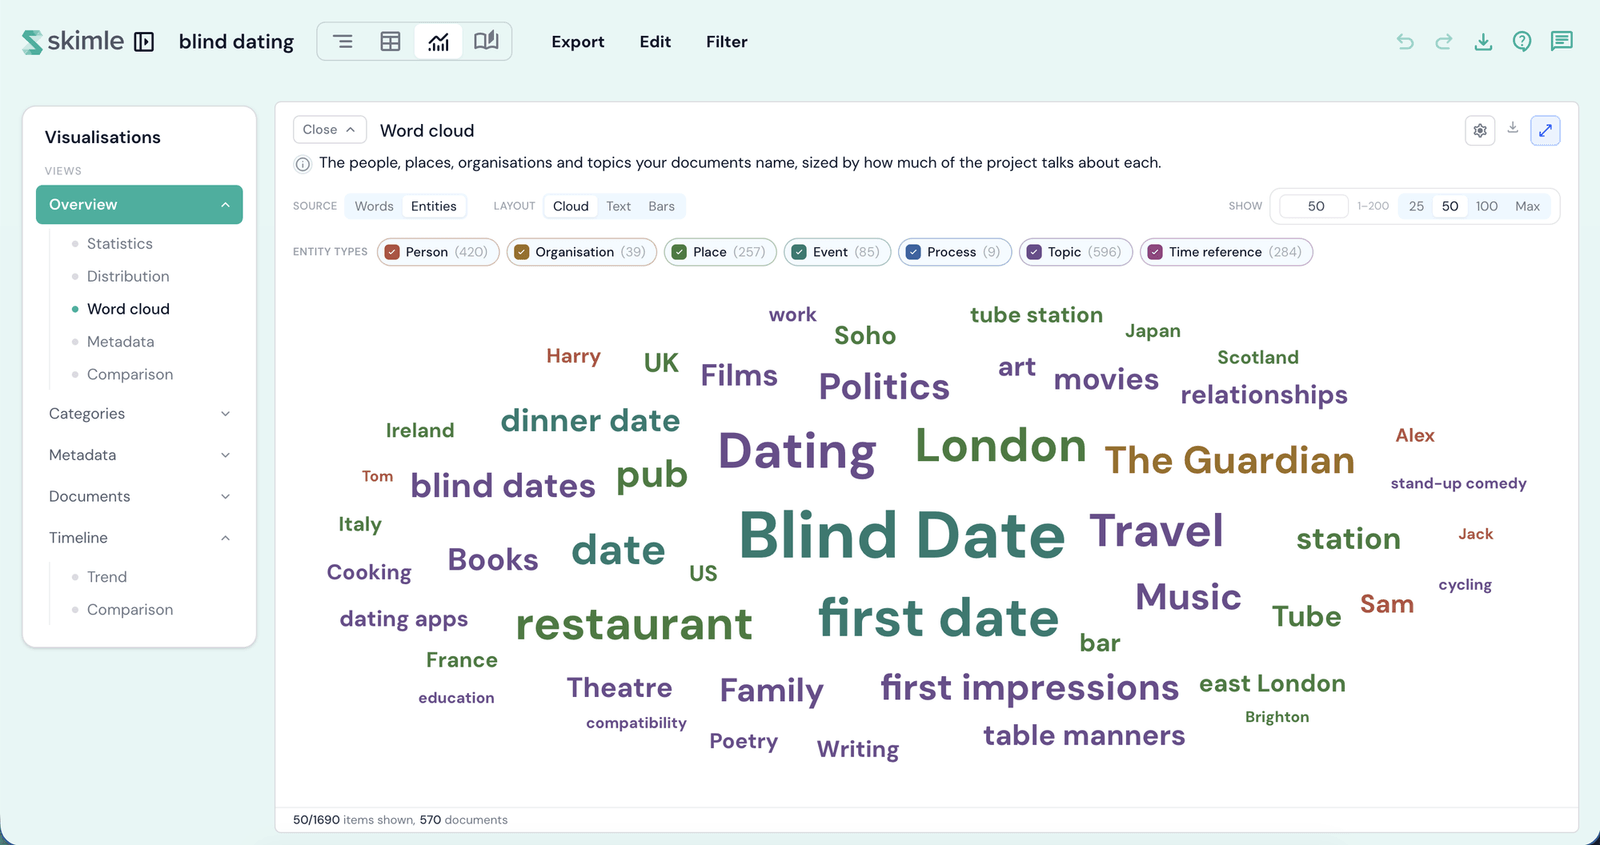
關於實體,有一個誠實的警語:它們是由語言模型透過理解語義找出的,而非透過文字比對。這表示一份文件即使從未寫出某個實體的名稱,仍可能被計入該實體之中 - 也表示偶爾會出現錯誤,例如將職稱誤判為人名,或將同一名稱的兩種拼法分開計算。點擊某個實體即可查看其背後的文件並自行判斷;向下鑽研卡甚至會將寫出名稱的文件與未寫出名稱但有討論該實體的文件分開列出。
版面配置
- 雲狀 - 經典的螺旋排列。任何無法在不重疊的情況下放置的項目都會被捨棄,因此頁尾所計算的是實際繪製出來的項目。
- 文字 - 流動式文本塊,從大到小排列。
- 長條圖 - 與排序長條圖相同的項目,並顯示確切的計數。
顯示設定要繪製的項目數量 - 您可以輸入確切數字,或選擇預設值。每種版面配置都會記住自己的設定。
排序依據
在齒輪圖示後方,排序依據可選擇決定大小與順序的衡量指標:
- 提及次數 - 原始總數:該項目出現的次數。最適合用於衡量單純的數量多寡,但單一文件重複提及可能會使此數值膨脹。僅適用於詞彙。
- 文件數 - 該項目出現在多少份文件中。最適合用於區分普遍關注的議題與單一聲量過大的個案。
- 特出 - 被大量提及,但並非到處都有。任何出現在每一份文件中的項目 - 例如訪談問題或電子郵件標頭 - 都會被壓低至接近零,因此留下來的就是真正獨特之處。
詞彙預設以提及次數排序;實體則預設以文件數排序。
最少提及次數
同樣位於齒輪圖示後方,有一個最低門檻可用於隱藏長尾項目:您可以將滑桿從不限拖曳至資料集中的最高計數,或輸入確切數字。在詞彙中,此控制項為最少提及次數;在實體中,則為最少文件數。
隱藏填充詞
在詞彙模式中,隱藏填充詞開關可隱藏常見的填充詞,例如 just、really、think,以及標頭殘留文字,例如 Fri 或 GMT。在包含 10 份或以上文件的專案中,它也會隱藏任何幾乎在每份文件中出現的詞彙,因為到處都有的詞彙無法區分任何內容。沒有任何內容會被刪除 - 關閉此開關後,所有詞彙都會恢復顯示。實體永遠不會被篩選。
向下鑽研卡
點擊任何項目即可查看它出現在哪些文件中,並顯示各文件的計數,還可以直接開啟其中一份文件。一個不錯的初步實驗:在詞彙模式中,將排序依據設為文件數 - 躍升至頂端的通常是您的問題表,而非您的受訪者。